04/09

Thứ Sáu · 6 tin
Kim@kimmonismus
Mô hìnhĐiểm AI 39/100

Lộ diện kết quả benchmark GPT-6 Astra: Đạt 98.6% trong bài kiểm tra ARC-AGI-3

Full benchmarks. Absolutely insane. ARGI-AGI 3, from 7.8% to 98.6%

DịchBảng điểm rò rỉ cho thấy GPT-6 Astra đạt hiệu suất vượt trội trên nhiều bài kiểm tra trí tuệ nhân tạo, với ARC-AGI-3 đạt 98.6%. OpenAI được cho là sẽ sớm phát hành mô hình này cho người dùng trả phí và qua API trong vài ngày tới.

Thêm 1 nguồn khác đưa tinX: Testing Catalog (@testingcatalog)
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 46/100

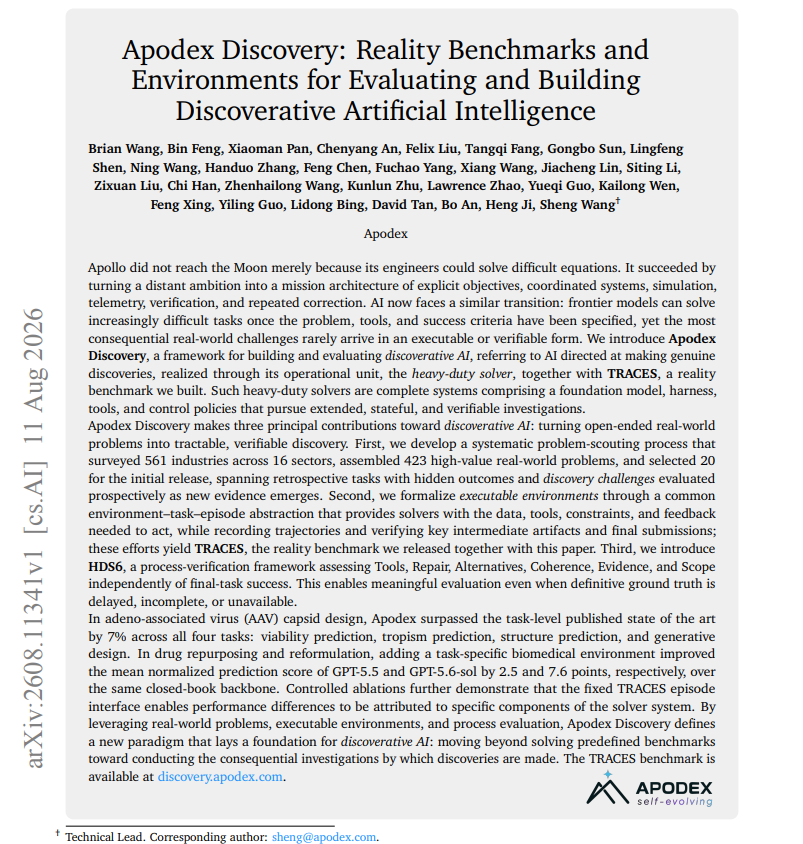
Apodex ra mắt TRACES: Bộ tiêu chuẩn đánh giá khả năng giải quyết các bài toán khoa học chưa có lời giải

Most benchmarks assume the answer exists somewhere. Scientific discovery often starts precisely beca…

DịchApodex giới thiệu TRACES, bộ benchmark gồm 423 câu hỏi khoa học thực tế từ 561 lĩnh vực, được các chuyên gia STEM biên soạn nhằm kiểm tra khả năng tư duy và khám phá của AI đối với những vấn đề chưa có đáp án xác định.

Thêm 2 nguồn khác đưa tinX: DAIR.AI (@dair_ai)X: Elvis Saravia (@omarsar0, DAIR.AI)

03/09

Thứ Năm · 8 tin
OpenRouter@OpenRouter
Sản phẩmĐiểm AI 48/100

OpenRouter ra mắt công cụ so sánh trực tiếp các mô hình AI tạo video

Introducing video benchmarks: compare video models side by side, on a variety of challenges. Seedan…

DịchOpenRouter vừa giới thiệu tính năng benchmark cho phép so sánh trực tiếp các mô hình video. Seedance 2.5 gây ấn tượng về vật lý, trong khi MiniMax H3 Max thiết lập chuẩn mực mới về tốc độ và chi phí.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 47/100

LoopArena: Benchmark mới đánh giá khả năng điều phối của AI trong các tác vụ lập trình dài hạn

A strong coding model is not enough if the model managing its work does not know when to redirect, v…

DịchLoopArena là bộ tiêu chuẩn mới giúp đánh giá hiệu quả của các mô hình AI khi đóng vai trò 'Controller' điều phối các tác vụ lập trình phức tạp, thay vì chỉ tập trung vào khả năng viết code đơn lẻ.

Dex Horthy (HumanLayer)@dexhorthy
Hướng dẫnĐiểm AI 21/100

Đánh giá hiệu năng lập trình: So sánh Fable 5.1, Sol và GLM 5.3 qua bộ benchmark Slop Code

many of the runs are incomplete, so will keep updating, but slop code bench coming together for Fabl…

DịchDex Horthy công bố kết quả sơ bộ từ bộ benchmark Slop Code, so sánh khả năng lập trình của các mô hình Fable 5.1, Sol và GLM 5.3 ở nhiều cấp độ suy luận khác nhau.

Elvis Saravia@omarsar0
Hướng dẫnĐiểm AI 41/100

ProximalHQ ra mắt FrontierSWE v2: Claude Fable 5.1 dẫn đầu bảng xếp hạng lập trình dài hạn

Brilliant effort worth checking out. Ultra-long horizon coding tasks are where frontier models lik…

DịchProximalHQ vừa công bố FrontierSWE v2, bộ tiêu chuẩn đánh giá khả năng lập trình chuyên sâu, trong đó Claude Fable 5.1 thể hiện sự vượt trội so với các đối thủ.

Kim@kimmonismus
Mô hìnhĐiểm AI 78/100

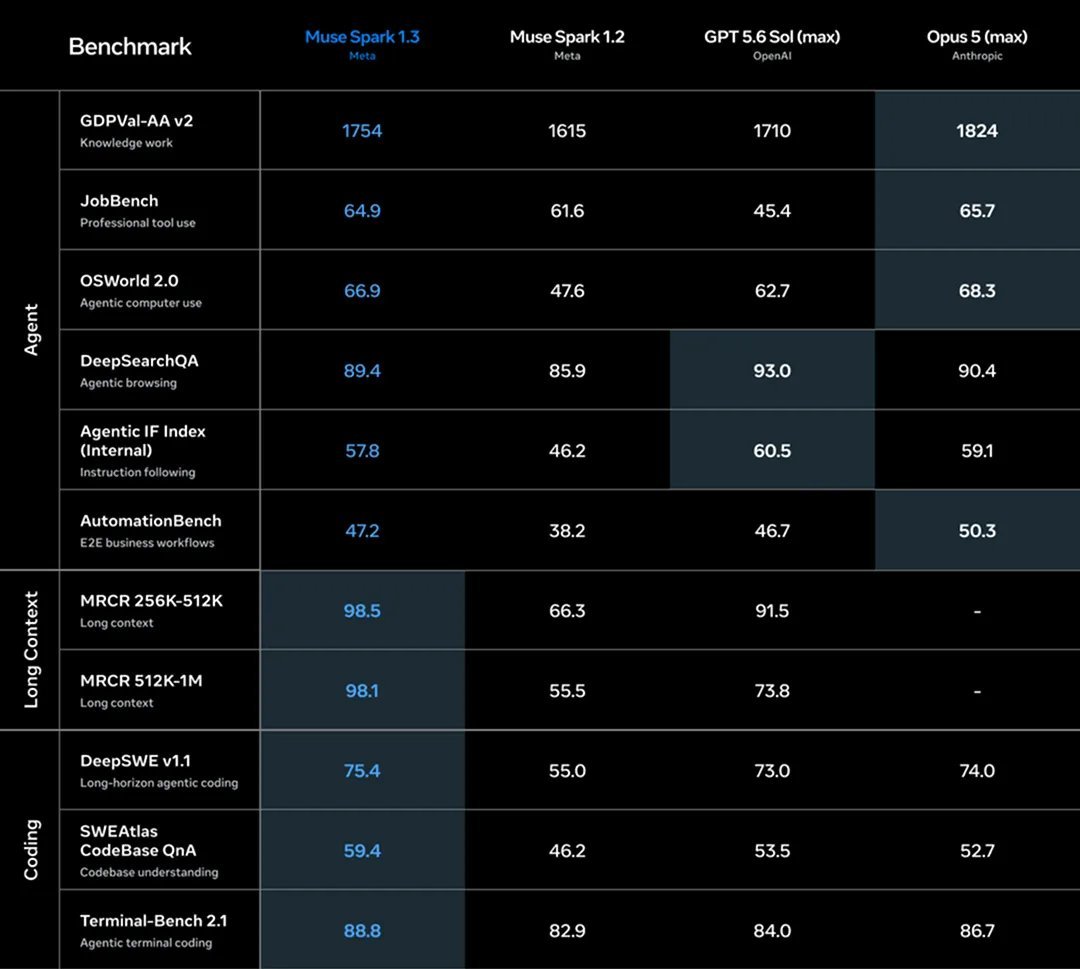
Cùng sự kiệnMeta ra mắt Muse Spark 1.3: Hiệu năng tiệm cận Claude và GPT-5.6

It's worth really grasping this: in a very short time, the race between OpenAI and Anthropic has tur…

DịchMeta vừa trình làng Muse Spark 1.3, phiên bản thứ tư trong năm tháng qua. Biến thể 'max' đạt 62 điểm trên bảng xếp hạng Artificial Analysis, khẳng định vị thế cạnh tranh mạnh mẽ với các mô hình hàng đầu hiện nay.

Cùng sự kiện, bài đại diện «Meta ra mắt Muse Spark 1.3: Nâng cấp mạnh mẽ khả năng lập trình và tác tử AI»
Alexandr Wang (Scale AI nhà sáng lập/Meta Giám đốc AI)@alexandr_wang
Hướng dẫnĐiểm AI 20/100

Alexandr Wang chia sẻ kết quả đánh giá sớm của Muse Spark 1.3 trên bộ benchmark Stata

some early eval results from Stata benchmark:)

DịchNhà sáng lập Scale AI, Alexandr Wang, vừa đăng tải những đánh giá ban đầu về hiệu năng của mô hình Muse Spark 1.3 thông qua bộ kiểm chuẩn Stata, thu hút sự chú ý trong giới công nghệ.

Kim@kimmonismus
Mô hìnhĐiểm AI 30/100

Cùng sự kiệnMuse Spark 1.3 thiết lập kỷ lục mới với 75.4% trên bảng xếp hạng DeepSWE v1.1

wtf Muse Spark 1.3 It has achieved first place in DeepSWE with 75.4%, even ahead of GPT-5.6 Sol and …

DịchMuse Spark 1.3 vừa chính thức ra mắt, đạt điểm số kỷ lục 75.4% trên benchmark lập trình DeepSWE v1.1, vượt qua các đối thủ mạnh như GPT 5.6 Sol và Opus 5, đồng thời ghi nhận hiệu suất ấn tượng trên các bài kiểm tra MRCR và Terminal-Bench.

Cùng sự kiện, bài đại diện «Meta ra mắt Muse Spark 1.3, tích hợp vào Muse Code và Meta Model API»

02/09

Thứ Tư · 5 tin
Yuchen Jin@Yuchenj_UW
Mô hìnhĐiểm AI 52/100

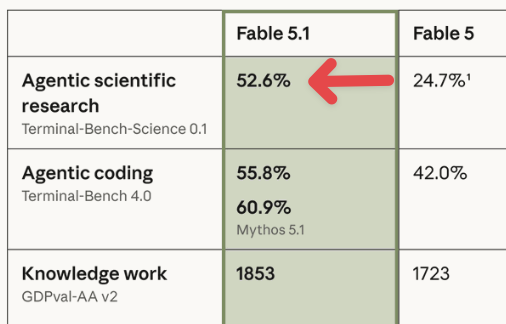
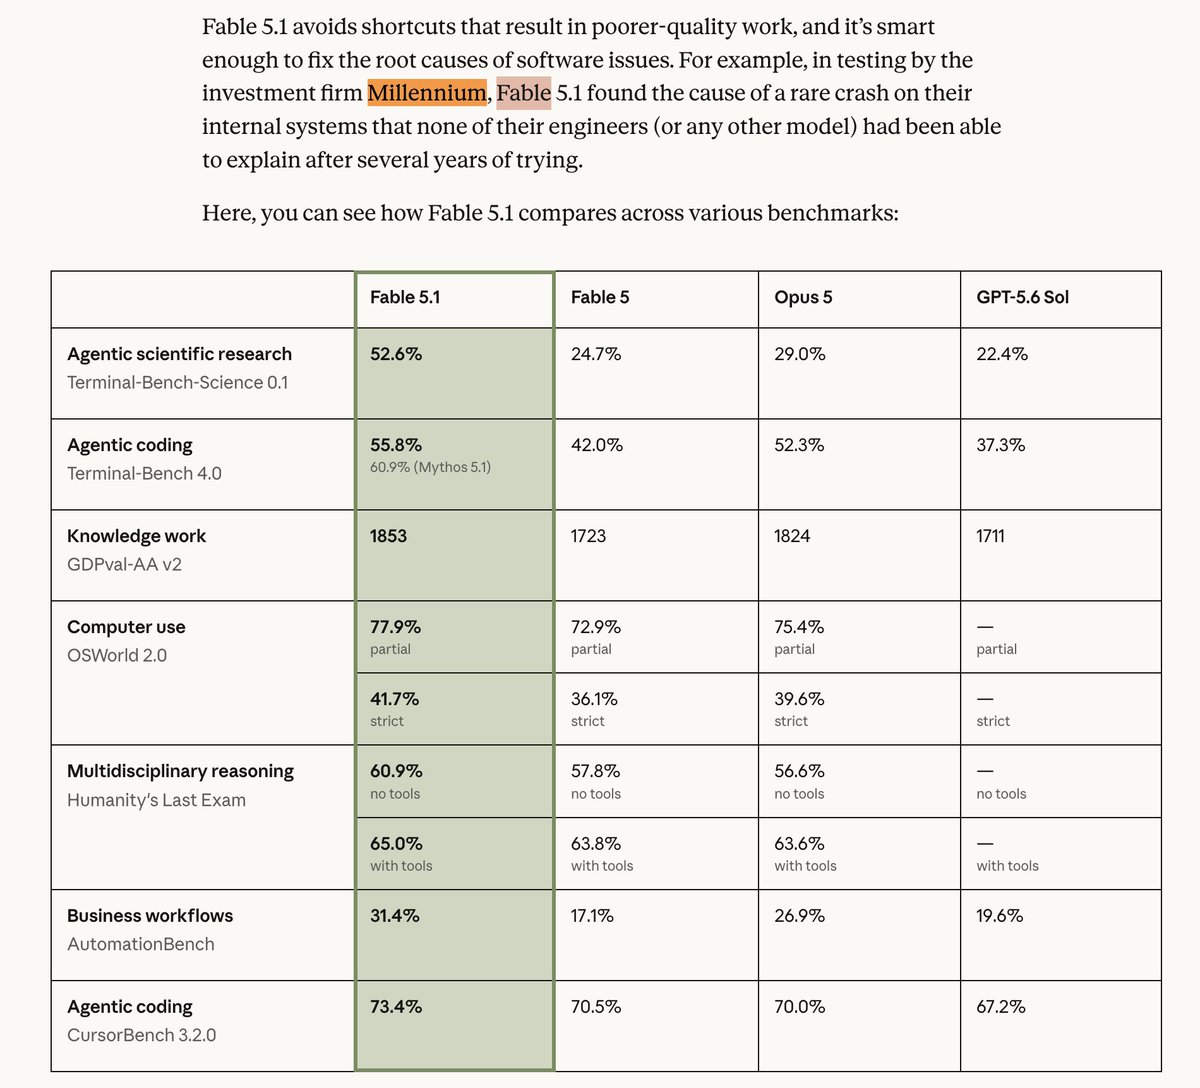
Yuchen Jin đánh giá Fable 5.1: Bước nhảy vọt ấn tượng giữa làn sóng 'làm đẹp' bảng xếp hạng

Even if most AI labs are benchmark-maxxing now, Fable 5.1 still looks like an insane jump. From Ant…

DịchChuyên gia Yuchen Jin nhận định Fable 5.1 thể hiện sự tiến bộ vượt bậc về hiệu năng thực tế, khác biệt hoàn toàn với xu hướng tối ưu hóa điểm số trên các bảng xếp hạng AI hiện nay.

01/09

Thứ Ba · 5 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 38/100

PaperBanana-Interact: Hệ thống đa tác nhân tinh chỉnh sơ đồ khoa học qua phản hồi người dùng

PaperBanana-Interact là hệ thống đa tác nhân sử dụng vòng lặp phản hồi để tối ưu hóa sơ đồ khoa học. Nghiên cứu cũng giới thiệu bộ benchmark MTPaperBananaBench với hơn 3.500 yêu cầu người dùng để đánh giá khả năng tinh chỉnh hình ảnh.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 60/100

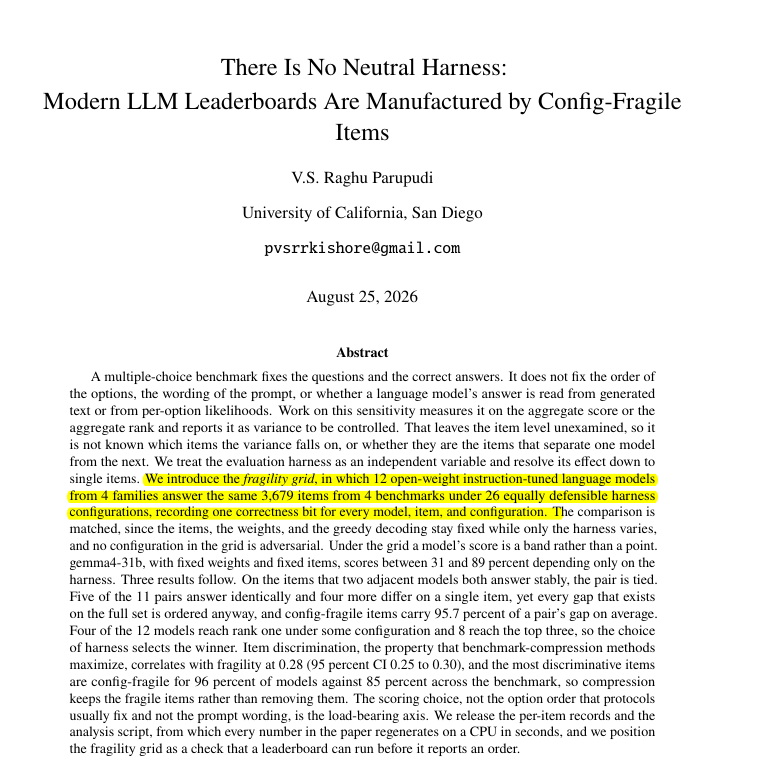
Nghiên cứu mới: Thứ hạng LLM trên bảng xếp hạng phụ thuộc lớn vào cách thiết lập đánh giá

LLM rankings can be created by evaluation choices as much as model differences, so one setup should …

DịchMột nghiên cứu cho thấy chỉ cần thay đổi định dạng prompt hoặc cách chấm điểm, điểm số của cùng một mô hình (như Gemma-2-27b) có thể dao động từ 31% đến 89%, làm lung lay tính khách quan của các bảng xếp hạng LLM hiện nay.

AK@_akhaliq
Nghiên cứuĐiểm AI 30/100

LoopArena: Công bố bộ tiêu chuẩn đánh giá mô hình AI trong vai trò bộ điều khiển vòng lặp

LoopArena Benchmarking Models as Runtime Controllers for Loop Engineering paper: https://huggingfa...

DịchNghiên cứu mới giới thiệu LoopArena, một bộ tiêu chuẩn (benchmark) chuyên biệt để đánh giá khả năng của các mô hình AI khi đóng vai trò là bộ điều khiển thời gian thực trong kỹ thuật vòng lặp.

29/08

Thứ Bảy · 2 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 42/100

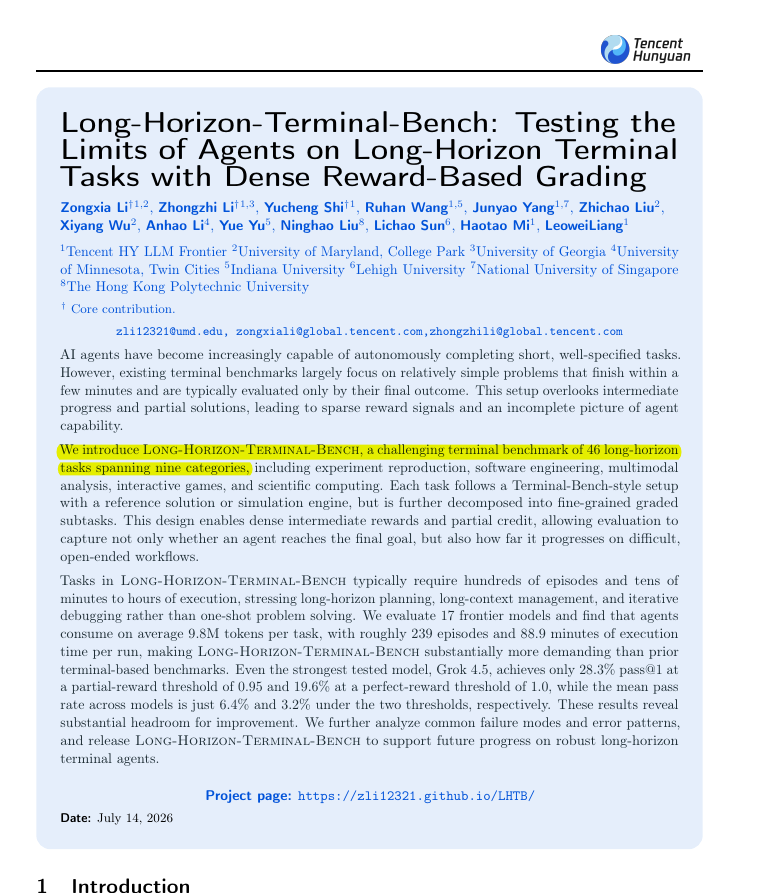
Benchmark mới chỉ ra các mô hình AI hàng đầu chỉ đạt tỷ lệ thành công 6,4% trong các tác vụ dài hạn

Another paper that so clearly exposes AI's long-horizon problem. Long-Horizon-Terminal-Bench, where…

DịchKết quả từ Long-Horizon-Terminal-Bench cho thấy 17 mô hình AI tiên tiến nhất hiện nay gặp khó khăn lớn với các tác vụ phức tạp, khi phần lớn thất bại do quá tải thời gian và không thể duy trì logic qua hàng trăm bước thực hiện.

28/08

Thứ Sáu · 3 tin
Apple Machine Learning Research
Nghiên cứuĐiểm AI 44/100

Agent Seer: Phương pháp tự động tổng hợp kịch bản đánh giá AI Agent từ đặc tả công cụ

Agent Seer giúp tự động tạo các kịch bản kiểm thử thực tế cho AI Agent bằng cách phân tích đặc tả công cụ, loại bỏ nhu cầu xây dựng thủ công và giải quyết vấn đề khó mở rộng trong các bộ benchmark truyền thống.

Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 72/100

Tinh chọnTerminal-Bench-Science 0.1: Bộ tiêu chuẩn mới đánh giá năng lực AI trong nghiên cứu khoa học

Các nhà nghiên cứu tại Stanford vừa ra mắt Terminal-Bench-Science 0.1, bộ benchmark gồm 70 tác vụ chuyên sâu thuộc nhiều lĩnh vực khoa học nhằm đo lường khả năng thực hiện quy trình nghiên cứu thực tế của các AI agent.


Vì sao đáng đọc: Đây là bước tiến quan trọng trong việc chuẩn hóa khả năng suy luận và thực thi của AI trong môi trường khoa học, thay vì chỉ dừng lại ở các bài kiểm tra ngôn ngữ thông thường.
Kim@kimmonismus
Sản phẩmĐiểm AI 40/100

CommerceAgentBench: Bộ tiêu chuẩn đánh giá khả năng thực thi tác vụ thực tế của AI trong thương mại điện tử

Most AI benchmarks test whether a model can give the right answer. CommerceAgentBench asks whether a…

DịchAccio ra mắt CommerceAgentBench với 107 tác vụ thực tế từ vận hành đến hậu mãi. Thay vì dựa trên lý thuyết, bộ tiêu chuẩn này kiểm chứng trực tiếp kết quả công việc của AI, cho thấy các mô hình hiện nay chỉ đạt tỷ lệ thành công 61,7%.

Thêm 2 nguồn khác đưa tinX: Testing Catalog (@testingcatalog)TechNode

27/08

Thứ Năm · 1 tin

26/08

Thứ Tư · 5 tin
Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 52/100

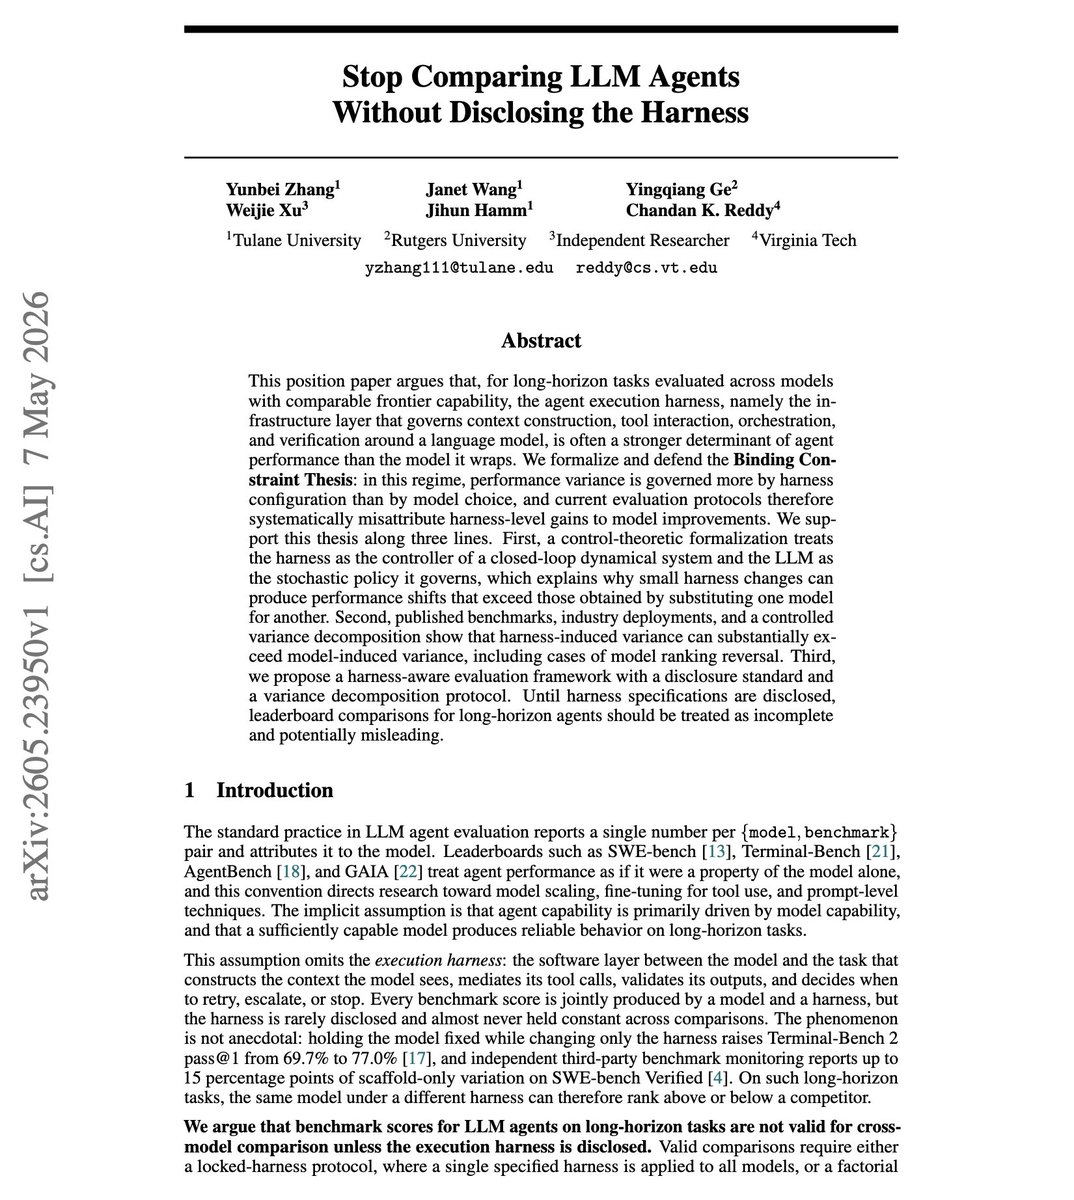
Tại sao bảng xếp hạng AI Agent không đáng tin? Vai trò mờ ám của bộ đánh giá (harness)

Great paper on why agent leaderboard comparisons are hard to trust. It's on the hot topic of how mu…

DịchNghiên cứu mới chỉ ra rằng 'harness' (lớp trung gian giữa mô hình và tác vụ) ảnh hưởng đến điểm số AI Agent gấp 7,8 lần so với chính mô hình đó, khiến kết quả xếp hạng dễ bị thao túng và thiếu khách quan.

DAIR.AI@dair_ai
Nghiên cứuĐiểm AI 47/100

Điểm chuẩn AI không đáng tin: Thay đổi cấu hình nhỏ khiến thứ hạng mô hình đảo lộn

// There Is No Neutral Harness // Great work discussing some of the issues in harness evaluation. …

DịchNghiên cứu chỉ ra rằng chỉ cần thay đổi thứ tự đáp án hoặc cách diễn đạt câu lệnh, điểm số của các mô hình AI có thể dao động cực lớn, khiến bảng xếp hạng hiện nay trở nên thiếu khách quan.

Elvis Saravia@omarsar0
Nghiên cứuĐiểm AI 44/100

Đánh giá AI không hề khách quan: Điểm số một mô hình có thể dao động từ 31% đến 89%

Great paper on agent harnesses.

DịchNghiên cứu mới chỉ ra rằng cách thiết lập bộ khung đánh giá ảnh hưởng cực lớn đến kết quả của AI. Chỉ cần thay đổi thứ tự đáp án hay cách đặt câu hỏi, thứ hạng của các mô hình có thể bị đảo lộn hoàn toàn, cho thấy các bài kiểm tra hiện nay còn nhiều lỗ hổng.

25/08

Thứ Ba · 3 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Thinkingbox: Bước tiến mới trong đánh giá độ tin cậy của AI Agent trong quy trình nghiệp vụ

Thinkingbox là môi trường sandbox và bộ benchmark mới giúp đánh giá khả năng xử lý các quy trình nghiệp vụ phức tạp của AI Agent, vượt xa việc chỉ gọi công cụ đơn thuần bằng cách kiểm tra tính nhất quán và trạng thái hệ thống.

Artificial Analysis@ArtificialAnlys
Sản phẩmĐiểm AI 35/100

Mô hình Qwen2.5 27B hiện đã hỗ trợ kiểm thử hiệu năng trên nền tảng Optima

You can now benchmark Qwen3.8 27B with Optima. See how a model that can run on your laptop compares …

DịchBạn có thể sử dụng Optima để đánh giá hiệu suất, chi phí và tốc độ của mô hình Qwen2.5 27B trên các tác vụ thực tế ngay trên máy tính cá nhân. Artificial Analysis cũng cung cấp hỗ trợ tư vấn và tín dụng miễn phí cho các doanh nghiệp muốn xây dựng bộ kiểm thử riêng.

24/08

Thứ Hai · 5 tin
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 37/100

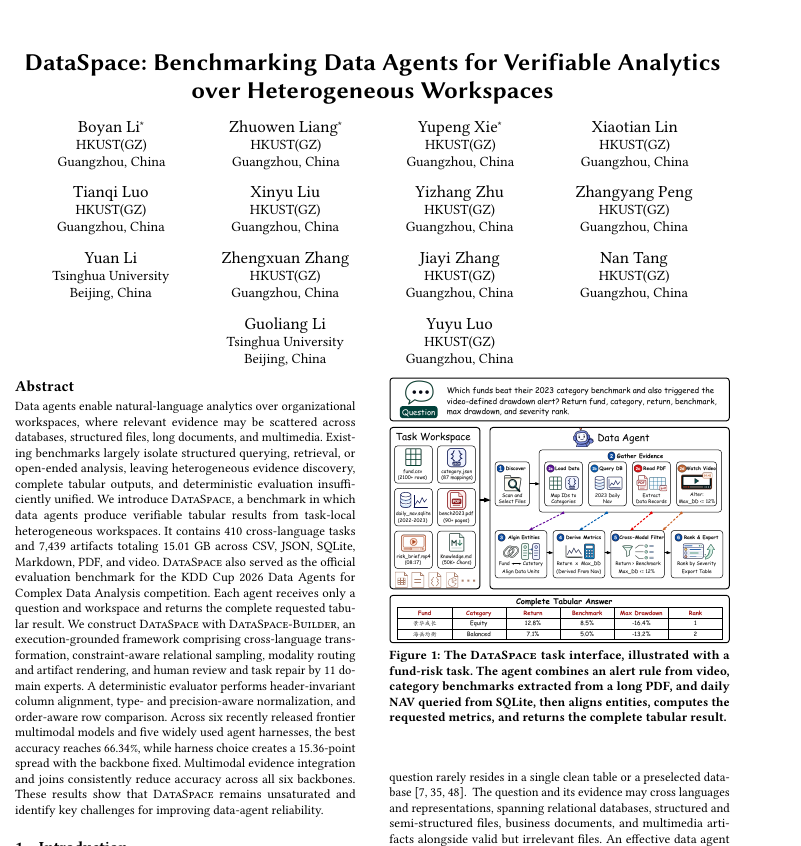
DataSpace: Benchmark mới cho thấy AI Agent chỉ đạt độ chính xác 66,34% trong xử lý dữ liệu phức tạp

A strong LLM does not automatically make a reliable data agent: DataSpace shows that the harness, cr…

DịchDataSpace đánh giá khả năng phân tích dữ liệu đa nguồn của AI Agent. Kết quả cho thấy ngay cả mô hình mạnh nhất cũng chỉ đạt 66,34% độ chính xác, đồng thời nhấn mạnh tầm quan trọng của việc tối ưu hóa framework điều khiển.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

FlavourBench: Đánh giá mô hình ngôn ngữ thông qua khả năng phối hợp nguyên liệu ẩm thực

FlavourBench là bộ tiêu chuẩn đánh giá tự động mới, sử dụng hệ thống ẩm thực có thể thực thi để đo lường khả năng tư duy logic và sáng tạo của 27 mô hình ngôn ngữ lớn thông qua các bài toán phối hợp nguyên liệu.

SemiAnalysis@SemiAnalysis_
Nghiên cứuĐiểm AI 64/100

Benchmark AgentX: Liệu 'hào sâu' CUDA có giữ vững vị thế trong suy luận AI Agent?

AgentX - InferenceXv3: Does CUDA Moat Hold up in Agentic Inferencing? $3 Million USD dataset open s…

DịchAgentX giới thiệu bộ dữ liệu 3 triệu USD với ngữ cảnh 1 triệu token, tối ưu hóa KVCache cho AI Agent đạt hiệu suất trên 95% trên các nền tảng phần cứng mạnh mẽ như GB300 và MI355.

23/08

Chủ Nhật · 2 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (73 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Benchmark” — Trang 3 | AIHOT.vn