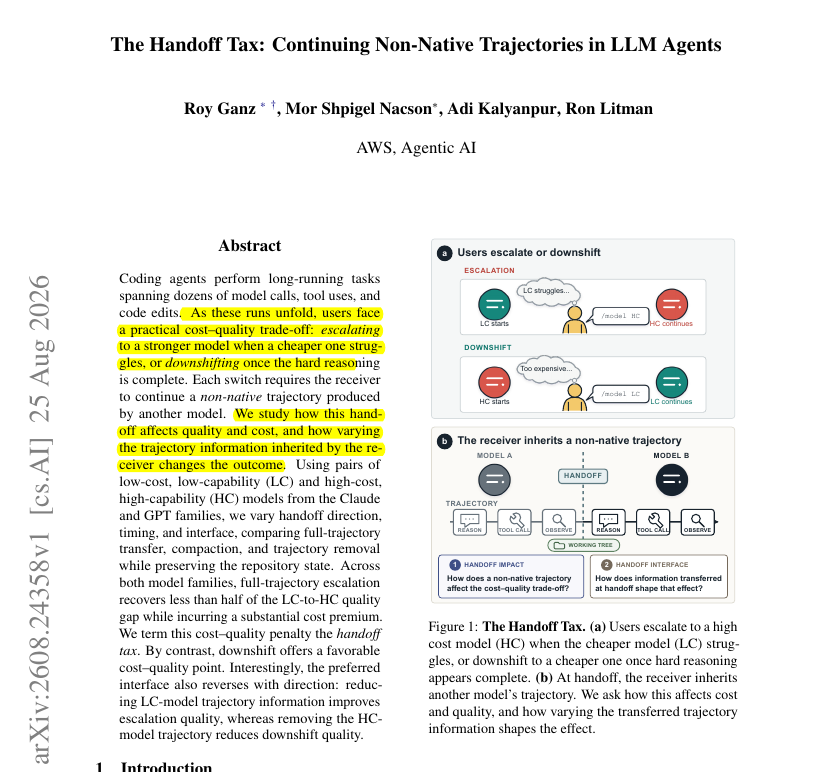
Nghiên cứu chỉ ra rằng việc chuyển đổi từ mô hình yếu sang mô hình mạnh giữa chừng có thể gây ra 'thuế chuyển giao', làm giảm hiệu quả tổng thể so với việc sử dụng mô hình mạnh ngay từ đầu.
Brent is incredible and one of the main forces behind the desktop app polish, performance and reliab…
DịchBrent là nhân tố chủ chốt đứng sau những cải tiến liên tục về độ ổn định và hiệu suất cho ứng dụng ChatGPT trên máy tính, giúp trải nghiệm người dùng mượt mà hơn mỗi ngày.
Brent is one of the best things that happened to the quality and polish of the desktop app. Relent…
DịchBản cập nhật mới nhất cho ứng dụng ChatGPT trên máy tính đã tối ưu hóa hiệu suất vượt trội, giúp tốc độ tải các hội thoại dài nhanh hơn 90% và giảm đáng kể mức tiêu thụ bộ nhớ.
NVIDIA GB300 NVL72 IS 7X BETTER 💰💰 PERF PER DOLLAR 💰💰 THAN H200 on long context agentic workload…
DịchNhờ tối ưu hóa kiến trúc và khả năng tận dụng băng thông từ tấm nền đồng, NVIDIA GB300 NVL72 đạt hiệu suất trên mỗi USD cao gấp 7 lần so với H200 trong các tác vụ AI có ngữ cảnh dài.
GLM-5.3-Flash at 270 tok/s! Databricks inference team is on fire. So proud of the team! On our Off…
DịchGLM-5.3-Flash thiết lập chuẩn mực mới với tốc độ 270 tok/s, mang lại chất lượng vượt trội 10% so với bản tiền nhiệm nhưng chỉ tốn 1/10 chi phí vận hành.
Speculative Decoding giúp tăng tốc độ tạo văn bản gấp 2-3 lần bằng cách dùng mô hình nhỏ dự đoán trước các token, sau đó để mô hình lớn xác thực song song. Phương pháp này tận dụng hiệu quả tài nguyên GPU nhàn rỗi mà vẫn đảm bảo độ chính xác tuyệt đối như mô hình gốc.
Cloudflare đã chuyển đổi blog của mình sang EmDash để kiểm chứng hiệu năng ở quy mô lớn, đồng thời chia sẻ cách họ tối ưu hóa trải nghiệm người dùng và điều hướng lưu lượng truy cập thực tế.
Chrome ngày càng nặng nề và ngốn RAM khi mở nhiều tab. Việc chuyển sang một trình duyệt thay thế tối ưu hơn thực tế đơn giản và mang lại trải nghiệm mượt mà bất ngờ.
we just deployed a fix that was causing a small percentage of requests to our inference service to d…
DịchOpenCode vừa triển khai bản cập nhật nhằm khắc phục tình trạng phản hồi chậm ở một số yêu cầu suy luận, giúp cải thiện tốc độ xử lý cho người dùng.
Tác giả cho rằng LLM đã hạ thấp rào cản tối ưu hóa hiệu năng, cho phép bất kỳ ai cũng có thể thực hiện các tác vụ phức tạp như viết trình biên dịch AOT để tăng tốc phần mềm đáng kể.
Nghiên cứu so sánh toàn diện cho thấy dù LLM có hiệu suất ngang ngửa mô hình nhúng chuyên dụng, nhưng chi phí vận hành lại đắt gấp 1.400 lần và tốc độ xử lý chậm hơn đáng kể.
Vì sao đáng đọc: Nghiên cứu thực nghiệm giá trị, giải quyết bài toán tối ưu chi phí và hiệu năng thực tế cho kỹ sư AI khi lựa chọn giữa LLM và mô hình nhúng.
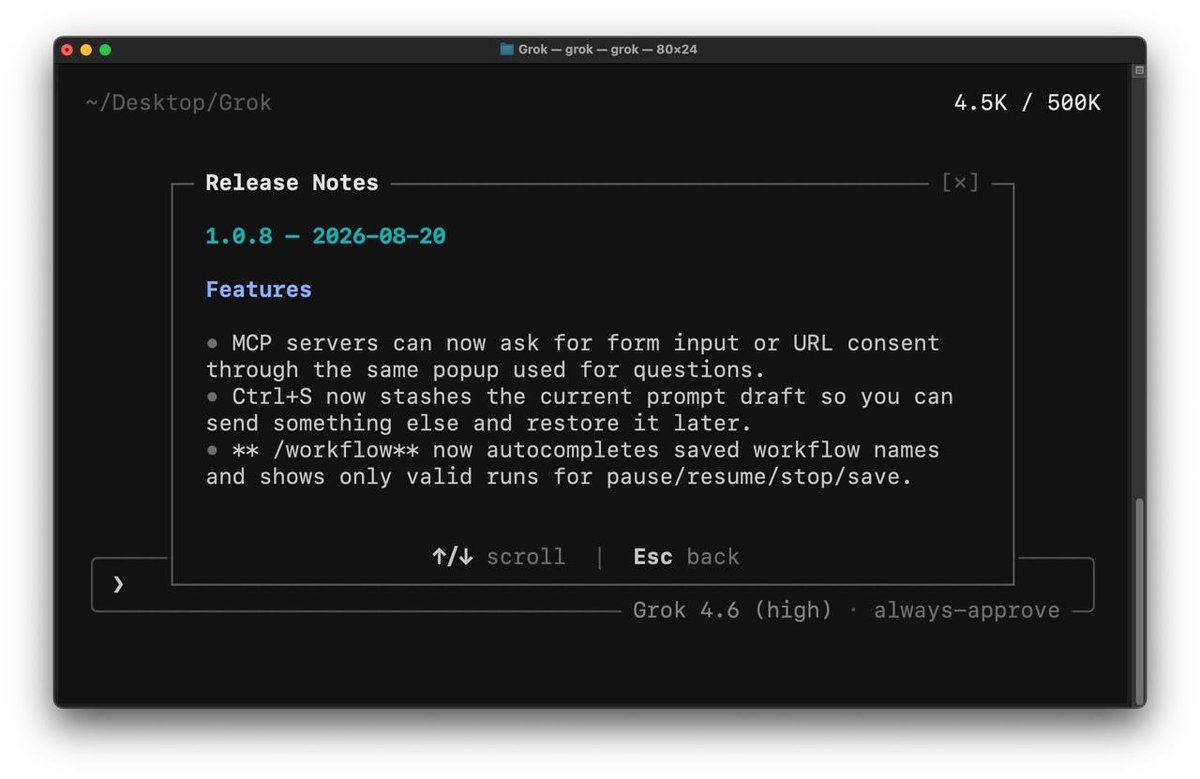
SpaceXAI just released a new Grok Build update. Version 1.0.8 is now available. Bug Fixes: • Down…
DịchBản cập nhật Grok Build 1.0.8 khắc phục lỗi tải xuống và xử lý công cụ, đồng thời bổ sung tính năng lưu nháp bằng Ctrl+S, tự động hoàn thiện workflow và tối ưu hóa hiệu suất đa tác nhân.
Dự án microGPT-C tối ưu hóa bằng NEON đạt tốc độ suy luận ấn tượng 10,16 triệu token/giây. Với chỉ 4.192 tham số, mô hình này vượt trội hơn các mô hình nội suy truyền thống trong việc dự đoán tên gọi mà không cần phụ thuộc vào thư viện bên ngoài.
Great paper if you are building production-grade agents. It's a good way to understand what is actu…
DịchNghiên cứu từ DAIR.AI chỉ ra rằng trong các ứng dụng AI Agent thực tế, các thành phần ngoài LLM thường là nguyên nhân chính gây độ trễ. Các giải pháp tối ưu hóa như dịch vụ nhận diện tác vụ và bộ nhớ đệm có thể cải thiện đáng kể hiệu suất và giảm tài nguyên hệ thống.
Theo báo cáo từ Signal65, chip Snapdragon X2 Elite Extreme của Qualcomm cho thấy hiệu năng đa nhân vượt xa các đối thủ từ Intel và AMD trong điều kiện sử dụng pin, với tốc độ xử lý nhanh hơn tới 83% so với Ryzen AI 9 465 trong bài kiểm tra GeekBench 7.0.
Small quality of life improvements like this add up. More on the way
DịchBằng cách điều chỉnh cơ chế thu gom rác của Bun để chỉ chạy khi tiến trình rảnh rỗi, Claude Code CLI đã giảm đáng kể mức tiêu thụ CPU ở ngưỡng p99, giúp trải nghiệm người dùng mượt mà hơn.
Perf win of the day: Claude Code CLI now uses 2x less CPU at p99. Bun's garbage collector was runni…
DịchClaude Code CLI vừa cập nhật cơ chế quản lý bộ nhớ, chuyển việc dọn dẹp rác (GC) sang thời điểm nhàn rỗi thay vì chạy theo lịch trình cố định, giúp giảm một nửa mức tiêu thụ CPU trong các tác vụ nặng.
Beautiful visual of somebody running, qwen 3.8 27B locally on a RTX 5090 32 GB VRAM system with 115 …
DịchMột bản demo cho thấy Qwen3.8 27B đạt tốc độ ấn tượng 115 tokens/giây khi chạy local trên RTX 5090 32GB VRAM. Cần lưu ý rằng phiên bản BF16 gốc của mô hình này có dung lượng lên tới 55.6 GB.
Một lập trình viên đã sử dụng AI agent dựa trên Codex để tự động phân tích, đề xuất và kiểm chứng các giải pháp tối ưu hóa mã nguồn, giúp rút ngắn đáng kể thời gian tìm kiếm điểm nghẽn hiệu năng.
OpenAI đã tối ưu hóa việc tải các đoạn hội thoại dài, giảm số lượng yêu cầu mạng và bộ nhớ JS đáng kể, giúp thời gian tải giảm từ 27 giây xuống còn 1,66 giây. Điều này cho thấy OpenAI đang tập trung giải quyết nút thắt hiệu năng từ phía client trong kỷ nguyên AI agent.
Hype: Codex is rolling out a major performance update next week that should make very long conversat…
DịchCodex chuẩn bị tung bản cập nhật giúp tối ưu hóa đáng kể tốc độ tải các đoạn hội thoại dài, giảm thiểu bộ nhớ và số lượng yêu cầu. Trong thử nghiệm thực tế, thời gian tải trung bình đã rút ngắn ấn tượng từ 27,6 giây xuống còn 1,7 giây.
Grok 4.6 beats Claude Fable 5, Claude Opus 4.8, Gemini 3.1 Pro, GPT-5.5 and GPT-5.6 Sol on EEBench, …
DịchGrok 4.6 vừa thiết lập cột mốc mới khi đánh bại các mô hình hàng đầu như Claude Fable 5, Gemini 3.1 Pro và GPT-5.6 Sol trong bài kiểm tra kỹ thuật điện EEBench.
Google has released Gemini 3.7 Flash, improving 4 points over Gemini 3.6 Flash and reaching the Inte…
DịchGoogle vừa trình làng Gemini 3.7 Flash, đạt 56 điểm trên bảng xếp hạng Artificial Analysis. Phiên bản này thiết lập chuẩn mực mới khi cân bằng hoàn hảo giữa sức mạnh trí tuệ và tốc độ phản hồi siêu nhanh.
We're launching Optima. Now anyone can create a custom benchmark for their use case, leveraging Arti…
DịchOptima cho phép người dùng xây dựng bộ tiêu chuẩn đánh giá riêng dựa trên dữ liệu cá nhân hoặc HuggingFace, giúp so sánh chính xác chi phí, tốc độ và hiệu suất giữa các mô hình AI hàng đầu để tối ưu hóa lựa chọn.
Người dùng đang kiểm chứng lại các phản hồi trái chiều về độ ổn định giữa hai phiên bản mô hình 'Max' và 'High'. Điểm đáng chú ý là mô hình này có xu hướng đưa ra kết quả ngay lập tức mà không cần suy luận, giống như đã biết trước đáp án.
 Rohan Paul@rohanpaul_ai