DeepSeek vừa phát hành V4-Flash-Vision-Exp trên Hugging Face theo giấy phép MIT, đánh dấu bước tiến đầu tiên của dòng V4 trong việc hỗ trợ xử lý hình ảnh.
DeepSeek vừa phát hành mã nguồn mở mô hình DeepSeek-V4-Flash-Vision-Exp trên Hugging Face, sở hữu khả năng phân tích hình ảnh và văn bản mạnh mẽ, tiệm cận hiệu năng của Opus-4.8.
GLM 5.3 is now available in Perplexity Computer. Built for long-context, multimodal agent workloads…
DịchGLM 5.3 đã có mặt trên Perplexity, được tối ưu hóa cho các tác vụ đa phương thức và xử lý ngữ cảnh dài. Mô hình này đã vượt qua phiên bản tiền nhiệm trong bài kiểm tra WANDR về khả năng nghiên cứu chuyên sâu có dẫn chứng.
UrbanGround là sandbox đầu tiên dựa trên dữ liệu 3D toàn cảnh Hong Kong, cho phép kiểm thử khả năng điều hướng và nhận thức của các mô hình MLLM trong môi trường đô thị thực tế. Kết quả cho thấy AI hiện nay vẫn gặp khó khăn trong việc duy trì định hướng và lập kế hoạch dài hạn.
Aphanta là khung chẩn đoán tự động giúp đánh giá và cải thiện hiệu quả của các công cụ chỉnh sửa ảnh trong quy trình suy luận đa phương thức, giúp tăng đáng kể độ chính xác của các tác vụ phức tạp.
Video-IFBench là bộ tiêu chuẩn đánh giá chuyên sâu khả năng tuân thủ chỉ dẫn của các mô hình đa phương thức (MLLM) khi xử lý video, thông qua 1.500 mẫu thử nghiệm với độ phức tạp cao. Kết quả cho thấy các mô hình hiện nay vẫn gặp khó khăn lớn với các yêu cầu đa ràng buộc và cấu trúc phức tạp.
MA-VLA là khung làm việc mới giúp điều phối nhiều cánh tay robot thông qua việc phân tách nhiệm vụ thành các hành động nguyên tử, cho phép robot thực hiện các tác vụ phối hợp phức tạp ngay cả với những kịch bản chưa từng gặp.
The best of Qwen Live EP2, in under two minutes. What does it take for multimodal AI to get to work? …
DịchTóm tắt những điểm chính từ Qwen Live EP2 về các điều kiện cần thiết để AI đa phương thức có thể thực hiện công việc thực tế, cùng tầm nhìn về tương lai của các tác nhân AI có khả năng nhìn, nghe và hành động.
⚡Meet Qwen3.8-Flash, a multimodal MoE and an early preview of the Qwen4 architecture, now open-weigh…
DịchAlibaba giới thiệu Qwen3.8-Flash, mô hình MoE 125B với kiến trúc Qwen4 tiên tiến, chỉ kích hoạt 6B tham số mỗi token. Với chi phí huấn luyện bằng 1/9 bản tiền nhiệm và giá API cực rẻ, đây là bước tiến lớn về hiệu suất và khả năng xử lý ngữ cảnh lên tới 1 triệu token.
Alibaba chuẩn bị ra mắt Qwen3.8-Flash-Next, một mô hình đa phương thức dạng Mixture-of-Experts dựa trên kiến trúc Qwen4, nhằm giúp cộng đồng lập trình viên làm quen trước khi phiên bản chính thức trình làng.
Bài nghiên cứu đề xuất khung phân loại L0-L5 cho kính thông minh, định vị thiết bị này như một nền tảng AI thế hệ thứ nhất kết nối nhận thức con người với các hành động kỹ thuật số và vật lý.
STARFlow2 tích hợp dòng chuẩn hóa tự hồi quy vào LLM, tận dụng cấu trúc chung để tạo ảnh đa phương thức mà không làm giảm độ trung thực của hình ảnh như phương pháp token hóa rời rạc.
Sau thời gian dài chỉ tập trung vào văn bản, DeepSeek vừa ra mắt API hỗ trợ xử lý hình ảnh, đánh dấu bước tiến quan trọng để phát triển các AI Agent phức tạp hơn.
DeepSeek vừa bổ sung khả năng xử lý hình ảnh vào nền tảng API với phiên bản thử nghiệm DeepSeek-V4-Flash-Vision-Exp, đánh dấu bước tiến mới trong hệ sinh thái mô hình của hãng.
DeepSeek vừa giới thiệu mô hình đa phương thức V4-Flash-Vision-Exp với khả năng suy luận văn bản mạnh mẽ và hiệu suất tiệm cận Opus 4.8 trong các bài kiểm tra tác tử AI. Mô hình hỗ trợ API linh hoạt, cho phép xử lý tới 600 ảnh mỗi yêu cầu với chi phí tối ưu.
Got confirmation on what the Ox Alpha model is. Can't disclose anything yet, but I can confirm it'…
DịchMô hình Ox Alpha vừa được xác nhận là một bước tiến đột phá, hứa hẹn thay đổi hoàn toàn cục diện về khả năng của các tác nhân AI đa phương thức trong tương lai gần.
DeepSeek vừa trình làng mô hình thị giác máy tính V4-Flash-Vision-Exp với khả năng hiểu hình ảnh vượt trội, tiệm cận hiệu suất của Opus-4.8. Dịch vụ đã sẵn sàng trên API với cơ chế tính phí theo token linh hoạt, hỗ trợ đa dạng phương thức truyền tải hình ảnh.
🥷 New stealth model: Ox Alpha Ox Alpha is a frontier model built for efficient coding, sustained a…
DịchOpenRouter vừa giới thiệu Ox Alpha, mô hình AI mới hỗ trợ cửa sổ ngữ cảnh 1 triệu token, xử lý đa phương thức (văn bản, hình ảnh, video) và được tối ưu hóa cho lập trình cũng như vận hành tác vụ tự động.
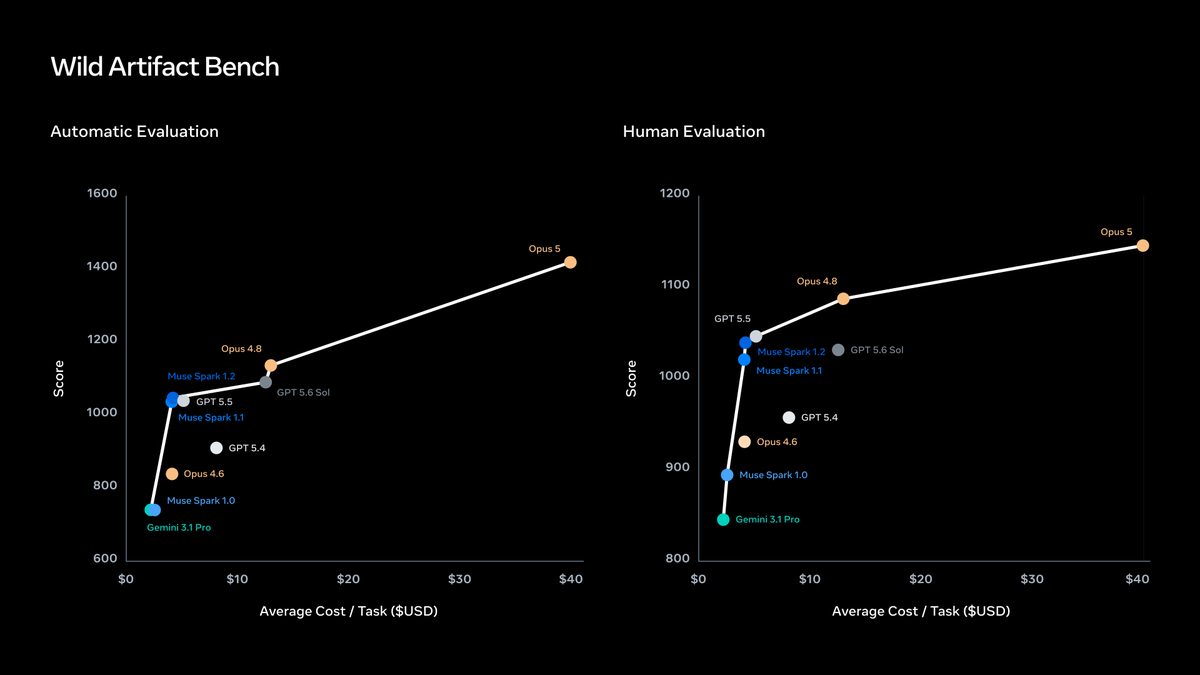
Today we're also previewing WildArtifactBench, an internal evaluation framework designed to assess a…
DịchMeta giới thiệu WildArtifactBench, bộ khung đánh giá sử dụng hệ thống Elo và đánh giá từ con người để đo lường hiệu suất của các tác nhân đa phương thức trong môi trường thực tế thay vì các đáp án cứng nhắc.
Great walkthrough of MiniCPM-o 4.5 by @LearnOpenCV! Unlike traditional turn-based multimodal system…
DịchMiniCPM-o 4.5 là mô hình mã nguồn mở 9B đột phá, hỗ trợ tương tác toàn song công (full-duplex) cho phép xử lý đồng thời video, âm thanh và phản hồi giọng nói theo thời gian thực, mang lại trải nghiệm AI tự nhiên hơn.
VibeWorlding là khung làm việc toàn diện giúp các tác nhân đa phương thức tự động hiểu ý định, lập kế hoạch và xây dựng thế giới 3D tương tác thông qua bộ dữ liệu chuẩn VWE-BENCH.
Thử nghiệm PerceptionBench từ Moonshot AI cho thấy các mô hình AI hàng đầu đều chưa đạt 60% độ chính xác trong việc nhận diện hình ảnh, chứng minh lỗi suy luận thường bắt nguồn từ khâu đọc hình ảnh kém.
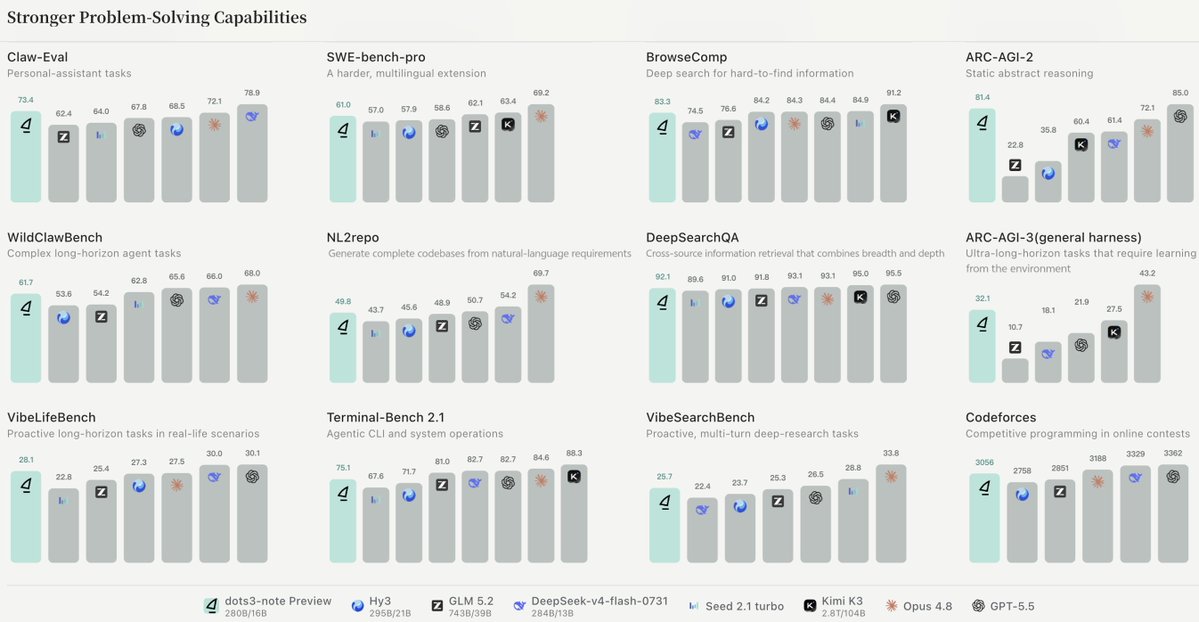
Nice: RedNote just open-sourced dots3-note Preview, a 280b multimodal MoE built for agents that oper…
DịchRedNote vừa công bố bản xem trước của dots3-note, mô hình MoE 280B chỉ kích hoạt 16B tham số, hỗ trợ cửa sổ ngữ cảnh 512K cùng khả năng xử lý đa phương thức từ văn bản, hình ảnh đến video và âm thanh.
MBA-Bench là bộ tiêu chuẩn đột phá với 30.000 mẫu dữ liệu đa phương thức, giúp huấn luyện và đánh giá các tác nhân AI trong việc phân tích và sáng tạo ý tưởng kinh doanh dựa trên các tín hiệu hình ảnh thực tế.