Sản phẩm
Google ra mắt kiến trúc cơ sở dữ liệu AlloyDB cho AI Agent, mở bản xem trước AlloyDB PostgreSQL for agents
(giờ Việt Nam)
Tóm tắt AI
Google Cloud giới thiệu kiến trúc cơ sở dữ liệu mới cho AI Agent, sử dụng MCP kết nối với các microVM tách biệt để đảm bảo hiệu năng và bảo mật dữ liệu mà không ảnh hưởng đến cụm sản xuất.
Chính văn · Bản dịch AI

Toàn bộ sự nghiệp kỹ thuật cơ sở dữ liệu đã được dành ra để giải quyết một câu hỏi duy nhất: Làm thế nào để mở rộng quy mô (scale) khối lượng công việc OLTP mà không làm ảnh hưởng đến hệ thống lưu trữ dữ liệu gốc (system of record)?
Exadata đã trả lời câu hỏi này bằng cách giảm tải các truy vấn sang tầng lưu trữ mở rộng (scale-out storage tier) bên dưới cơ sở dữ liệu, loại bỏ mạng lưới như một điểm nghẽn. Azure SQL Hyperscale thực hiện điều đó với các máy chủ khối chia sẻ (shared block servers), mở rộng quy mô lên hàng chục bản sao đọc (read replicas). Aurora giảm tải việc áp dụng nhật ký (log application) sang các nút lưu trữ phân tán, mở rộng quy mô đọc trên hàng chục nút PostgreSQL. Trong khi đó, các kiến trúc mới nổi lưu trữ dữ liệu trong bộ lưu trữ đối tượng (object storage) truyền thống với một tầng bộ nhớ đệm (cache tier) được cấp phát phía trước, khôi phục độ trễ cho dữ liệu nóng nhưng lại để lại độ trễ cao (high-latency tail) mỗi khi xảy ra lỗi bộ nhớ đệm (cache miss).
Mỗi kiến trúc này vốn dĩ bị hạn chế bởi ít nhất một trong ba thuộc tính: quy mô (scale), độ trễ (latency) và tính cô lập (isolation) — và đôi khi là cả hai. Ví dụ, các kiến trúc được xây dựng trên máy chủ khối chia sẻ làm ảnh hưởng đến khả năng mở rộng, vì I/O chắc chắn sẽ bị nghẽn tại máy chủ khối. Chúng cũng hy sinh tính cô lập, vì khối lượng công việc sản xuất (production workloads) bị điều tiết bất cứ khi nào lưu lượng truy cập của bản sao tăng đột biến.
Một số đánh đổi này thực sự hợp lý vào thời điểm đó; chúng đáp ứng các yêu cầu về khối lượng công việc cơ sở dữ liệu doanh nghiệp trong bốn thập kỷ. Tuy nhiên, trong kỷ nguyên tác nhân (agentic era), những sự thỏa hiệp này không còn chấp nhận được nữa. Các khối lượng công việc của tác nhân được tạo ra một cách linh hoạt và không thể kiểm duyệt trước, khiến việc cô lập chúng khỏi các hệ thống quan trọng trở thành yêu cầu cấp thiết để đảm bảo tính liên tục trong kinh doanh. Các khối lượng công việc của tác nhân cũng đòi hỏi độ trễ thấp, điều chỉ có thể đạt được với toàn bộ sức mạnh của công cụ cơ sở dữ liệu và tất cả các chỉ mục (indexes) của nó, cũng như một cấp độ mở rộng linh hoạt (elastic scale) hoàn toàn mới chưa từng được thử nghiệm với một cơ sở dữ liệu đơn lẻ: một đợt bùng nổ các tác nhân yêu cầu 1.000 nút tính toán trên một cơ sở dữ liệu duy nhất trong vài giây, và có thể kết thúc trong vòng một phút.
Ba nguyên tắc cần thiết cho một kiến trúc cơ sở dữ liệu thực sự mang tính tác nhân (agentic)
Chúng tôi tin rằng kỷ nguyên tác nhân đòi hỏi một kiến trúc cơ sở dữ liệu tác nhân mới được xác định bởi ba nguyên tắc cơ bản. Một kiến trúc cơ sở dữ liệu tác nhân phải thỏa mãn cả ba, nếu không thì nó không thực sự là "agentic".
- Nguyên tắc: Tính cô lập (Isolation) — cô lập theo thiết kế, nhưng vẫn truy cập dữ liệu thời gian thực. Các tác nhân phải đọc dữ liệu sản xuất trực tiếp với độ tươi mới dưới một giây thông qua đường dẫn dữ liệu không chia sẻ các thành phần cơ sở dữ liệu với cụm chính (primary cluster). Thời gian thực nghĩa là cập nhật đến từng giây, không phải là bản sao cũ hay nhánh dữ liệu. Đây là sự tách biệt vật lý, không phải hạn ngạch (quota) — vì phân bổ chia sẻ đồng nghĩa với chung số phận. Ranh giới kéo dài xuyên suốt qua tầng lưu trữ, loại bỏ sự tranh chấp tài nguyên theo thiết kế.
- Nguyên tắc: Độ trễ (Latency) — I/O cơ sở dưới một mili giây. Khối lượng công việc vận hành đòi hỏi I/O khối dưới một mili giây, và tiêu chuẩn đó không được giảm đối với các tác nhân. Trong khi các nút tính toán tận dụng DRAM và SSD cục bộ để tăng tốc, các lỗi bộ nhớ đệm (cache misses) chạm đến bộ lưu trữ từ xa — dù là ứng dụng hay tác nhân — phải hoàn thành trong vòng chưa đầy một mili giây. Một kiến trúc bị suy giảm hiệu suất theo cấp số nhân về cơ bản là không thể sử dụng được bởi các tác nhân.
- Nguyên tắc: Quy mô (Scale) — tính toán và I/O ở quy mô tác nhân. Quy mô tác nhân đồng thời mang tính tức thời, biến động và khổng lồ: Các nút tính toán cơ sở dữ liệu phải khởi động trong vài giây, mở rộng lên hàng nghìn nút, chạy trong các đợt bùng nổ ngắn và tự động tắt về không khi các tác nhân hoàn thành công việc. Cho đến nay, chưa ai từng mơ đến việc yêu cầu một cơ sở dữ liệu mở rộng tính toán và I/O một cách linh hoạt lên hàng nghìn nút trong khi vẫn giữ nguyên hệ thống sản xuất. Do tính chất năng động của các tác nhân, việc cấp phát trước (pre-provisioning) là điều không khả thi trên toàn bộ ngăn xếp (stack), dù là tính toán, I/O lưu trữ hay bất kỳ tầng bộ nhớ đệm nào ở giữa.
Quan trọng nhất, một kiến trúc tác nhân phải duy trì cả ba nguyên tắc cùng một lúc. Bằng cách đó, kiến trúc cho phép các tác nhân làm việc trực tiếp trên dữ liệu vận hành trực tiếp, tức là sự thật của doanh nghiệp, mà không làm ảnh hưởng đến sự ổn định của hệ thống sản xuất. Kết quả mang tính chuyển đổi:
- Không có lỗi tương quan: Sự tách biệt hoàn toàn giữa các công cụ vận hành doanh nghiệp và các đội ngũ tác nhân suy luận trên đó giúp loại bỏ con đường khiến các tác nhân ảnh hưởng đến hệ thống sản xuất.
- Không cần đoán định công suất: Khả năng co giãn thực sự giúp loại bỏ sự ma sát của việc cấp phát trước cho quy mô tác nhân không thể dự báo.
- Không thỏa hiệp về ngữ nghĩa: Không có gì bị giữ lại đối với các tác nhân — chúng có quyền truy cập vào toàn bộ sức mạnh của SQL quan hệ, tìm kiếm kết hợp (vector, toàn văn, không gian) và các chỉ mục trong mỗi bước suy luận.
Kiến trúc tác nhân của AlloyDB
Kiến trúc cơ sở dữ liệu tác nhân mới của AlloyDB là hệ thống đầu tiên thỏa mãn cả ba nguyên tắc. Chúng tôi đã thiết kế hệ thống này từ đầu trên toàn bộ các tầng lưu trữ, mạng, tính toán và cơ sở dữ liệu để mang lại:
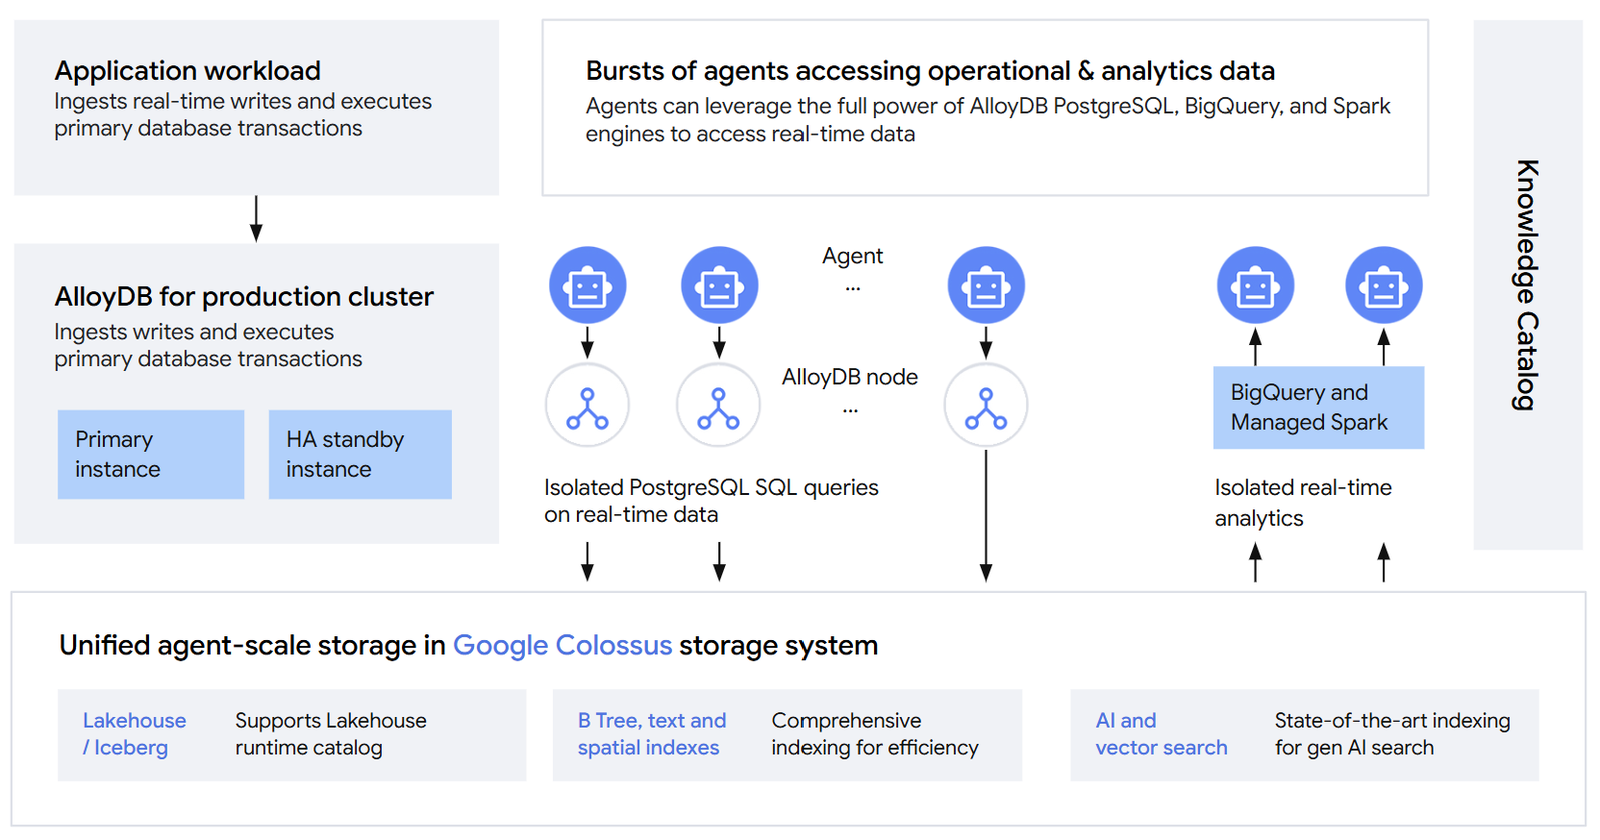
- Tính cô lập, tránh chung số phận theo thiết kế: Cụm sản xuất giao dịch chạy trên cơ sở hạ tầng chuyên dụng, được cấp phát trước, hoàn toàn tách biệt với khối lượng công việc của tác nhân. Các tác nhân giao tiếp thông qua Model Context Protocol (MCP) với một nhóm các nút AlloyDB dựa trên microVM tạm thời, đọc trực tiếp từ các phân đoạn lưu trữ Colossus chuyên dụng, tách biệt với các phân đoạn dành cho sản xuất.
- I/O lưu trữ dưới một mili giây có thể dự đoán được: Mỗi lần đọc lưu trữ đều được phục vụ trực tiếp bởi hệ thống lưu trữ Colossus của Google, kế thừa độ trễ cơ sở dưới một mili giây, loại bỏ các điểm rơi hiệu suất khi xảy ra lỗi bộ nhớ đệm lạnh (cold cache misses).
- Khả năng mở rộng tính toán từ 0 đến hàng nghìn thực sự: Nhóm tác nhân mở rộng nhanh chóng từ 0 lên hàng nghìn nút cho các hoạt động tác nhân bùng nổ, và thu nhỏ về 0 ngay khi các tác vụ hoàn thành.
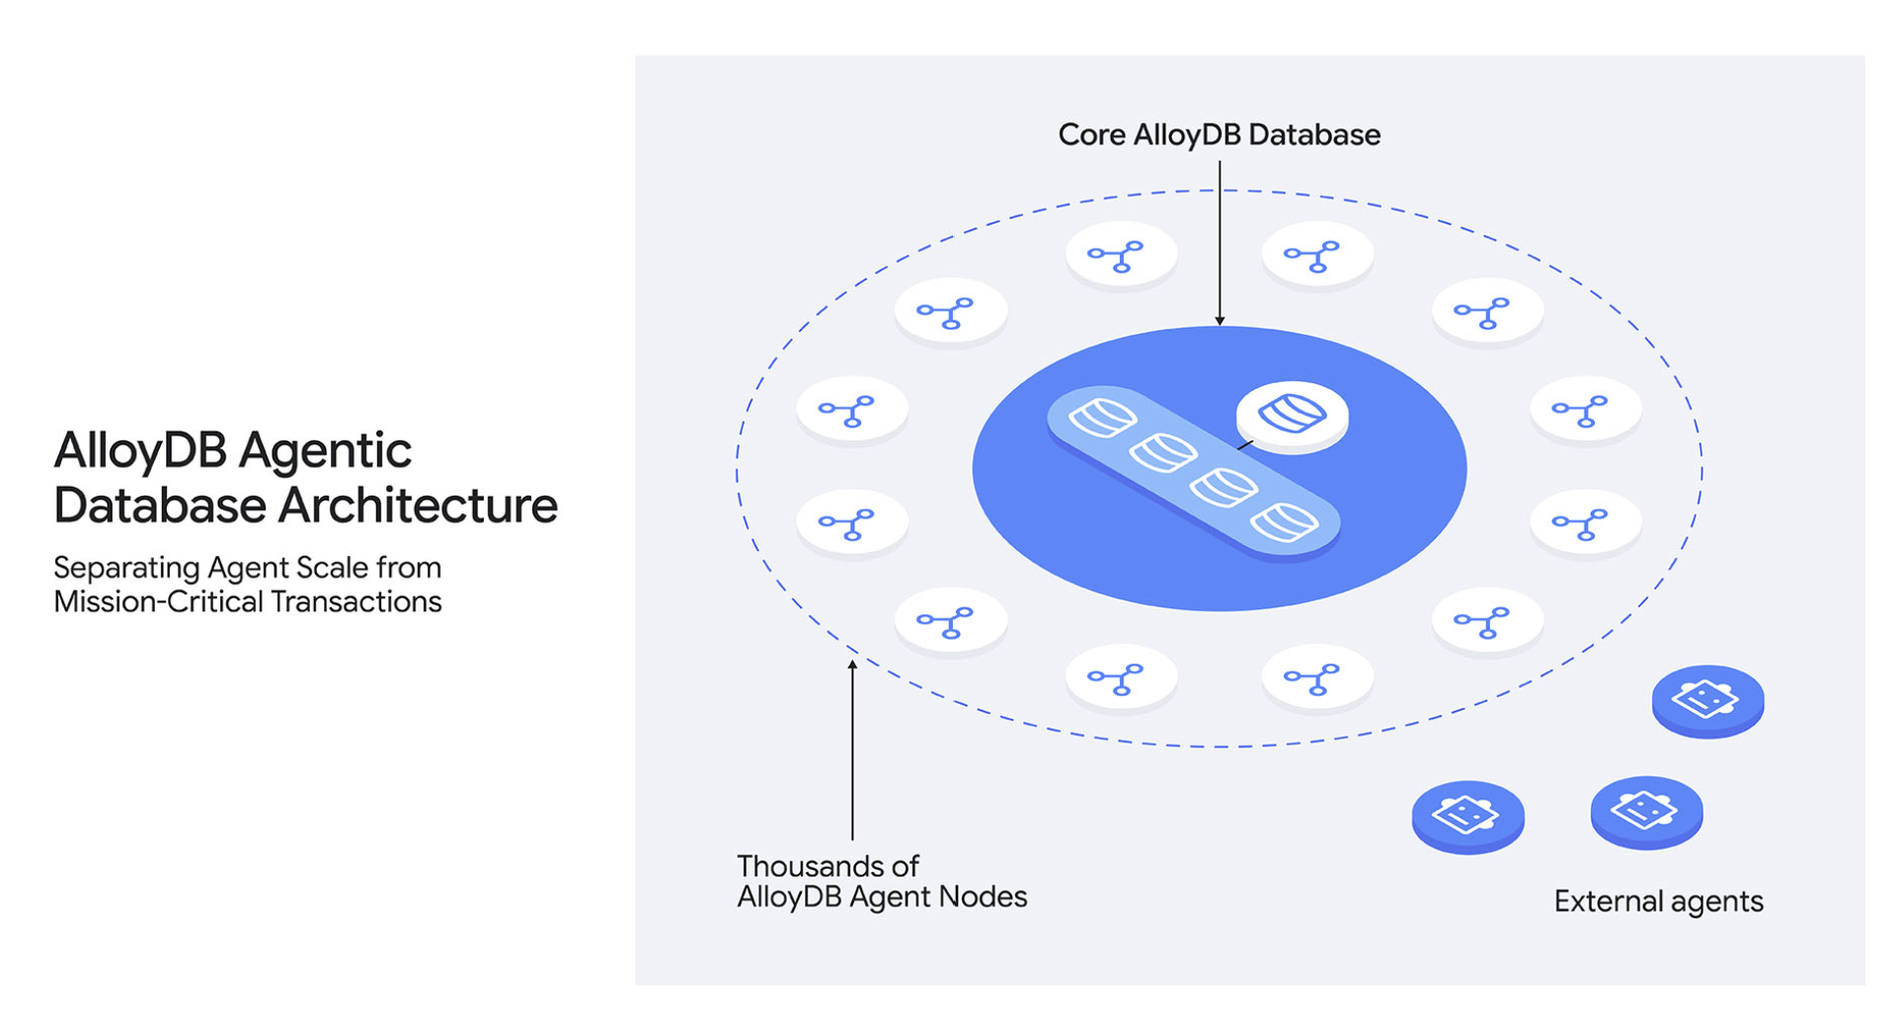
Các tác nhân truy vấn dữ liệu sản xuất với độ tươi mới dưới một giây, với toàn bộ công cụ PostgreSQL — tra cứu điểm, duyệt chỉ mục, tìm kiếm vector, toàn văn và không gian, quét cột và truy vấn liên kết trên lakehouse — theo ý muốn để thúc đẩy các vòng lặp suy luận của chúng.
Tại sao các kiến trúc hiện tại không thể thỏa mãn cả ba nguyên tắc
Các cơ sở dữ liệu vận hành truyền thống và mới nổi cố gắng mở rộng quy mô bằng cách sử dụng một trong ba mô hình kiến trúc. Khi được đánh giá dựa trên các yêu cầu của tác nhân AI tự hành, mỗi mô hình đều thể hiện một sự thỏa hiệp cấu trúc cơ bản — không có mô hình nào thỏa mãn đồng thời cả ba nguyên tắc.
Các bản sao độc lập (lưu trữ chia sẻ không dùng chung - shared-nothing storage)
Các kiến trúc quan hệ truyền thống mở rộng quy mô đọc bằng cách truyền phát nhật ký sao chép (replication logs) từ một thực thể chính đến các cơ sở dữ liệu bản sao chuyên dụng, mỗi bản sao có bộ lưu trữ khối cục bộ hoặc đính kèm riêng. Chúng đáp ứng Nguyên tắc: Tính cô lập – các bản sao không chia sẻ tài nguyên vật lý với cụm chính, và việc sao chép nhật ký liên tục duy trì tính cập nhật gần như thời gian thực. Chúng đáp ứng Nguyên tắc: Độ trễ – bộ lưu trữ cục bộ chuyên dụng đảm bảo độ trễ đọc dưới một mili giây có thể dự đoán được. Tuy nhiên, chúng thất bại ở Nguyên tắc: Quy mô – việc mở rộng quy mô đòi hỏi phải cấp phát một bản sao mới và nạp lại hàng trăm gigabyte hoặc terabyte dữ liệu. Tất cả những việc này mất hàng giờ — một sự không tương thích không thể chấp nhận được đối với các đợt bùng nổ suy luận của tác nhân được tính bằng giây. Hơn nữa, việc tính toán và lưu trữ được cấp phát tĩnh tiếp tục gây ra chi phí nhàn rỗi rất lâu sau khi tác nhân hoàn thành công việc.
Các máy chủ lưu trữ chia sẻ phân tách (Disaggregated shared-storage servers)
Cách tiếp cận thứ hai tách biệt các nút tính toán không trạng thái (stateless compute nodes) khỏi một tầng lưu trữ tùy chỉnh, đa người thuê (multi-tenant) dùng chung, nơi quản lý tính bền vững, sao chép và có thể giảm tải việc ghi khối (block writes). Cách tiếp cận này đáp ứng Nguyên tắc: Độ trễ – các lệnh đọc truy cập vào các máy chủ lưu trữ được tối ưu hóa sẽ được giải quyết với độ trễ vận hành thấp và nhất quán. Tuy nhiên, nó không đáp ứng được Nguyên tắc: Cô lập – vì mọi bản sao (replica) đều đọc từ cùng các máy chủ với bản chính (primary), nên I/O của tác nhân (agent I/O) cạnh tranh trực tiếp với I/O sản xuất, tạo ra tình trạng chung số phận (shared fate). Nó cũng không đáp ứng được Nguyên tắc: Quy mô – các bản sao tính toán không trạng thái khởi động nhanh chóng vì không có dữ liệu nào được sao chép, nhưng tổng băng thông I/O lưu trữ bị cố định ở tầng lưu trữ đã được cấp phát trước. Việc thêm các nút tính toán mà không mở rộng dung lượng I/O cơ sở chỉ làm tăng tốc độ bão hòa và điều tiết (throttling) lưu trữ.
Lưu trữ đối tượng (Object storage) với các máy chủ khối chia sẻ (shared-block servers)
Cách tiếp cận mới thứ ba giữ cho dữ liệu bền vững trong lưu trữ đối tượng mục đích chung và phục vụ các lệnh đọc khối từ một tầng máy chủ khối chia sẻ. Vì một lệnh đọc ngẫu nhiên từ lưu trữ đối tượng mất hàng chục mili giây — chậm hơn một bậc so với lưu trữ cơ sở dữ liệu truyền thống và chậm hơn so với mảng đĩa doanh nghiệp trong ít nhất 25 năm qua — các máy chủ khối lưu giữ dữ liệu nóng để phục vụ với độ trễ thấp. Cách tiếp cận này đáp ứng Nguyên tắc: Độ trễ — với một lưu ý: Một lệnh truy vấn không tìm thấy dữ liệu trên máy chủ khối (block server miss) vẫn sẽ chuyển xuống lưu trữ đối tượng với độ trễ cao không thể chấp nhận được. Nó không đáp ứng được Nguyên tắc: Cô lập — vì các bản sao chia sẻ máy chủ khối với hệ thống sản xuất: I/O của tác nhân và I/O sản xuất sử dụng cùng một dung lượng, vì vậy khi dung lượng đó bị cạn kiệt hoặc bị điều tiết, hệ thống sản xuất sẽ bị ảnh hưởng cùng với các tác nhân. Nó cũng không đáp ứng được Nguyên tắc: Quy mô, vì lý do tương tự như các máy chủ lưu trữ chia sẻ: Các bản sao khởi động nhanh, nhưng các máy chủ khối không mở rộng I/O theo sự bùng nổ nhu cầu.
Một số kiến trúc trong nhóm này cũng cho phép các công cụ phân tích như Apache Spark đọc trực tiếp lưu trữ đối tượng cơ sở, bỏ qua công cụ cơ sở dữ liệu. Đối với khối lượng công việc phân tích, đó là một con đường khả thi và có giá trị. Tuy nhiên, vì các tác nhân cần truy xuất độ trễ thấp, việc loại bỏ các chỉ mục (indexes), tra cứu điểm (point lookups) và tìm kiếm vector buộc phải thực hiện quét bảng kiểu vét cạn (brute-force table scans), làm tăng vọt độ trễ, và do đó phá vỡ khả năng thực thi các vòng lặp truy xuất-suy luận của tác nhân.
Đánh giá các kiến trúc hiện có
Chúng tôi đã đánh giá một dịch vụ thương mại sử dụng kiến trúc lưu trữ đối tượng với các máy chủ khối chia sẻ bằng cách chạy các lệnh tra cứu chỉ mục đồng thời trên một tập dữ liệu lớn hơn DRAM hiện có, kiểm tra cả giới hạn mở rộng và sự cô lập sản xuất. Bắt đầu với một phiên bản đọc duy nhất, chúng tôi đã mở rộng khối lượng công việc bằng cách thêm tối đa tám bản sao đọc.
Trong các kiến trúc có tài nguyên vật lý chia sẻ, việc mở rộng các tác nhân thông qua bản sao đọc sẽ nhanh chóng làm giảm hiệu suất của cả bản sao và bản chính. Trong các thử nghiệm của chúng tôi như thấy trong biểu đồ bên dưới, việc thêm các bản sao chỉ mang lại mức tăng thông lượng dưới 2 lần, đạt đỉnh ở bốn bản sao trước khi giảm xuống do băng thông máy chủ khối chia sẻ bị bão hòa.

Tác động lên cơ sở dữ liệu chính là ngay lập tức và nghiêm trọng: Thông lượng chính giảm hơn 75% khi các bản sao được thêm vào.

Tóm lại, cả kiến trúc truyền thống lẫn kiến trúc mới đều không thể đáp ứng quy mô mà các tác nhân yêu cầu, và chắc chắn không thể thực hiện mà không gây nguy hiểm cho sự ổn định của các hệ thống sản xuất.
Đánh giá dựa trên các Nguyên tắc
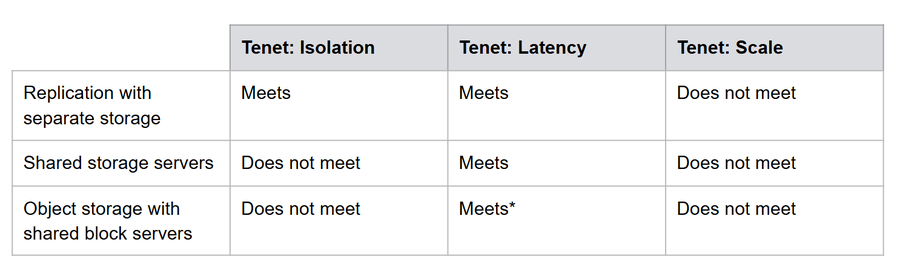
* Đáp ứng một phần: Dữ liệu nóng được phục vụ với độ trễ thấp từ các máy chủ khối, nhưng một lệnh truy vấn không tìm thấy dữ liệu trên máy chủ khối sẽ chuyển xuống lưu trữ đối tượng với độ trễ hàng chục mili giây.
Trong mỗi trường hợp, khoảng cách là về mặt cấu trúc, không chỉ là vấn đề tinh chỉnh. Việc sao chép tạo sự cô lập bằng cách cung cấp cho mỗi bản sao bộ lưu trữ riêng, vì vậy nó không thể thêm bản sao nhanh hơn tốc độ điền dữ liệu vào bộ lưu trữ đó. Các máy chủ lưu trữ chia sẻ thêm khả năng tính toán nhanh chóng bằng cách chia sẻ lưu trữ, vì vậy chúng không thể cô lập cũng không thể mở rộng I/O. Các máy chủ khối trên lưu trữ đối tượng khôi phục độ trễ bằng một tầng được cấp phát, vì vậy chúng không thể cô lập cũng không thể xử lý đột biến, và mọi lệnh truy vấn không tìm thấy dữ liệu vẫn chạm đến lưu trữ đối tượng. Mỗi cách tiếp cận giải quyết vấn đề ở một lớp và phải trả giá ở lớp khác. Để đáp ứng cả ba nguyên tắc cùng lúc đòi hỏi phải suy nghĩ lại về kiến trúc cơ sở dữ liệu trên toàn bộ hệ thống tính toán, mạng và lưu trữ.
Cách chúng tôi thiết kế AlloyDB trên toàn bộ ngăn xếp
Kiến trúc cơ sở dữ liệu tác nhân của AlloyDB được tích hợp theo chiều dọc trên toàn bộ ngăn xếp dữ liệu, AI và cơ sở hạ tầng của Google: các mô hình AI, công cụ cơ sở dữ liệu và công cụ phân tích, cũng như cơ sở hạ tầng lưu trữ, mạng và tính toán.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Google Cloud: Databases. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.