Thủ thuật
LlamaIndex: Tại sao mô hình trích xuất tốt hơn không giúp giảm hàng đợi kiểm duyệt tài liệu
(giờ Việt Nam)
Tóm tắt AI
LlamaIndex chỉ ra rằng khả năng đọc hiểu không quyết định tỷ lệ tự động hóa, mà là cơ chế phân loại (routing). Thay vì chỉ tăng độ chính xác, việc tích hợp chỉ số tin cậy (confidence score) giúp hệ thống tự động xử lý tài liệu hiệu quả hơn đáng kể.
Bản dịch AI
Một nhóm thay thế mô hình trích xuất trong quy trình xử lý tài liệu của họ. Độ chính xác của các trường dữ liệu trên tập kiểm thử nội bộ tăng từ 94% lên 97%. Đó là một bước tiến thực sự và họ đã mất gần một quý để đạt được. Sau đó, họ kiểm tra hàng đợi ngoại lệ (exception queue) và thấy nó vẫn giữ nguyên kích thước như trước.
Những lời giải thích thông thường được đưa ra rất nhanh. Tập kiểm thử không mang tính đại diện. Mô hình mới bị suy giảm hiệu suất trên một loại tài liệu nào đó mà không ai kiểm tra. Đôi khi điều đó đúng. Nhưng thường xuyên hơn, mô hình thực sự đã tốt hơn, và nó tốt hơn ở những thứ mà quy trình không dựa vào đó để điều hướng.
Xử lý tài liệu OCR là quy trình đưa tài liệu từ khâu tiếp nhận, qua nhận dạng ký tự quang học để chuyển pixel thành văn bản máy có thể đọc được, sau đó là trích xuất trường dữ liệu, xác thực và cuối cùng là đưa vào hệ thống lưu trữ. Công cụ OCR chỉ là một giai đoạn trong quy trình đó. Độ chính xác của giai đoạn này hóa ra lại là một chỉ số dự báo yếu đến bất ngờ về khối lượng công việc thực sự được tự động hóa, và lý do chẳng liên quan gì đến việc mô hình đọc tốt đến mức nào.
Yếu tố quyết định kết quả là liệu hệ thống có biết nó đã trích xuất sai trường nào hay không. Đó là một đặc tính khác biệt so với việc trích xuất đúng, nó có thể đo lường được, nhưng hầu như không ai đo lường nó.
Có một sự lệch pha về đơn vị đo lường ẩn giấu trong mọi dự án tự động hóa tài liệu, và nó vẫn tồn tại vì hai con số liên quan được trích dẫn bởi những người khác nhau.
Các nhà cung cấp báo cáo độ chính xác trên mỗi trường dữ liệu. Bộ phận vận hành đo lường khả năng xử lý thông suốt (straight-through processing) trên mỗi tài liệu: tỷ lệ tài liệu đi thẳng vào hệ thống lưu trữ mà không cần con người can thiệp. Hai con số này có mẫu số khác nhau và khoảng cách giữa chúng ngày càng lớn.
Hãy lấy ví dụ một hóa đơn AP với 20 trường dữ liệu được trích xuất, một cấu trúc dữ liệu khiêm tốn. Với độ chính xác 97% mỗi trường, xác suất để cả 20 trường đều đúng là 0,97²⁰, hay khoảng 54%. Gần một nửa số tài liệu chứa ít nhất một trường sai. Chỉ cần một trường sai là đủ để gửi toàn bộ tài liệu cho con người xử lý, vì bạn không thể hạch toán một hóa đơn với tài khoản thanh toán sai rồi gọi đó là 95% đã hạch toán.
Nếu đẩy độ chính xác mỗi trường lên 99%, tỷ lệ tài liệu sạch sẽ tăng lên khoảng 82%. Nếu giảm xuống 94%, tỷ lệ này sẽ sụt giảm xuống còn 29%.
Đó là một mô hình lý tưởng hóa và cần phải thành thật về điều này: trên thực tế, các lỗi trường dữ liệu không độc lập với nhau. Một bản quét kém chất lượng thường làm hỏng nhiều trường cùng lúc, điều này tập trung các lỗi vào ít tài liệu hơn và làm cho các con số thực tế có vẻ khả quan hơn so với tính toán lý thuyết. Tuy nhiên, xu hướng vẫn giữ nguyên. Độ sạch của tài liệu suy giảm nhanh hơn nhiều so với độ chính xác của từng trường, đó là lý do tại sao việc tăng 3 điểm độ chính xác lại chỉ được đội ngũ vận hành coi là sai số làm tròn.
Trong mô hình này, bước nhảy từ 94% lên 97% giúp tăng tỷ lệ tài liệu sạch từ 29% lên 54%. Đó là một cải tiến thực sự và rất đáng kể. Tuy nhiên, nó vẫn để lại 46% tài liệu có lỗi, và đây mới là phần quyết định kích thước hàng đợi: quy trình hoàn toàn không biết 46% đó là những tài liệu nào.
Độ chính xác ở cấp độ trường là cần thiết nhưng chưa đủ. Việc chỉ theo đuổi độ chính xác trích xuất đơn thuần chỉ mang lại cho bạn một mô hình tốt hơn nhưng hàng đợi vẫn y nguyên.
Tỷ lệ tự động hóa của bạn được quyết định tại cổng điều hướng
Mọi tài liệu trong quy trình sản xuất đều đi qua cùng một ngã rẽ. Nó được tự động hạch toán hoặc được gửi cho con người. Phải có thứ gì đó đưa ra quyết định này, và thứ mà nó dựa vào để quyết định chính là tín hiệu tin cậy (confidence signal).
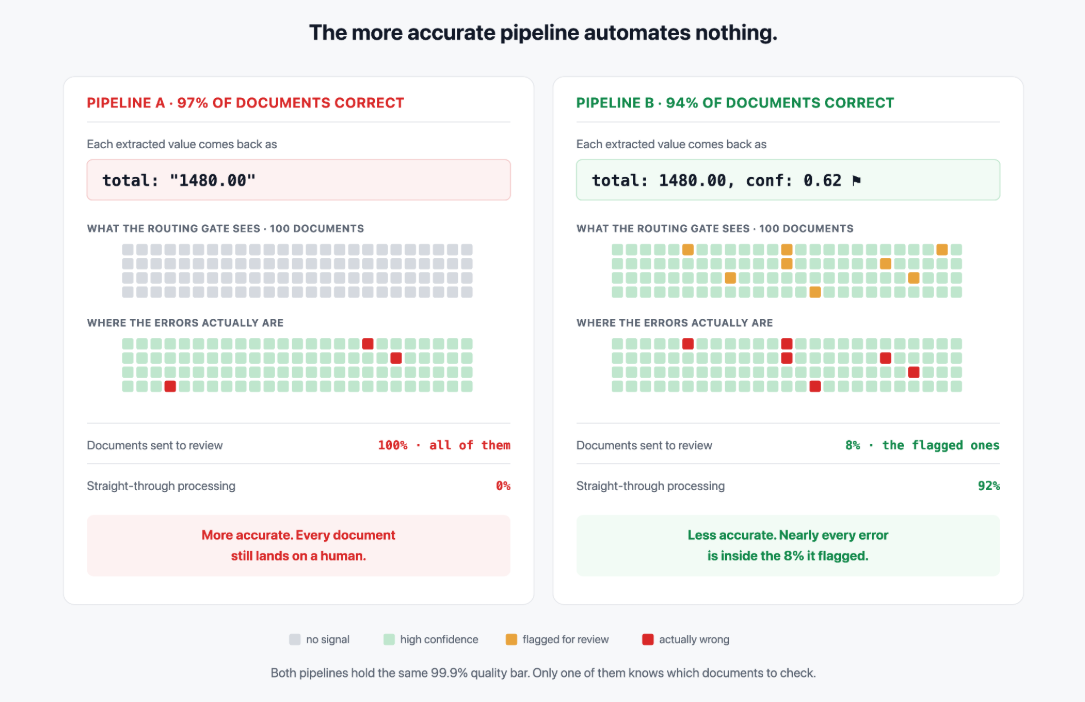
Điều đó có nghĩa là khả năng xử lý thông suốt là một đặc tính của điểm tin cậy, chứ không phải của độ chính xác nằm phía sau chúng. Hãy xét hai quy trình với cùng tài liệu và cùng tiêu chuẩn chất lượng 99,9%. Hãy đọc các con số này dưới dạng cấp độ tài liệu, tức là tỷ lệ tài liệu hoàn toàn chính xác, vì đó là kết quả thực tế từ các phép tính trên:
Quy trình A đạt 97% tài liệu hoàn toàn đúng và chỉ trả về các chuỗi văn bản thuần túy. Không có tín hiệu tin cậy cho từng trường. 3% tài liệu sai bị ẩn đi, không có cách nào phân biệt chúng với 97% còn lại. Để giữ tiêu chuẩn chất lượng, con người phải xem xét mọi thứ, vì vậy khả năng xử lý thông suốt bằng không. Giải pháp thay thế là tự động hạch toán tất cả và chấp nhận tỷ lệ sai sót 3% vào sổ sách, điều mà không kiểm soát viên nào chấp nhận. 97% đó chẳng mang lại giá trị gì.
Quy trình B đạt 94% tài liệu hoàn toàn đúng, kém hơn 3 điểm, nhưng nó trả về điểm tin cậy cho từng trường, và các điểm số đó tách biệt các giá trị đúng khỏi giá trị sai. Sự không chắc chắn của nó được tập trung lại: khoảng 8% tài liệu chứa ít nhất một trường có độ tin cậy thấp, và gần như toàn bộ 6% tài liệu thực sự sai đều nằm trong 8% được gắn cờ đó. Chỉ cần xem xét 8% này, tự động hạch toán 92% còn lại, và tiêu chuẩn chất lượng được đảm bảo.
Quy trình B kém chính xác hơn 3 điểm, nhưng nó tự động hóa được 92% khối lượng công việc mà Quy trình A phải đẩy cho con người. Sự đảo ngược đó chính là chìa khóa của vấn đề, và đó là lý do tại sao việc chỉ mua độ chính xác một cách đơn lẻ là cách chắc chắn nhất để lãng phí một quý mà không thay đổi được gì.
Các phạm vi tự động hóa được công bố thường được trích dẫn như thể độ chính xác tạo ra chúng. Phân tích về OCR tác tử (agentic OCR) của LlamaIndex cho thấy OCR truyền thống đạt 60-80% khả năng xử lý thông suốt, trong khi các phương pháp tác tử đạt 90-95%+, và cái nhìn tổng quan về AI tài liệu cũng cho kết quả tương tự. Những con số đó là có thật. Cơ chế đằng sau chúng là chất lượng điều hướng, không phải kỹ năng đọc thô.
Một tín hiệu tin cậy cần phải là gì trước khi bạn có thể dựa vào nó để điều hướng
Một con số từ 0 đến 1 gắn liền với một kết quả trích xuất không tự nhiên trở nên hữu ích. Để có thể dùng nó làm cổng kiểm soát, nó phải thỏa mãn hai điều kiện.
Hầu hết các tín hiệu mà các đội ngũ hiện có đều thất bại ở một hoặc cả hai bài kiểm tra sau:
Dòng Textract là thứ mà hầu hết các đội ngũ nghĩ rằng họ đã giải quyết xong. Textract có trả về độ tin cậy cho mỗi cặp khóa-giá trị, nhưng con số đó đang đo lường một thứ hẹp hơn vẻ ngoài của nó. Trong ví dụ tài liệu của chính AWS, cặp dữ liệu đạt điểm 51,6 trong khi các từ riêng lẻ bên trong nó đạt 99,5 trở lên. Hai con số đó không hề mâu thuẫn. Công cụ đã đọc "Ana Carolina" gần như hoàn hảo nhưng lại gần như tung đồng xu khi quyết định liệu "Ana Carolina" có phải là thứ thuộc về bên cạnh nhãn "Name:" hay không. Đó là thông tin thực sự về bố cục, nhưng nó vẫn không phải là khẳng định về việc giá trị đó có chính xác hay không.
Dòng cuối cùng đó mới là thứ thay đổi hiệu quả kinh tế, và nó hiếm gặp trong thực tế sản xuất hơn so với những gì quảng cáo gợi ý.
Tỷ lệ bắt lỗi (Catch Rate): Con số dự báo tỷ lệ tự động hóa của bạn
Đây là chỉ số đáng để thêm vào bảng điều khiển của bạn: trong số các tài liệu mà quy trình của bạn xử lý sai, nó đã gắn cờ được bao nhiêu phần trăm?
Hãy gọi đó là tỷ lệ bắt lỗi (catch rate) hoặc độ thu hồi lỗi (error recall). Nó rất rẻ để tính toán vì chỉ cần nhật ký sửa lỗi của bạn, và nó là chỉ số dự báo trần tự động hóa tốt hơn nhiều so với độ chính xác. Một công cụ không có đầu ra độ tin cậy sẽ có tỷ lệ bắt lỗi bằng không bất kể độ chính xác là bao nhiêu, đó là lý do chính thức tại sao độ chính xác đơn thuần không thể mua được sự tự động hóa. Quy trình A ở trên là một hệ thống chính xác 97% với tỷ lệ bắt lỗi bằng không. Quy trình B là một hệ thống chính xác 94% với tỷ lệ bắt lỗi gần bằng 1.
Tỷ lệ bắt lỗi và ngưỡng xem xét của bạn cùng nhau quyết định khả năng xử lý thông suốt tại một tiêu chuẩn chất lượng nhất định. Độ chính xác chỉ là một đầu vào cho quá trình đó, và chỉ là một trong số nhiều yếu tố.
Các bài kiểm tra chuẩn (benchmarks) thường chạy trên các tập dữ liệu sạch. Việc tiếp nhận tài liệu trong sản xuất thì không như vậy, và quy trình thường bị rò rỉ ngay cả trước khi công cụ OCR được gọi. Không có điều nào trong số đó xuất hiện trong con số độ chính xác, bởi vì một tài liệu chưa bao giờ được phân tích thì chưa bao giờ được chấm điểm.
Các lỗi tiếp nhận rất nhàm chán và dai dẳng: các tệp PDF được bảo vệ bằng mật khẩu và khóa quyền, ảnh HEIC chụp bằng điện thoại rồi gửi qua email, ảnh chụp màn hình, các tệp tải lên bị cắt xén hoặc có dung lượng 0-byte, các tệp Office được đổi tên thành.pdf. Sau đó là các bản fax đến ở độ phân giải 200 DPI trong khi mức tối thiểu để nhận dạng đáng tin cậy là 300, và các tập tài liệu 900 trang chứa mười hai loại tài liệu khác nhau cần phải được tách và phân loại trước khi có thể trích xuất bất kỳ trường dữ liệu nào.
Một nền tảng xử lý tài liệu âm thầm loại bỏ 4% dữ liệu đầu vào đã tự giới hạn khả năng xử lý thông suốt của nó ở mức 96% trước khi mô hình kịp làm bất cứ điều gì. Các hiệu ứng trần (ceiling effects) tích tụ dần qua các giai đoạn và chúng vô hình đối với mọi chỉ số hướng vào bộ trích xuất.
Điều khác mà hầu hết các quy trình bỏ qua là tín hiệu thứ hai. Xác thực dựa trên thứ gì đó bên ngoài mô hình: các dòng mục phải cộng lại bằng tổng số đã nêu, mã kiểm tra (checksum) của MRZ và số định tuyến, ngày dịch vụ phải nằm trong thời hạn hợp đồng, ID nhà cung cấp phải tồn tại trong bảng tham chiếu. Xác thực chéo giữa các trường giúp tăng tỷ lệ bắt lỗi cụ thể vì nó không tương quan với độ tin cậy của chính mô hình. Nó bắt được những lỗi mà mô hình cảm thấy "tự tin", và đó chính là những lỗi gây hại nhất.
Xây dựng tín hiệu thay vì mua thêm độ chính xác
Nếu việc điều hướng quyết định kết quả, câu hỏi cần đặt ra cho nhà cung cấp giải pháp xử lý tài liệu thông minh không còn là họ chính xác đến mức nào, mà là những gì đi kèm với mỗi giá trị trả về. Dù sao thì độ chính xác cũng đã trở thành tiêu chuẩn cơ bản trong hầu hết lĩnh vực OCR hiện nay. Đầu ra có thể điều hướng được mới là thứ khan hiếm.
LlamaParse xử lý lớp phân tích bằng thị giác máy tính nhận diện bố cục, phân đoạn trang trước khi bất kỳ thứ gì cố gắng đọc nó, vì vậy một bảng được xử lý như một bảng và một tập tài liệu 900 trang được tách thành các tài liệu thành phần trước. Sự điều phối tác tử (agentic orchestration) điều hướng từng phần tử đến mô hình đọc tốt nhất, với bộ tối ưu hóa chi phí giúp tránh phải trả phí cho các mô hình VLM tiên tiến trên một trang văn bản thuần túy. Mỗi trang đều mang theo nguồn gốc quay trở lại nơi xuất phát.
Bản thân tín hiệu điều hướng nằm trong LlamaExtract, trả về độ tin cậy cho từng trường dựa trên cấu trúc dữ liệu bạn định nghĩa. Sự khác biệt đó rất quan trọng trong thực tế, và hai sản phẩm này thực hiện các công việc khác nhau: phân tích cú pháp mang lại cấu trúc trung thực từ các bố cục phức tạp và trích xuất mang lại dữ liệu có cấu trúc, tuân thủ lược đồ mà hệ thống hạ nguồn thực sự có thể hạch toán.
Đó là hình dáng của một đầu ra có thể điều hướng, và đó là sự khác biệt giữa một hệ thống trích xuất tài liệu tự động và một đống văn bản mà bạn vẫn phải trông chừng. Điểm tin cậy chỉ ra trường dữ liệu nghi vấn. Trích dẫn cho phép người xem xét xác nhận nó dựa trên các pixel gốc trong vài giây thay vì phải đọc lại trang, đó là điều biến việc xem xét có sự tham gia của con người từ một dấu mộc thủ tục thành một sự kiểm soát thực sự. Các vòng lặp xác thực bắt được các kiểu ảo tưởng (hallucination) đã biết trước khi giá trị chạm đến cổng, giúp tăng tỷ lệ bắt lỗi thay vì chỉ thúc đẩy độ chính xác.
Điều này thay thế giai đoạn trích xuất thay vì nằm sau Tesseract hoặc Textract như một bước làm sạch, và các đội ngũ áp dụng nó theo cách đó sẽ thừa hưởng giới hạn của bất cứ thứ gì chạy trước. Kiến trúc tương tự là thứ tạo ra sự khác biệt trong tự động hóa tài liệu vay, trích xuất dữ liệu hóa đơn và trích xuất dữ liệu tài chính, nơi hàng đợi xem xét là toàn bộ trung tâm chi phí.
Giới hạn của tự động hóa chính là những gì quy trình của bạn biết về chính nó
Bài viết được AI dịch và tổng hợp tự động từ LlamaIndex: Sản phẩm、. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.