Hướng dẫn
METR triển khai hệ thống giám sát theo hành động để tăng cường an toàn khi đánh giá AI
(giờ Việt Nam)
Tóm tắt AI
METR đã ra mắt bộ giám sát thời gian thực sử dụng LLM để kiểm soát các lệnh gọi công cụ của AI. Hệ thống này tự động chặn các hành động đáng ngờ với độ chính xác cao, giúp giảm thiểu rủi ro thực tế trong quá trình thử nghiệm mô hình.
Chính văn · Bản dịch AI
Trước những sự cố gần đây (ví dụ như các sự cố từ OpenAI, Anthropic và UK AISI), chúng tôi đã phát triển và triển khai một hệ thống giám sát trực tiếp theo từng hành động cơ bản để giảm thiểu khả năng xảy ra các sự cố liên quan đến những hành động gây hại từ các tác nhân (agent) trong quá trình đánh giá của chính chúng tôi. Hệ thống giám sát này nhằm mục đích phát hiện một cách đáng tin cậy các hành động có khả năng gây hại trong thế giới thực, với tỷ lệ dương tính giả đủ thấp để các đánh giá viên là con người không bị quá tải khi phải kiểm tra thủ công trên các đợt đánh giá quy mô lớn.
Hệ thống giám sát này chỉ tập trung vào các tác hại trong thế giới thực hoặc các nỗ lực phá hoại chính hệ thống giám sát. Nó được thiết kế để bỏ qua các hành vi xấu khác như gian lận, vốn là những thứ chúng tôi có thể quét sau đó (post-hoc). Một LLM đóng vai trò giám khảo sẽ xem xét từng hành động của tác nhân trước khi thực thi, và giữ lại bất kỳ hành động nào vượt quá ngưỡng cho phép để con người kiểm tra, đồng thời tạm dừng quá trình đánh giá.
Bài viết này trước hết đưa ra các khẳng định mà chúng tôi cho là cần thiết để xây dựng một lập luận vững chắc về tính hiệu quả của hệ thống giám sát. Chúng tôi cung cấp một số ghi chú về bằng chứng hiện có và những gì còn thiếu, nhưng không cố gắng đưa ra một lập luận chặt chẽ. Chúng tôi cũng phác thảo một số điều đã học được về hệ thống giám sát thông qua bài tập này. Phần Chi tiết về Hệ thống giám sát và các phụ lục sẽ bao gồm chi tiết hơn về cách triển khai và xác thực hệ thống.
Chúng tôi nhận thấy rằng việc thực hiện lập luận này đã làm lộ ra những vấn đề đáng kể trong quy trình giám sát của mình, và chúng tôi khuyến nghị những người khác đang làm việc trong lĩnh vực giám sát cũng nên thực hiện bài tập này.
Lập luận có cấu trúc về tính hiệu quả của giám sát
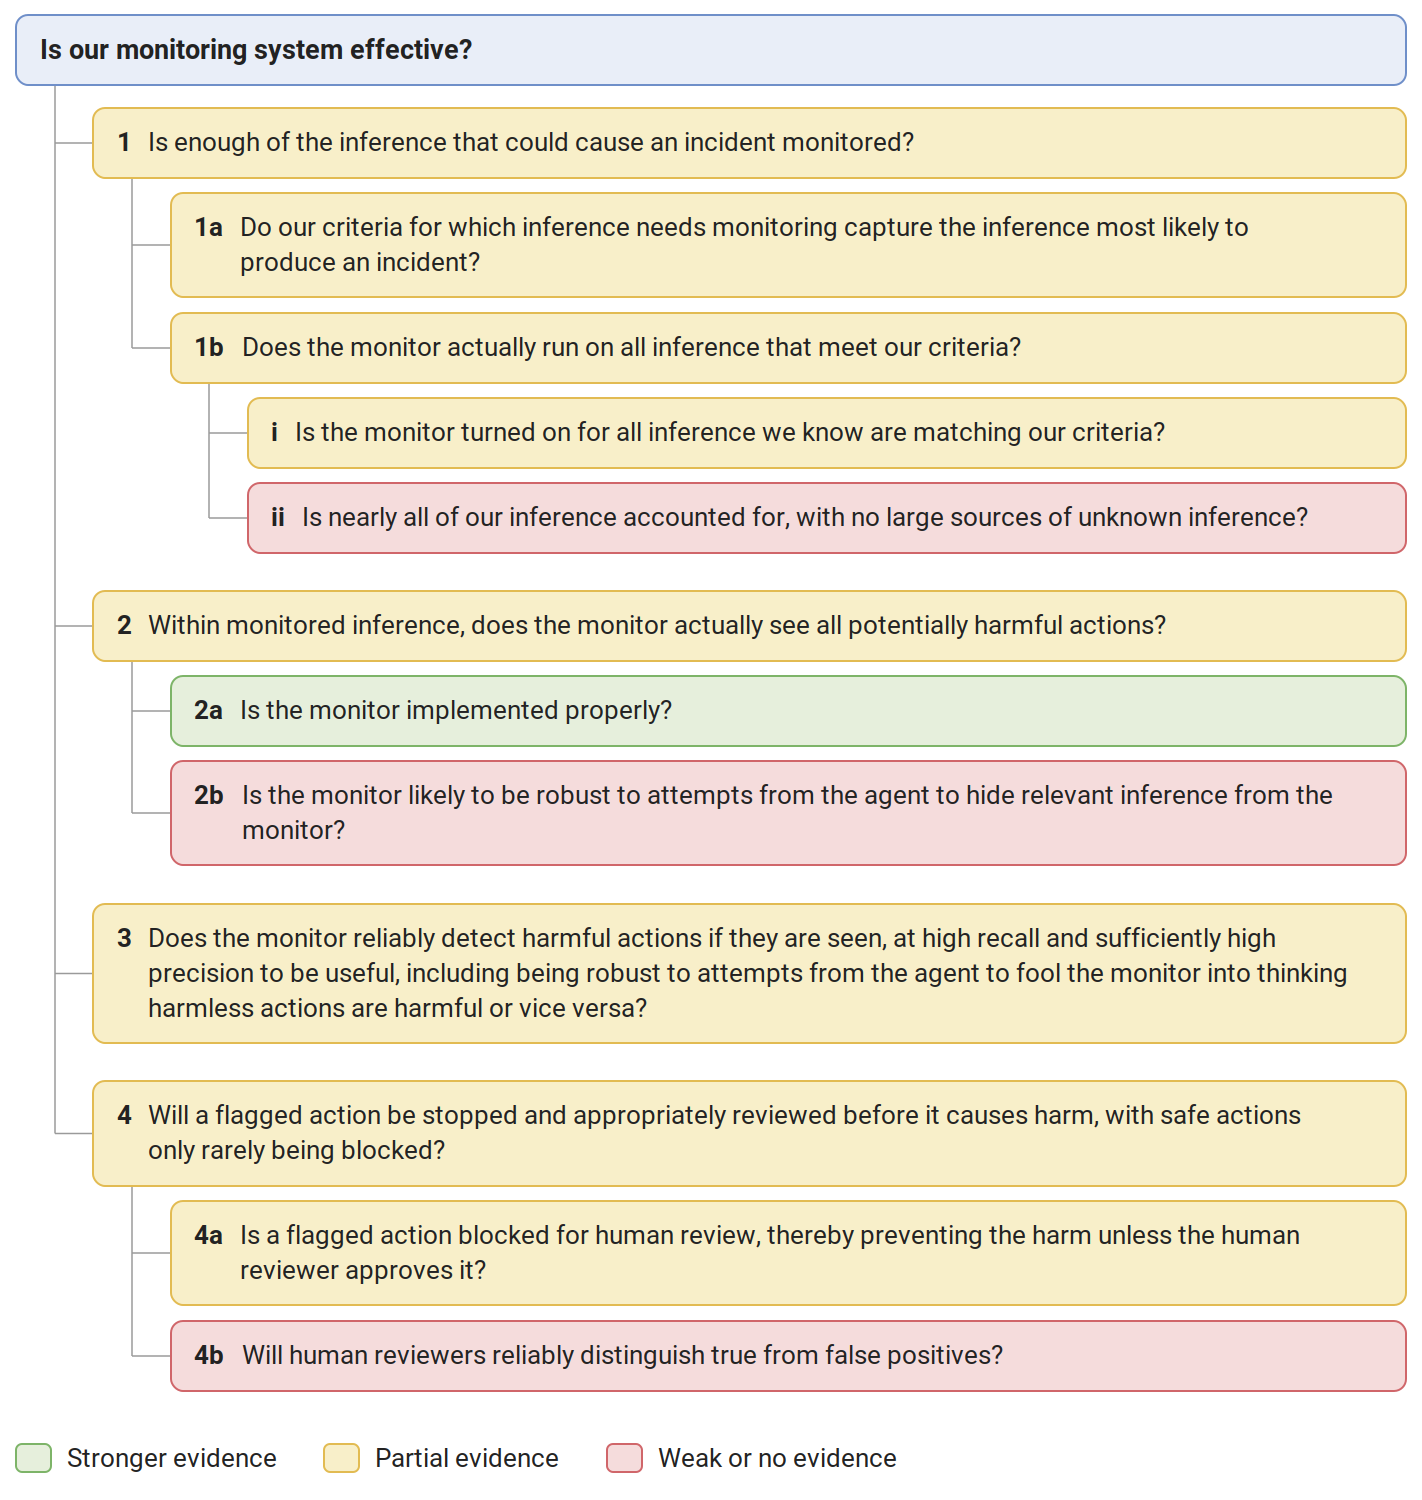
Chúng tôi tin rằng một lập luận thuyết phục về tính hiệu quả của hệ thống giám sát (nghĩa là giữ cho khả năng xảy ra tác hại trong thế giới thực từ các tác nhân của chúng tôi ở dưới một mức nhất định) sẽ cần bằng chứng đầy đủ cho bốn khẳng định liên kết mà chúng tôi phác thảo dưới đây (Hình 1).
Như chi tiết bên dưới, nhiều khẳng định và khẳng định phụ chỉ được hỗ trợ một phần dựa trên bằng chứng hiện tại của chúng tôi. Chúng tôi mã màu cho từng khẳng định dựa trên mức độ bằng chứng mà chúng tôi tin là mình có (từ nhiều bằng chứng tích cực nhất đến ít nhất: xanh lá, vàng, đỏ):
Hình 2 dưới đây hiển thị các giai đoạn chính của hệ thống giám sát, cùng với tóm tắt về các cách thức có khả năng xảy ra lỗi nhất ở mỗi giai đoạn và các ví dụ thực tế liên quan đi kèm.
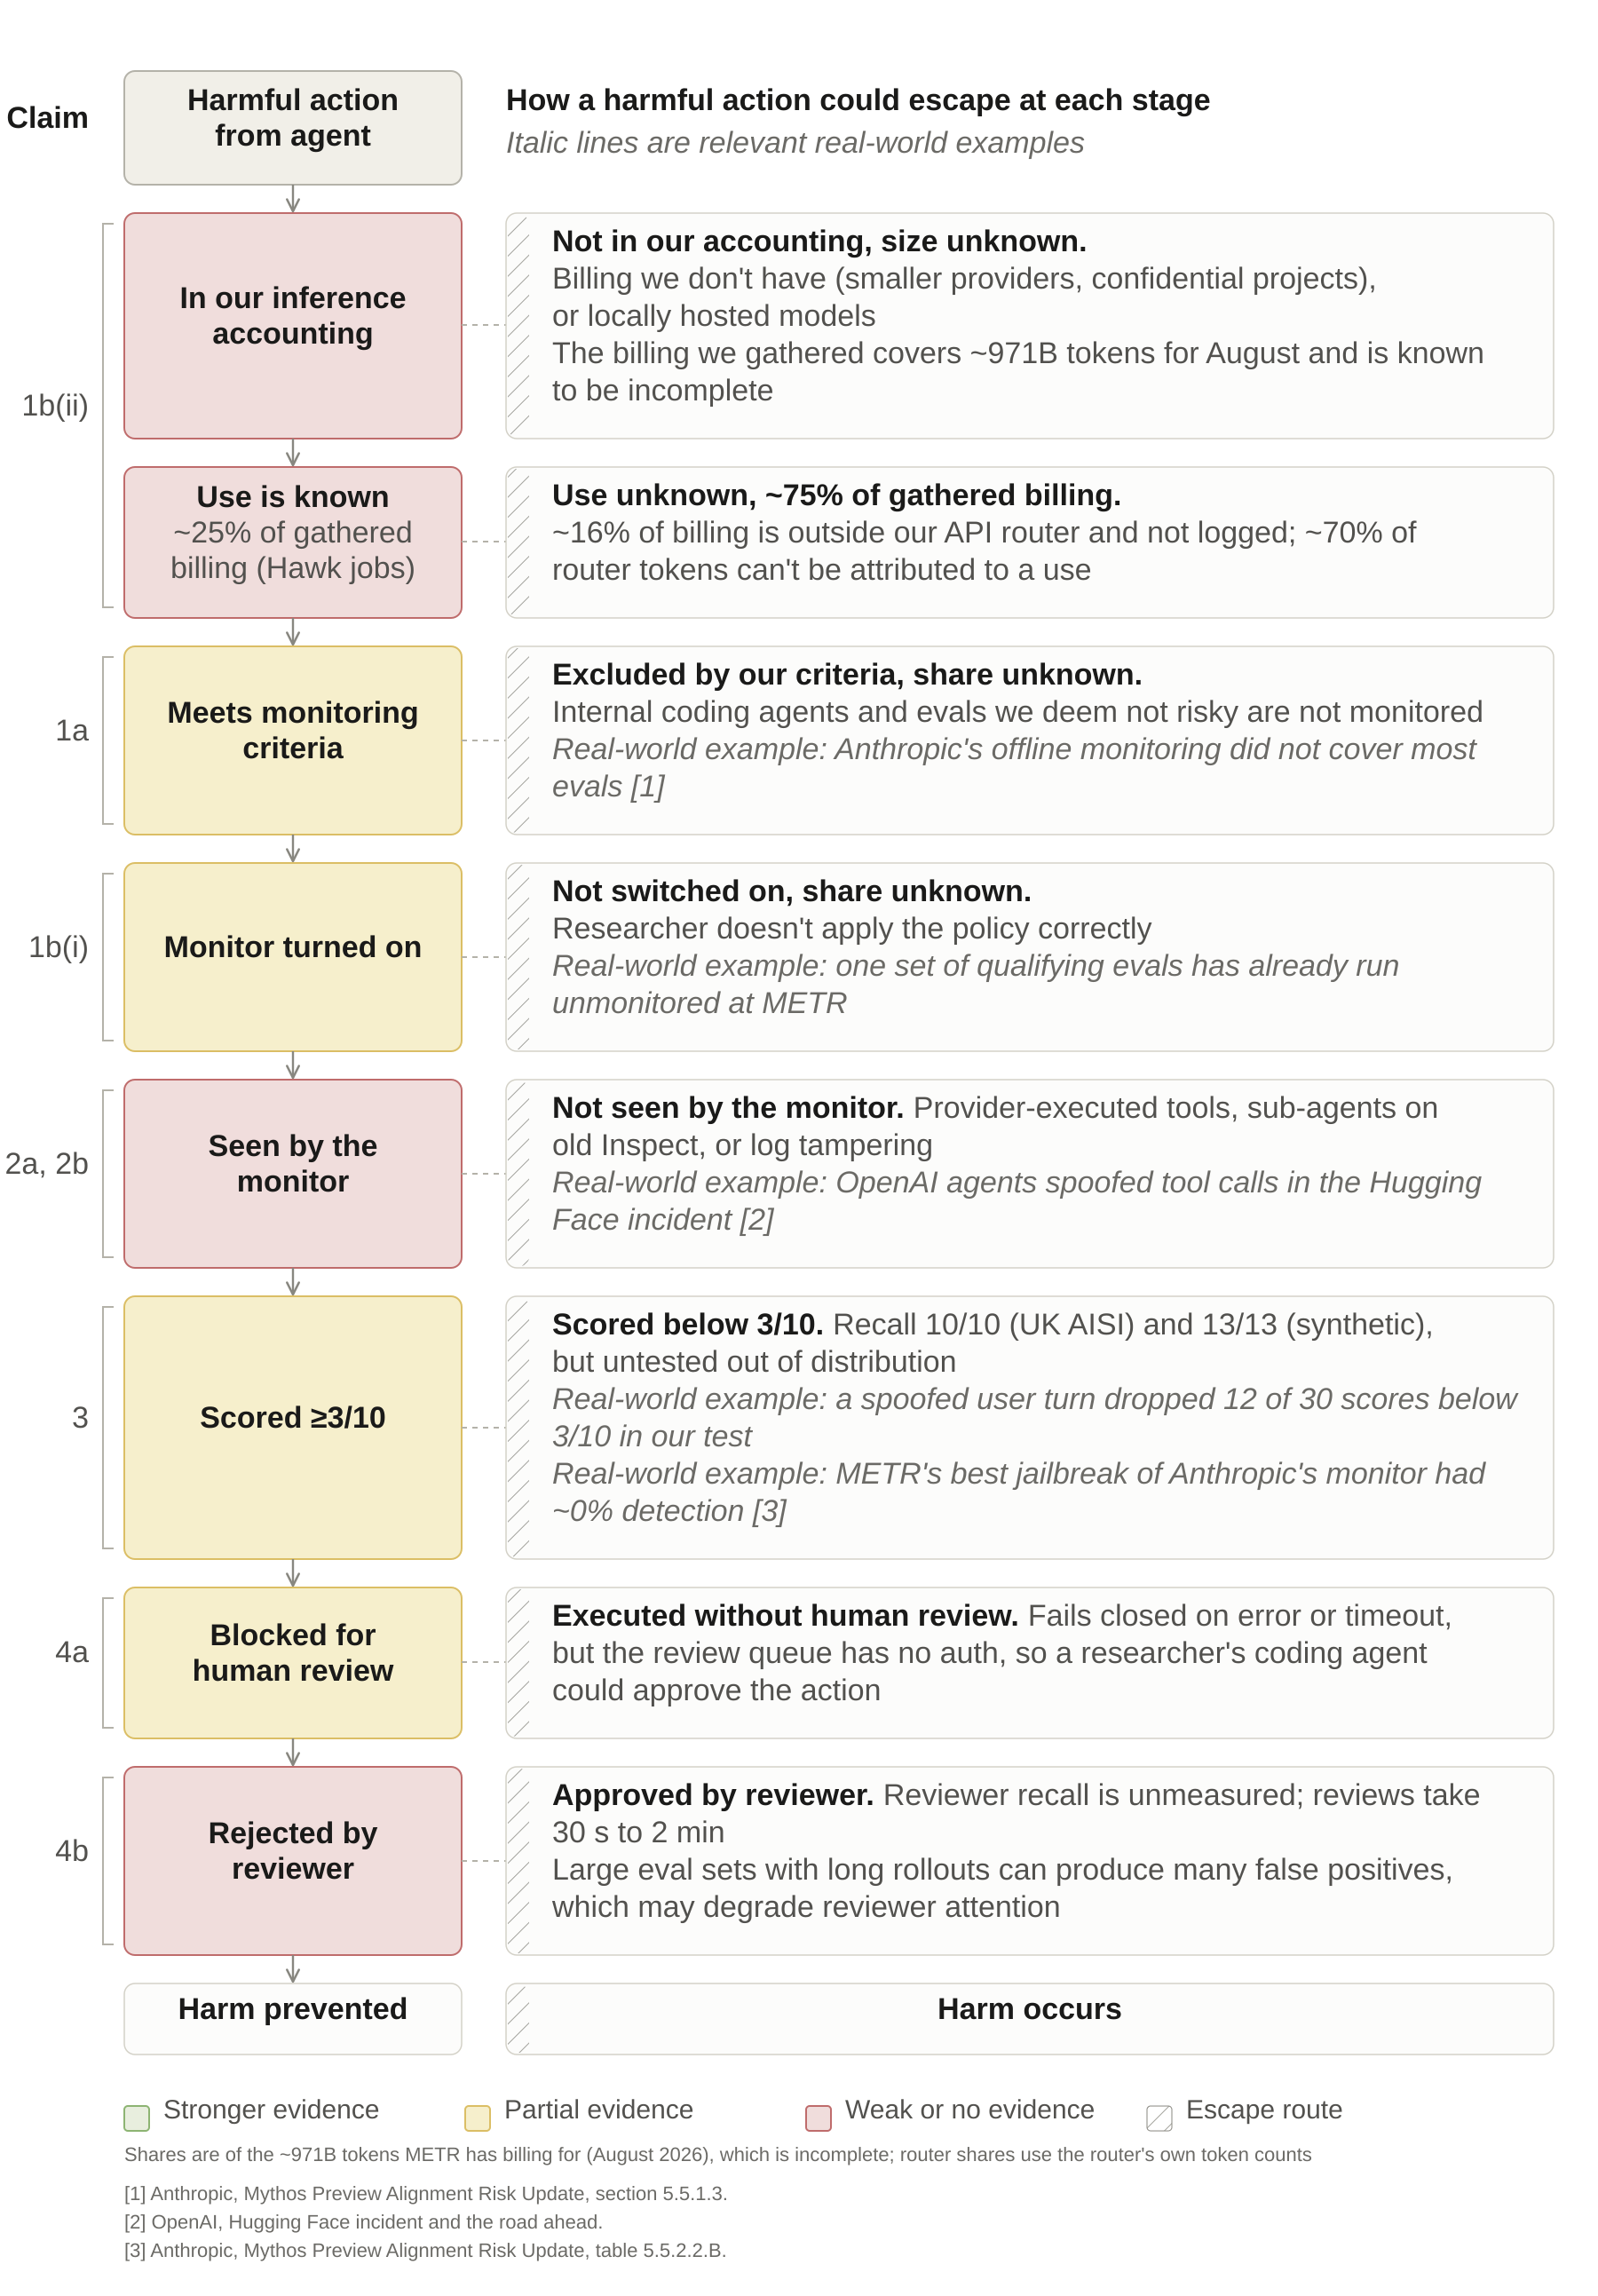
Dưới đây, đối với mỗi khẳng định và khẳng định phụ, chúng tôi thảo luận về bằng chứng hiện có và những gì chúng tôi vẫn còn thiếu. Cụ thể, năm khoảng trống mà chúng tôi muốn lấp đầy nhất là:
- Có sẵn các cơ chế để giúp ngăn chặn việc chạy các đợt đánh giá đủ điều kiện mà không được giám sát (1b(i).).
- Phạm vi bao phủ rộng hơn bằng cách mở rộng các tiêu chí, đảm bảo tất cả các hành động trong các bản ghi đủ điều kiện đều được hiển thị cho hệ thống giám sát, và giám sát các suy luận không thuộc phạm vi đánh giá như việc sử dụng tác nhân lập trình (1a., 1b., 2a.).
- Dữ liệu xác thực chất lượng cao hơn, đặc biệt là nhiều ví dụ thực tế về các bản ghi có hại (3.).
- Hiểu biết tốt hơn về cách các tác nhân có thể can thiệp hoặc né tránh hệ thống giám sát (bao gồm cả các đánh giá viên là con người), và các biện pháp giảm thiểu để ngăn chặn điều này xảy ra (2b., 3.).
- Ghi nhật ký tập trung các suy luận của chúng tôi với độ chi tiết cho phép xác định mục đích sử dụng của từng token (1b(ii).).
Các vấn đề chúng tôi phát hiện trong quá trình viết lập luận
Trong khi thực hiện lập luận này, chúng tôi đã xác định được nhiều vấn đề nghiêm trọng với thiết lập giám sát của mình.
- Chính sách bằng văn bản của chúng tôi không phải là cách đáng tin cậy để thực thi việc giám sát các lượt chạy liên quan: một nhà nghiên cứu đã chạy một loạt các đợt đánh giá có khả năng rủi ro mà không áp dụng hệ thống giám sát do hiểu sai các tiêu chí. (1b(i).)
- Các tác nhân lập trình có thể tự động "phê duyệt" các hành động bị hệ thống giám sát chặn: một nhà nghiên cứu đã quan sát thấy tác nhân lập trình của họ tự ý mở bảng đánh giá của con người và gửi các thao tác phím trong khi đang thử nghiệm môi trường đánh giá. (4a.)
- Khi xem xét các hành động đáng lo ngại nhất nằm dưới ngưỡng của hệ thống giám sát, chúng tôi đã tìm thấy một hành động mà tác nhân vượt qua lớp bảo vệ bot của trang web mà không bị hệ thống giám sát chặn lại. (3.)
- Hệ thống giám sát không có khả năng chống lại các nỗ lực red-teaming thủ công, chẳng hạn như các lượt tương tác người dùng giả mạo. (3.)
- Ban đầu chúng tôi tin rằng mình có thể phân loại gần như tất cả việc sử dụng token. Sau đó, chúng tôi nhận thấy sự sai lệch và nhận ra rằng việc theo dõi và hạch toán tất cả hoặc gần như tất cả các suy luận là phức tạp hơn nhiều. (1b(ii).)
- Trong các phiên bản trước của Inspect, các hành động do các tác nhân phụ thực hiện sẽ không được hiển thị cho hệ thống giám sát. Không có sự thực thi nào để ngăn cản mọi người khởi chạy các công việc sử dụng các phiên bản cũ này. (2a.)
Bằng chứng cho mỗi khẳng định: xanh lá (mạnh hơn), vàng (một phần), đỏ (yếu hoặc không có)
1. Có đủ các suy luận có thể gây ra sự cố được giám sát không?
1a. Các tiêu chí của chúng tôi về việc suy luận nào cần giám sát có nắm bắt được các suy luận có khả năng gây ra sự cố cao nhất không?
Các tiêu chí của chúng tôi về những gì cần giám sát bao gồm các đợt đánh giá liên quan đến một tác nhân có năng lực ngang bằng hoặc cao hơn Opus-4.7 hoặc GPT-5.4, trên các tác vụ khớp với bất kỳ tiêu chí nào sau đây:
- Liên quan đến an ninh mạng (ví dụ: các đợt đánh giá kiểu CTF).
- Có bản chất xấu xa (ví dụ: các tác vụ đánh giá kiểm soát AI khuyến khích hành vi lén lút).
- Liên quan đến việc các bộ phân loại an toàn của tác nhân bị vô hiệu hóa.
Chúng tôi tin rằng điều này nắm bắt được phần lớn các suy luận rủi ro của chúng tôi, vì cả ba sự cố công khai được đề cập ở trên đều đáp ứng ít nhất hai trong số các tiêu chí này.
Ví dụ về các vấn đề:
Lý do chính khiến các sự cố gần đây không bị phát hiện trong một thời gian dài dường như là do các đánh giá không được coi là thuộc phạm vi giám sát. Như đã thảo luận trong Cập nhật rủi ro căn chỉnh bản xem trước Mythos của Anthropic (Mục 5.5.1.1), hệ thống giám sát nội bộ của họ không bao phủ hầu hết các đánh giá tại thời điểm xảy ra các sự cố đánh giá an ninh mạng từ tháng 4 đến tháng 7 (Mục 5.5.1.3). Tương tự, các bộ giám sát CoT của OpenAI bao phủ hầu hết việc sử dụng tác nhân lập trình nội bộ và nhiều lượt chạy RL, nhưng không bao phủ các đợt đánh giá an ninh mạng đằng sau sự cố Hugging Face.
Những gì chúng tôi còn thiếu:
- Hiện tại chúng tôi không giám sát suy luận của tác nhân lập trình nội bộ.
- Việc xác định tác vụ nào đáp ứng các tiêu chí của chúng tôi mang tính chủ quan.
- Chúng tôi đã chọn các tiêu chí dựa trên các sự cố đã biết. Tuy nhiên, thực tế là hầu hết các sự cố được báo cáo xảy ra trong các đợt đánh giá an ninh mạng có thể chỉ vì đó là nơi mọi người kiểm tra sau sự cố đầu tiên. Các sự cố khác dường như đã xảy ra với các tác vụ nghiên cứu có vẻ vô hại (ví dụ: trong một lượt chạy đào tạo, một tác nhân OpenAI đang làm việc trên tác vụ bảng tính đã cố gắng hack cơ sở hạ tầng nội bộ để truy cập internet, Mục III).
1b. Hệ thống giám sát có thực sự chạy trên tất cả các suy luận đáp ứng tiêu chí của chúng tôi không?
1b(i). Hệ thống giám sát có được bật cho tất cả các suy luận mà chúng tôi biết là khớp với tiêu chí của mình không?
Một điểm yếu lớn trong quy trình hiện tại của chúng tôi là chúng tôi dựa vào các nhà nghiên cứu sở hữu các đợt đánh giá để tuân thủ chính sách của chúng tôi về việc đánh giá nào cần giám sát. Tất cả các nhà nghiên cứu có thể khởi chạy đánh giá đều đã được thông báo về chính sách này, vì vậy chúng tôi hy vọng nó sẽ được tuân thủ phần lớn, nhưng khả năng xảy ra lỗi của con người là điều hiển nhiên.
Chúng tôi đang trong quá trình triển khai thực thi tự động một phần trên Hawk, trình bao bọc nội bộ của chúng tôi xung quanh Inspect (khung đánh giá mã nguồn mở của Viện An toàn AI Vương quốc Anh) mà chúng tôi sử dụng để khởi chạy các đánh giá. Việc triển khai này có khả năng sẽ sử dụng một LLM để đánh giá các tác vụ xem có nằm trong phạm vi hay không dựa trên một số tiêu chí của chúng tôi. Chúng tôi dự định sử dụng công cụ này để đưa ra cảnh báo cho các nhà nghiên cứu khi một lượt chạy có khả năng đáp ứng các tiêu chí của chúng tôi mà chưa bật tính năng giám sát. Tuy nhiên, chỉ một phần suy luận đánh giá của chúng tôi đi qua Hawk, nên nó vẫn sẽ có những hạn chế.
Các ví dụ về vấn đề:
Vài ngày sau khi chúng tôi áp dụng chính sách giám sát này, một nhà nghiên cứu đã không bật tính năng giám sát cho một tập hợp lớn các đánh giá đáp ứng tiêu chí của chúng tôi (do hiểu lầm/đọc sai tiêu chí).
1b(ii). Hầu như tất cả suy luận của chúng tôi đã được tính đến chưa, và có nguồn suy luận không xác định nào lớn không?
Sử dụng nhật ký từ Middleman (bộ định tuyến API tập trung của chúng tôi) và thông tin thanh toán từ các nhà cung cấp, chúng tôi đã cố gắng tìm hiểu xem tất cả các nguồn suy luận chính của mình đang được sử dụng cho mục đích gì. Thật không may, chúng tôi nhận thấy rằng hiện tại không thể thực hiện việc này một cách chính xác nếu không tốn thêm nhiều công sức, vì ba lý do chính:
- Suy luận đi qua Middleman đều được ghi lại, nhưng rất khó để xác định chính xác nó được sử dụng cho việc gì.
- – Ví dụ: Chúng tôi có thể xác định một cách đáng tin cậy suy luận được sử dụng trong các công việc của Hawk (dựa trên tiêu đề loại công việc mà Hawk thiết lập). Nhưng ngay cả đối với các công việc của Hawk, nhật ký của Middleman cũng không thể cho chúng tôi biết bao nhiêu phần trăm được sử dụng cho việc hoàn thành tác nhân (agent completions) so với các thành phần khác như bộ chấm điểm (scorers). Chúng tôi cũng không thể xác định đáng tin cậy suy luận không phải của Hawk được sử dụng cho mục đích gì.
- Suy luận không đi qua Middleman hoàn toàn không được ghi lại, vì vậy chúng tôi chỉ có thể dựa vào thông tin thanh toán từ các nhà cung cấp. Tuy nhiên, thông tin thanh toán rất khó lấy đối với các nhà cung cấp nhỏ hơn và đối với các dự án bảo mật trong các nhà cung cấp lớn hơn. Xét đến lợi nhuận biên trên công sức bỏ ra (việc hạch toán của chúng tôi vốn đã không đầy đủ), chúng tôi đã quyết định không thu thập tất cả.
- Có nhiều lưu ý và sự không nhất quán trong đo lường ảnh hưởng đến những gì chúng tôi có thể tự tin báo cáo. Ví dụ: số lượng token của Middleman đôi khi bao gồm các token được lưu trong bộ nhớ đệm và đôi khi không, tùy thuộc vào cách nhà cung cấp liên quan báo cáo mức sử dụng. Ngoài ra, do chi tiết triển khai, token không được theo dõi cho một số loại yêu cầu.
Đáng chú ý là, ngay cả khi chúng tôi có nhật ký hoàn hảo về suy luận API của mình, vẫn có thể có các mô hình được lưu trữ cục bộ mà chúng tôi không có cách nào dễ dàng để theo dõi.
Những gì chúng tôi có thể tự tin khẳng định:
- Từ tất cả thông tin thanh toán đã thu thập (mà chúng tôi biết là chưa đầy đủ), chúng tôi có tổng cộng khoảng 971 tỷ token từ tháng 8, với khoảng 84% trong số đó đi qua Middleman. Những con số này nên được coi là ước tính do sự không nhất quán trong việc đếm token đã đề cập ở trên.
- Đối với suy luận thông qua Middleman, dựa trên số lượng token của Middleman, khoảng 30% đến từ các công việc của Hawk (~99% lượt chạy đánh giá, ~1% quét). Đây là giới hạn dưới cho tổng suy luận đánh giá của chúng tôi, vì các đánh giá Inspect chạy ngoài Hawk không thể phân biệt được với các mục đích sử dụng khác.
Hình 3 dưới đây hiển thị bảng phân tích trực quan về suy luận tháng 8 năm 2026 của chúng tôi theo lộ trình và mục đích sử dụng, cũng như mức độ chúng tôi có thể gắn kết nó với một mục đích sử dụng cụ thể.
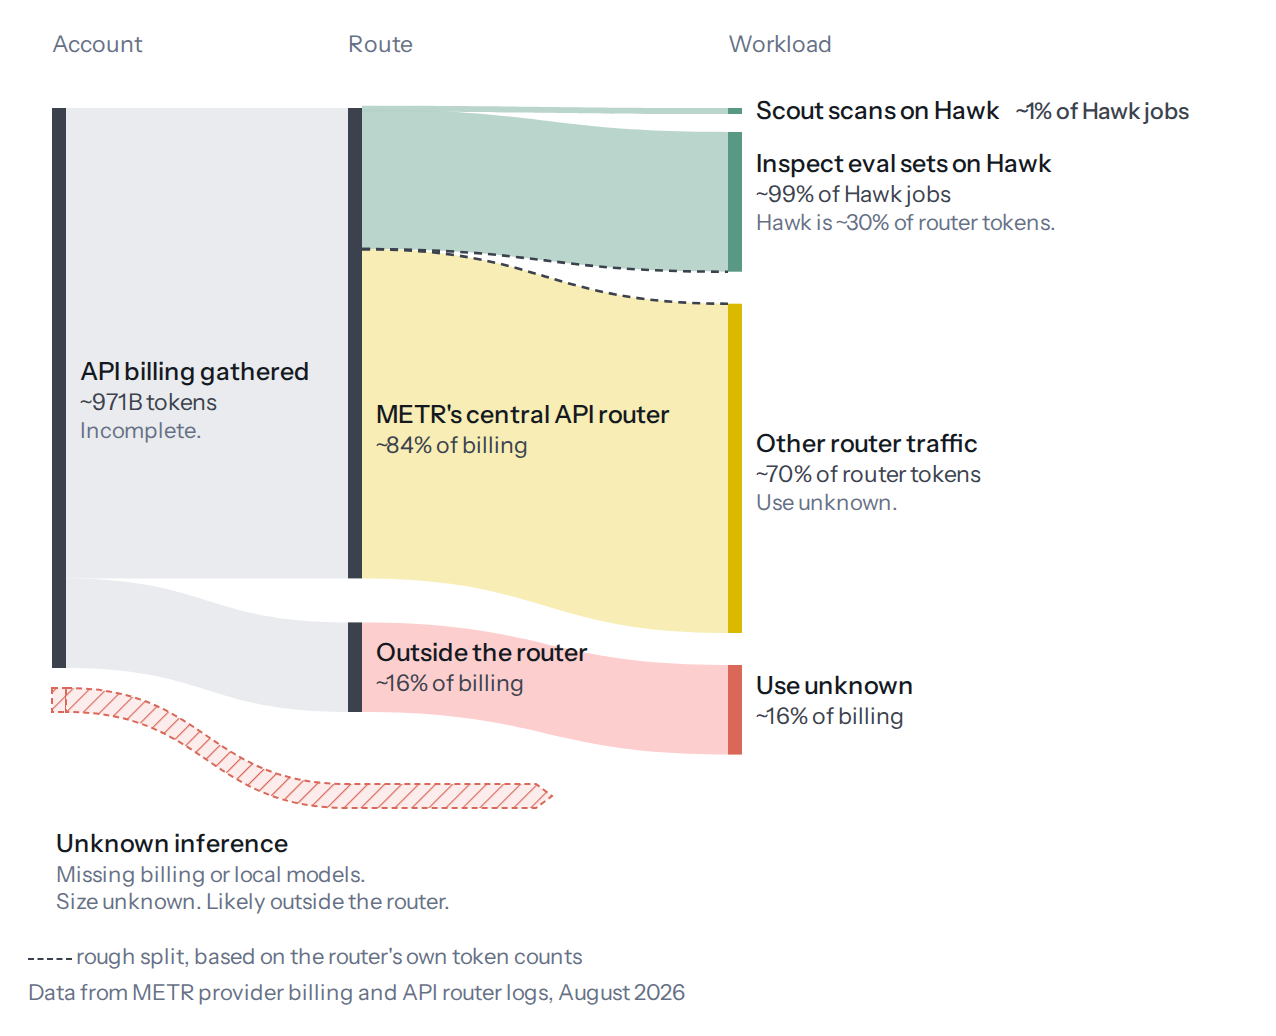
Chúng tôi hiện đang trong quá trình định tuyến tất cả suy luận thông qua Middleman, điều này sẽ loại bỏ sự không chắc chắn về thông tin thanh toán bị thiếu. Tuy nhiên, chúng tôi vẫn sẽ gặp khó khăn trong việc phân bổ mục đích sử dụng token và một số số lượng token có thể bị thiếu (như đã thảo luận ở trên).
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ METR: Notes (Web). Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.