Sản phẩm
Mở rộng mô hình ra quyết định dạng JEV với SGLang: API chấm điểm và đánh giá đa lựa chọn
(giờ Việt Nam)
Tóm tắt AI
Đội ngũ SGLang giới thiệu cách sử dụng API /v1/score để tối ưu hóa các mô hình ra quyết định, cho phép chỉ định trực tiếp token nhãn thay vì dựa vào logprobs của phản hồi.
Chính văn · Bản dịch AI
Sundara Raman Ramachandran, Chuanrui Zhu, Qing Lan, Shri Rajamanikandan Vasudevan, Jian Sheng, I-Ting Chen, Fedor Borisyuk, ngày 25 tháng 9 năm 2026
Một khách hàng hỏi liệu đơn hàng đã được gửi đi chưa. Nhân viên đã có ID đơn hàng và ba hành động tiếp theo khả thi: truy vấn dịch vụ trạng thái đơn hàng, tìm kiếm tài liệu chính sách giao hàng chung, hoặc hỏi khách hàng về ID đơn hàng. Trước khi có thể hành động, nhân viên cần phải lựa chọn.
Một mô hình quyết định kiểu JEV có thể trả về một danh mục hoặc điểm số thay vì giải thích bằng văn bản. Mã ứng dụng sử dụng tín hiệu đó để thực hiện hành động. Việc phục vụ hiệu quả bắt đầu bằng hai lựa chọn: thông tin nào mà mỗi đánh giá nên thấy và cách trả về các điểm số mà ứng dụng cần.
Trong bài viết này, chúng tôi giải thích các prompt pointwise (từng điểm) và setwise (theo tập hợp), sử dụng các đánh giá ứng viên của Open-Jev làm ví dụ cụ thể, và chỉ ra nơi Score API của SGLang cùng cơ chế thực thi chia sẻ ngữ cảnh (shared-context execution) cải thiện việc phục vụ pointwise. Sau đó, chúng tôi so sánh Fused-Choice và chấm điểm setwise khi tất cả các ứng viên xuất hiện cùng nhau. Xuyên suốt bài viết, chúng tôi tập trung vào việc chấm điểm nhãn token tiếp theo với các mô hình ngôn ngữ nhân quả (causal language models) thay vì tạo văn bản dài.
Tóm tắt (TL;DR)
- Làm rõ hợp đồng đầu ra. Với /v1/score, người gọi yêu cầu các điểm số token nhãn cụ thể thay vì dựa vào việc các nhãn đó xuất hiện trong top-k logprobs của phản hồi tạo văn bản.
- Tách biệt ngữ nghĩa prompt khỏi quá trình thực thi. Pointwise và setwise mô tả những thông tin mà một đánh giá có thể thấy. SIS và MIS mô tả cách runtime thực thi các yêu cầu chấm điểm.
- Tái sử dụng truy vấn lặp lại. Chấm điểm đa mục (MIS) chia sẻ tính toán truy vấn trong một yêu cầu trong khi vẫn giữ các ứng viên pointwise tách biệt. Trong các khối lượng công việc được biểu đồ hóa, độ trễ của nó tăng ít hơn nhiều so với số lượng ứng viên và tải được cung cấp.
- Đo lường hiệu suất phục vụ ở mức tải dự kiến. Lợi ích thay đổi tùy theo mô hình và cấu hình. Hãy so sánh thông lượng đạt được và độ trễ đuôi (tail latency), không chỉ tỷ lệ yêu cầu được cung cấp.
Bản chất của một LLM ra quyết định
Trong ví dụ của chúng tôi, đầu vào là trạng thái hiện tại, một câu hỏi và các hành động khả thi. Việc chọn một danh mục là phân loại. Việc gán điểm phù hợp cho các hành động là chấm điểm; những điểm số đó có thể thúc đẩy việc lựa chọn hoặc xếp hạng. Sự trừu tượng này mô tả một khối lượng công việc phục vụ, không phải các thành phần bên trong của một mô hình JEV độc quyền. Nó không thay thế cho việc huấn luyện một mô hình ra quyết định tốt.
Một LLM có thể tạo ra tín hiệu này thông qua một lớp phân loại (classification head) đã được huấn luyện hoặc thông qua điểm số cho các token trả lời như Yes/No hoặc A/B/C. Chúng tôi tập trung vào cách thứ hai. Tại ranh giới câu trả lời, vị trí nơi câu trả lời bắt đầu, một mô hình ngôn ngữ nhân quả đã cung cấp một phân phối trên các token tiếp theo khả thi. Nếu mô hình thể hiện đánh giá cần thiết tại vị trí đó, ứng dụng có thể đọc các điểm số liên quan mà không cần yêu cầu giải thích.
Câu hỏi tiếp theo là thông tin nào mà mỗi đánh giá nên thấy.
Hai cách để đặt câu hỏi quyết định
Giữ các hành động cố định: A là "truy vấn dịch vụ trạng thái đơn hàng", B là "tìm kiếm tài liệu chính sách giao hàng chung", và C là "hỏi khách hàng về ID đơn hàng". Chúng ta có thể sắp xếp các đầu vào này theo hai cách, thường được gọi là pointwise và setwise trong các hệ thống gợi ý và xếp hạng.
Hình 1. Cấu trúc prompt pointwise và setwise.
Những điều cần lưu ý: Sự khác biệt nằm ở những gì mỗi đánh giá có thể thấy, không phải API nào phục vụ nó. Chấm điểm pointwise tạo ra một hàng điểm Yes/No cho mỗi ứng viên, với các ứng viên khác bị ẩn; công thức setwise được minh họa tạo ra một hàng A/B/C sau khi thấy tất cả các tùy chọn. Cả hai đều có thể sử dụng chấm điểm nhãn rõ ràng, nhưng điểm số của chúng có ý nghĩa khác nhau. Chia sẻ tính toán truy vấn với MIS là một tối ưu hóa thực thi, không phải là sự chuyển đổi từ suy luận pointwise sang setwise.
Các cấu trúc prompt này không nhất thiết mang lại cùng một quyết định. Hãy chọn công thức dựa trên tác vụ và quá trình huấn luyện của mô hình, bao gồm cả việc liệu các ứng viên có nên ảnh hưởng lẫn nhau hay không.
Open-Jev làm cho mô hình pointwise trở nên cụ thể
Trình biên dịch yêu cầu công khai của Open-Jev xây dựng các prompt ứng viên độc lập cho các tác vụ lựa chọn. Mỗi prompt chứa một tiền tố ngữ cảnh-và-câu hỏi được chia sẻ, một câu trả lời đề xuất, và một hướng dẫn để trả lời Yes hoặc No.
Điều đó mang lại cho chúng ta một khối lượng công việc phục vụ hữu ích: trạng thái lặp lại, nhiều đánh giá độc lập và đầu ra rất nhỏ.
Tại sao khối lượng công việc ra quyết định xứng đáng có một giao diện chấm điểm
Tạo một token với logprobs là một cơ sở khả thi, nhưng phản hồi top-k của nó có thể bỏ sót một nhãn mà ứng dụng cần. /v1/score của SGLang cho phép người gọi khai báo rõ ràng các nhãn đó thông qua label_token_ids, cùng với truy vấn và các mục. Chấm điểm token tiếp theo thông thường trả về một hàng cho mỗi mục, theo thứ tự nhãn được yêu cầu.
Đối với chấm điểm nhãn causal-LM, một khối lượng công việc chỉ chấm điểm rõ ràng cho phép runtime bỏ qua việc lấy mẫu token, tránh các logprobs không cần thiết cho các token đầu vào, thu thập điểm số nhãn theo lô, và giảm việc truyền dữ liệu từ GPU sang CPU lặp đi lặp lại. Việc trích xuất chọn lọc nhãn này không loại bỏ phép chiếu từ vựng hoặc chuẩn hóa phân phối đầy đủ.
Cả chấm điểm và tạo một token hiện đại đều có thể trả về kết quả trực tiếp từ prefill; việc tạo văn bản không nhất thiết yêu cầu một lượt truyền mô hình bổ sung. Ngoài đường dẫn đầu ra, SGLang hỗ trợ thực thi chấm điểm đơn mục (SIS) và chấm điểm đa mục (MIS):
- SIS: mỗi cặp truy vấn-cộng-mục là một chuỗi logic độc lập. Một yêu cầu API vẫn có thể chứa nhiều mục.
- MIS: runtime tái sử dụng rõ ràng truy vấn được chia sẻ trong một yêu cầu và giới hạn sự chú ý của mỗi ứng viên vào truy vấn đó và các token của chính nó.
Score API cũng hỗ trợ các mô hình SequenceClassification như Qwen3ForSequenceClassification, Qwen2ForSequenceClassification, và LlamaForClassification ngay lập tức, sử dụng các lớp phân loại của chúng (PR #22118). Các điểm chuẩn dưới đây tập trung vào chấm điểm nhãn token tiếp theo với các mô hình ngôn ngữ nhân quả.
Điểm chuẩn: Các quyết định Pointwise
Chúng tôi sử dụng các tác vụ lựa chọn từ tập dữ liệu Open-Jev, với trạng thái và câu hỏi được chia sẻ trên các đánh giá ứng viên.
| Thành phần | Thiết lập |
|---|---|
| Các mô hình | Qwen3-0.6B, Qwen3-8B, và Qwen3.5-4B |
| Bộ tăng tốc | Một GPU NVIDIA H200 |
| Phần mềm | SGLang trên CUDA 13.0, với các cấu hình máy chủ dành riêng cho chế độ |
| Các phương pháp phục vụ | Generate với max_tokens=1, SIS, và MIS |
| Chỉ số độ trễ | Thời gian p95 từ đầu đến cuối để hoàn thành các đánh giá ứng viên của một câu hỏi |
| Đơn vị tải | Câu hỏi mỗi giây, không phải số ứng viên cá nhân mỗi giây |
Mỗi câu hỏi được coi là hoàn tất khi tất cả các ứng viên của nó đã được đánh giá. Chúng tôi báo cáo thời gian p95 để ra quyết định, ngưỡng độ trễ bao phủ 95% các câu hỏi thành công, thay vì thời gian để chấm điểm một ứng viên.
Các biểu đồ này so sánh các cấu hình phục vụ, không phải một thay đổi API riêng lẻ: MIS có các yêu cầu về backend và bộ nhớ đệm khác với tạo văn bản thông thường và SIS. Phụ lục mô tả các máy khách, cài đặt máy chủ và các kiểm tra đo lường.
Độ trễ tại mức tải mục tiêu tương ứng
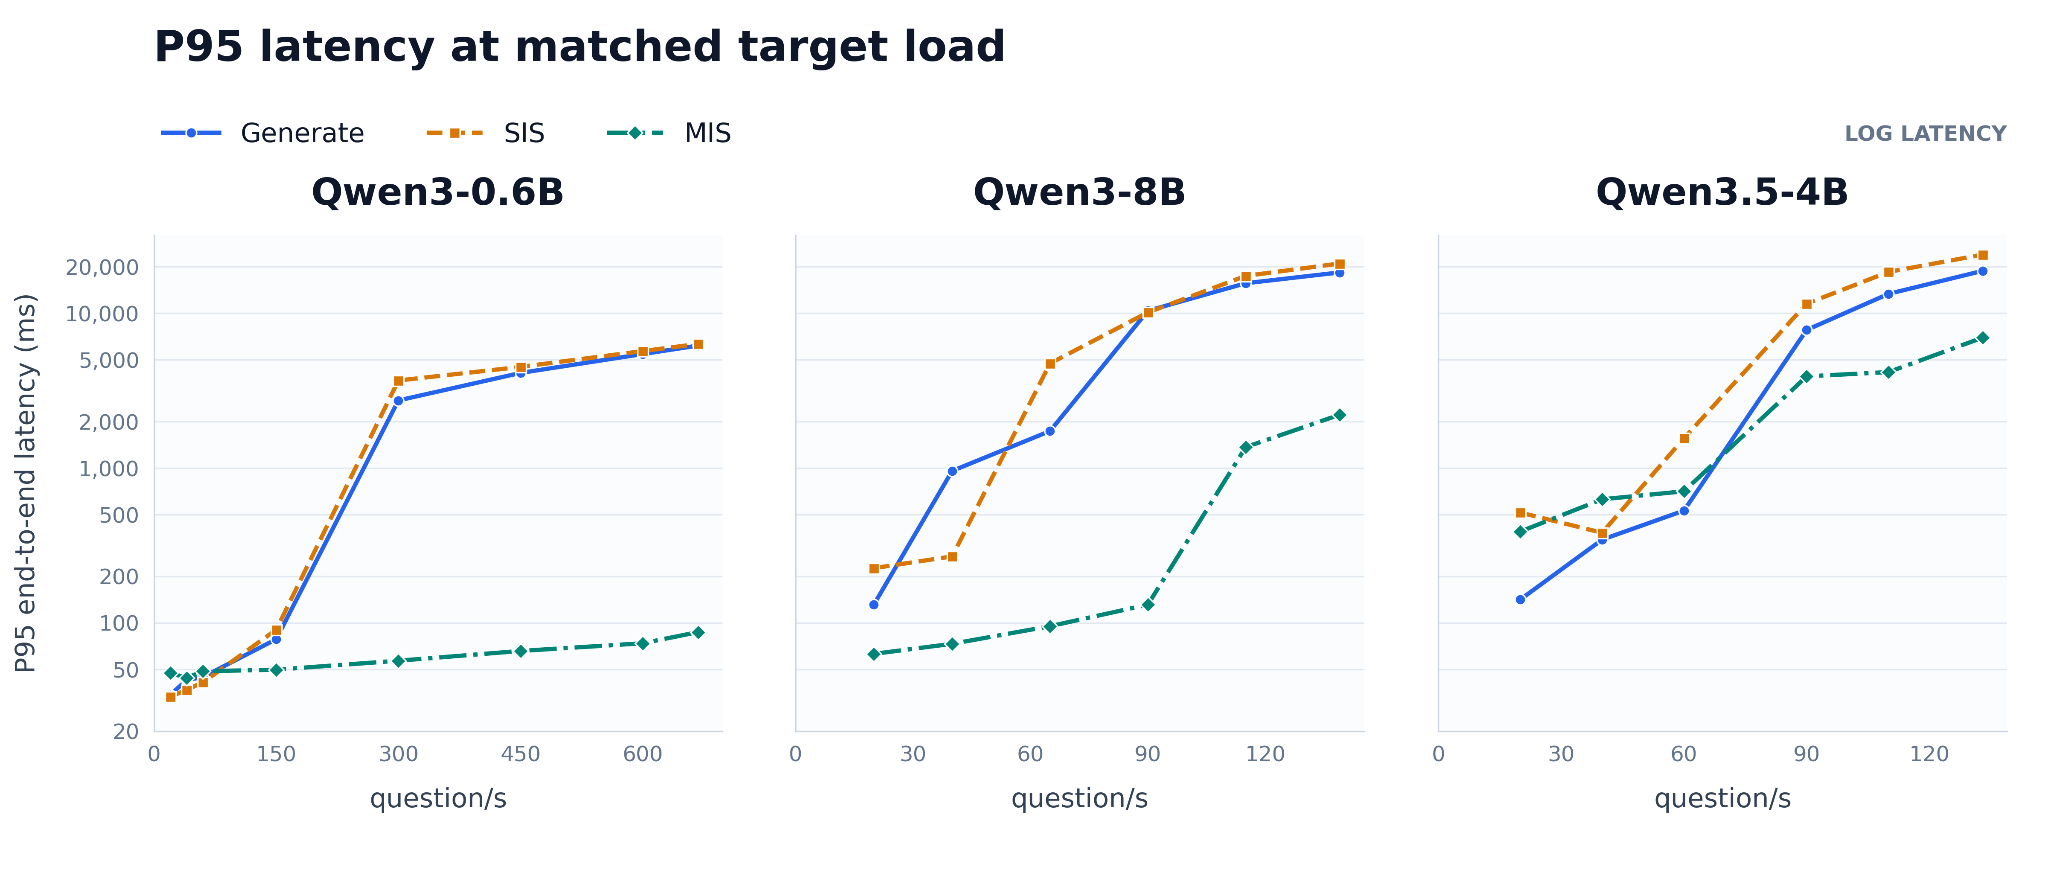
Hình 2. Độ trễ p95 từ đầu đến cuối của pointwise tại mức tải mục tiêu tương ứng trên ba mô hình (thang đo log).
Những điều cần lưu ý: Lợi thế lớn nhất của MIS xuất hiện khi tải tăng; nó không nhất quán nhanh hơn ở mức tải thấp.
- Qwen3-0.6B: Độ trễ p95 của nó duy trì dưới khoảng 100 ms trên phạm vi được biểu đồ hóa trong khi Generate và SIS tăng lên đến hàng giây.
- Qwen3-8B: MIS duy trì ở mức gần 130 ms cho đến 90 câu hỏi/giây, sau đó tăng mạnh tại điểm tải tiếp theo: nó làm chậm quá trình bão hòa thay vì loại bỏ hoàn toàn.
- Qwen3.5-4B: Cho thấy lợi thế nhỏ hơn và Generate nhanh hơn ở mức tải thấp. Tại mức tải cao nhất được biểu thị, độ trễ p95 của MIS chỉ bằng khoảng một phần ba so với hai phương thức còn lại.
Đây là các tỷ lệ độ trễ tại cùng một mức tải được cung cấp, không phải hệ số nhân thông lượng, và các biểu đồ sử dụng các dải câu hỏi trên giây (QPS) khác nhau. Chỉ riêng QPS được cung cấp không cho thấy máy chủ hoàn thành bao nhiêu câu hỏi mỗi giây hoặc liệu máy khách có thể duy trì tốc độ gửi yêu cầu hay không.
Độ trễ khi số lượng ứng viên tăng lên
Hình 3. Thời gian p95 từng điểm để đưa ra quyết định theo số lượng ứng viên.
Những điểm cần lưu ý: Độ trễ của MIS gần như phẳng khi số lượng tùy chọn tăng từ 2 lên 16, nhất quán với việc phân bổ tính toán truy vấn chung cho các ứng viên. Ở mức 16 tùy chọn, Qwen3-0.6B mất 18,7 ms với MIS so với 39,6 ms của Generate và 24,3 ms của SIS; Qwen3-8B mất 20,6 ms so với lần lượt là 54,1 ms và 53,1 ms. Mức tăng nhỏ hơn trên Qwen3.5-4B: 55,7 ms so với lần lượt là 84,8 ms và 74,4 ms. Với chỉ hai tùy chọn, SIS nhanh hơn một chút so với MIS trên Qwen3-0.6B và Qwen3.5-4B.
Các nhóm số lượng ứng viên chứa các câu hỏi khác nhau với độ dài token khác nhau, vì vậy đây là xu hướng khối lượng công việc được quan sát, không phải là một thí nghiệm cô lập tác động của số lượng ứng viên.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ LMSYS: Blog (nhóm Chatbot Arena). Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.