Thủ thuật
SemiAnalysis: Nên đặt trí tuệ robot ở thiết bị hay trung tâm dữ liệu?
(giờ Việt Nam)
Tóm tắt AI
SemiAnalysis phân tích bài toán tối ưu chi phí và độ trễ cho robot. Với các mô hình hàng tỷ tham số hiện nay, việc xử lý tại chỗ hay trên cloud vẫn là thách thức lớn về kinh tế và kỹ thuật.
Bản dịch AI
Cho đến nay, AI chủ yếu tồn tại sau màn hình. Các chatbot trả lời câu hỏi. Sau đó, các tác nhân (agent) bắt đầu điều khiển phần mềm và tự mình hoàn thành các tác vụ đa bước. Bước tiếp theo là AI hoạt động trong thế giới vật lý, và phần quan trọng nhất của bước này chính là robot. Mọi thứ vẫn còn ở giai đoạn sơ khai. Chưa ai định hình được phần cứng, các mô hình hay các yếu tố kinh tế liên quan.
Với các mô hình ngôn ngữ lớn (LLM), phần cứng phải tùy biến theo mô hình. Đổ càng nhiều dữ liệu và năng lực tính toán vào quá trình huấn luyện càng tốt, sau đó mới tìm cách vận hành mô hình thu được. Mô hình là ưu tiên hàng đầu; phần cứng là thứ yếu. Robotics đảo ngược điều này do hai hạn chế.
Hạn chế đầu tiên là thời gian. Một robot chạy các vòng lặp điều khiển thời gian thực và không được phép trễ hạn. Một LLM có thể chạy chậm mà không ảnh hưởng đến kết quả cuối cùng. Nếu robot chậm, thế giới xung quanh nó sẽ thay đổi, và hành động đó sẽ trở nên lỗi thời vào thời điểm nó cần thực hiện.
Hạn chế thứ hai là chi phí. Khi bạn sử dụng LLM, nó nằm sau màn hình do người dùng cung cấp. Trong lĩnh vực robotics, nhà sản xuất phải chế tạo cả năng lực tính toán lẫn chính robot đó và phải trả chi phí ngay từ đầu cho từng đơn vị sản phẩm, và chi phí đầu tư vốn (capex) có thể rất khổng lồ. Ở quy mô lớn, chi phí trả trước này có thể lên tới hàng tỷ, thậm chí hàng nghìn tỷ nếu cuối cùng chúng ta đạt tới con số một tỷ robot.
Do hai hạn chế này, trong robotics, phần cứng trên robot là cố định và mô hình được thiết kế để phù hợp với những gì chúng ta có thể sản xuất một cách hợp lý. Khả năng của các mô hình tiên phong sẽ bị giới hạn bởi những gì chúng ta có thể chạy trên phần cứng giá cả phải chăng, hoạt động theo thời gian thực, và trí tuệ trở thành thứ mà bạn phải phân bổ dựa trên độ trễ và hiệu quả kinh tế của từng đơn vị.
Đây là lý do tại sao các mô hình robot tiên phong vẫn nhỏ hơn nhiều so với các LLM tiên phong, vốn đã đạt tới quy mô hàng nghìn tỷ tham số. Các mô hình robot đa năng hiện nay chỉ ở mức hàng tỷ tham số: lớp π0 của Physical Intelligence ở mức ~3 tỷ, π0.7 ở mức 5 tỷ, GR-3 của ByteDance ở mức 4 tỷ, các mô hình của Generalist khoảng 10 tỷ và DreamZero của NVIDIA ở mức 14 tỷ. Tuy nhiên, số lượng tham số này ít mang ý nghĩa hơn so với các LLM tương đương. Các phòng thí nghiệm LLM chọn kích thước mô hình bằng cách tối ưu hóa chất lượng dựa trên ngân sách huấn luyện và chi phí suy luận; các phòng thí nghiệm robotics chọn kích thước dựa trên những gì dữ liệu của họ có thể hỗ trợ và những gì vừa vặn trên Jetson hoặc H100 trong giới hạn độ trễ cho phép. Kích thước mô hình robot cho bạn biết các hạn chế nằm ở đâu, chứ không phải kích thước sẽ ổn định ở mức nào.
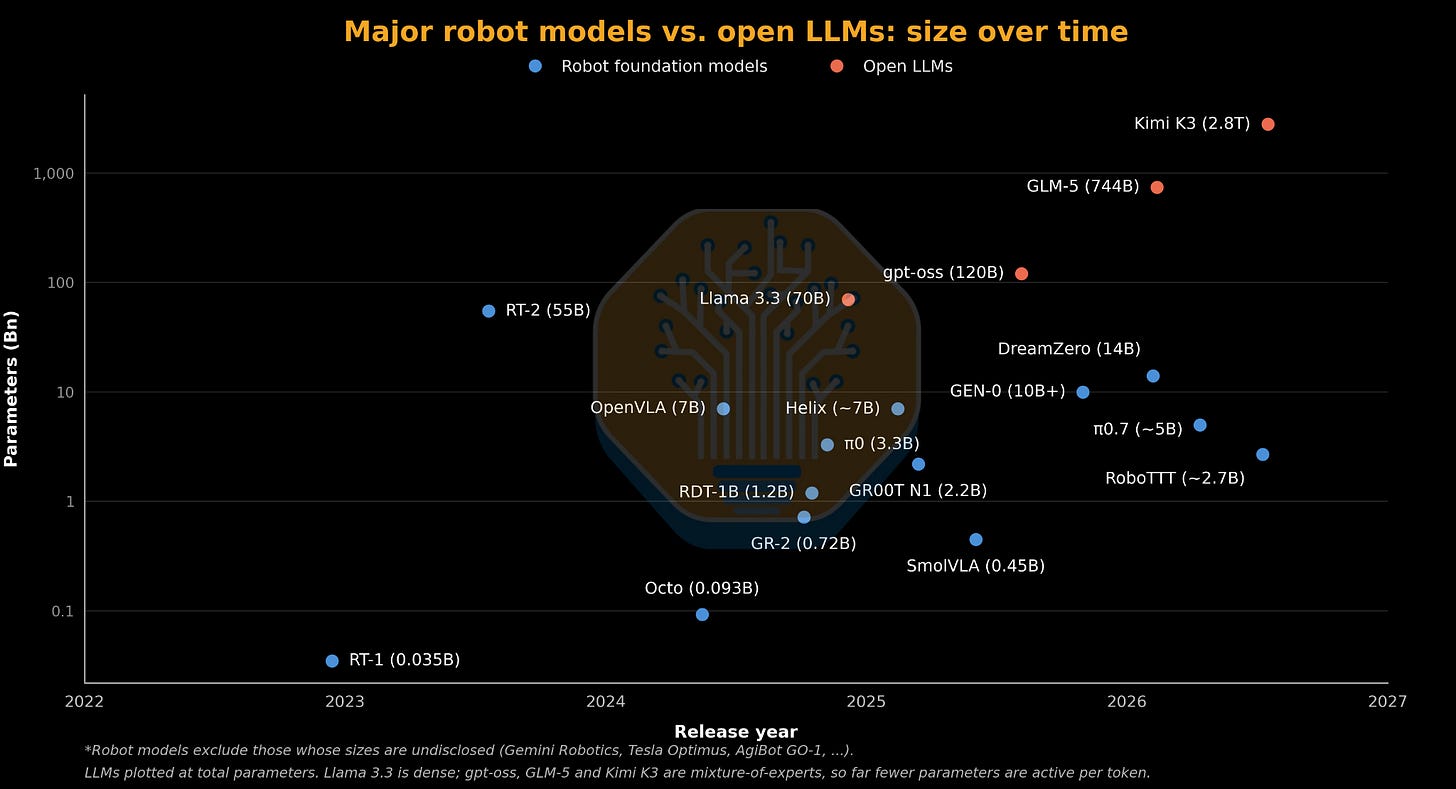
Trong LLM, các định luật mở rộng (scaling laws) vẫn đúng, việc mở rộng quy mô đã liên tục mở rộng phạm vi các vấn đề mà một mô hình đơn lẻ có thể giải quyết. Các kết quả ban đầu từ các công ty như Generalist và Dyna cho thấy robotics cũng mở rộng quy mô theo cách tương tự. Câu hỏi không phải là liệu việc mở rộng quy mô có hiệu quả hay không, mà là liệu các đầu vào có thể theo kịp hay không. Dữ liệu là hạn chế đầu tiên, không có kho dữ liệu trải nghiệm robot quy mô internet nào, và dữ liệu tương tác trong thế giới thực rất chậm và đắt đỏ để tạo ra, do đó dẫn đến sự trỗi dậy của việc thu thập dữ liệu từ con người trong môi trường thực tế (embodied human data collection) và các mô hình thế giới (world models). Mạng lưới là hạn chế thứ hai. Các mô hình tiên phong đã vượt quá khả năng của robot (π0.7 chạy trên H100 bên ngoài robot; DreamZero cần hai chip GB200), và một khi mô hình nằm trong trung tâm dữ liệu, độ trễ và hiện tượng giật (jitter) sẽ gây ra vấn đề.
Chưa rõ kích thước mô hình robot sẽ dừng lại ở đâu. Đường xu hướng đang hướng lên, nhưng các cải tiến về hiệu suất vẫn liên tục kéo theo hướng ngược lại, và lĩnh vực này vẫn chưa đi đến thống nhất. DreamZero của NVIDIA, một "mô hình hành động thế giới" 14 tỷ tham số được xây dựng trên nền tảng khuếch tán video (video-diffusion), cần hai GPU GB200 bên ngoài robot chỉ để chạy trong thời gian thực. Nhưng các yêu cầu về tính toán thay đổi rất nhanh: vài tháng sau DreamZero, RoboTTT của NVIDIA đã đặt cược vào hướng ngược lại, sử dụng một chính sách 3 tỷ tham số liên tục cập nhật trọng số của chính nó bằng cách huấn luyện tại thời điểm kiểm thử (test time training) thay vì tạo ra các video về tương lai. Kết quả là một mô hình với ngữ cảnh hữu dụng kéo dài vài phút, đủ nhỏ để chạy ngay trên thiết bị.
Dù kích thước mô hình dừng lại ở đâu, quan điểm của chúng tôi là một chuỗi các phương pháp tiếp cận là điều không thể tránh khỏi. Một số robot sẽ chạy nhận thức hoàn toàn trên thiết bị, trong khi những robot khác sẽ chuyển một phần công việc đó sang các GPU đặt tại trung tâm dữ liệu. Tuy nhiên, đối với các robot đa năng đòi hỏi trí tuệ thực sự, chúng tôi cho rằng tính toán bên ngoài robot có nhiều lợi thế, từ việc thoát khỏi ngân sách tính toán và năng lượng của robot cho đến việc chia sẻ tài nguyên suy luận trên toàn bộ đội ngũ robot. Điều này đi kèm với những thách thức về mạng lưới mà chúng tôi sẽ đề cập trong các phần sau, nhưng đây là một lựa chọn ngày càng khả thi.
Trước khi khám phá ý tưởng về tính toán bên ngoài robot, đây là phần giới thiệu nhanh về cách các mô hình robot hoạt động và những mô hình nào mà chúng ta đang đề cập đến.
Điều khiển robot cổ điển, bao gồm động học cộng với quỹ đạo được lập kế hoạch và các bộ điều khiển phản hồi, đã vận hành các nhà máy trong nhiều thập kỷ trên các chip nhúng nhỏ. Nhiều chính sách học máy hẹp (narrow learned policies) cũng vừa vặn để chạy trên thiết bị. Bài viết này không nói về những thứ đó. Chúng tôi quan tâm đến các robot đa năng: những robot có thể tuân theo các hướng dẫn mở, xử lý các cảnh tượng chưa từng thấy và thực hiện nhiều công việc khác nhau.
Ở trên cùng là lớp lập kế hoạch (planning layer). Nó diễn giải hướng dẫn và bối cảnh, quyết định robot nên làm gì tiếp theo, và có thể tạo ra một tác vụ phụ, điểm đến, tư thế cầm nắm hoặc kế hoạch bước chân. Bên dưới nó là lớp hành động hoặc chuyển động (action or motion layer). Nó biến các đầu ra đó thành các chuỗi hành động ngắn, tư thế cơ thể hoặc vận tốc. Ở dưới cùng là các vòng lặp servo và an toàn. Chúng ước tính trạng thái của robot, phản ứng với va chạm và trượt, duy trì sự cân bằng và cuối cùng là điều khiển các bộ truyền động (actuators).
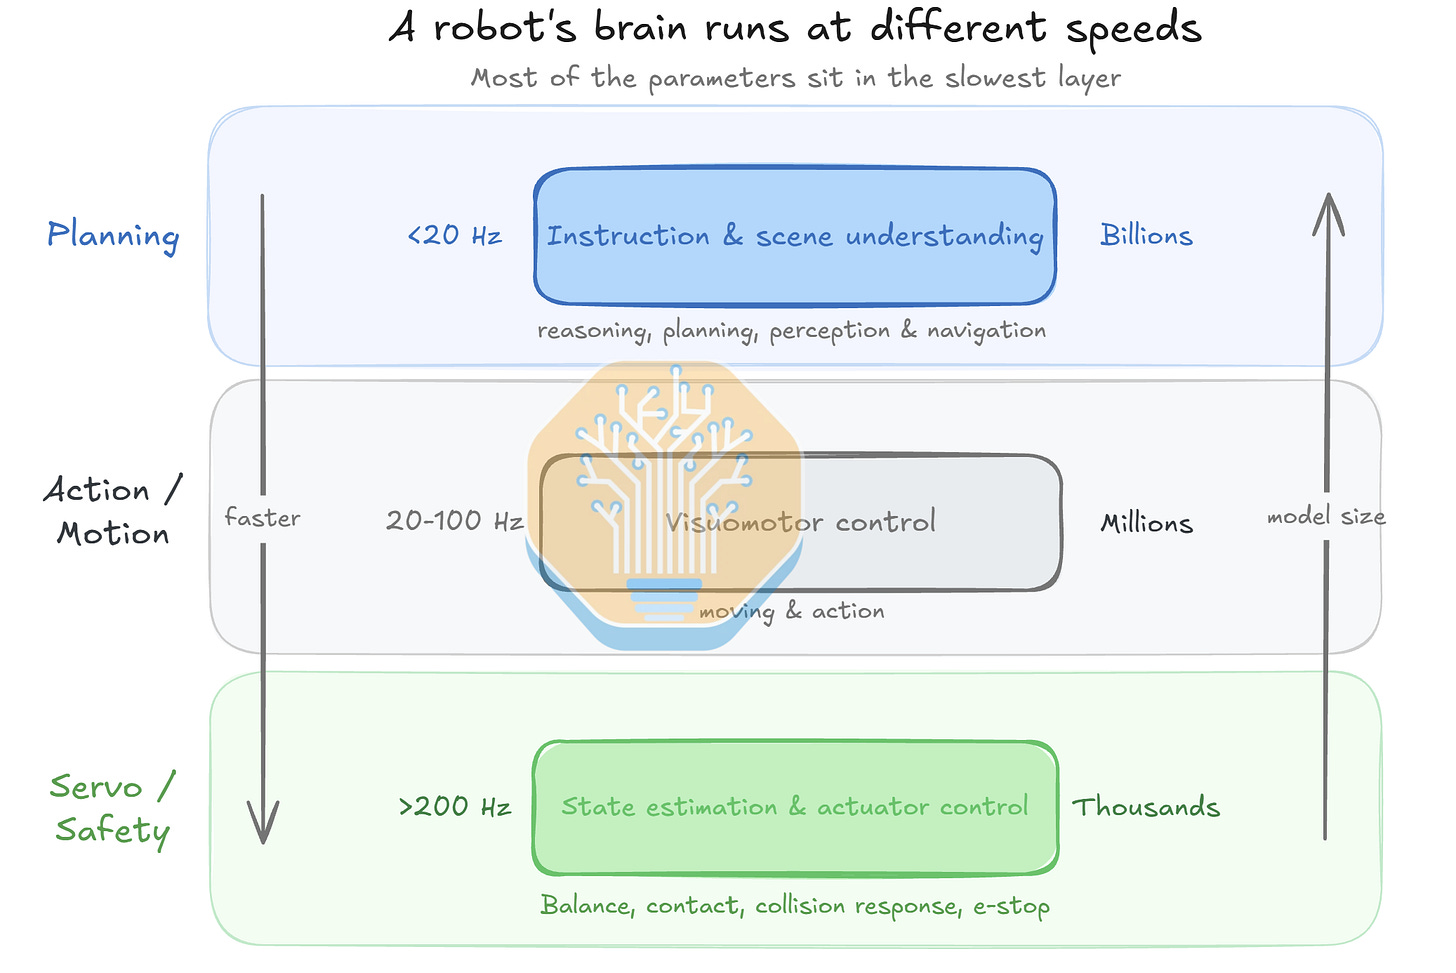
Tần suất quyết định lớp nào cần chạy trên robot. Các lớp hành động và servo chạy ở tần số hàng trăm Hz: một vòng lặp 100 Hz phải tạo ra đầu ra tiếp theo sau mỗi 10 mili giây. Một vòng lặp không dây điển hình tự nó đã tốn từ 10 đến 50 mili giây, và một kết nối được thiết kế tốt cũng mất dưới 10 mili giây, vì vậy đối với các vòng lặp này, mạng lưới không chỉ đơn thuần làm tăng độ trễ mà còn tiêu tốn gần như toàn bộ ngân sách thời gian trước khi mô hình kịp tính toán bất cứ điều gì. Đây là lý do tại sao bất cứ thứ gì trên khoảng 100 Hz không bao giờ có thể rời khỏi robot.
Dưới khoảng 20 Hz, nơi lớp lập kế hoạch hoạt động, bức tranh thay đổi. Một bộ lập kế hoạch chạy ở 5 Hz có 200 mili giây cho mỗi quyết định, vì vậy ngay cả một vòng lặp 10 đến 50 mili giây cũng nằm trong giới hạn thoải mái, với biên độ dự phòng. Đó là đủ không gian để chuyển lớp lập kế hoạch ra khỏi robot hoàn toàn, và một ngăn xếp mạng được tinh chỉnh tốt có thể đẩy ranh giới có thể chuyển đổi lên trên 20 Hz. Tuy nhiên, vấn đề lớn hơn là hiện tượng giật (jitter) thay vì độ trễ. Một độ trễ cố định có thể được lập kế hoạch để xử lý: hệ thống biết khoảng cách robot và mọi thứ xung quanh sẽ di chuyển trong khoảng thời gian đó và có thể lập kế hoạch trước một chút. Hiện tượng giật khó xử lý hơn vì các lệnh đến vào những khoảng thời gian không đều đặn, vì vậy robot không bao giờ biết chính xác khi nào bản cập nhật tiếp theo sẽ đến. Bạn có thể sử dụng bộ đệm cho trường hợp xấu nhất, biến độ trễ thay đổi thành độ trễ có thể dự đoán được, nhưng khi đó mọi hành động đều phải chịu mức phạt của trường hợp xấu nhất. Kiểm soát được hiện tượng giật chính là chìa khóa để thực hiện việc chuyển lớp lập kế hoạch ra bên ngoài.
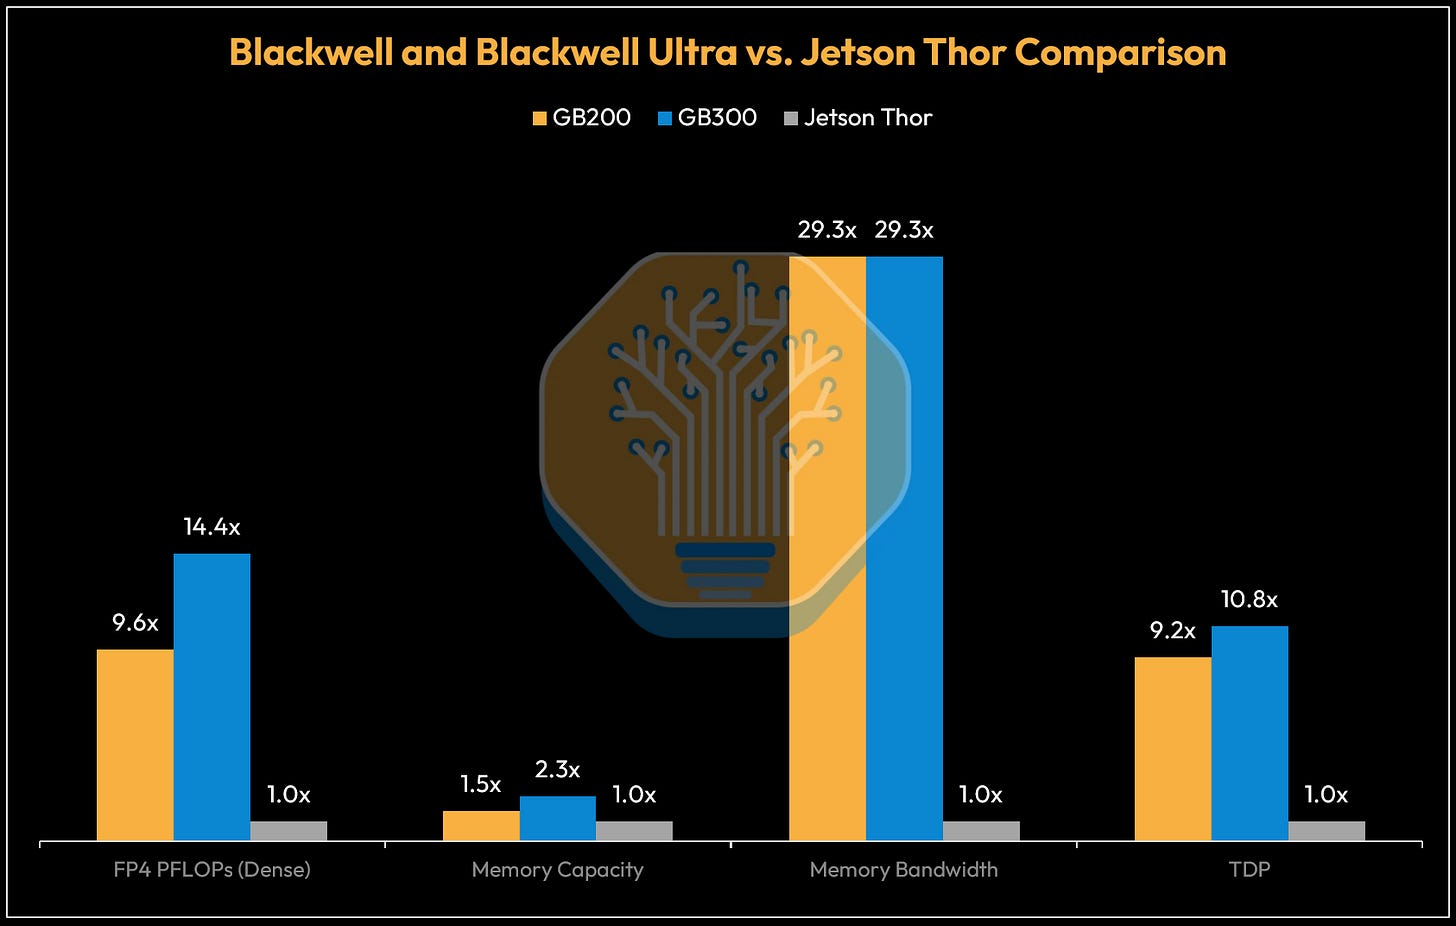
Lớp lập kế hoạch cũng là lớp có yêu cầu tính toán nặng nề nhất, và các yêu cầu đó tăng lên khi khả năng tổng quát hóa tăng lên. Các tác vụ mở đòi hỏi khả năng suy luận thực sự, và các mô hình suy luận thì rất lớn. Đó là lý do tại sao một số công ty đã bắt đầu xem xét đến tính toán tại trung tâm dữ liệu. Jetson Thor là phần cứng tính toán robot tốt nhất bạn có thể mua hiện nay, nhưng nó vẫn chỉ cung cấp khoảng 1/10 số FLOPs của một chip GB200 và khoảng 1/30 băng thông bộ nhớ của nó.
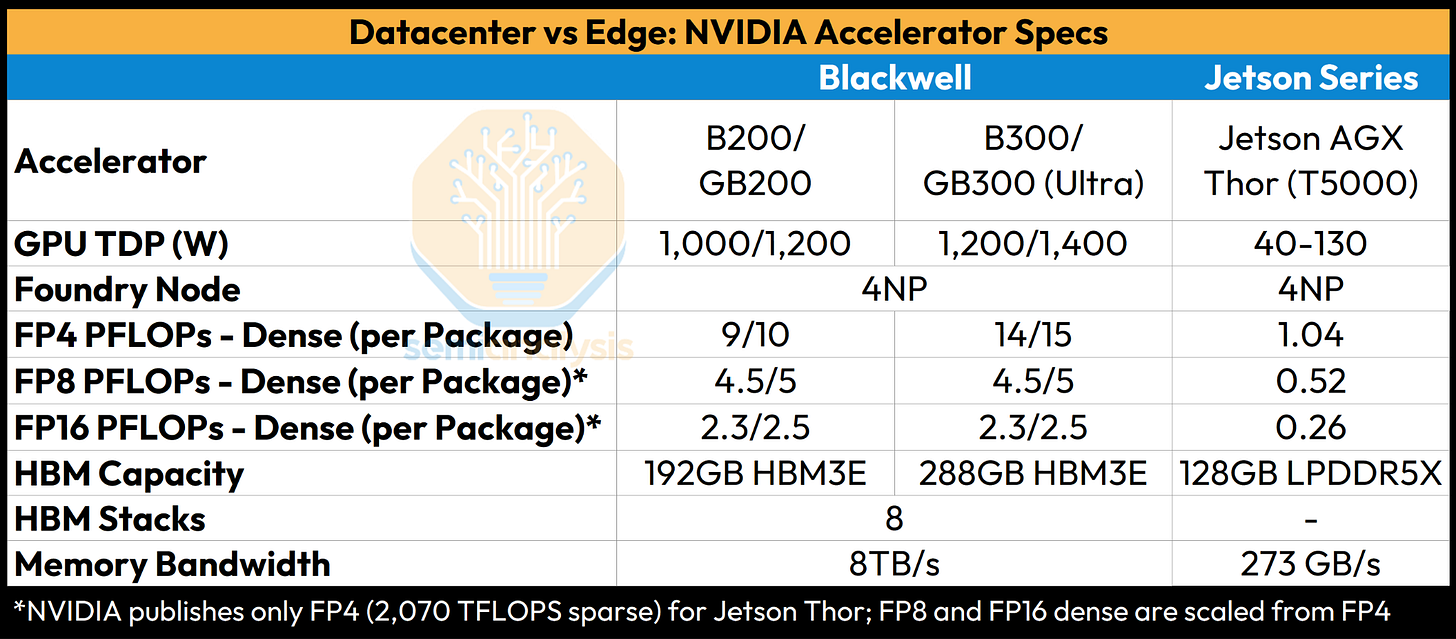
Chuỗi cung ứng cũng được định hướng cho silicon trung tâm dữ liệu, không phải silicon robot, và việc tăng cường sản xuất silicon robot sẽ không dễ dàng, đặc biệt là khi công suất front-end và DRAM vốn đã khan hiếm. Sản lượng của chính Nvidia đã chứng minh điều này.
Sản lượng bộ tăng tốc của Nvidia gần như hoàn toàn là silicon trung tâm dữ liệu: một quá trình tăng tốc Hopper kéo dài suốt năm 2023 và 2024 để chuyển giao sang Blackwell, vốn sẽ tăng trưởng mạnh trong năm 2025 và 2026 để thống trị thị trường. Jetson, dòng sản phẩm được sử dụng trong robot, chỉ là một dải màu đỏ mỏng ở phía dưới, hầu như không thể nhìn thấy ngay cả vào năm 2026. Điều này là do thị trường robotics vẫn còn sơ khai, khối lượng thực tế phải mất nhiều năm nữa mới đạt được, và hầu như không có gì để xây dựng cho nó.
Biên lợi nhuận cũng cho thấy một câu chuyện tương tự. Nhu cầu vẫn chưa xuất hiện, nhưng khi nó đến, giá cả sẽ tăng lên và biên lợi nhuận của Jetson sẽ thay đổi. Nhưng hiện tại, một GPU trung tâm dữ liệu Blackwell mang lại biên lợi nhuận gộp cao hơn nhiều so với một mô-đun Jetson, ở mức khoảng 70% so với mức 60%, vì vậy NVIDIA có mọi động lực để tập trung công suất tấm wafer tiên tiến khan hiếm của mình vào trung tâm dữ liệu và ít lý do để tăng cường sản xuất silicon cho thiết bị biên (edge silicon) trong khi thị trường robotics vẫn còn nhỏ.
Tệ hơn nữa, silicon robot đang hội tụ vào chính các nút (node) mà trung tâm dữ liệu đang tranh giành. Dòng Jetson của Nvidia trước đây được bảo vệ: thế hệ trước, Orin, chạy trên quy trình SF8 của Samsung. Thế hệ hiện tại, Thor, đã thu hẹp khoảng cách đó xuống TSMC N4, và khi robot chạy trên các mô hình có khả năng mạnh mẽ hơn, silicon của chúng phải duy trì ở mức tiên tiến nhất: thế hệ sau Thor có khả năng chuyển sang N3 cùng với Rubin, sau đó là N2 cùng với Feynman, chính xác là các nút mà toàn bộ lộ trình bộ tăng tốc AI đang tranh giành. Vì vậy, một dòng Jetson khối lượng thấp, biên lợi nhuận thấp hơn sẽ luôn phải cạnh tranh để giành các tấm wafer nút tiên tiến từ cuối hàng đợi.
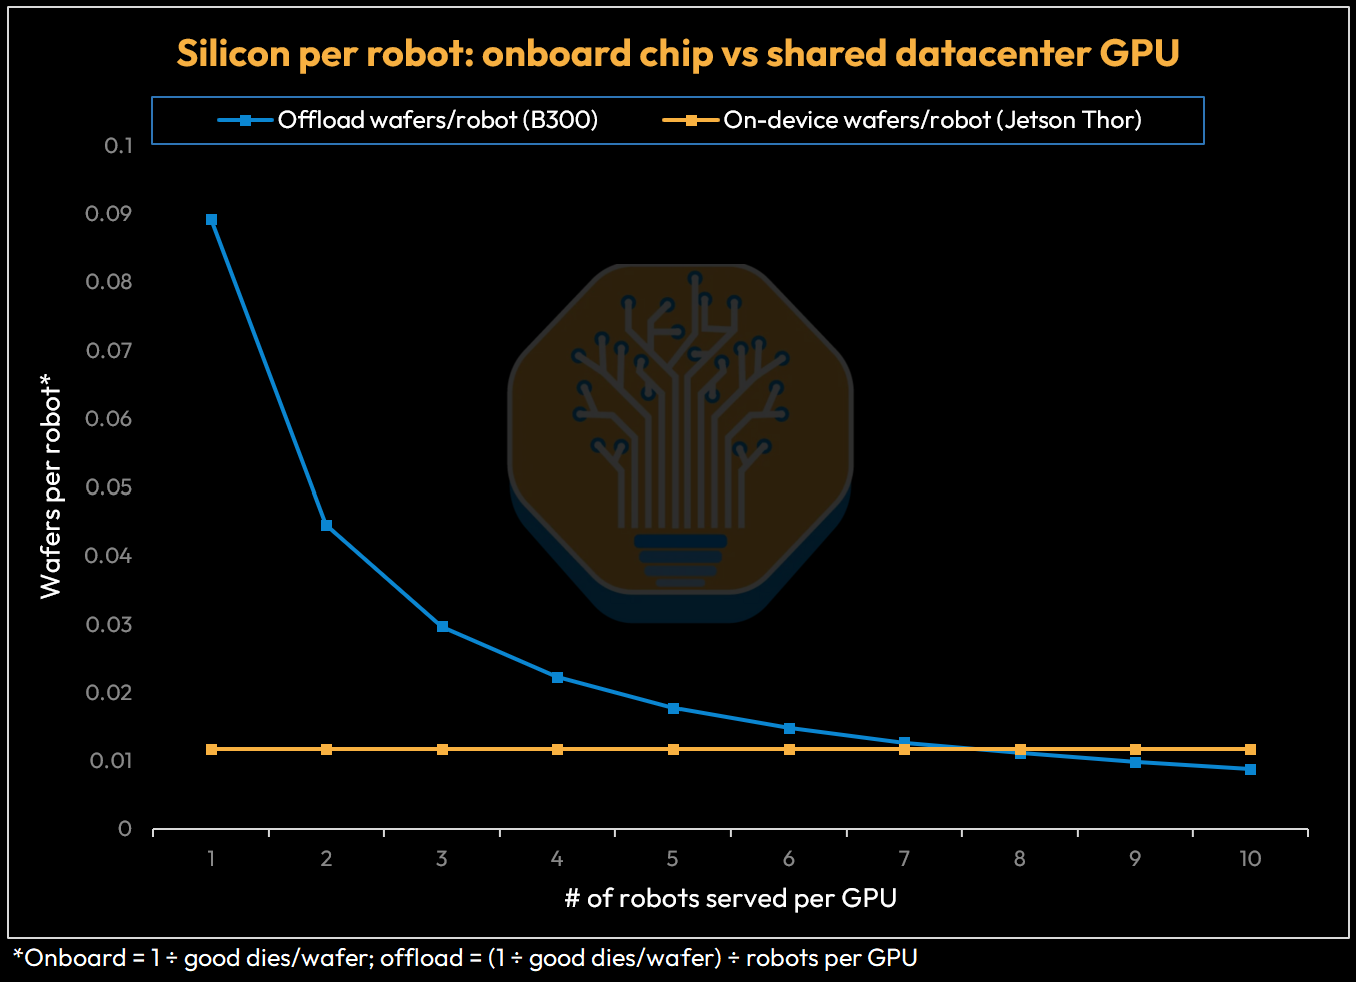
Nhưng nhu cầu wafer từ robot không phải là nơi gây ra áp lực. Một triệu chip dòng Jetson vào năm 2030, mỗi chip khoảng 400mm², chỉ chiếm khoảng mười nghìn tấm wafer mỗi năm, một sai số làm tròn so với sự tăng trưởng của GPU trung tâm dữ liệu, bởi vì kích thước chip của Thor chỉ bằng một nửa kích thước reticle, và đơn giản là chưa có nhiều robot. Nguồn cung chỉ thắt chặt khi robot cần hàng chục triệu chip mỗi năm, tức là sau năm 2030. Vì vậy, câu hỏi thực sự không phải là liệu robot có thể lấy được wafer hay không. Đó là hiệu quả sử dụng silicon: đối với một đội ngũ robot nhất định, phương pháp nào tiêu tốn ít silicon tiên tiến hơn? Đặt một con chip vào mỗi robot, hay phục vụ nhận thức của chúng từ các GPU trung tâm dữ liệu dùng chung.
Nếu bạn nhìn vào hiệu quả silicon theo số lượng wafer trên mỗi robot, con chip trên thiết bị và GPU trung tâm dữ liệu dùng chung sẽ đạt điểm cân bằng ở mức khoảng 7 robot trên mỗi GPU. Ngoài con số đó, việc phục vụ nhận thức từ một GPU dùng chung sẽ tốn ít silicon trên mỗi robot hơn là đặt một con chip vào mỗi máy. Và đó mới là điều thực sự quan trọng ở đây, bởi vì khi nguồn cung từ nhà máy khan hiếm, phương pháp sử dụng ít silicon trên mỗi robot hơn chính là phương pháp có thể mở rộng quy mô.
Một nút thắt lớn khác là bộ nhớ. Mỗi thế hệ Jetson đều mang nhiều DRAM hơn thế hệ trước: Jetson Xavier sử dụng 32GB, AGX Orin 64GB, và Jetson Thor hiện sử dụng 128GB LPDDR5X, với các thế hệ tương lai dự kiến sẽ tiếp tục tăng. Mặc dù tổng công suất wafer DRAM tiếp tục tăng, phần lớn công suất gia tăng đang bị hấp thụ bởi HBM cho các bộ tăng tốc AI. Điều đó khiến nguồn cung DRAM thông thường và LPDDR mà bộ não robot phụ thuộc vào phải cạnh tranh cho một lượng wafer không phải HBM đang ngày càng thu hẹp. Tương tự, khi DRAM là tài nguyên khan hiếm, phương pháp sử dụng ít DRAM trên mỗi robot hơn chính là phương pháp có thể mở rộng quy mô.
Bộ nhớ cũng cho thấy một câu chuyện tương tự, con chip trên thiết bị và GPU trung tâm dữ liệu dùng chung đạt điểm cân bằng ở mức khoảng 5 robot trên mỗi GPU. Ngoài con số đó, việc phục vụ nhận thức từ một GPU dùng chung sẽ tốn ít DRAM trên mỗi robot hơn là đặt một con chip vào mỗi máy.
Wafer và DRAM cho chúng ta biết phương pháp nào có thể mở rộng quy mô, nhưng chúng không nói gì về phương pháp nào rẻ hơn để vận hành. Vì vậy, câu hỏi tiếp theo là chi phí. Nếu bạn phải phục vụ cùng một đội ngũ robot, chi phí sẽ ra sao với các máy chủ B300 trong trung tâm dữ liệu, máy chủ RTX 6000 Pro trong trung tâm dữ liệu, hay một Jetson Thor trong mỗi robot?
Chúng tôi sử dụng RoboTTT của NVIDIA. Nó không có mã nguồn hoặc trọng số công khai, vì vậy chúng tôi thực hiện một phép đo kiểm chuẩn (benchmark) dựa trên việc tái cấu trúc đại diện về thời gian: các điểm kiểm tra (checkpoint) GR00T N1.7 thực tế với các khối huấn luyện tại thời điểm kiểm thử (TTT) được chèn vào đầu hành động, được xây dựng để khớp với hồ sơ tính toán và bộ nhớ của bài báo thay vì độ chính xác của nó.
Ba chi tiết để đảm bảo tính trung thực. DiT của GR00T xen kẽ các khối cross-attention và self-attention theo chỉ số, vì vậy một bước nhảy (stride) cố định đơn giản sẽ đặt mọi mô-đun TTT vào cùng một loại khối; chúng tôi chèn 16 mô-đun dưới dạng các cặp (chẵn, lẻ), 8 mô-đun theo sau cross-attention và 8 mô-đun theo sau self-attention trên 32 khối. Chúng tôi thêm 16 token đăng ký có thể học được, tạo ra chuỗi 57 token của bài báo (16 đăng ký + 1 trạng thái + 40 hành động) mà mọi mô-đun attention và TTT đều chạy trên đó. Mỗi khối thực hiện một bước gradient bên trong cho mỗi lần khử nhiễu, và mỗi robot mang theo 151 MB trạng thái trọng số nhanh (fast-weight state), được thu thập trước mỗi lần gọi theo lô và phân tán lại sau đó, đây là chi phí phục vụ đa robot mà một mô hình VLA dùng chung trọng số không phải trả.
Do đó, đường dẫn TTT tốn toàn bộ FLOPs, lưu lượng bộ nhớ và hoán đổi trạng thái trong khi vẫn giữ nguyên các hành động được phát ra. Các trọng số nhanh chưa được huấn luyện sẽ phân kỳ và tạo ra dữ liệu rác, và chúng tôi đang đo lường chi phí phục vụ thay vì sự thành công của tác vụ. Những con số này cho biết chi phí suy luận theo kiểu RoboTTT đắt đỏ như thế nào để phục vụ.
Trên cơ sở đó, một máy chủ B300 duy trì 12 robot trong thời hạn 500 ms, so với 4 robot trên một máy chủ RTX PRO 6000.
Với điều này, chúng tôi xây dựng ba kịch bản. Đối với các kịch bản chuyển tải (offload), chúng tôi giả định một máy chủ B300 cấp Blackwell có thể phục vụ tới 12 robot trên mỗi GPU, cũng như một máy chủ RTX 6000 Pro Server Edition có thể phục vụ tới 4 robot trên mỗi GPU. Đối với kịch bản trên thiết bị (on-device), mỗi robot mang theo Jetson Thor của riêng nó.
Trong cả ba kịch bản, các bộ phận chung (ví dụ: linh kiện cơ khí, vỏ robot) không được tính vào chi phí BOM (hóa đơn nguyên vật liệu).
Kịch bản chuyển tải đầu tiên là một máy chủ B300, cộng với 96 bo mạch không dây để kết nối robot với máy chủ GPU không dây (một bo mạch mỗi robot, mười hai robot mỗi GPU theo tiêu chí p99 đã đo kiểm). Điều đó đưa tổng chi phí capex lên khoảng 554.000 USD, bao gồm cả chi phí vận hành như thuê chỗ đặt máy chủ (colocation) và điện năng, dẫn đến tổng chi phí sở hữu (TCO) là 18,63 USD/giờ trong kịch bản chuyển tải. Điều này giả định kinh tế học của chủ sở hữu/người vận hành, không phải báo giá thuê đám mây.
Kịch bản chuyển tải thứ hai là sử dụng RTX 6000 Pro Server Edition. Để so sánh tương đương, 96 robot yêu cầu ba máy chủ 8-GPU, vì RTX 6000 Pro có thể phục vụ bốn robot trên mỗi GPU theo tiêu chí p99 đã đo kiểm. Tổng cộng, chi phí này là 436.000 USD capex, dẫn đến tổng TCO là 15,61 USD/giờ.
Kịch bản trên robot là 96 mô-đun Jetson Thor với giá 3.500 USD mỗi đơn vị, mỗi đơn vị có bo mạch cơ sở, bộ nhớ, làm mát, pin tăng cường và kết nối vô tuyến trên bo mạch riêng, tổng cộng khoảng 394.000 USD. Tính toán các yếu tố trên, cùng với chi phí điện năng cho các mô-đun Thor, dẫn đến TCO là 14,97 USD/giờ cho việc triển khai 96 chip.
Chúng tôi giả định vòng đời hữu dụng là bốn năm cho một Jetson Thor trên thiết bị, ngắn hơn so với GPU trung tâm dữ liệu, vì môi trường mà nó hoạt động. Một GPU trong tủ rack không bao giờ di chuyển. Một Jetson trên robot nằm trên một khung gầm rung lắc liên tục, chịu những cú va đập mạnh, và tùy thuộc vào công việc, nó có thể bị rơi, bị bắn nước hoặc hoạt động trong môi trường làm việc không cấu trúc cả ngày. Sự căng thẳng cơ học đó làm phần cứng nhanh hỏng hơn. Một số nhà vận hành mà chúng tôi đã trao đổi đưa ra con số dưới bốn năm, nhưng chúng tôi nghĩ bốn năm là một giả định hợp lý.
Bài viết được AI dịch và tổng hợp tự động từ SemiAnalysis RSS. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.