Hướng dẫn
Modal chia sẻ bí quyết vận hành Kimi K2.6: Tối ưu hóa suy luận cho Agent lập trình quy mô nghìn tỷ token
(giờ Việt Nam)
Tóm tắt AI
Modal tiết lộ kỹ thuật tối ưu hóa giúp tăng 2,8 lần hiệu suất mỗi người dùng và 5,6 lần thông lượng cho mô hình Kimi K2.6, cho phép xử lý hàng trăm tỷ token mỗi ngày.
Chính văn · Bản dịch AI
Phần mềm đang xâm chiếm thế giới, và các tác nhân (agent) đang xâm chiếm kỹ thuật phần mềm. Việc các kỹ sư phần mềm phát triển sự hiểu biết không chỉ về phần mềm tác nhân – công cụ quan trọng nhất của họ hiện nay – mà còn về cách thức hoạt động của lõi thông minh trong phần mềm tác nhân thông qua suy luận bởi các mô hình ngôn ngữ tạo sinh lớn là điều bắt buộc. Nếu không phải vì nhu cầu hiểu và kiểm soát công cụ của kỹ sư, thì ít nhất cũng vì suy luận đang trên đà tiêu thụ nhiều năng lượng tính toán hơn và tạo ra nhiều lợi ích hơn tất cả các mục đích sử dụng máy tính khác cộng lại.
Thực tế cốt lõi về các dịch vụ suy luận cho các tác nhân lập trình là chúng phải vận hành ở hiệu suất tương đối và tuyệt đối cực kỳ cao.
Về hiệu suất tương đối, chúng tôi muốn nói đến tỷ trọng lớn của tốc độ đỉnh hoặc "tốc độ ánh sáng" của phần cứng mà nó sử dụng. Về hiệu suất tuyệt đối, chúng tôi muốn nói rằng quy mô của tốc độ đỉnh đó và khối lượng công việc thực hiện trên mỗi yêu cầu là rất lớn. Các bộ tăng tốc toán học ma trận hiện đại như Tensor Cores hoạt động ở quy mô petaFLOP mỗi giây. Các mô hình chuỗi tạo sinh lớn với đủ trí thông minh để tự động hóa phát triển phần mềm có hàng nghìn tỷ tham số dấu phẩy động, và mỗi tham số phải được truy cập nhiều lần mỗi giây, ngay cả khi chỉ phục vụ một yêu cầu duy nhất.
Do những yêu cầu này, các dịch vụ suy luận tác nhân lập trình khả thi về mặt kinh tế hiện chỉ có thể thực hiện được bằng cách vận hành ở quy mô đủ lớn để khấu hao chi phí phần cứng và kỹ thuật — đại khái là ở quy mô hàng nghìn tỷ token đầu vào và đầu ra.
Chúng tôi đã thực hiện điều này và muốn chia sẻ cách thức thực hiện.
Tại Modal, chúng tôi vận hành một số dịch vụ suy luận như vậy cho các tác nhân lập trình ở quy mô này và làm việc với nhiều khách hàng cũng làm điều tương tự. Bạn có thể sử dụng dịch vụ của chúng tôi gián tiếp thông qua các nền tảng định tuyến suy luận như OpenRouter hoặc Vercel AI Gateway, hoặc trực tiếp thông qua các Shared Endpoints của chúng tôi.
Trong bài viết blog này, chúng tôi sẽ hướng dẫn cách tối ưu hóa hiệu suất suy luận khi phục vụ các suy luận từ mô hình Kimi K2.6 của Moonshot AI để cung cấp năng lượng cho các tác nhân lập trình. Mặc dù mô hình này là "cũ" theo tiêu chuẩn của lĩnh vực này (thực sự đã hàng trăm ngày tuổi!), các nguyên tắc cơ bản về mô hình hóa chuỗi, phần cứng và mở rộng quy mô thay đổi đủ chậm để câu chuyện cốt lõi và nhiều chi tiết vẫn khớp với những gì chúng tôi đã làm cho các mô hình gần đây hơn đã thay thế K2.6 về trí thông minh và hiệu suất chi phí, như Kimi K3.
Các tối ưu hóa của chúng tôi cho phép chúng tôi mở rộng hiệu suất trên mỗi bản sao (replica) của suy luận lên gấp 2,8 lần cho mỗi người dùng và 5,6 lần trên mỗi bản sao cho tất cả người dùng:
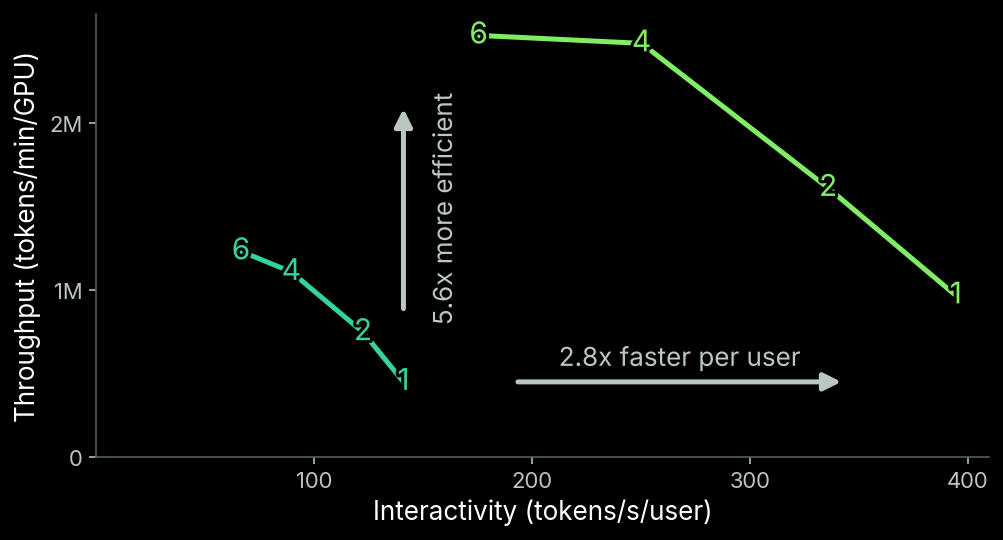
Biểu đồ này liên kết trải nghiệm của từng người dùng (số token giải mã mỗi giây cho mỗi người dùng, hay còn gọi là tính tương tác) trên trục x với hiệu suất chi phí của toàn bộ hệ thống trên trục y (tổng số token mỗi phút trên mỗi GPU, hay còn gọi là thông lượng token), với số lượng người dùng đồng thời được chỉ định tại mỗi điểm.
Trực quan hơn, đó là sự khác biệt giữa một dịch vụ đắt đỏ đến mức phá sản với trải nghiệm người dùng (UX) ở phía dưới bên phải và một dịch vụ cạnh tranh về giá với UX ở phía bên trái:
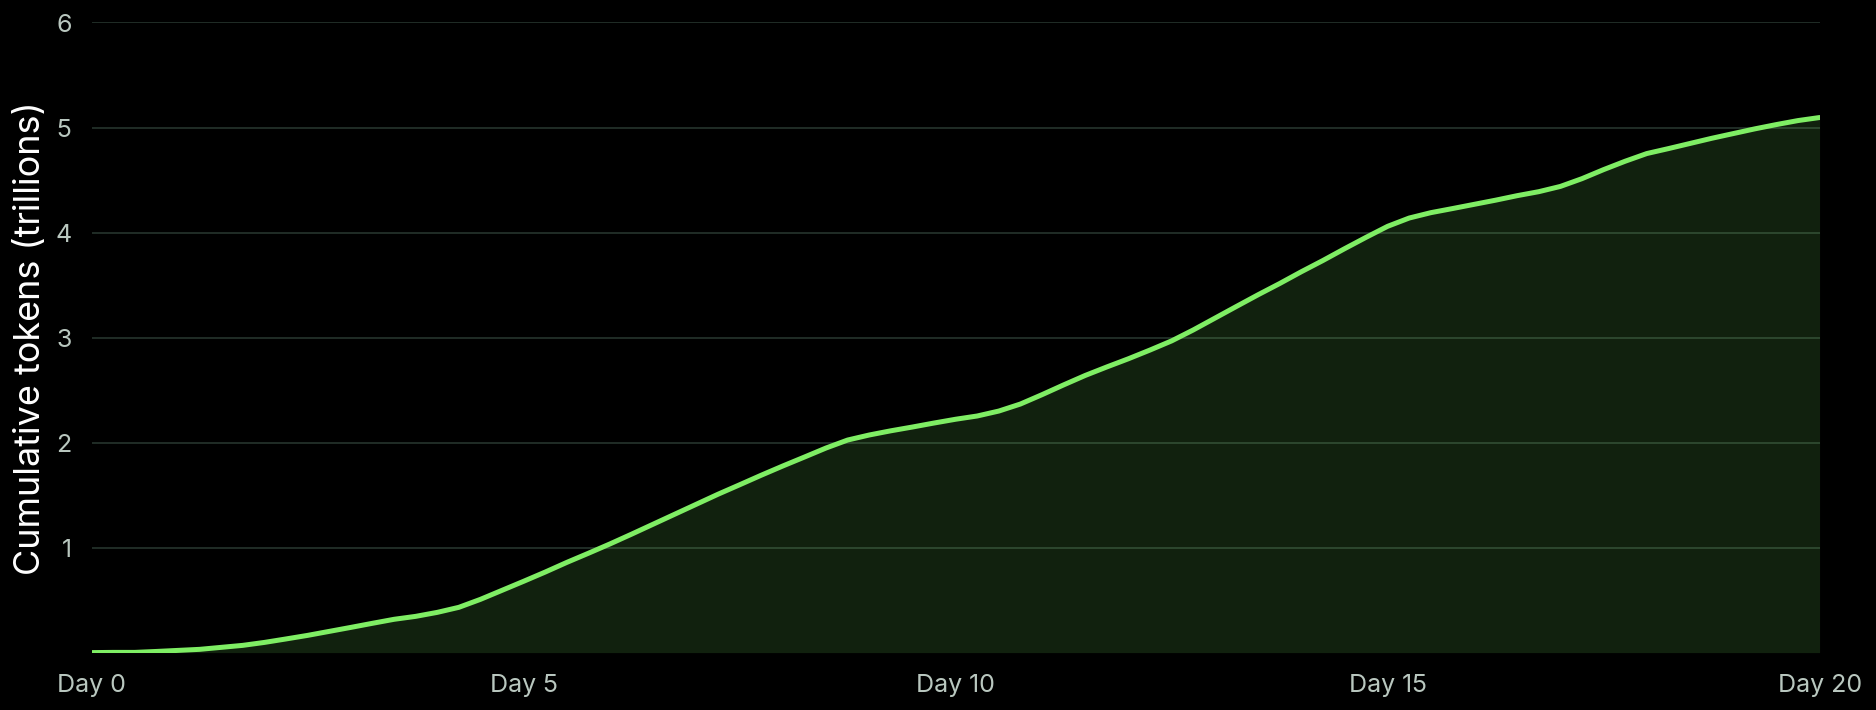
Sau đó, chúng tôi đã mở rộng các bản sao đơn container đó thành các triển khai và dịch vụ. Một dịch vụ cụ thể đã xử lý hàng trăm tỷ token mỗi ngày và hàng nghìn tỷ token tổng cộng:
Dưới đây, chúng tôi hướng tới việc làm cho kỹ thuật hiệu suất này trở nên dễ hiểu đối với đối tượng kỹ sư phần mềm nói chung. Bằng cách chia sẻ cách chúng tôi và khách hàng của mình có thể vận hành các dịch vụ này, chúng tôi hy vọng nó sẽ giúp bạn làm điều tương tự — có lẽ bằng cách triển khai một Dedicated Endpoint trên Modal.
Đầu tiên, hãy hiểu về khối lượng công việc.
Chúng tôi chia điều này thành hai phần: hiểu về mô hình chuỗi suy luận phản hồi cho từng yêu cầu và hiểu cấu trúc khối lượng công việc giữa các yêu cầu.
Các tác nhân lập trình hiện đại nhất được hỗ trợ bởi các mô hình chuỗi thần kinh có hàng nghìn tỷ tham số, xử lý đầu vào song song và suy luận đầu ra tuần tự.
Các tác nhân lập trình đương đại được cung cấp năng lượng bởi các mô hình tạo sinh xác suất của các chuỗi unicode, được huấn luyện trước chủ yếu thông qua dự đoán chuỗi bị che (masked sequence prediction) không giám sát và được huấn luyện sau chủ yếu bằng cách củng cố tính đúng đắn của phần mềm đầu ra. Giống như trình phân tích cú pháp của trình biên dịch, chúng không hoạt động trên các chuỗi ký tự thô mà trên các chuỗi token, vì vậy chúng tôi gọi đầu vào và đầu ra của chúng là các token. Bởi vì cuối cùng chúng ta đang đoán xem các token đầu ra nên là gì, đây được gọi là suy luận. Nếu bạn thích suy diễn, hãy gắn bó với cơ sở dữ liệu và hệ điều hành.
Các mô hình chuỗi cơ bản hiện nay là các mạng thần kinh Transformer kết hợp chú ý (hybrid-attention) và hỗn hợp chuyên gia (mixture-of-experts). Các mạng này áp dụng các tính toán cho mỗi token trong chuỗi và trên các token trong chuỗi.
Chú ý (Attention) đã phát triển thành một thuật ngữ chung cho tính toán chéo token. Hỗn hợp chuyên gia (Mixture-of-experts) đề cập đến phép nhân ma trận thưa thớt khối được định tuyến động, áp dụng phần lớn các tính toán cho mỗi token. Các tính toán này cập nhật lặp đi lặp lại biểu diễn nội tại hoặc tiềm ẩn của mạng.
Để có cái nhìn sâu sắc về những gì đang diễn ra bên trong các mô hình chuỗi này, hãy xem “A Mathematical Framework for Transformer Circuits” của Anthropic (2021, nhưng vẫn chưa có đối thủ).
Một lần truyền tiến (forward pass) duy nhất qua mạng thần kinh như vậy tạo ra cả trạng thái nội tại đáng kể và phân phối xác suất trên (các) token tiếp theo trong chuỗi cho mỗi vị trí chuỗi. Bởi vì chúng ta dự đoán (”hồi quy”) dựa trên chính đầu ra của mình (”tự”), đây là mô hình hóa chuỗi tự hồi quy.
Để phản hồi yêu cầu của khách hàng, chúng tôi thường kết nối nhiều lần truyền tiến lại với nhau như sau:
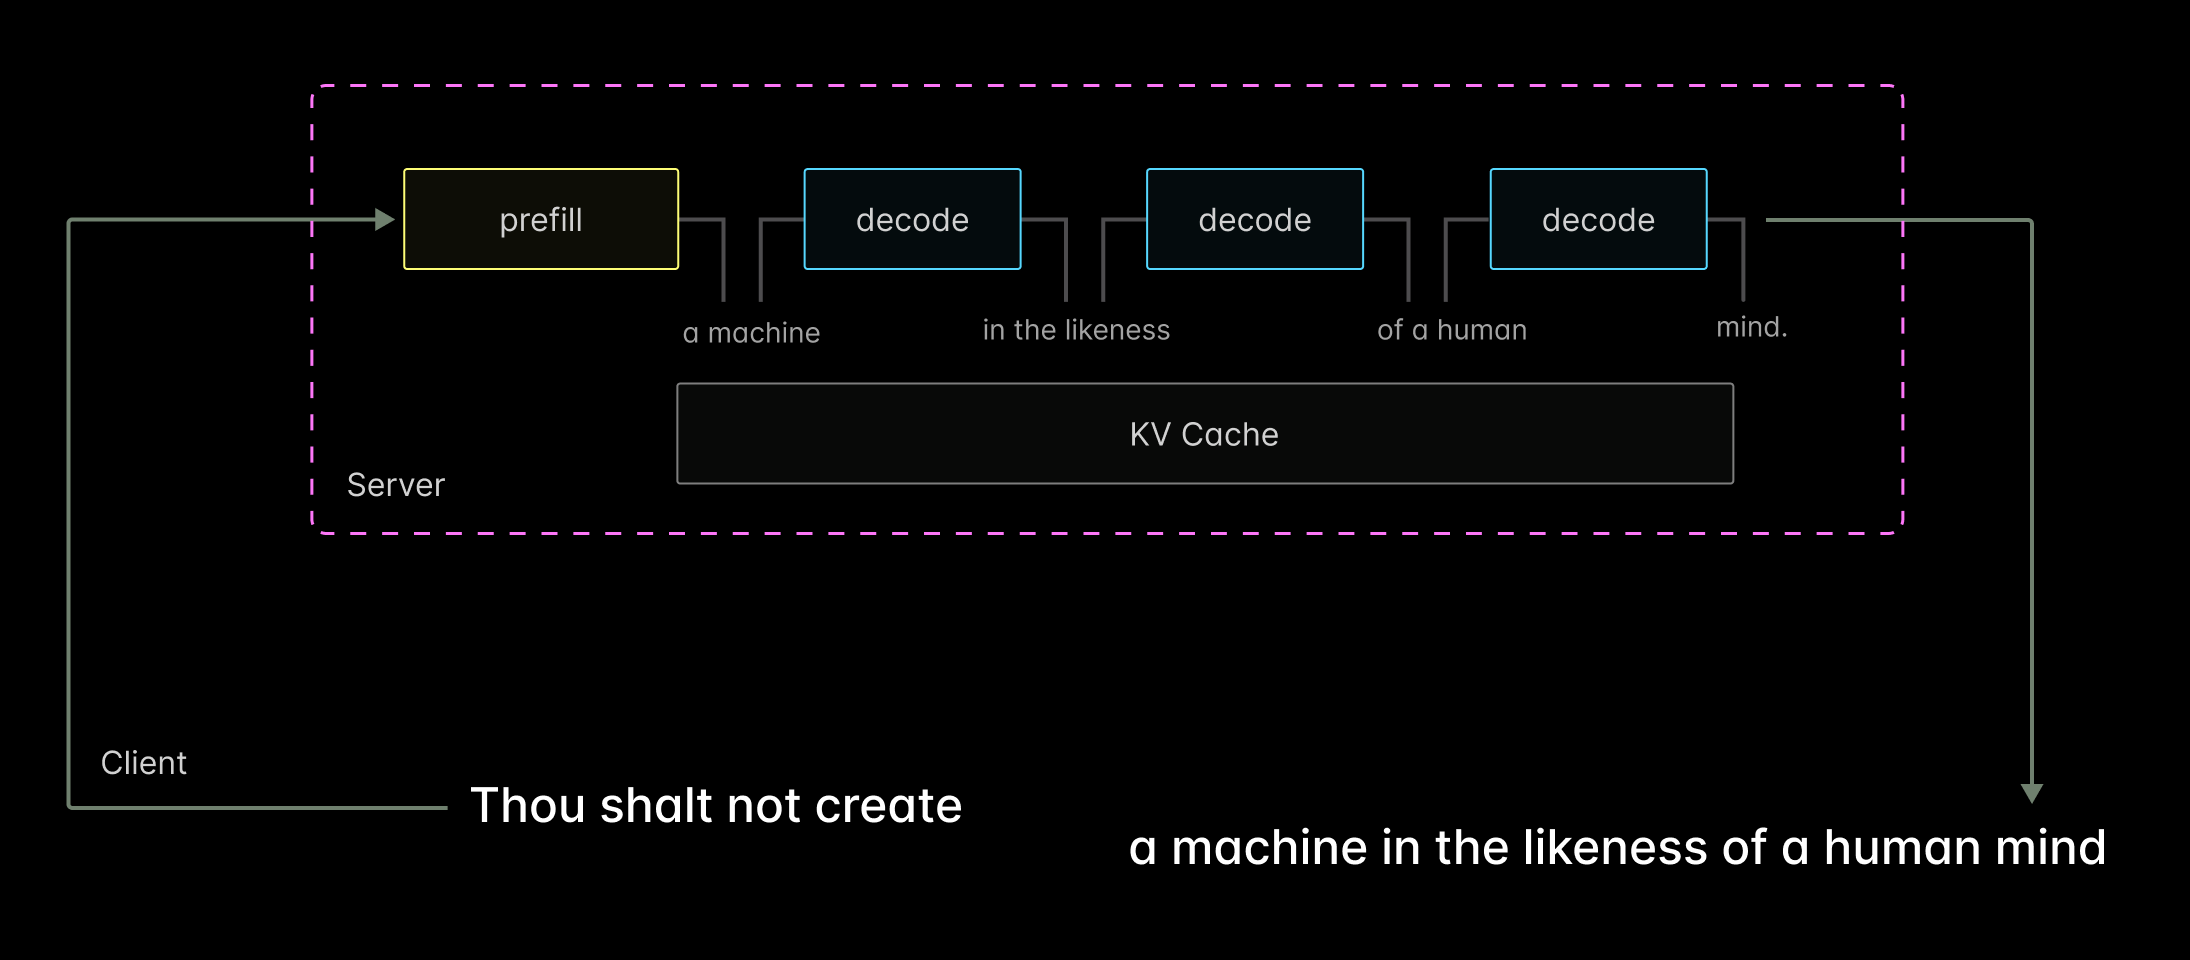
Các lần truyền tiến rất tốn kém, vì vậy chúng tôi muốn khấu hao công việc này nhiều nhất có thể. Phần lớn công việc trong tính toán cho mỗi token được khấu hao bằng cách gộp (batching) nhiều chuỗi lại với nhau. Phần lớn công việc trong tính toán chéo token được khấu hao bằng cách lưu trữ trạng thái nội tại. Vì lý do lịch sử, đây được gọi là bộ nhớ đệm khóa-giá trị (KV cache hoặc chỉ là KV), mặc dù các mô hình đương đại như Kimi không có các khóa và giá trị riêng biệt. Bạn có thể đọc thêm về "toán học trên giấy ăn" tại bài blog “Transformer Inference Arithmetic” xuất sắc của Kipply (2022, nhưng vẫn chưa có đối thủ).
Khi một lần truyền tiến xử lý các token đầu vào của yêu cầu, chúng tôi gọi đó là prefill, vì nó đang "lấp đầy trước" bộ nhớ đệm KV. Khi một lần truyền tiến tạo ra các token đầu ra của phản hồi, chúng tôi gọi đó là decode, vì chúng tôi đang "giải mã" sự "mã hóa" trạng thái quá khứ của mô hình thành tương lai được dự đoán. Còn các lần truyền tiến thực hiện cả hai thì sao? Vâng, chúng tôi cũng không thích thuật ngữ đó.
Hiệu suất prefill chủ yếu được theo dõi bằng độ trễ để hoàn thành tất cả các prefill cho một yêu cầu, hay còn gọi là thời gian đến token đầu tiên (TTFT). Hiệu suất decode chủ yếu được đo bằng tốc độ tạo ra các token đầu ra sau đó, hay còn gọi là số token đầu ra mỗi giây (TPS). Cả hai đều có thể được đo ở phía máy khách hoặc phía máy chủ, gây ra sự nhầm lẫn không hồi kết.
Mô hình chuỗi cụ thể được đề cập trong bài viết này là Kimi K2.6 của Moonshot AI. Mô hình này tham số hóa các phép nhân ma trận của nó với khoảng một nghìn tỷ con số (trọng số trong các ma trận của nó), phần lớn trong số đó được lưu trữ dưới dạng số nguyên bốn bit (INT4).
Tuy nhiên, chúng tôi vận hành mô hình bằng số dấu phẩy động 4-bit (FP4). Bốn bit chỉ cung cấp mười sáu giá trị riêng biệt, vì vậy bạn cần thêm một định dạng vi tỷ lệ (micro-scaling format) để điều chỉnh các khối riêng lẻ trong tensor một cách độc lập. Chúng tôi đã chọn định dạng vi tỷ lệ NVFP4, vốn có hỗ trợ phần cứng gốc ở quy mô petaFLOP/s trong các Tensor Cores của kiến trúc Streaming Multiprocessor Architecture trên các GPU Blackwell như B200 và B300. Vì chúng tôi vận hành một đội ngũ GPU linh hoạt trong thời điểm nguồn cung điện toán bị hạn chế, chúng tôi chuẩn bị triển khai để chạy trên cả GPU B200 và B300. Các kết quả dưới đây đều dành cho GPU B200; các GPU B300 về cơ bản tương tự nhưng hoạt động ở mức độ đồng thời yêu cầu cao hơn vì chúng có nhiều bộ nhớ băng thông cao (HBM) hơn để lưu trữ bộ nhớ đệm.
Chúng tôi chọn công cụ suy luận SGLang làm nền tảng. Chúng tôi đã tìm thấy một số cơ hội để cải thiện hiệu suất bằng cách vá lỗi công cụ này. Với tư cách là những người đóng góp cho dự án SGLang, chúng tôi đã đưa các bản vá này lên nhánh chính (upstream), được mô tả và liên kết trong bài viết dưới đây.
Để tối ưu hóa trải nghiệm người dùng (UX) và hiệu quả chi phí, bạn phải hiểu cấu trúc của các chuỗi này trên các yêu cầu.
Khi bạn phục vụ các mô hình như vậy cho lưu lượng truy cập của tác nhân lập trình (coding agent) một cách ngây thơ, bạn sẽ nhận được kết quả kém.
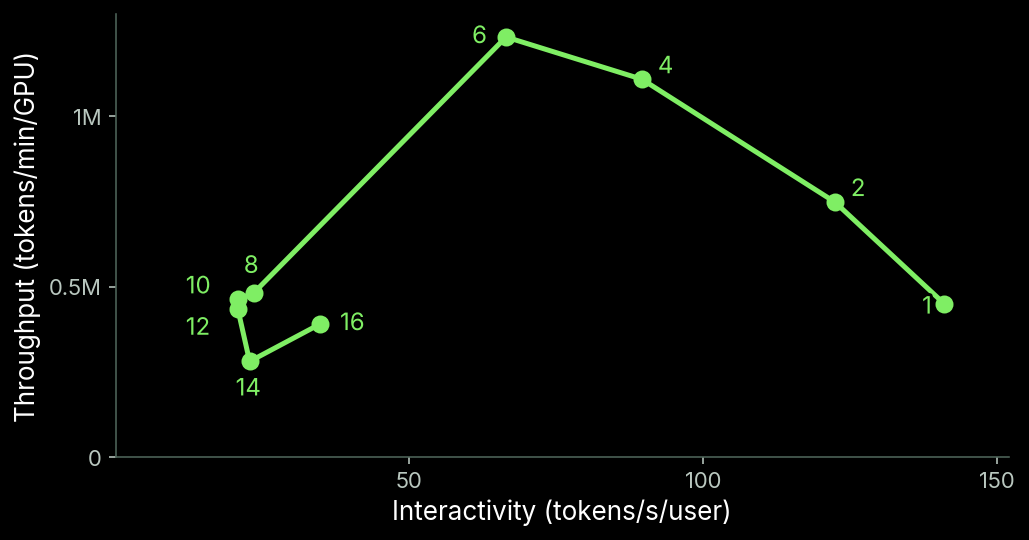
Biểu đồ này chỉ ra rằng thông lượng và tính tương tác giảm nhanh chóng khi vượt quá 6 người dùng đồng thời. Hơn nữa, ngay cả trước khi đạt đến đỉnh điểm đó, tính tương tác vẫn thấp hơn kỳ vọng của người dùng và hệ thống hoạt động dưới mức hiệu quả chấp nhận được.
Vì vậy, từ đây, bạn cần tăng tính tương tác và thông lượng để mang lại kết quả tốt hơn cho người dùng trong khi giảm chi phí của chính mình. Để làm được điều đó, bạn cần hiểu các chuỗi trong khối lượng công việc này sâu sắc hơn là chỉ "đầu vào token và đầu ra token".
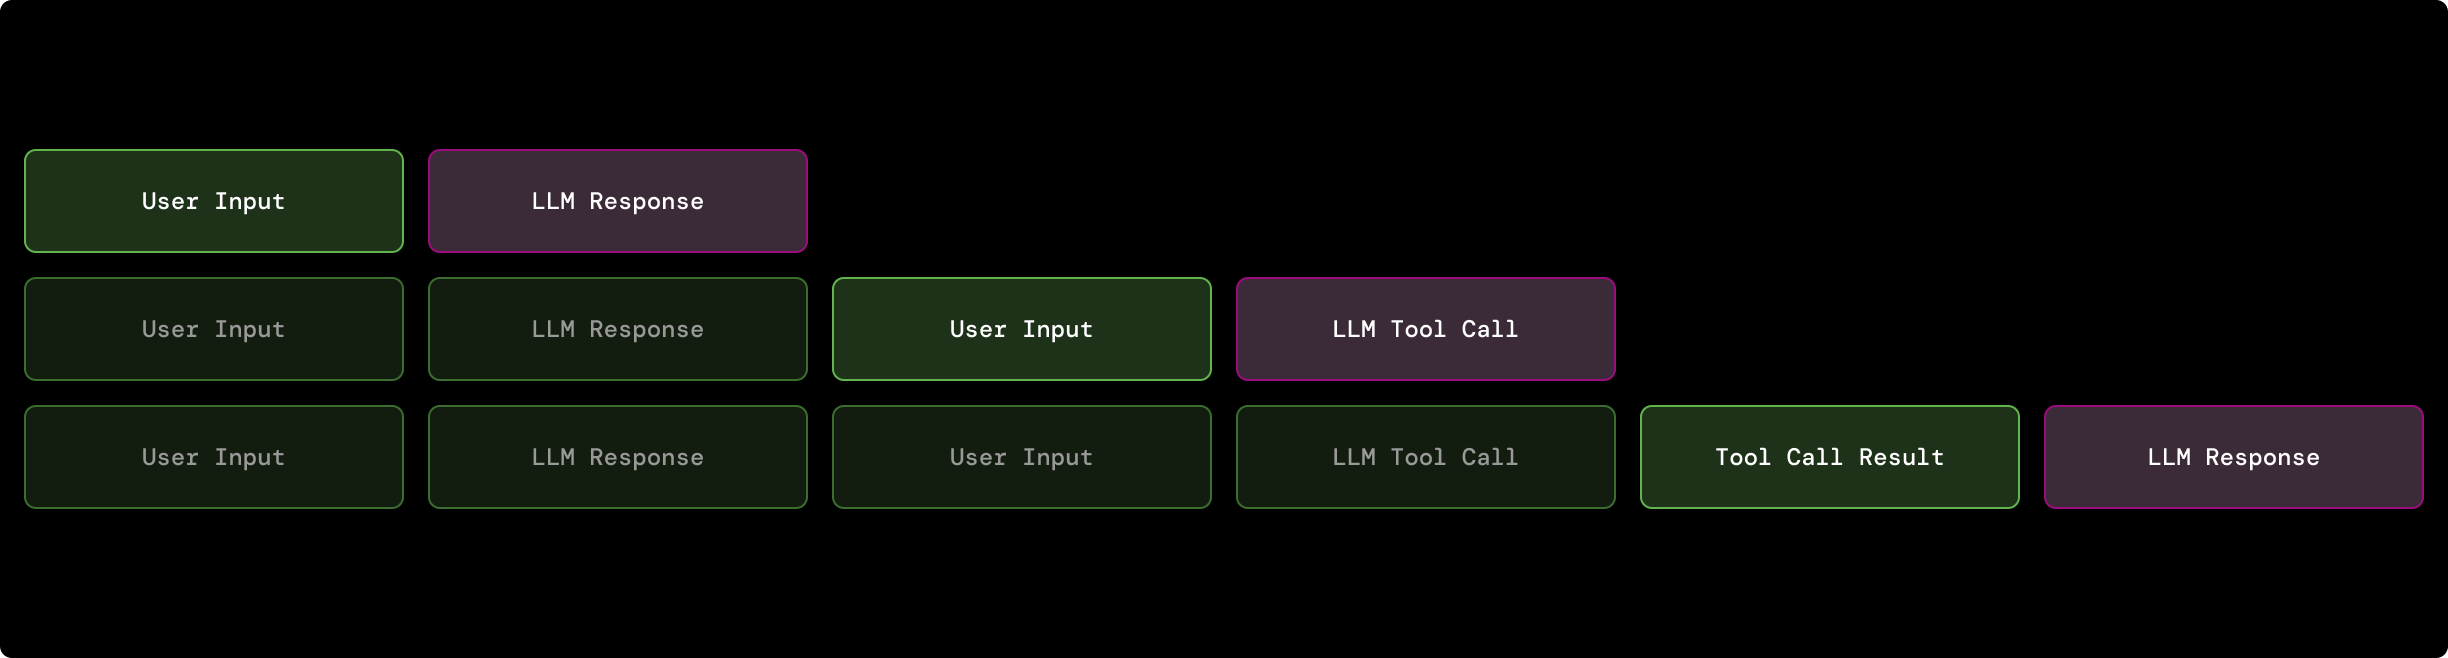
Các yêu cầu riêng lẻ cho token đầu ra được tạo trong các "phiên": người dùng, mô hình tạo sinh và các lệnh gọi công cụ liên kết với nhau một cách lặp đi lặp lại để xây dựng một tháp các chuỗi đầu vào, tích lũy ngữ cảnh — và giá trị — theo thời gian. Quá trình lặp đi lặp lại của việc xây dựng ý nghĩa, khám phá thông tin và tạo lập ý nghĩa khiến chúng tôi thấy rằng nó là nền tảng cho bản chất của mô hình hóa chuỗi và hành động tuần tự, vì vậy chúng tôi kỳ vọng mô hình này sẽ tồn tại lâu hơn nhiều so với các "tác nhân lập trình".
Cụ thể, một phiên đơn lẻ trông giống như thế này:
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Modal Blog kỹ thuật chính thức. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.