Tin ngành
Databricks giới thiệu RADAR: Giải pháp phát hiện lỗi 'xám' bằng AI
(giờ Việt Nam)
Tóm tắt AI
Databricks ra mắt RADAR, hệ thống phát hiện lỗi 'xám' bốn giai đoạn sử dụng mô hình học máy không giám sát SPOT. Công nghệ này giúp tự động hóa việc phát hiện sự cố mà không cần thiết lập ngưỡng thủ công, đạt độ chính xác trên 90% và tăng tốc độ xử lý lỗi lên 95% trong môi trường thực tế.
Bản dịch AI
Một số sự cố gây thiệt hại nặng nề nhất lại là những sự cố mà hệ thống giám sát của bạn không bao giờ cảnh báo: một nhóm khách hàng của bạn âm thầm gặp lỗi trong khi mọi kiểm tra trạng thái (health check) vẫn báo bình thường. Những "lỗi xám" (gray failures) này gây thất thoát người dùng và doanh thu trong nhiều giờ trước khi có ai đó nhận ra vấn đề. Bài viết này nói về việc phát hiện sớm chúng bằng cách phát hiện bất thường (anomaly detection) — cách chúng tôi thực hiện tại Databricks với một hệ thống gọi là RADAR, và cách bạn có thể xây dựng hệ thống tương tự cho bất kỳ chỉ số nào quan trọng nhất đối với doanh nghiệp của mình. Bài viết dành cho những người chịu trách nhiệm về độ tin cậy của dịch vụ: SRE, kỹ sư nền tảng và dữ liệu, nhân viên trực sự cố (on-call responders) và các lãnh đạo kỹ thuật mà họ báo cáo.
Khi mọi thứ đều "xanh" nhưng chẳng có gì ổn cả
Hãy tưởng tượng một ngày thứ Tư bình thường. Công việc của bạn là giữ cho dịch vụ hướng tới khách hàng luôn ổn định, và mọi bảng điều khiển trên tường của bạn đều hiển thị màu xanh — CPU khỏe mạnh, độ trễ ổn, máy chủ hoạt động, cơ sở dữ liệu kết nối tốt. Theo mọi tín hiệu mà nhóm bạn theo dõi, hệ thống trông có vẻ hoàn hảo.
Nhưng thực tế thì không.
Trong gần bảy giờ, hệ thống giám sát của bạn vẫn khẳng định mọi thứ đều ổn trong khi khách hàng rời bỏ và doanh thu thì thất thoát.
Lỗi xám (gray failure) là gì?
Ngày thứ Tư đó là một ví dụ điển hình về lỗi xám. Bề ngoài, mọi thứ trông có vẻ khỏe mạnh; nhưng bên dưới, một phần cụ thể đã âm thầm ngừng hoạt động — và nó gây hại cho khách hàng mà không bao giờ kích hoạt cảnh báo.
Hai điều khiến lỗi xám trở nên cực kỳ tinh vi:
Hãy coi nó như khói sau bức tường. Từ bên ngoài, ngôi nhà trông có vẻ ổn, nhưng bên trong, thiệt hại đang lan rộng — và bạn càng chờ đợi lâu, phạm vi ảnh hưởng (blast radius) càng lớn. Các nhà nghiên cứu cũng có tên gọi cho vấn đề cơ bản này: bài báo "Microsoft’s Gray Failure: The Achilles’ Heel of Cloud-Scale Systems" gọi đó là khả năng quan sát khác biệt (differential observability) — các bộ phát hiện lỗi của bạn không nhận thấy vấn đề ngay cả khi người dùng của bạn thấy rõ điều đó.
Tại sao việc chờ đợi báo cáo từ khách hàng lại thất bại
Hầu hết các nhóm xử lý lỗi xám theo đúng cách đã xảy ra vào ngày thứ Tư đó: họ chờ khách hàng thông báo. Báo cáo từ khách hàng rất quan trọng — đó là nỗi đau thực sự của con người — nhưng khách hàng không nên là hệ thống giám sát của bạn. Việc chỉ dựa vào các báo cáo có ba vấn đề:
Giải pháp không phải là ngừng đọc các yêu cầu hỗ trợ (tickets) — hãy cứ tiếp tục làm điều đó. Giải pháp là thêm tính năng phát hiện tự động chạy liên tục và bắt được những gì con người bỏ lỡ. Cụ thể, bạn muốn một thứ gì đó kích hoạt ngay khi số lượng khách hàng gặp cùng một vấn đề tại cùng một thời điểm cao hơn mức bình thường.
Giới thiệu RADAR
Đó là ý tưởng đằng sau RADAR — Reliability Anomaly Detection, Alerting, and Root-cause analysis (Phát hiện bất thường, Cảnh báo và Phân tích nguyên nhân gốc rễ về độ tin cậy). Chúng tôi đã xây dựng nó tại Databricks để bắt các lỗi xám trong vài phút thay vì vài giờ. Cái tên này rất phù hợp: khi tầm nhìn thấp, bạn không đợi cho đến khi có sự cố xảy ra — bạn quét các tín hiệu yếu từ sớm.
Đây là cách chúng tôi áp dụng nó vào một tín hiệu đặc biệt hữu ích: lỗi người dùng (user errors).
Lỗi xám thường xuất hiện dưới dạng một đợt tăng đột biến các lỗi trông như lỗi do người dùng. Hãy tưởng tượng một nhóm người dùng ở một khu vực đột nhiên không thể khởi chạy một loại cụm (cluster) nhất định. Mỗi yêu cầu đều thất bại với mã INVALID_ARGUMENT - một lỗi lịch sự nói rằng, "lỗi này là do bạn".
Nhưng khi nhiều người dùng gặp cùng một lỗi "do bạn" tại cùng một thời điểm, thì đó không còn là lỗi của họ nữa. Đó là lỗi của chúng ta. Sự tăng đột biến đó chính xác là mô hình mà RADAR được xây dựng để bắt lấy.
Bốn giai đoạn của RADAR
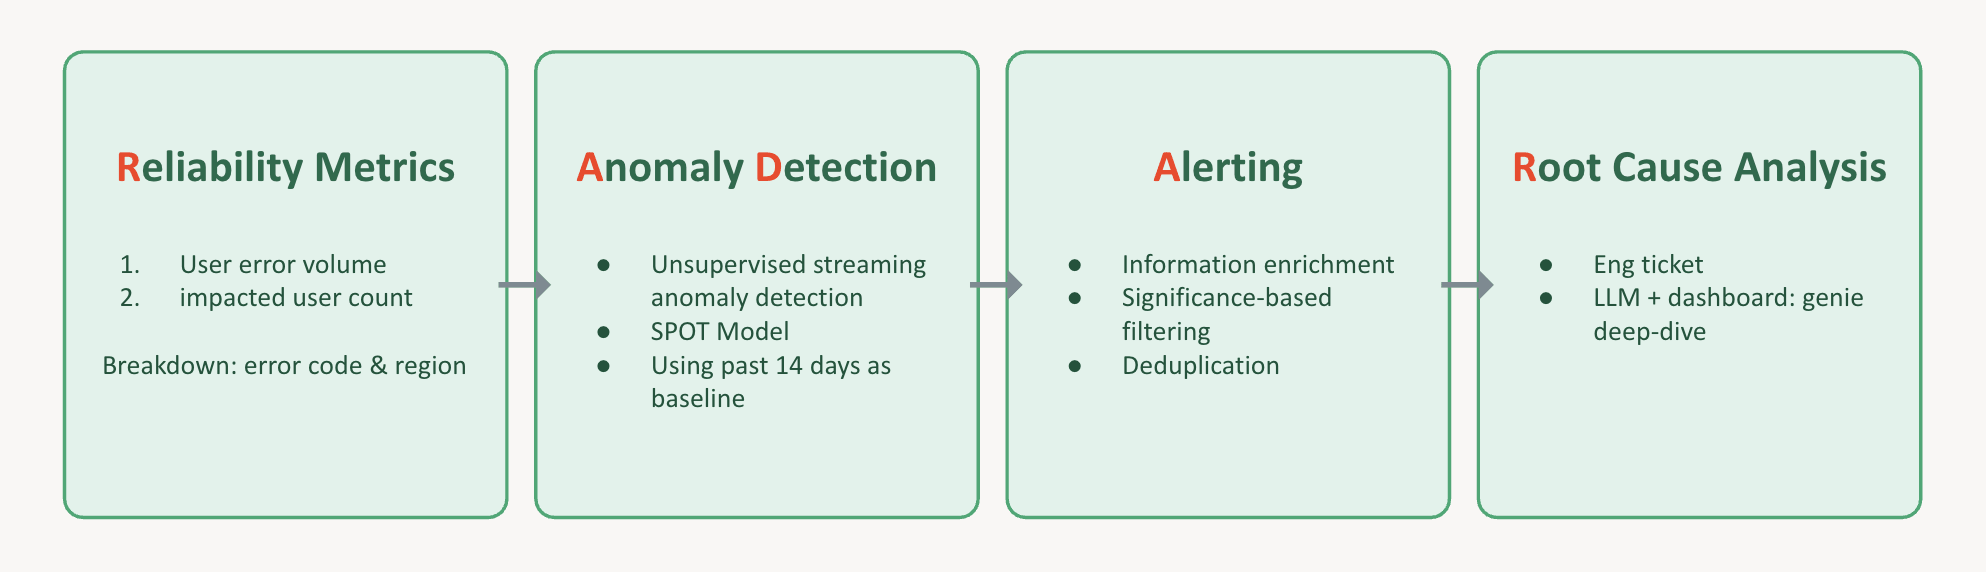
RADAR biến bản năng đó thành một quy trình gồm bốn giai đoạn:
Những gì chúng tôi đã đạt được
Việc chạy RADAR trên chính hệ thống của mình đã thay đổi hình thái của các sự cố này. Trước đây, chúng tôi chờ đợi các yêu cầu từ khách hàng để phát hiện sự cố, dẫn đến sự chậm trễ kéo dài hàng ngày. Với RADAR, chúng tôi đã đạt được mức giảm 95% thời gian phát hiện sự cố, với độ chính xác hơn 90%, mà không cần con người phải phát hiện mô hình. Kết quả là, chúng tôi có thể kiểm soát phạm vi ảnh hưởng của các lỗi xám.
Áp dụng RADAR cho bất kỳ chỉ số nào
Đây là phần quan trọng nhất đối với bạn: RADAR không quan tâm chỉ số đó là gì. Chúng tôi tình cờ áp dụng nó cho lỗi người dùng, nhưng cùng một mô hình đó hoạt động ở bất cứ nơi nào mà một con số có thể âm thầm gặp vấn đề:
Đó là cùng một mô hình trong các thiết lập khác nhau. Bất cứ nơi nào bạn có thứ gì đó có thể âm thầm gặp lỗi, RADAR đều có thể áp dụng.
Tự xây dựng trên Databricks
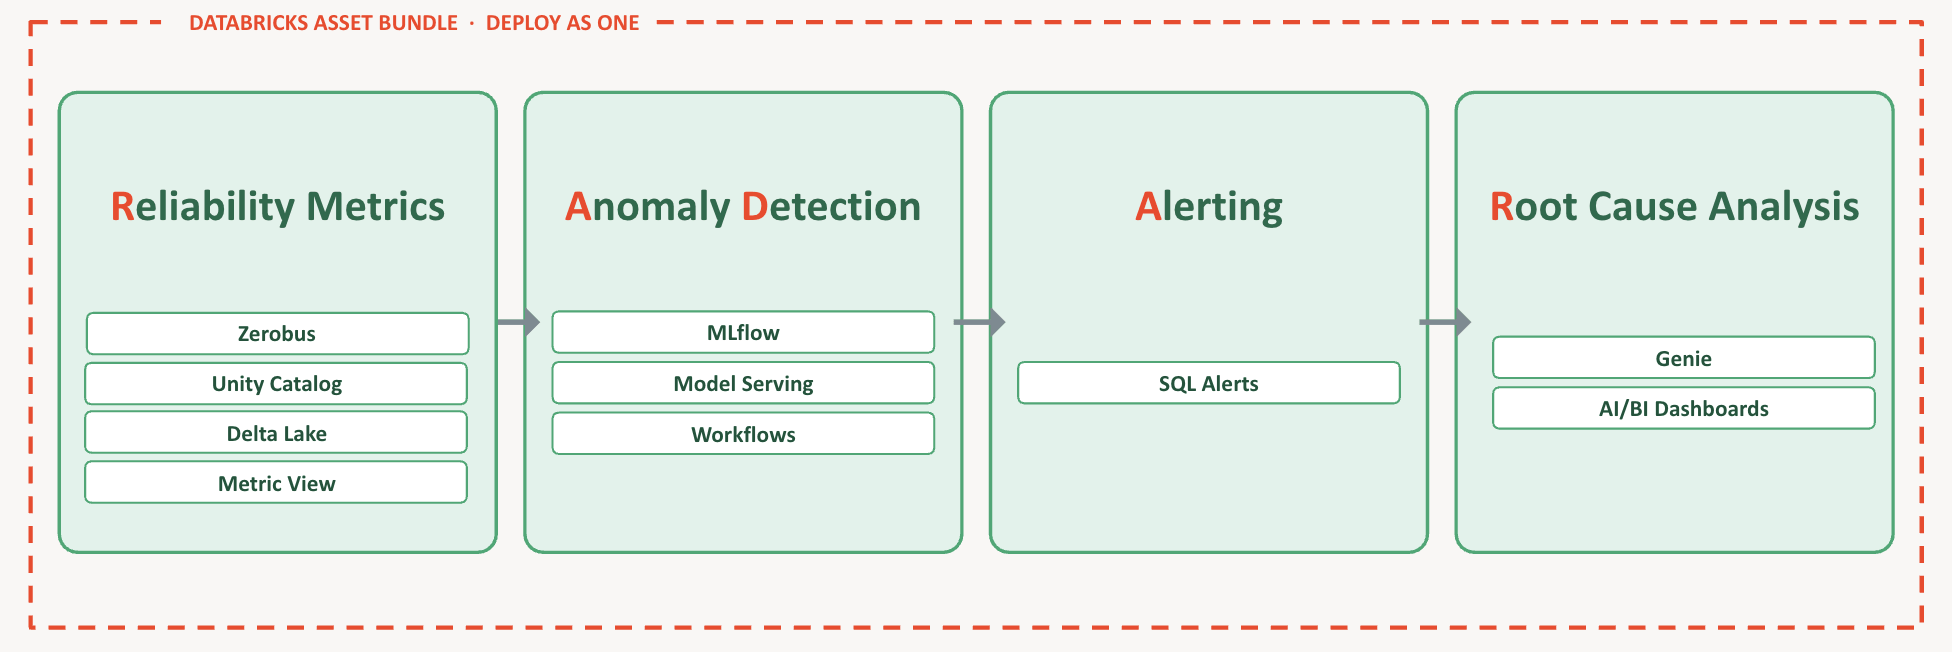
Tin tốt nhất: mọi thành phần bạn cần đều đã có sẵn trên Databricks. Ánh xạ bốn giai đoạn đó vào nền tảng và nó trông như thế này:
Và toàn bộ hệ thống được triển khai như một đơn vị duy nhất thông qua Declarative Asset Bundle (DAB).
Việc kết nối thủ công tất cả các phần đó là phần gây khó chịu nhất — vì vậy chúng tôi đã loại bỏ nó. Chúng tôi đã chắt lọc toàn bộ hệ thống RADAR nội bộ thành một khung duy nhất: một tệp markdown hoạt động như một công thức, ánh xạ từng phần của RADAR tới một thành phần cụ thể của Databricks (thu thập và lưu trữ → bảng Delta; phát hiện bất thường → một job; cảnh báo và khử trùng lặp → một ticket; trực quan hóa → một bảng điều khiển).
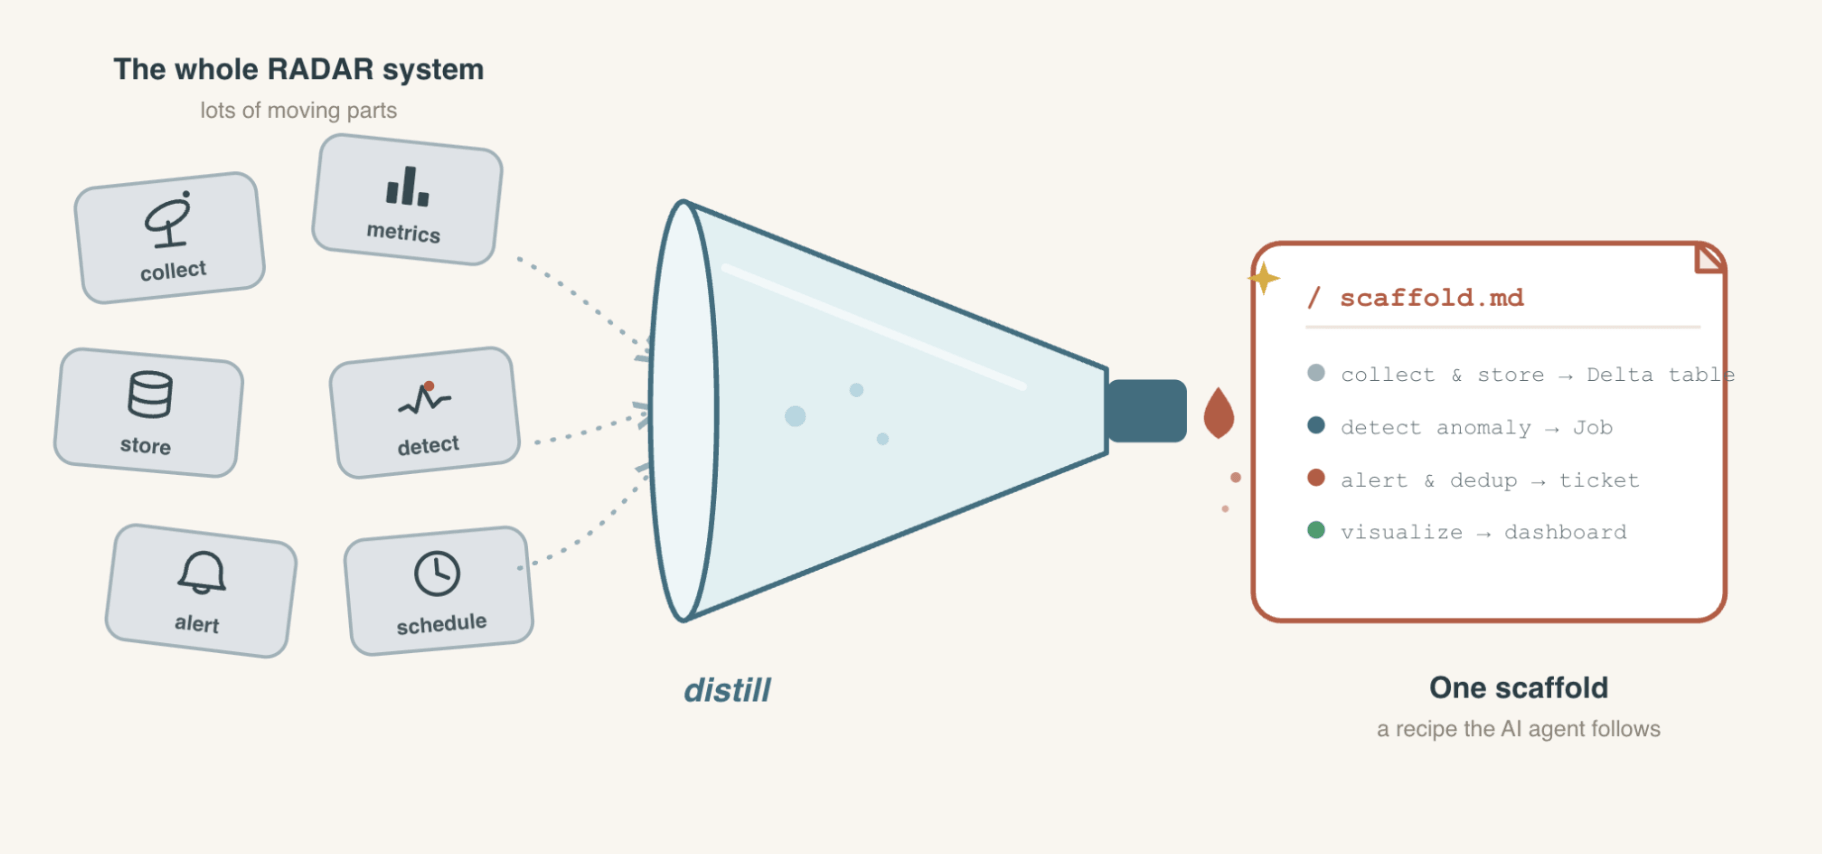
Sau đó là kết quả. Bạn mang chỉ số của riêng mình — bất cứ nơi nào tín hiệu của bạn tồn tại — và đưa chỉ số đó, khung (scaffold) và một lời nhắc (prompt) ngắn cho một tác nhân AI. Nó sẽ xây dựng toàn bộ hệ thống RADAR cho bạn, trực tiếp trên Databricks. Bạn có thể làm theo hướng dẫn trên Github về cách xây dựng một hệ thống từ một lời nhắc duy nhất.
Những điểm chính cần nhớ
Hai điều cần rút ra:
Lấy khung RADAR trên GitHub
Bởi vì kết quả tốt nhất không phải là phản hồi nhanh hơn với những khách hàng đang giận dữ — mà là khách hàng của bạn không bao giờ phải là người phát hiện sự cố thay cho bạn.
Bài viết được AI dịch và tổng hợp tự động từ Databricks: Blog. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.