Sản phẩm
Exa ra mắt Agent Ultra: API cụm tác nhân phụ chuyên sâu cho nghiên cứu dữ liệu quy mô lớn
(giờ Việt Nam)
Tóm tắt AI
Exa giới thiệu Agent Ultra, API mới sử dụng cơ chế cụm tác nhân phụ và điều phối mô hình hỗn hợp để thực hiện các tác vụ nghiên cứu phức tạp, đòi hỏi thu thập dữ liệu từ hàng nghìn nguồn tin.
Chính văn · Bản dịch AI
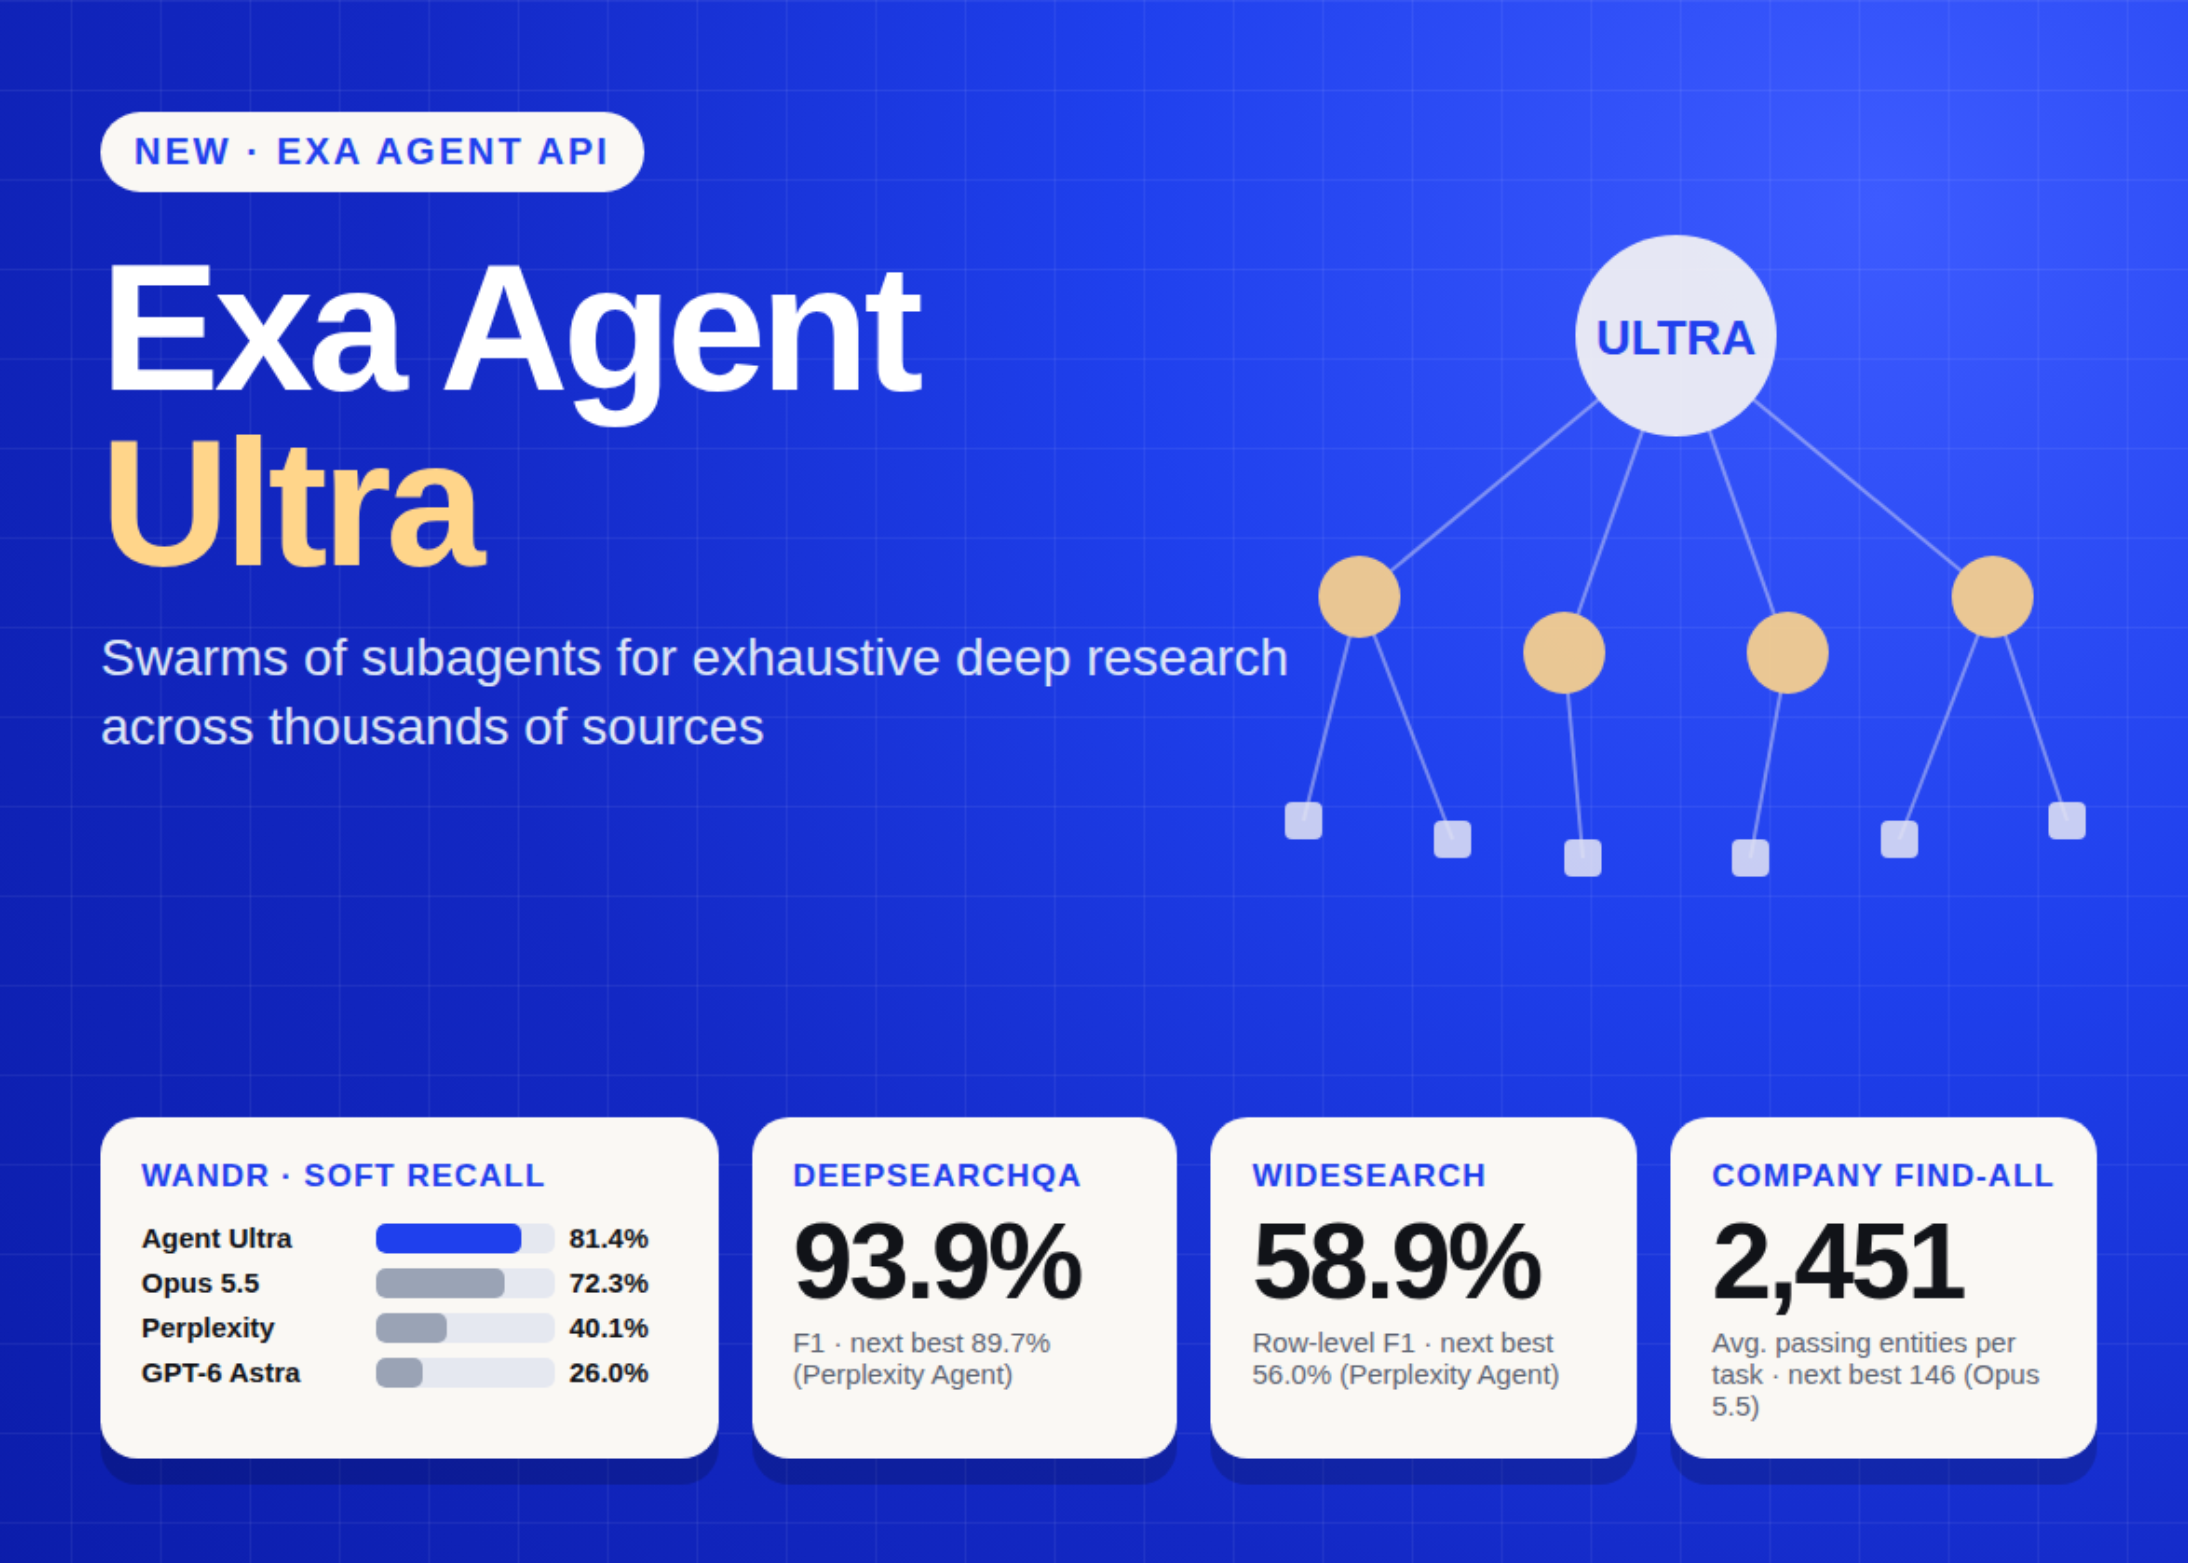
Exa vừa ra mắt Agent Ultra, cấp độ nỗ lực cao nhất cho API Exa Agent của họ. Công cụ này được xây dựng cho các nghiên cứu đòi hỏi sự đào sâu triệt để: xây dựng danh sách quy mô lớn, làm giàu dữ liệu thực thể và giải quyết các câu hỏi cần hàng ngàn nguồn tin. Đội ngũ Exa báo cáo rằng Ultra vượt qua Opus 5.5, GPT-6 Astra và Perplexity Agent (ở mức nỗ lực tối đa của mỗi loại) trên 4 tiêu chuẩn đánh giá nghiên cứu.
Có thể triển khai được không? Có, dưới dạng API được lưu trữ (hosted API). Agent Ultra hiện đã khả dụng trên Exa API bằng cách thiết lập effort: "ultra". Đây không phải là mô hình mã nguồn mở (open weights) và không thể tự lưu trữ (self-hosted).
Exa Agent Ultra là gì?
Exa Agent chia nhỏ một tác vụ thành các tác vụ phụ và chỉ định các tác nhân phụ (subagents) để nghiên cứu nhiều lĩnh vực cùng lúc. Nó điều hướng các mô hình tiên tiến (frontier models) đến các bước cần thiết và sử dụng các mô hình nhanh hơn ở những nơi phù hợp. Ultra là chế độ tiêu tốn nhiều tài nguyên tính toán nhất. Theo tài liệu về Agent Ultra, nó chạy lâu hơn bất kỳ chế độ nỗ lực nào khác để trả về kết quả đầy đủ nhất.
Các lượt chạy Ultra thường hoàn thành các tác vụ phức tạp trong khoảng 30 phút. Những tác vụ rất khó có thể mất tới 3 giờ.
Kết quả đánh giá (Benchmark)
Tất cả các số liệu dưới đây đều từ bài đăng ra mắt của Exa. Các đối thủ cạnh tranh được chạy ở mức nỗ lực tối đa của họ.
| Tiêu chuẩn đánh giá (chỉ số) | Agent Ultra | Opus 5.5 | GPT-6 Astra | Perplexity Agent |
|---|---|---|---|---|
| WANDR (soft recall) | 81.4% | 72.3% | 26.0% | 40.1% |
| DeepSearchQA (F1) | 93.9% | 77.6% | 85.3% | 89.7% |
| WideSearch (F1 cấp hàng) | 58.9% | 51.6% | 54.7% | 56.0% |
| Company Find-All (trung bình thực thể tìm thấy mỗi tác vụ) | 2,451 | 146 | 113 | 98 |
Exa đưa ra tuyên bố về chi phí cho mỗi kết quả:
- WANDR: +12,6% so với Opus 5.5, với chi phí mỗi tác vụ chỉ bằng một nửa.
- DeepSearchQA: +4,7% so với Perplexity, với chi phí mỗi tác vụ thấp hơn 46% so với GPT-6 Astra.
- WideSearch: +5,2% so với Perplexity, với chi phí mỗi tác vụ thấp nhất trong 4 hệ thống.
- Company Find-All: +1579% so với Opus 5.5, với chi phí thấp nhất cho mỗi thực thể tìm thấy.
Những mức tăng này là tương đối, không phải điểm phần trăm. Trên WANDR, khoảng cách tuyệt đối so với Opus 5.5 là 9,1 điểm.
Hiểu về các con số này
WANDR là tiêu chuẩn đánh giá của Perplexity gồm 500 tác vụ thu thập dữ liệu sâu và rộng, với một bộ công cụ mở. Hệ thống chấm điểm của Exa chia sẻ logic đánh giá thượng nguồn. Nó thay thế công cụ nội dung bằng Exa, thay đổi logic truyền tải và sử dụng gpt-6-luna làm giám khảo. Khi một nhà cung cấp đã công bố kết quả trên bộ công cụ này, Exa báo cáo con số đó. Nếu không, Exa tự chạy tiêu chuẩn đánh giá.
DeepSearchQA là tiêu chuẩn đánh giá tìm kiếm đa bước gồm 900 câu lệnh của Google DeepMind. WideSearch kiểm tra khả năng thu thập thông tin trên diện rộng. Exa đã đánh giá tối đa 200 tác vụ cho mỗi tiêu chuẩn WANDR và DeepSearchQA, và 100 tác vụ cho mỗi tiêu chuẩn WideSearch và Company Find-All. Số lượng tác vụ được chấm điểm khác nhau tùy theo nhà cung cấp. Tất cả kết quả đều do nhà cung cấp báo cáo và chưa được kiểm chứng độc lập.
Agent Ultra phù hợp với ai?
Exa liệt kê 3 nhóm người dùng mục tiêu:
- Các nhà cung cấp mô hình: tập hợp dữ liệu huấn luyện, chẳng hạn như mọi bài báo và kho lưu trữ (repo) triển khai một kỹ thuật nhất định. Xác minh các tiêu chí như 'đã phát hành trọng số, không chỉ là API'.
- Dịch vụ tài chính: xây dựng bản đồ thị trường thẩm định, thực hiện nghiên cứu KYC (hiểu khách hàng) qua các hồ sơ và hồ sơ tòa án, và theo dõi các tín hiệu danh mục đầu tư.
- Các đội ngũ Go-to-market: xây dựng danh sách khách hàng tiềm năng và làm giàu các hàng dữ liệu bằng các trường đánh giá, mỗi trường đều có dẫn chứng bằng URL.
Ultra cũng có thể mở rộng danh sách hiện có. Bạn chỉ cần cung cấp các hàng dữ liệu đã có, chúng sẽ được loại trừ khỏi các kết quả mới.
API, Giá cả và Kiểm soát
Ultra sử dụng endpoint chạy Agent tiêu chuẩn. Yêu cầu hỗ trợ outputSchema, input.data và streaming.
from exa_py import Exa

exa = Exa()
run = exa.agent.runs.create(
    query="Find all companies building browser automation tools in the United States.",
    effort="ultra",
)
run = exa.agent.runs.poll_until_finished(run.id, timeout_ms=3 * 60 * 60 * 1000)
print(run.stop_reason)- Giá cả: tính phí theo mức sử dụng Agent tiêu chuẩn, tối đa 20 USD cho mỗi lượt chạy mặc định. Các lượt chạy kết thúc sớm sẽ tốn ít chi phí hơn.
- Ngân sách: maxCostDollars chấp nhận từ 1 đến 100 USD. maxDurationSeconds chấp nhận từ 300 đến 10.800 giây.
- Dừng chạy: lệnh stop kết thúc lượt chạy sớm, giữ lại kết quả và tính phí sử dụng đến thời điểm đó.
- Thời gian chờ (Timeouts): các trình hỗ trợ polling của SDK mặc định sẽ hết thời gian chờ sau 1 giờ, vì vậy hãy thiết lập thời gian chờ dài hơn hoặc sử dụng streaming sự kiện.
- Tương thích với OpenAI: trên /responses, thiết lập reasoning.effort: "ultra" với chế độ streaming hoặc background.
Bạn có thể kiểm tra nó trong Exa API Playground.
Những điểm chính cần lưu ý
- Agent Ultra là chế độ nỗ lực cao nhất của Exa Agent, hiện đã khả dụng qua API.
- Nó điều phối các tác nhân phụ song song và kết hợp giữa các mô hình tiên tiến và mô hình nhanh hơn.
- Exa báo cáo điểm số cao nhất trên WANDR, DeepSearchQA, WideSearch và Company Find-All.
- Các lượt chạy tốn tối đa 20 USD theo mặc định, có thể điều chỉnh từ 1 đến 100 USD.
- Các lượt chạy thông thường mất khoảng 30 phút, với giới hạn tối đa là 3 giờ.
Xem Chi tiết kỹ thuật. Mọi công lao thuộc về nhà nghiên cứu của dự án này. Ngoài ra, hãy theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit 150k+ ML và đăng ký Bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Bạn cần hợp tác với chúng tôi để quảng bá GitHub Repo, trang Hugging Face, sản phẩm mới hoặc hội thảo trực tuyến của bạn? Kết nối với chúng tôi

Michal Sutter
Michal Sutter là một chuyên gia khoa học dữ liệu với bằng Thạc sĩ Khoa học Dữ liệu từ Đại học Padova. Với nền tảng vững chắc về phân tích thống kê, học máy và kỹ thuật dữ liệu, Michal xuất sắc trong việc chuyển đổi các tập dữ liệu phức tạp thành những thông tin chi tiết có thể hành động được.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.