Sản phẩm
Meta mã nguồn mở Rebalancer: Thư viện tối ưu hóa phân bổ tài nguyên hiệu suất cao
(giờ Việt Nam)
Tóm tắt AI
Meta vừa công bố mã nguồn mở Rebalancer, thư viện chuyên dụng giải quyết các bài toán phân bổ tài nguyên phức tạp đã được ứng dụng nội bộ hơn 9 năm với quy mô 40 triệu tác vụ mỗi ngày.
Bản dịch AI
Với một tập hợp các đối tượng và một tập hợp các thùng chứa, làm thế nào để chúng ta phân bổ các đối tượng vào các thùng chứa theo cách tối ưu hóa các mục tiêu cụ thể trong khi vẫn đáp ứng được các ràng buộc nhất định?
Câu hỏi này nảy sinh ở tất cả các lớp trong hệ thống hạ tầng của Meta, bao gồm cả
Những thách thức chính trong việc thiết kế một khung làm việc có thể tái sử dụng để giải quyết các vấn đề như thế này nằm ở khả năng sử dụng và khả năng mở rộng. Khả năng sử dụng bị cản trở bởi việc các chuyên gia gặp khó khăn trong việc chuyển đổi các chính sách thực tế thành các công thức toán học chính xác theo yêu cầu của các phương pháp tối ưu hóa hình thức, trong khi khả năng mở rộng lại bị hạn chế bởi các bài toán NP-hard không thể giải quyết hiệu quả bằng các trình giải thương mại.
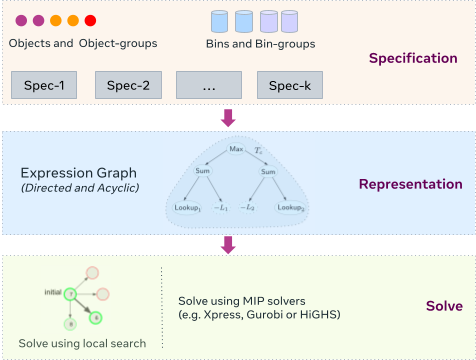
Rebalancer giải quyết cả hai thách thức này bằng cách tách biệt đặc tả của bài toán khỏi giải pháp của nó. Rebalancer cung cấp một ngôn ngữ để mô tả các bài toán sử dụng đối tượng, thùng chứa, ràng buộc và mục tiêu, như trong các ví dụ trên. Sau khi bài toán được mô tả theo cách này, Rebalancer chuyển đổi nó thành một đồ thị có hướng không chu trình (directed-acyclic graph) gọi là đồ thị biểu thức (expression graph). Thuật toán giải của Rebalancer sử dụng đồ thị biểu thức này để thiết kế một phương pháp tìm kiếm heuristic cục bộ hoặc xây dựng một mô hình lập trình số nguyên hỗn hợp (MIP) có thể giải được bằng trình giải thương mại (FICO Xpress hoặc Gurobi) hoặc trình giải mã nguồn mở (HiGHS).
Đặc tả các bài toán phân bổ
Ngôn ngữ đặc tả của Rebalancer sử dụng phương pháp ba bước để tăng dần mức độ trừu tượng nhằm tạo sự dễ dàng khi sử dụng.
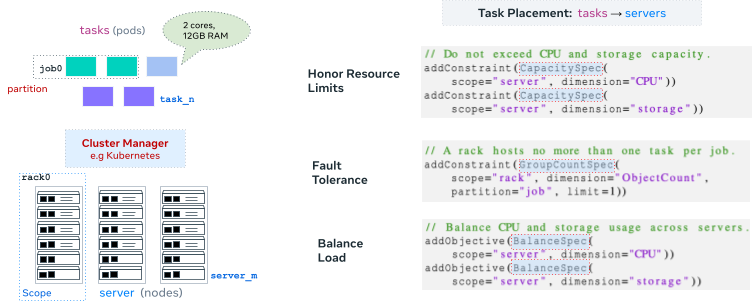
Trong ví dụ trên, các tác vụ được mô hình hóa thành các đối tượng và máy chủ được mô hình hóa thành các thùng chứa để đặt các tác vụ vào đó. Các máy chủ được đặt vật lý trong các tủ rack; sự nhóm này được mô hình hóa dưới dạng một phạm vi (scope). Các tác vụ tiêu tốn một lượng CPU và lưu trữ nhất định, và các máy chủ có giới hạn cho mỗi loại tài nguyên này. CPU và lưu trữ được mô hình hóa thành các chiều (dimensions). Mức sử dụng CPU và lưu trữ của một máy chủ tương ứng với tổng của tất cả các tác vụ được gán cho máy chủ đó, và các giới hạn sử dụng của máy chủ được mô hình hóa bằng CapacitySpec. API biểu thức có thể được sử dụng để thay đổi cách tính toán mức sử dụng nếu phép tính tổng đơn giản không phù hợp.
Hơn nữa, chúng tôi mô hình hóa các tác vụ thuộc về các công việc (jobs). Một nhóm các đối tượng như thế này được gọi là một phân vùng (partition) và chúng tôi sử dụng GroupCountSpec để đảm bảo rằng mỗi tủ rack chỉ có một loại công việc (phân vùng) được gán cho nó. BalanceSpec đảm bảo rằng mức sử dụng của mỗi máy chủ được cân bằng trên cả hai chiều CPU và lưu trữ.
Ví dụ này minh họa cách các bài toán phân bổ phức tạp có thể được xây dựng một cách dễ dàng và tự nhiên bằng cách sử dụng Rebalancer, và cách các đặc tả (specs) cung cấp phương thức để thể hiện các ràng buộc và mục tiêu có thể được tái sử dụng theo nhiều cách khác nhau bằng cách thay đổi các chiều, phạm vi hoặc phân vùng.
Vui lòng xem danh sách đầy đủ các đặc tả của Rebalancer trong tài liệu hướng dẫn.
Sau khi một bài toán được đặc tả bằng API mô tả ở trên, Rebalancer sẽ dịch nó thành một đồ thị biểu thức. Các nút lá trong đồ thị này đại diện cho các biểu thức sử dụng; ví dụ: mức sử dụng bộ nhớ của máy chủ A, thu được bằng cách tính tổng đóng góp bộ nhớ của các tác vụ được gán cho máy chủ A. Các giá trị sử dụng này sau đó được kết hợp đệ quy bằng cách sử dụng các nút tổng hợp như Max và Sum, hoặc các nút biến đổi như Square và Abs. Lưu ý rằng giá trị của mỗi nút trong đồ thị biểu thức phụ thuộc vào phân bổ hiện tại và cần được cập nhật mỗi khi phân bổ thay đổi.
Cùng với các mục tiêu và ràng buộc của bài toán, người lập mô hình cũng cung cấp cho Rebalancer một phân bổ ban đầu và một điều kiện dừng, chẳng hạn như giới hạn thời gian. Rebalancer sẽ tính toán một phân bổ tối ưu giúp giảm thiểu giá trị mục tiêu và không vi phạm bất kỳ ràng buộc mới nào. Các ràng buộc bị vi phạm bởi phân bổ ban đầu sẽ trở thành các mục tiêu ưu tiên cao và mức độ vi phạm của chúng sẽ được giảm thiểu, lý tưởng nhất là về bằng không.
Rebalancer cung cấp hai kỹ thuật riêng biệt để giải quyết bài toán phân bổ.
Trình giải tối ưu (Optimal Solver). Ở chế độ này, Rebalancer dịch đồ thị biểu thức thành một tập hợp các biểu thức có thể đưa vào các trình giải MIP như FICO Xpress, Gurobi hoặc HiGHS. Trong quá trình dịch này, Rebalancer cần biểu diễn mức sử dụng của một thùng chứa bằng tổng có trọng số của các biến quyết định nhị phân (mỗi đối tượng một biến) để chỉ ra liệu đối tượng đó có được gán cho thùng chứa hay không; điều này có thể dẫn đến các mô hình MIP rất lớn! Rebalancer tự động sử dụng các kỹ thuật như tổng hợp biến (gộp các đối tượng tương tự thành một biến số nguyên duy nhất), tính hoán đổi và phá vỡ tính đối xứng để giảm kích thước mô hình, nhưng kích thước trường hợp xấu nhất của mô hình MIP được tạo ra vẫn có thể là bậc hai, tức là O(|đối tượng| * |thùng chứa|). Các bài toán lớn nhất mà chúng tôi xem xét đều quá lớn đối với bất kỳ trình giải MIP nào.
Trình giải tìm kiếm cục bộ (Local Search Solver) khắc phục hạn chế này bằng cách làm việc trực tiếp trên đồ thị biểu thức, khám phá vùng lân cận xung quanh phân bổ hiện tại bằng cách di chuyển một số đối tượng sang thùng chứa khác. Vùng lân cận này có kích thước trường hợp xấu nhất là O(|đối tượng| + |thùng chứa|), cho phép Rebalancer mô hình hóa ngay cả những bài toán rất lớn mà không gặp phải giới hạn bộ nhớ. Mỗi bước di chuyển tạo ra một phân bổ ứng viên mới, trong đó Rebalancer đánh giá các giá trị mới của mục tiêu và ràng buộc. Sau khi tất cả các ứng viên được đánh giá, Rebalancer áp dụng phân bổ ứng viên tốt nhất; đó là phân bổ không vi phạm ràng buộc và cải thiện mục tiêu nhiều nhất. Quá trình đánh giá và áp dụng các bước di chuyển này được lặp lại cho đến khi không thể đạt được tiến bộ hoặc đạt đến điều kiện dừng. Thuật toán tìm kiếm cục bộ của Rebalancer được tối ưu hóa và song song hóa mạnh mẽ để mỗi lần đánh giá tương đối rẻ (có thể đạt hàng triệu lần đánh giá mỗi giây), cho phép chúng tôi nhanh chóng khám phá không gian tìm kiếm. Ngoài ra, Rebalancer biết cách cắt tỉa không gian tìm kiếm, giúp giảm số lượng đánh giá cần thiết ngay từ đầu.
Kỹ thuật giải pháp phù hợp sẽ phụ thuộc vào nhu cầu của bạn. Tại Meta, hầu hết các bài toán quy mô lớn đều sử dụng tìm kiếm cục bộ. Các bài toán quy mô nhỏ đến trung bình có yêu cầu thời gian giải vừa phải thường sử dụng trình giải tối ưu. Việc tạo mẫu bằng trình giải tối ưu và sau đó chuyển sang tìm kiếm cục bộ sau khi đã xác định được giải pháp cơ sở chất lượng cao cũng là điều phổ biến. Ở chế độ ngoại tuyến, trình giải tối ưu có thể được sử dụng để tinh chỉnh tìm kiếm cục bộ.
Rebalancer tại Meta
Trong thập kỷ qua, Rebalancer đã được sử dụng và cải tiến liên tục tại Meta. Nó được sử dụng để giải quyết hàng loạt các bài toán tối ưu hóa hạ tầng, bao gồm gán shard cho máy chủ (Shard Manager), máy chủ cho dịch vụ (RAS), định tuyến lưu lượng từ các trung tâm dữ liệu biên phân tán toàn cầu đến các trung tâm dữ liệu chính (Taiji), nhóm các hàm serverless để cải thiện tính cục bộ, cân bằng khối lượng công việc đào tạo ML trực tuyến giữa các khu vực trong khi vẫn xem xét mức độ ưu tiên của khối lượng công việc ML, v.v. Tại thời điểm viết bài này, Rebalancer được sử dụng để giải quyết khoảng 40 triệu bài toán phân bổ mỗi ngày với hơn 30 công thức bài toán độc đáo. Thời gian giải P99 là 12 giây cho một bài toán với 265 nghìn đối tượng và 3,2 nghìn thùng chứa. Đối với các bài toán có hơn 1 triệu đối tượng và 5 nghìn thùng chứa, thời gian giải trung bình là 171 giây và có hơn 3,4 nghìn lượt chạy như vậy.
Không có gì ngạc nhiên khi Rebalancer cũng được sử dụng để giải quyết các bài toán phi hạ tầng như gán cuộc họp vào phòng họp để giảm thiểu thời gian di chuyển, gán phiếu hỗ trợ cho kỹ sư và tối ưu hóa vị trí bàn làm việc. Ngoài Meta, các bài toán phân bổ nảy sinh trong nhiều lĩnh vực như chăm sóc sức khỏe, năng lượng và tiện ích, vận tải và logistics, giáo dục và ứng phó khẩn cấp, và mặc dù chúng tôi không có chuyên môn để tự mình áp dụng Rebalancer vào các lĩnh vực này, chúng tôi hy vọng những người khác sẽ làm được.
Gỡ lỗi
Với việc Rebalancer giúp dễ dàng xây dựng và giải quyết các bài toán, chúng tôi nhận thấy phần lớn thời gian kỹ thuật của các nhà lập mô hình đã chuyển sang việc gỡ lỗi hành vi của trình giải. Nếu không có các công cụ phù hợp, việc gỡ lỗi như vậy đòi hỏi sự hiểu biết sâu sắc về nội bộ của trình giải. Theo thời gian, chúng tôi đã xác định được các câu hỏi và điểm khó khăn chung của các nhà lập mô hình và xây dựng một công cụ giao diện người dùng chuyên dụng để giải đáp chúng: Rebalancer Explorer.
https://facebook.github.io/rebalancer/videos/rebalancer-explorer-demo.mp4
Explorer đi kèm với Rebalancer trong bản phát hành mã nguồn mở này dưới dạng giao diện web Dockerized, giúp tạo điều kiện gỡ lỗi và lặp lại nhanh chóng khi giải quyết các bài toán bằng cả trình giải tìm kiếm cục bộ và trình giải tối ưu. Nó giúp trả lời các câu hỏi như ràng buộc nào đang bị ràng buộc, điều gì sẽ xảy ra nếu một ràng buộc được nới lỏng, và tại sao một đối tượng lại được đặt vào thùng chứa này mà không phải thùng chứa khác.
Tương lai của Rebalancer
Chúng tôi luôn tìm cách tối ưu hóa hiệu suất của Rebalancer, bổ sung các khả năng mới và mở rộng nó để hỗ trợ nhiều loại bài toán phân bổ hơn. Rebalancer tự hào là mã nguồn mở (giấy phép Apache 2.0) và chúng tôi mời cả các chuyên gia về hệ thống và tối ưu hóa dùng thử Rebalancer và đóng góp cho dự án bằng cách xác định các điểm nghẽn hiệu suất, thêm các kỹ thuật giải mới, mở rộng nó để hỗ trợ các loại bài toán mới hoặc chỉ đơn giản là sửa lỗi. Chúng tôi mong chờ được thấy cách các cộng đồng hệ thống và tối ưu hóa áp dụng, xây dựng và đóng góp cho Rebalancer.
Lời cảm ơn
Rebalancer được phát triển bởi các thành viên cũ và hiện tại của nhóm Tối ưu hóa Thuật toán tại Meta: Pol Mauri Ruiz, Igor Kabiljo, Neeraj Kumar, Vijay Menon, Mayank Pundir, Andrew Newell, Liyuan Wang, Richard Barnes, Sahil Deshpande, Karthik Velakur, Yang Liu, Leart Gjoni, Ravi Surulikamu, Tony Zhang, Raj Rajendran, Aravind Narayanan, Lakshmi Ganesh và Saranyan Vigraham.
Bài viết được AI dịch và tổng hợp tự động từ Meta Engineering Blog. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.