Tin ngành
Reward AI ra mắt OM-1: Mô hình điều khiển robot đột phá từ dữ liệu mô phỏng con người
(giờ Việt Nam)
Tóm tắt AI
Startup Reward AI giới thiệu OM-1, mô hình điều khiển robot đa năng được huấn luyện hoàn toàn từ dữ liệu mô phỏng cử động con người mà không cần đến điều khiển từ xa hay dữ liệu thực tế, đạt độ chính xác vượt trội so với các phương pháp thị giác truyền thống.
Bản dịch AI
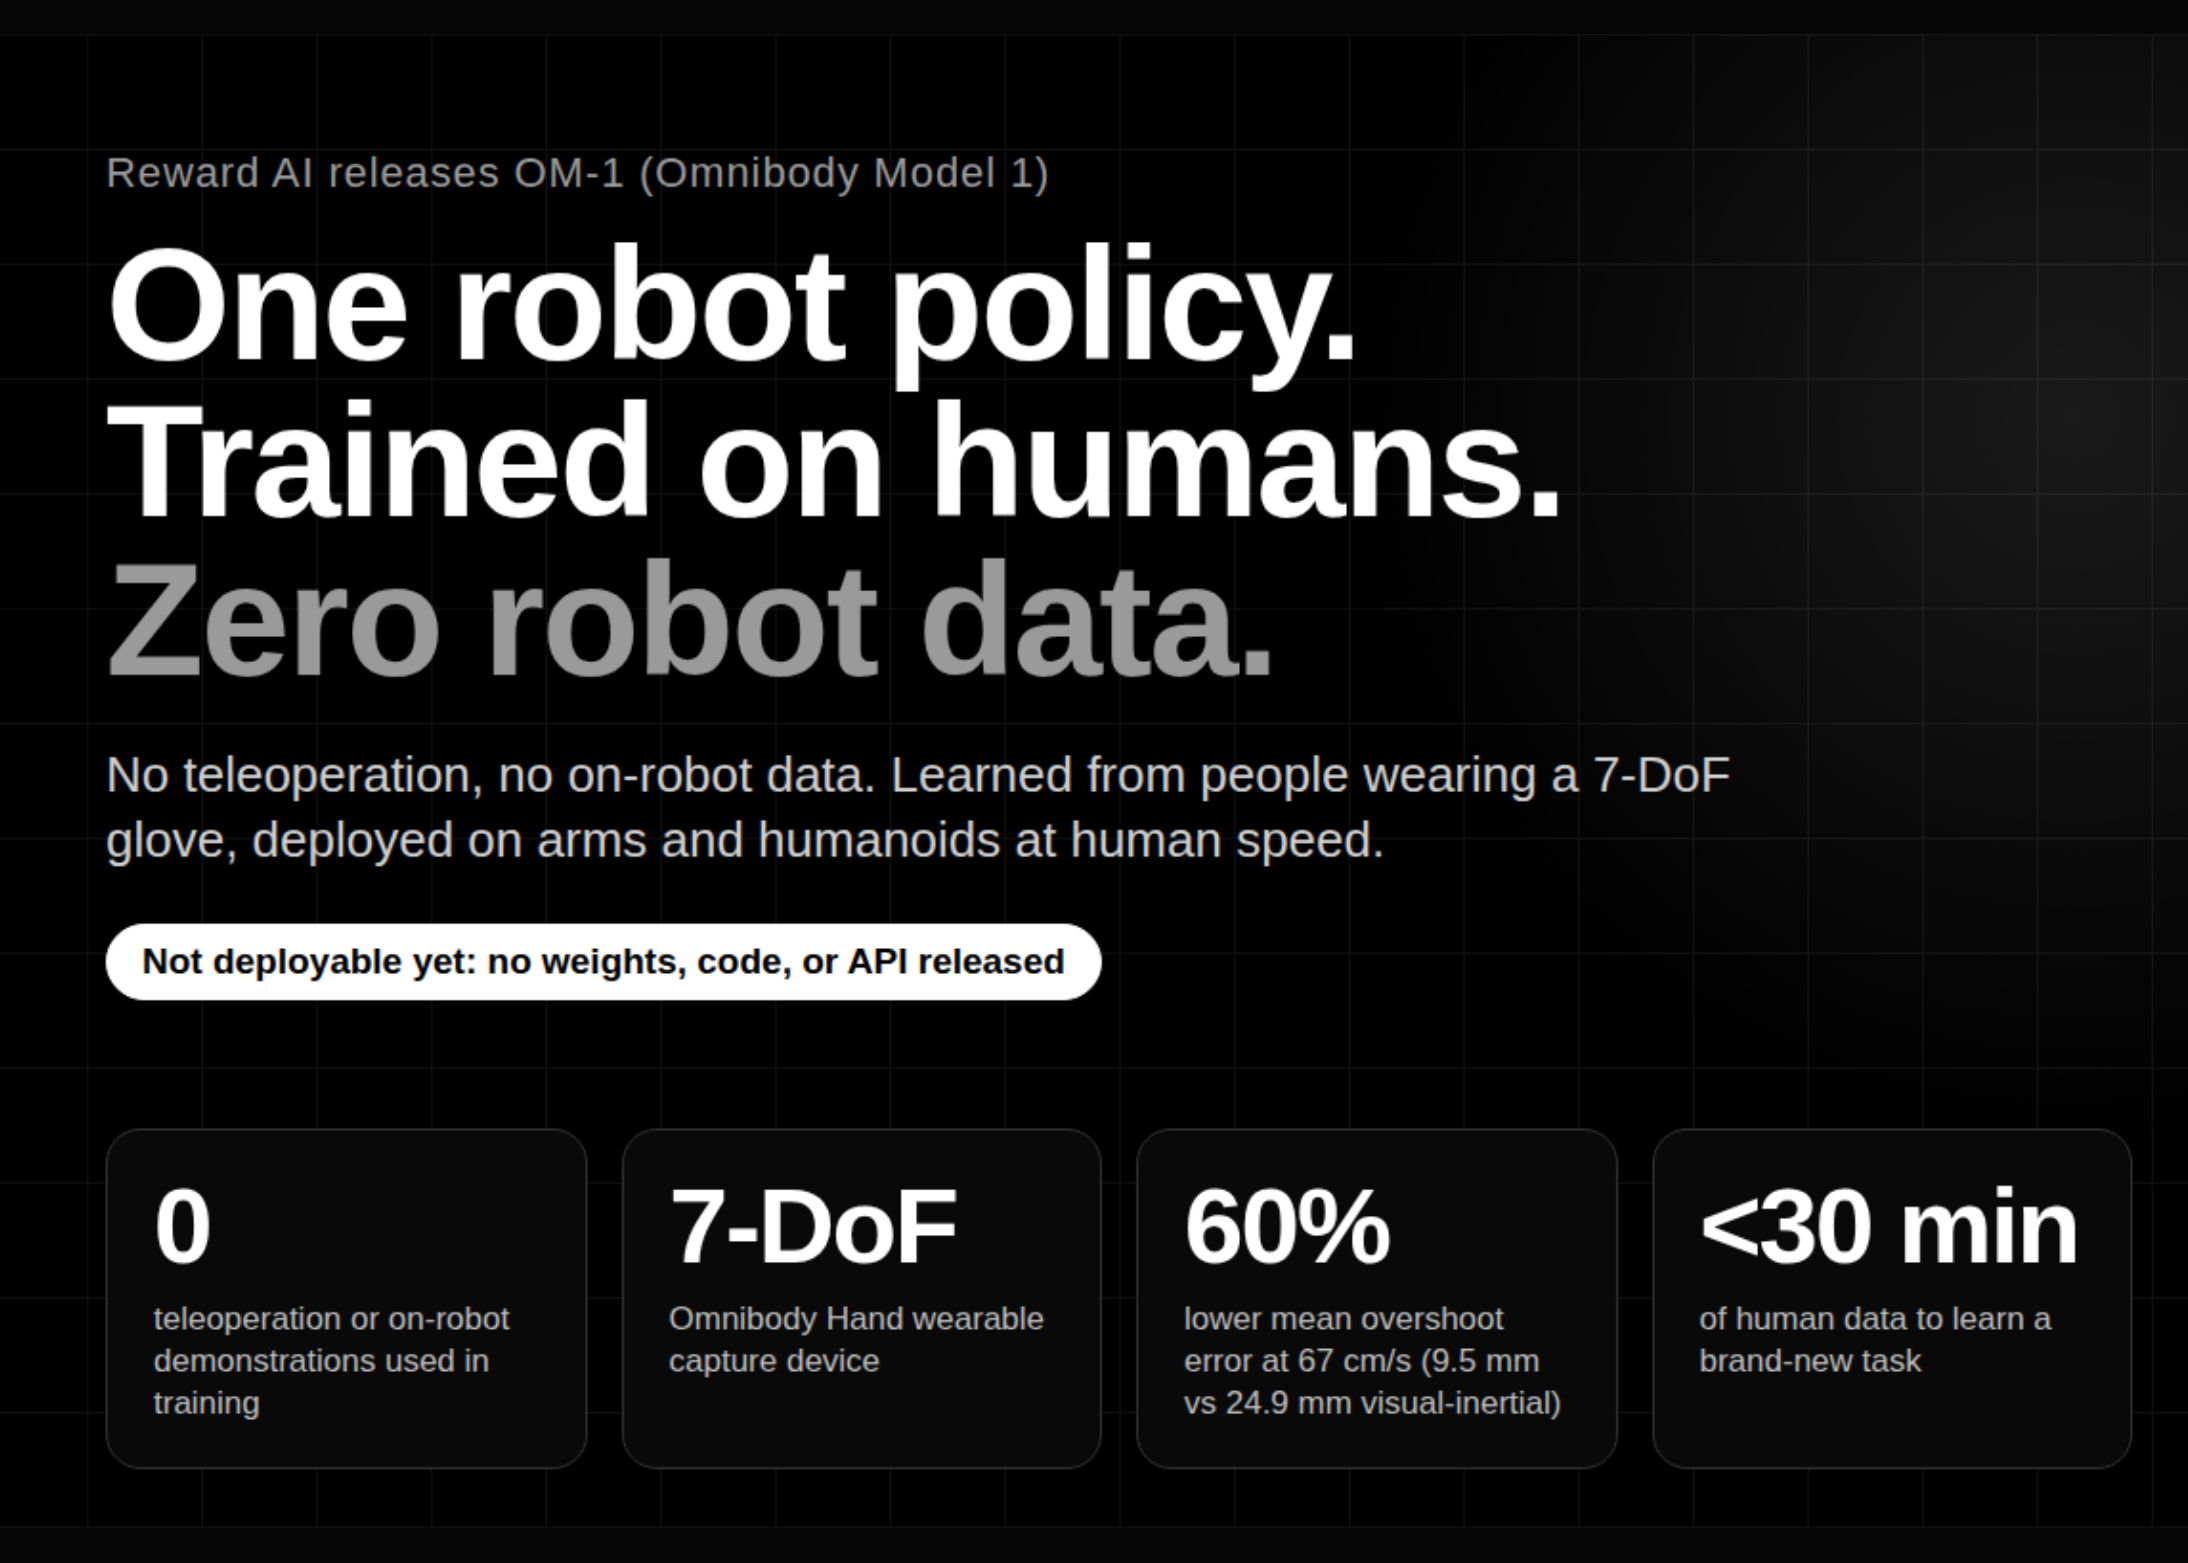
Reward AI, một startup về robot với đội ngũ từng thực hiện các dự án DexCap, HumanPlus và ALOHA, vừa ra mắt OM-1, viết tắt của Omnibody Model 1. OM-1 là một chính sách điều khiển thao tác đa năng, học từ con người thông qua một chiếc găng tay cảm biến, sau đó vận hành trên các cánh tay công nghiệp và robot hình người với tốc độ tương đương con người. Điểm đột phá đáng chú ý nhất: không cần dữ liệu điều khiển từ xa (teleoperation) và không cần dữ liệu trực tiếp từ robot trong quá trình huấn luyện. Hệ thống tuân thủ nguyên tắc: "Một mô hình, một giao diện dữ liệu, bất kỳ cơ thể nào".
Liệu nó có thể triển khai được không? Không, OM-1 hiện là chính sách nội bộ của Reward AI. Chưa có trọng số, mã nguồn, tập dữ liệu hay API nào được công bố, vì vậy các nhà phát triển chưa thể chạy nó trên phần cứng của riêng mình.
Tại sao lại bỏ qua dữ liệu robot?
Hầu hết các chính sách nền tảng cho robot đều được huấn luyện trên dữ liệu điều khiển từ xa hoặc dữ liệu do chính robot thu thập, điều này khiến tập dữ liệu bị ràng buộc với một hình thái cụ thể. Reward AI lập luận rằng khả năng thao tác ở cấp độ con người sẽ không đến từ việc tăng thêm dữ liệu hay sức mạnh tính toán, dẫn lời Anderson trong bài "More Is Different". Thay vào đó, việc thu thập, học tập và điều khiển được thiết kế như một quy trình thống nhất, nhờ đó các bản trình diễn được ghi lại hôm nay có thể huấn luyện cho cả những cơ thể robot chưa tồn tại.
Omnibody Hand: Thiết bị đeo 7-DoF
Hệ thống bắt đầu với Omnibody Hand, một thiết bị đeo mở rộng từ dự án DexCap trước đây của nhóm về bắt chuyển động di động. Thay vì sao chép bàn tay con người theo từng khớp, thiết kế này có 7 bậc tự do (7-DoF) tập trung vào các chức năng quan trọng: chọn điểm tiếp xúc, định hướng lại vật thể trong tay và chuyển đổi giữa các kiểu cầm nắm chính xác và cầm nắm lực. Nó ghi lại các thao tác chụm ngón cái-ngón trỏ, sự gập của ngón cái và ngón trỏ, cùng chuyển động kết hợp của ngón giữa, ngón áp út và ngón út tại các khớp MCP.
Công thái học được coi là vấn đề về chất lượng dữ liệu: một thiết bị bị trượt hoặc gây cản trở người đeo sẽ tạo ra các thao tác cầm nắm bù trừ. Cơ chế gập ở phần xa giúp hấp thụ sự khác biệt về chiều dài ngón tay, do đó không cần điều chỉnh cho từng người dùng.
"Một giao diện dữ liệu" chuyển đổi chuyển động của người đeo thành dữ liệu huấn luyện mà không cần thiết lập phức tạp hay người giám sát. Mục tiêu thiết kế là phân loại trên băng chuyền, nơi một người có thể phát hiện, nắm và ném vật thể trong tích tắc. Để bao quát toàn bộ tương tác, găng tay kết hợp cảm biến xúc giác tần số cao, cảm biến tiệm cận cho giai đoạn tiếp cận trước khi chạm, và các camera gắn trên tay với màn trập toàn cục (global-shutter) giúp duy trì ngữ cảnh ngay cả khi chuyển động nhanh.
Theo dõi tư thế tay là nơi Reward AI công bố kết quả định lượng đầu tiên. Theo dõi thị giác-quán tính (visual-inertial) là phương pháp mặc định phổ biến, nhưng độ chính xác khi đảo chiều nhanh bị giới hạn bởi tốc độ cập nhật hình ảnh. Reward AI đã tăng cường bằng cảm biến điện từ kết hợp bù nhiễu. Khi di chuyển cả hai bộ theo dõi giữa hai điểm dừng cơ học ở tám tốc độ từ 3 đến 67 cm/s, trung bình qua mười lần chạy, sai số vượt mức trung bình của theo dõi điện từ tăng từ khoảng 0,4 mm lên 9,5 mm, trong khi theo dõi thị giác-quán tính tăng từ khoảng 2,1 mm lên 24,9 mm: giảm 60% sai số ở tốc độ cao nhất, với độ ổn định giữa các lần chạy tốt hơn. Lực cũng được ghi lại dọc theo cùng quỹ đạo, vì vậy các bản trình diễn mang theo cả thông tin về lực lẫn đường đi.
OM-1: Một chính sách, huấn luyện một giai đoạn
OM-1 học cách tạo ra các hành động của robot trực tiếp từ chuyển động của con người thay vì thông qua một robot trung gian. Vì mọi bản trình diễn đều ở cùng một định dạng, không có sự phân tách giữa tiền huấn luyện và hậu huấn luyện: bản trình diễn đầu tiên được ghi lại và bản mới nhất đều cùng huấn luyện một chính sách duy nhất trong một giai đoạn duy nhất.
Đầu vào là các luồng dữ liệu đa phương thức của găng tay: hình ảnh, tín hiệu xúc giác, khoảng cách giữa các ngón tay và quỹ đạo tư thế tay. Mỗi phương thức được xử lý ở tốc độ lấy mẫu gốc của cảm biến thay vì giảm tần số xuống mức chung, nhờ đó các tín hiệu xúc giác và chuyển động tần số cao được giữ nguyên bên cạnh thị giác tần số thấp hơn. Đầu ra bao gồm hướng chuyển động, tốc độ, lực và thời điểm của các sự kiện như bắt đầu cầm nắm. Reward AI cho biết họ đã xây dựng một kiến trúc mới để suy luận hiệu quả, mặc dù chi tiết kiến trúc và số lượng tham số không được tiết lộ.
Điều khiển mọi cơ thể: Một lớp RL với nhịp độ riêng
Bên dưới chính sách là một lớp điều khiển tần số cao được huấn luyện bằng học tăng cường (reinforcement learning) trong môi trường mô phỏng để xử lý các động lực học phụ thuộc vào vận tốc và gia tốc, nhiễu bên ngoài và độ trễ hệ thống. Trong khi bộ điều khiển cổ điển sẽ không bao giờ phục hồi nếu bị lệch khỏi tham chiếu do tải trọng bất ngờ, lớp này giữ vững tham chiếu và tự điều chỉnh lại, điều này cho phép robot mở cửa tủ lạnh đã đóng chặt hoặc nâng các hộp có trọng lượng không xác định.
Lớp điều khiển chạy trên nhịp độ riêng, tiếp tục hoạt động trong khi chính sách tính toán các hành động tiếp theo, do đó độ trễ suy luận không bao giờ làm gián đoạn chuyển động. Vì các dự đoán kế tiếp có thể không khớp mượt mà, nó tối ưu hóa quá trình chuyển đổi giữa chúng theo thời gian thực. Không gian hành động này áp dụng cho cả thao tác và điều hướng cho robot di động.
Kết quả
Reward AI báo cáo rằng OM-1 có thể học một nhiệm vụ hoàn toàn mới, bao gồm cả các động lực học phức tạp và tầm nhìn xa, chỉ từ chưa đầy 30 phút dữ liệu con người, và cho rằng điều này là nhờ vào hệ thống tích hợp thay vì chỉ riêng chính sách. Trang giới thiệu của họ tuyên bố rằng tất cả các đoạn clip được công bố đều chạy ở tốc độ 1x và mô hình này bao quát cả cánh tay robot, robot hình người có chân và robot di động có bánh xe. Chưa có tỷ lệ thành công, so sánh với các tiêu chuẩn công khai hay bài báo khoa học nào được phát hành, vì vậy các tuyên bố này dựa trên bản trình diễn thay vì các tiêu chuẩn đo lường (benchmark).
Những điểm chính cần lưu ý
Xem chi tiết kỹ thuật tại đây. Mọi công lao thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy theo dõi chúng tôi trên Twitter, đừng quên tham gia SubReddit ML 150k+ thành viên và đăng ký nhận bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? Bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Bạn cần hợp tác với chúng tôi để quảng bá GitHub Repo, trang Hugging Face, sản phẩm mới hay hội thảo trực tuyến? Hãy kết nối với chúng tôi.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.