Tin ngành
Jev: Liệu có trở thành chuẩn mực mới trong đánh giá AI Agent?
(giờ Việt Nam)
Tóm tắt AI
LangChain thử nghiệm Jev so với các giám khảo LLM truyền thống trên 4 tiêu chí: độ chính xác, tính lặp lại, độ trễ và chi phí, nhằm tìm ra hướng đi mới cho việc đánh giá hiệu năng của các tác nhân AI.
Bản dịch AI
Hiện nay, các phương pháp đánh giá tác nhân (agent evals) thường chia làm hai loại: dựa trên mã nguồn (code-based) và sử dụng LLM làm giám khảo (LLM-as-judge). Cả hai đều có những hạn chế riêng: các bộ đánh giá dựa trên mã nguồn chỉ có thể áp dụng cho một tập hợp hẹp các vấn đề với đầu vào cố định, trong khi các LLM giám khảo lại có thể chậm, đắt đỏ và thiếu tin cậy. Với sự ra mắt phổ biến của Jev từ TypeSafe AI, chúng tôi muốn tìm hiểu xem liệu mô hình “System One” có thể là một hình thức đánh giá tác nhân thứ ba hay không, và tác động của nó đối với kỹ thuật tác nhân (agent engineering) là gì.
Jev là gì?
Jev là một mô hình mới được TypeSafe AI phát hành. Thực tế, Jev không phải là một LLM truyền thống; nó không tạo ra văn bản. Nó là thứ mà đội ngũ TypeSafe AI gọi là mô hình “System One”:
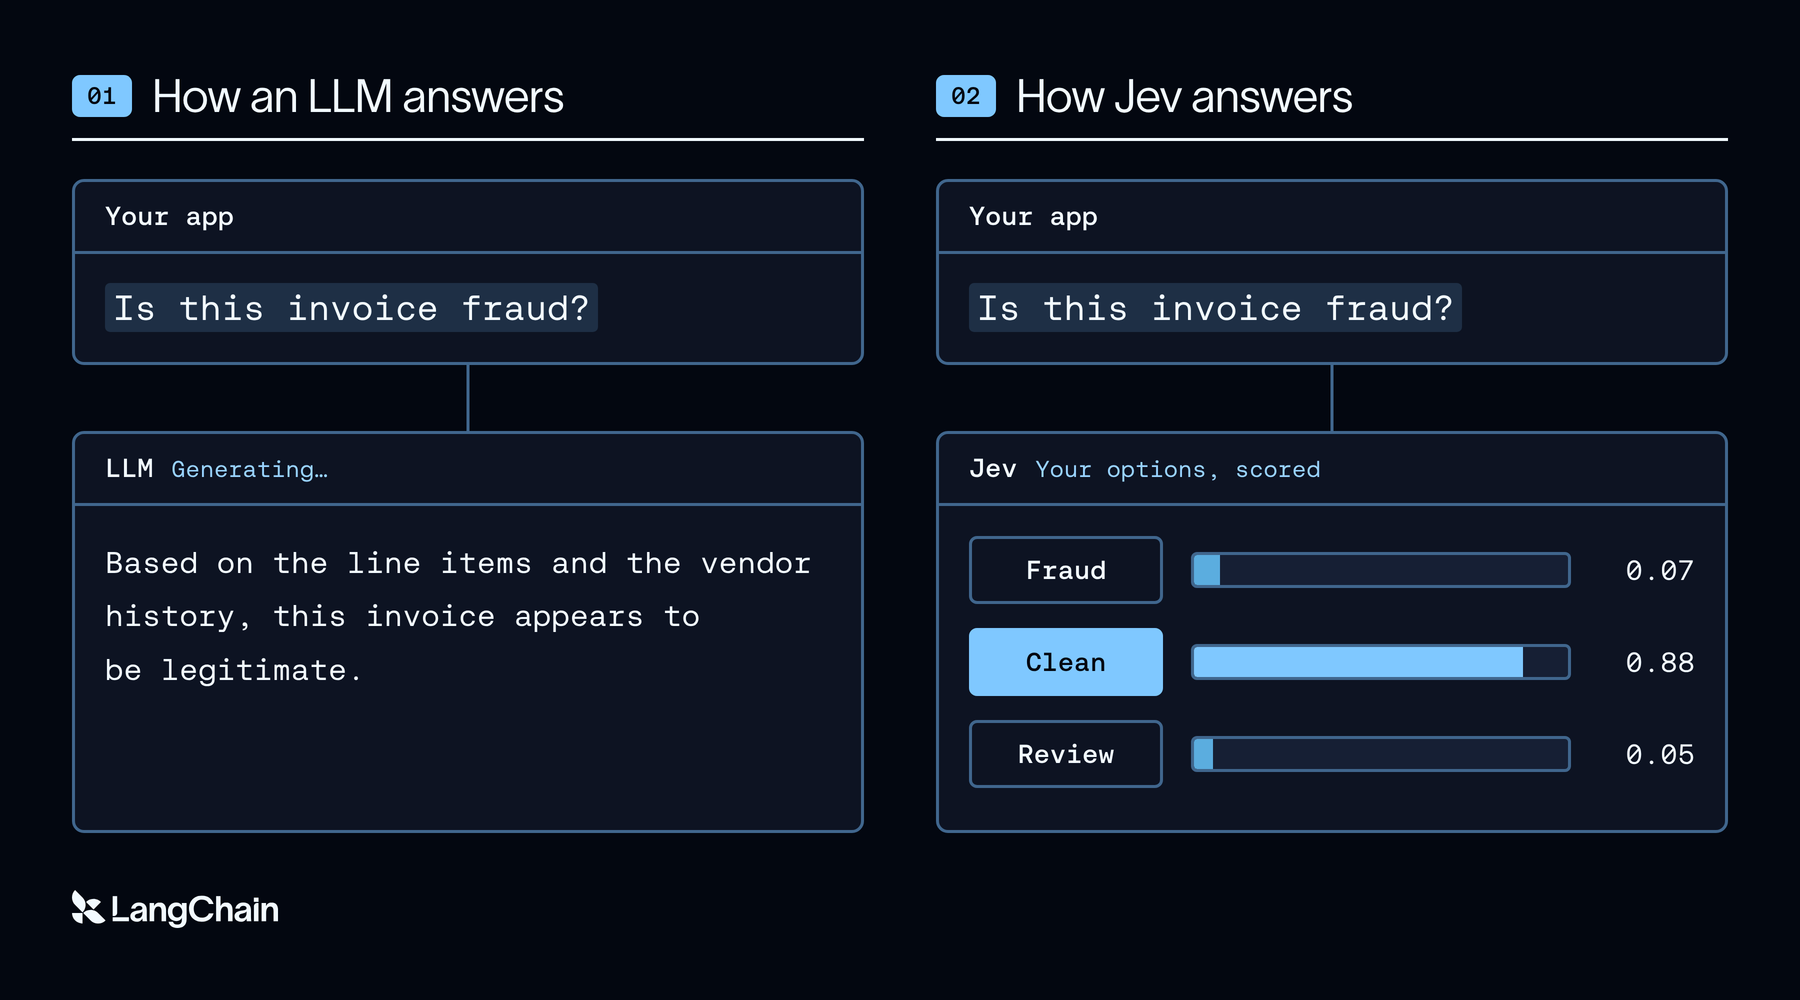
Theo TypeSafe AI, điều này giúp Jev nhanh hơn và rẻ hơn so với các LLM, với tốc độ suy luận nhanh hơn tới 200 lần và chi phí thấp hơn 400 lần so với các LLM tương đương trong các tác vụ phân loại.
Tại sao Jev có thể là một bộ đánh giá tác nhân tốt?
Các phương pháp đánh giá tác nhân hiện nay hoặc là dựa trên mã nguồn, hoặc là sử dụng LLM làm giám khảo, mỗi loại đều có những ưu điểm, hạn chế và sự đánh đổi riêng.
Đánh giá dựa trên mã nguồn đã tồn tại từ lâu như chính mã nguồn vậy. Rẻ, nhanh và đáng tin cậy, nhược điểm chính của nó nằm ở khả năng hạn chế. Do các hàm truyền thống yêu cầu đầu vào xác định, khả năng đánh giá thế giới ngẫu nhiên của hành vi tác nhân là rất hạn chế. Ví dụ, trong khi một hàm truyền thống có thể đánh giá liệu một tác nhân có gọi công cụ trong lần chạy đầu tiên hay không, nó sẽ gặp khó khăn hơn trong việc đánh giá liệu tác nhân đó có sử dụng kết quả của công cụ để trả lời thành công câu hỏi của người dùng hay không. Trong một tác vụ mở, có thể có nhiều cách hợp lệ để sử dụng cùng một kết quả công cụ, vì vậy việc mã hóa mọi câu trả lời chấp nhận được thành logic xác định sẽ nhanh chóng vấp phải giới hạn về phạm vi hẹp của đánh giá dựa trên mã nguồn.
Tiếp theo là LLM-as-a-judge, sử dụng LLM để suy luận thông qua đầu vào phi cấu trúc từ dấu vết (trace) của tác nhân và chấm điểm nó. Một LLM giám khảo có thể chấp nhận câu hỏi, dấu vết và bằng chứng dưới dạng đầu vào phi cấu trúc, sau đó sử dụng prompt để đánh giá xem phản hồi có giải quyết được yêu cầu của người dùng hay không.
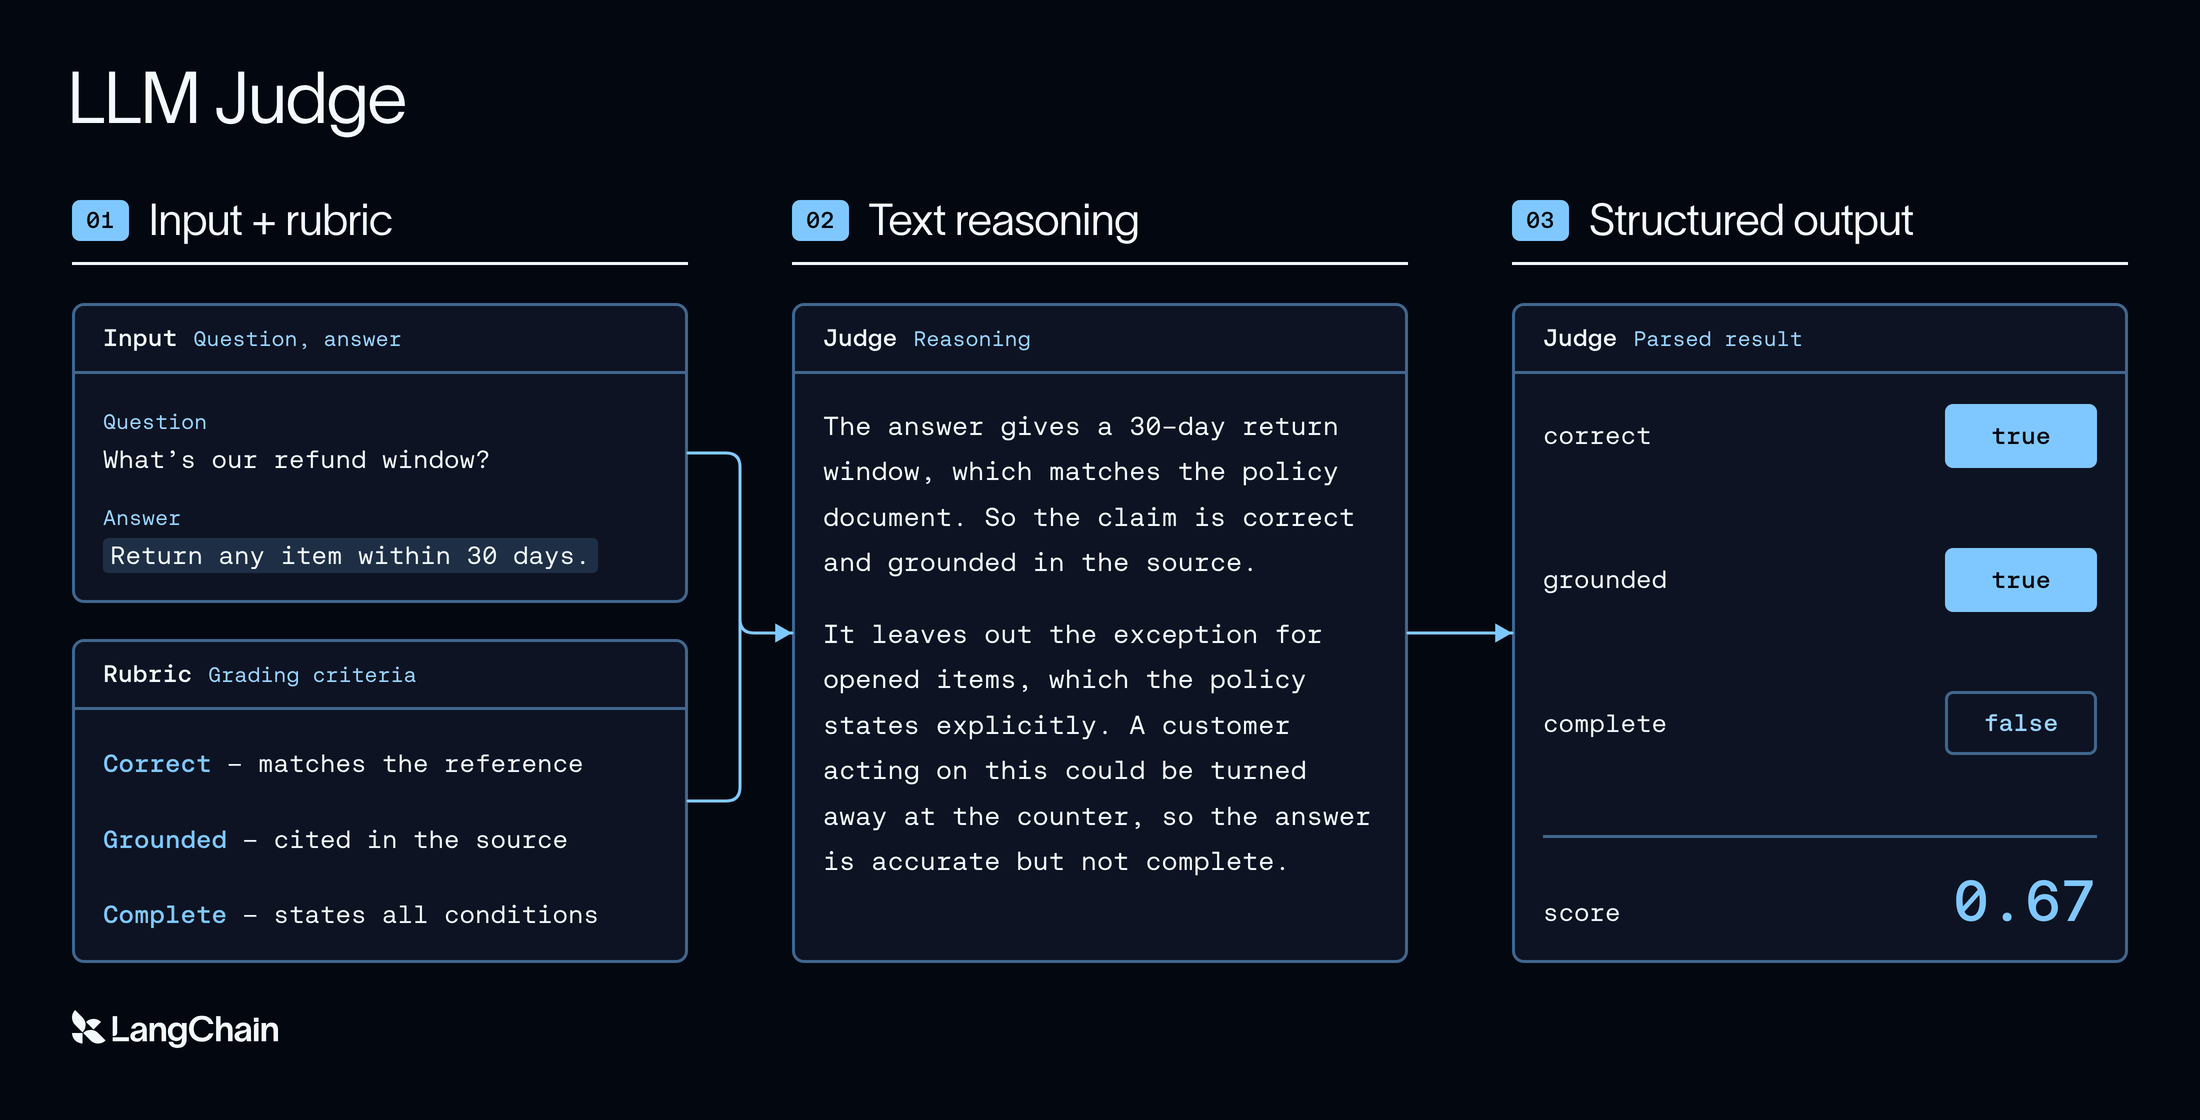
Tuy nhiên, như bất kỳ kỹ sư tác nhân nào cũng có thể xác nhận, LLM giám khảo không phải là một giải pháp hoàn hảo. Chúng vốn là các hệ thống không xác định (non-deterministic), không phải là nền tảng vững chắc cho một bộ máy kiểm thử đáng tin cậy. Chúng cũng chậm hơn và đắt hơn khi chạy so với đánh giá dựa trên mã nguồn truyền thống.
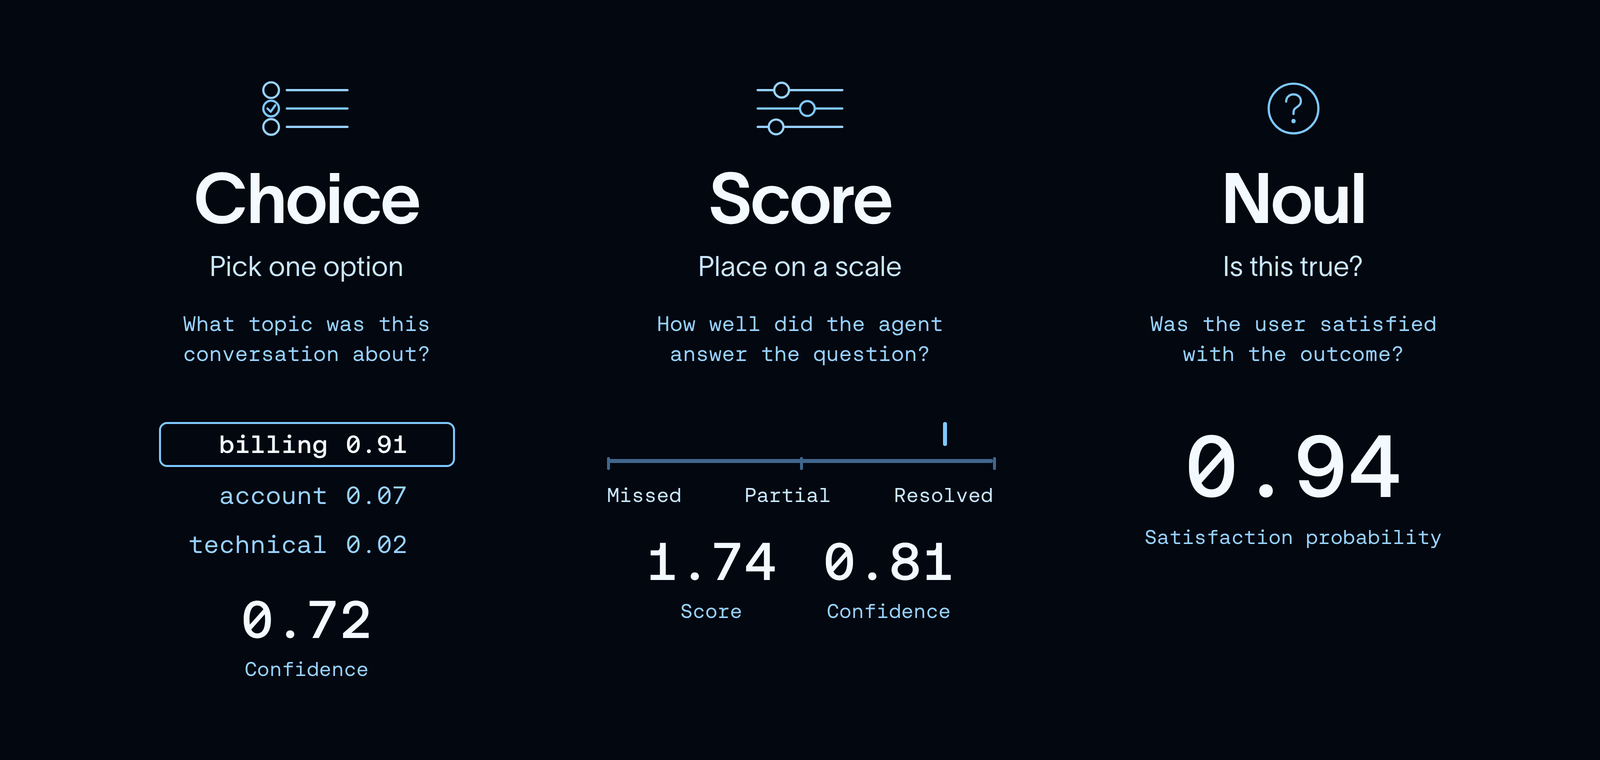
Đánh giá tác nhân là một tác vụ ra quyết định: dựa trên trạng thái và hành vi của tác nhân, hãy gán một điểm số để cung cấp phản hồi. Jev được thiết kế cho mô hình này. Nó đánh giá các câu hỏi có kiểu dữ liệu (typed questions) dựa trên trạng thái có cấu trúc và trả về các câu trả lời có kiểu dữ liệu kèm theo xác suất. Ngược lại, các mô hình tự hồi quy (autoregressive models) đưa ra phán đoán thông qua việc tạo văn bản từng token một. Trong thử nghiệm của chúng tôi, thiết kế ưu tiên quyết định này đồng nghĩa với độ trễ thấp hơn, chi phí thấp hơn và phương sai thấp hơn.
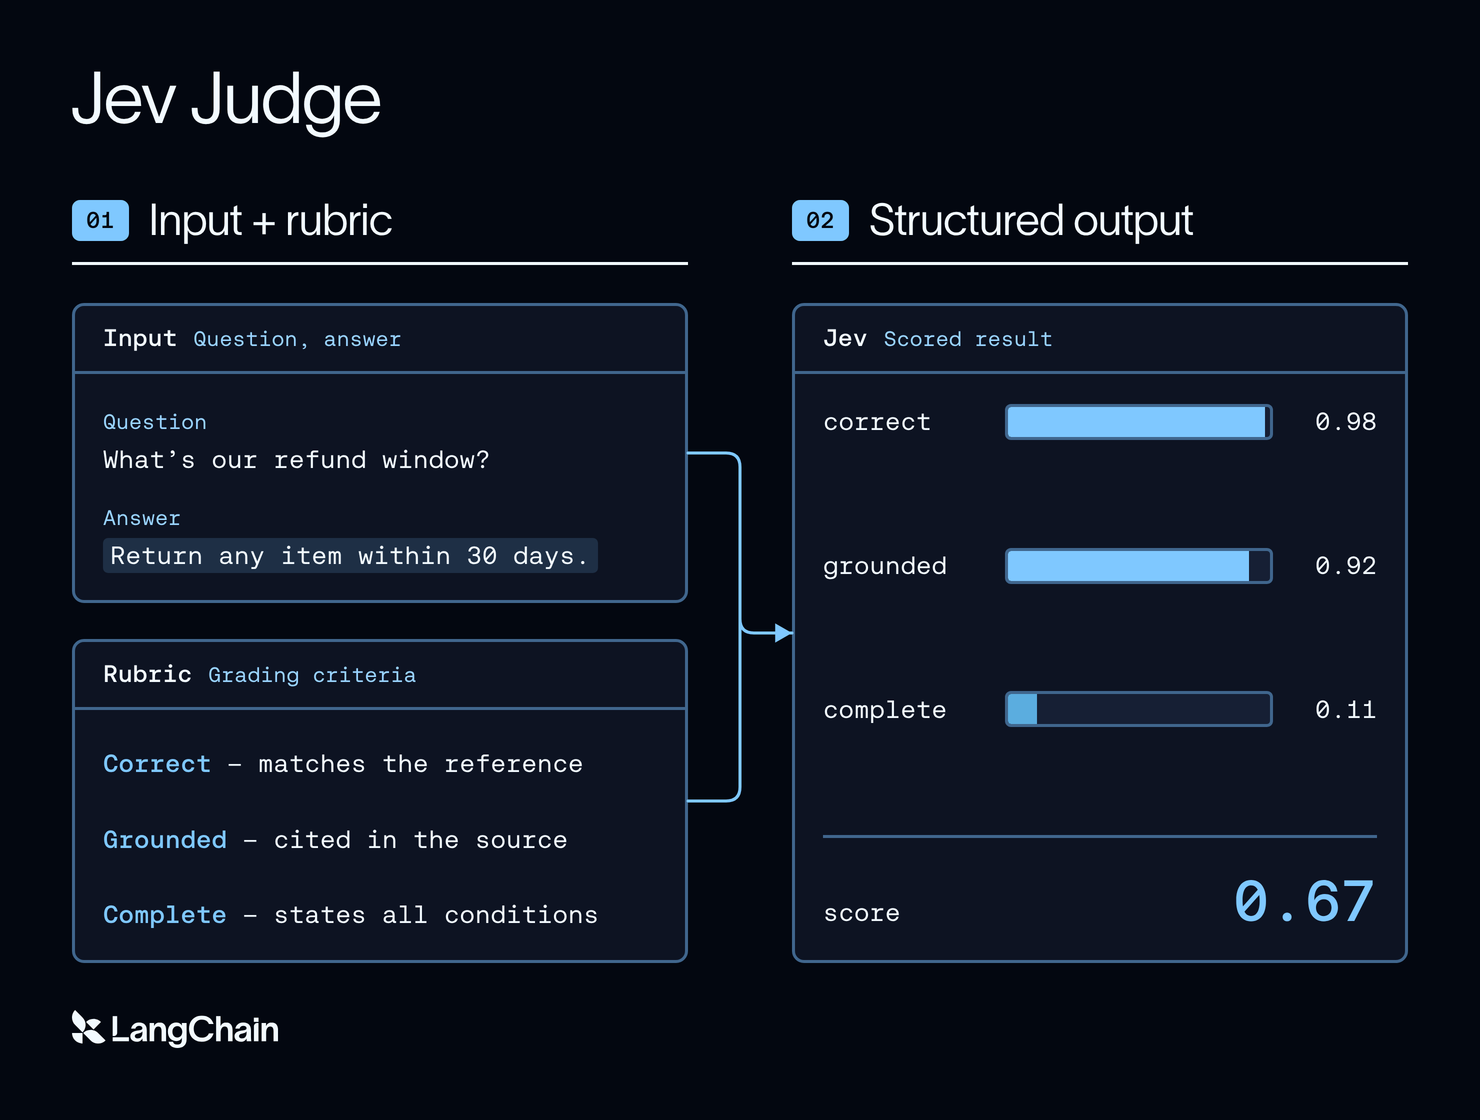
Jev hỗ trợ ba loại câu hỏi:
Nhiều câu hỏi nguyên tử (atomic questions) có thể được đánh giá song song trên cùng một trạng thái.
Việc so sánh các giám khảo rất khó khăn khi hành vi của tác nhân, dữ liệu được truy xuất hoặc ngữ cảnh dấu vết thay đổi giữa các lần chạy. Deep Agents và LangSmith cho phép chúng tôi nắm bắt một lần chạy tác nhân duy nhất dưới dạng tập dữ liệu và phát lại nó trên mỗi mô hình.
Đánh giá với Jev
Để đưa Jev vào thử nghiệm, chúng tôi cần một tác nhân để chấm điểm. Chúng tôi đã xây dựng một tác nhân mục tiêu bằng Deep Agents, bộ công cụ tác nhân mã nguồn mở của chúng tôi. Sau đó, chúng tôi xác định một tập kiểm thử dưới dạng tập dữ liệu LangSmith để mỗi bộ đánh giá chạy trên cùng các câu hỏi và hành vi mong đợi. Tập kiểm thử bao gồm năm yêu cầu về thời tiết:
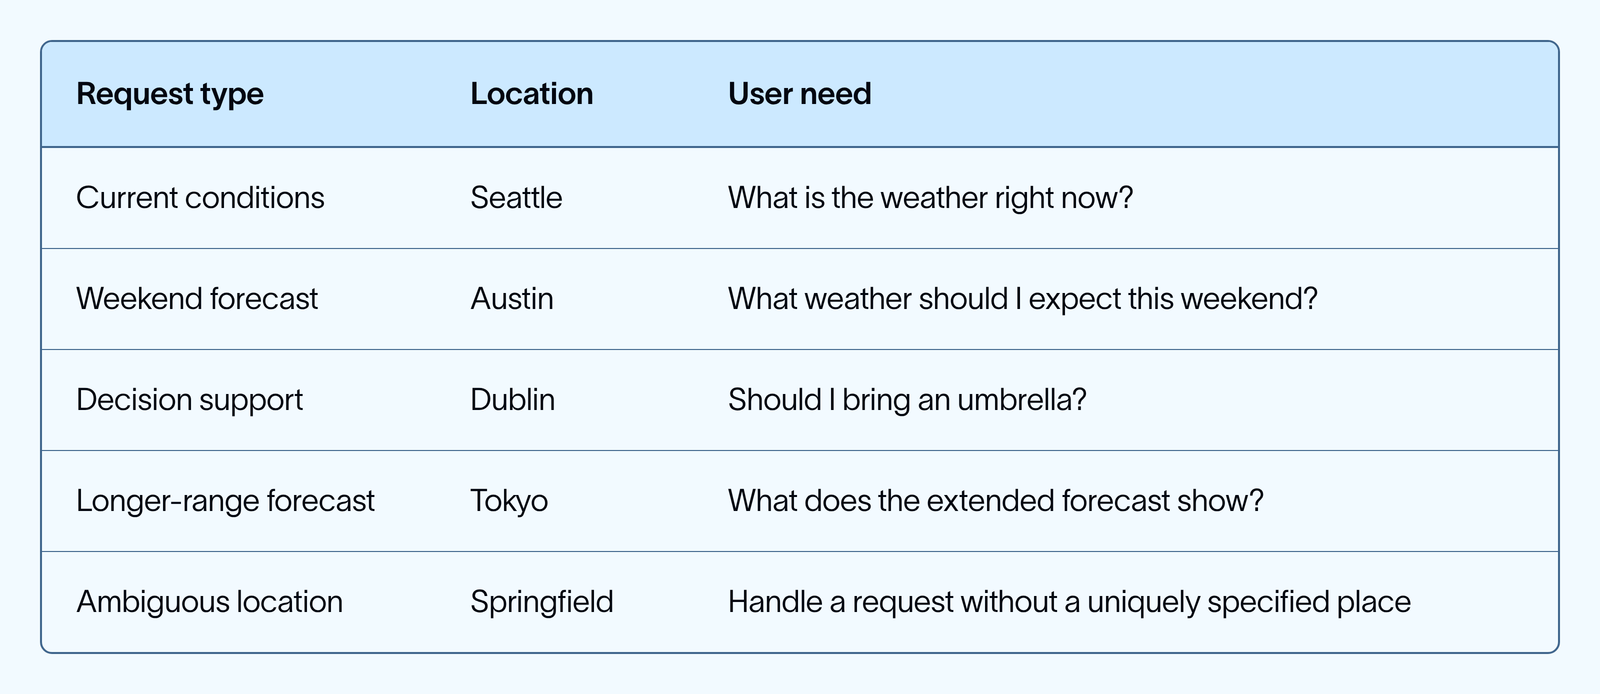
Đối với mỗi ví dụ trong tập dữ liệu, chúng tôi đã nắm bắt phản hồi của tác nhân thời tiết và lưu trữ toàn bộ đầu ra dưới dạng một ví dụ cố định trong LangSmith. Mỗi giám khảo đánh giá năm lần chạy đã ghi lại với hai tín hiệu: chất lượng (điểm số liên tục) và does_pass (quyết định nhị phân).
Để đo lường độ chính xác tách biệt với khả năng lặp lại, chúng tôi đã yêu cầu một người đánh giá gắn nhãn từng phản hồi cố định dựa trên cùng một thang điểm. Việc sử dụng nhãn của người đánh giá làm điểm chuẩn (oracle score) cho phép phân tích phong phú hơn về ảnh hưởng của độ chính xác và tính đúng đắn đối với hiệu quả tổng thể của bộ đánh giá.
Độ chính xác (Accuracy) đo lường sự đồng thuận với điểm chuẩn của con người. Phương sai (Variance) đo lường liệu một giám khảo có đưa ra phán đoán nhất quán trên cùng một hành vi tác nhân hay không. Phương sai thấp hơn không tự động có nghĩa là độ chính xác cao hơn: một giám khảo vẫn có thể sai một cách nhất quán. Nhưng khi một giám khảo chính xác, phương sai thấp hơn làm cho độ chính xác đó trở nên đáng tin cậy hơn trong môi trường sản xuất.
Chúng tôi đã so sánh Jev với GPT-5.6 Luna, GPT-5.6 Terra và Claude Sonnet 4.6, tính toán phương sai trên mỗi trường hợp qua 100 lần lặp lại và sự đồng thuận với điểm chuẩn của con người.
Kết quả đánh giá
Độ chính xác
Sử dụng nhãn của người đánh giá làm điểm chuẩn cho so sánh này, chúng tôi đã tính toán độ chính xác cho quyết định nhị phân đạt/không đạt.
Đối với điểm số nhị phân does_pass, Jev khớp với điểm chuẩn trên tất cả 500 quyết định lặp lại. Terra khớp 99,8% quyết định, Luna 96,4% và Claude 80,0%.
Độ chính xác (Precision)
Độ chính xác (Accuracy) cho chúng ta biết liệu giám khảo có đồng ý với điểm chuẩn của con người hay không. Độ chính xác (Precision) đặt câu hỏi liệu nó có tạo ra cùng một điểm chất lượng khi hành vi tác nhân không thay đổi hay không. Chúng tôi đã đo lường độ chính xác này bằng phương sai quan sát được của điểm số từ mỗi giám khảo.
Jev có phương sai trung bình trên mỗi trường hợp thấp nhất: 0,0000149. Luna cao hơn 433 lần, Terra cao hơn 913 lần và Claude cao hơn 92 lần.
Thử nghiệm này không thể cho chúng ta biết tại sao điểm số của Jev lại ít biến động hơn. Một giả thuyết là các mô hình được tối ưu hóa cho các loại đầu ra khác nhau. TypeSafe mô tả Jev là một mô hình quyết định được huấn luyện để trả về các xác suất đã hiệu chuẩn và các câu trả lời có kiểu dữ liệu, trong khi một LLM giám khảo tự hồi quy tạo ra văn bản trước khi bộ đánh giá ánh xạ đầu ra đó thành điểm số. Sự khác biệt đó có thể làm cho Jev phù hợp hơn với tác vụ đánh giá có giới hạn này, nhưng kết quả chỉ mang tính quan sát, không phải là bằng chứng cho thấy mục tiêu huấn luyện của nó gây ra phương sai thấp hơn.
Chi phí và độ trễ
Chi phí thấp có nghĩa là việc chạy đánh giá tác nhân ở quy mô lớn có thể thực hiện được. Khi các cuộc gọi đến bộ đánh giá đắt đỏ, các đội ngũ phải lựa chọn giữa phạm vi bao phủ và ngân sách của họ. Với mức 0,00035 USD mỗi cuộc gọi trong thử nghiệm này, Jev làm cho sự đánh đổi đó bớt nghiêm trọng hơn. Các đội ngũ có thể chi trả cho nhiều phán đoán lặp lại hơn và kiểm tra hồi quy thường xuyên hơn. Điều này thậm chí còn quan trọng hơn đối với đánh giá trực tuyến (online evaluation), nơi chi phí thấp hơn trên mỗi cuộc gọi cho phép các đội ngũ chạy nhiều giám khảo hơn trên một phần lớn hơn các dấu vết sản xuất, tạo ra tín hiệu phản hồi dày đặc hơn.
Đánh giá trực tuyến được mở khóa ở quy mô lớn
Đối với một tác nhân sản xuất tạo ra 10.000 dấu vết mỗi ngày, chi phí trên mỗi cuộc gọi quan sát được chuyển thành sự khác biệt vận hành đáng kể.
Để tính đến việc liệu một cuộc gọi chi phí thấp có hữu ích hay không, chúng tôi định nghĩa giá trị tín hiệu là sự đồng thuận với điểm chuẩn nhị phân nhân với khả năng lặp lại nhị phân. Khả năng lặp lại là cơ hội mà hai cuộc gọi độc lập trên cùng một dấu vết trả về cùng một phán quyết. Điều này khen thưởng các giám khảo vừa chính xác vừa ổn định, đồng thời phạt một giám khảo sai một cách nhất quán.
Một giám khảo có giá trị tín hiệu cao, chi phí thấp như Jev có thể mở khóa giá trị tốt hơn trong các bộ đánh giá trực tuyến. Các đội ngũ có thể tạo phản hồi trên nhiều dấu vết sản xuất hơn, phát hiện thay đổi về chất lượng sớm hơn và đặt cảnh báo khi phản hồi đó bắt đầu đi chệch hướng.
Một loại đánh giá tác nhân mới
Bài viết được AI dịch và tổng hợp tự động từ LangChain: Blog. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.