Mô hình
NVIDIA ra mắt mô hình tách giọng nói Nemotron 3 Diarization: Hỗ trợ theo dõi 8 người cùng lúc
(giờ Việt Nam)
Tóm tắt AI
NVIDIA vừa phát hành Nemotron 3 Diarization trên Hugging Face, mô hình mã nguồn mở 100M tham số có khả năng theo dõi thời gian thực tới 8 người nói và xử lý chồng lấn âm thanh, cho phép sử dụng thương mại.
Chính văn · Bản dịch AI
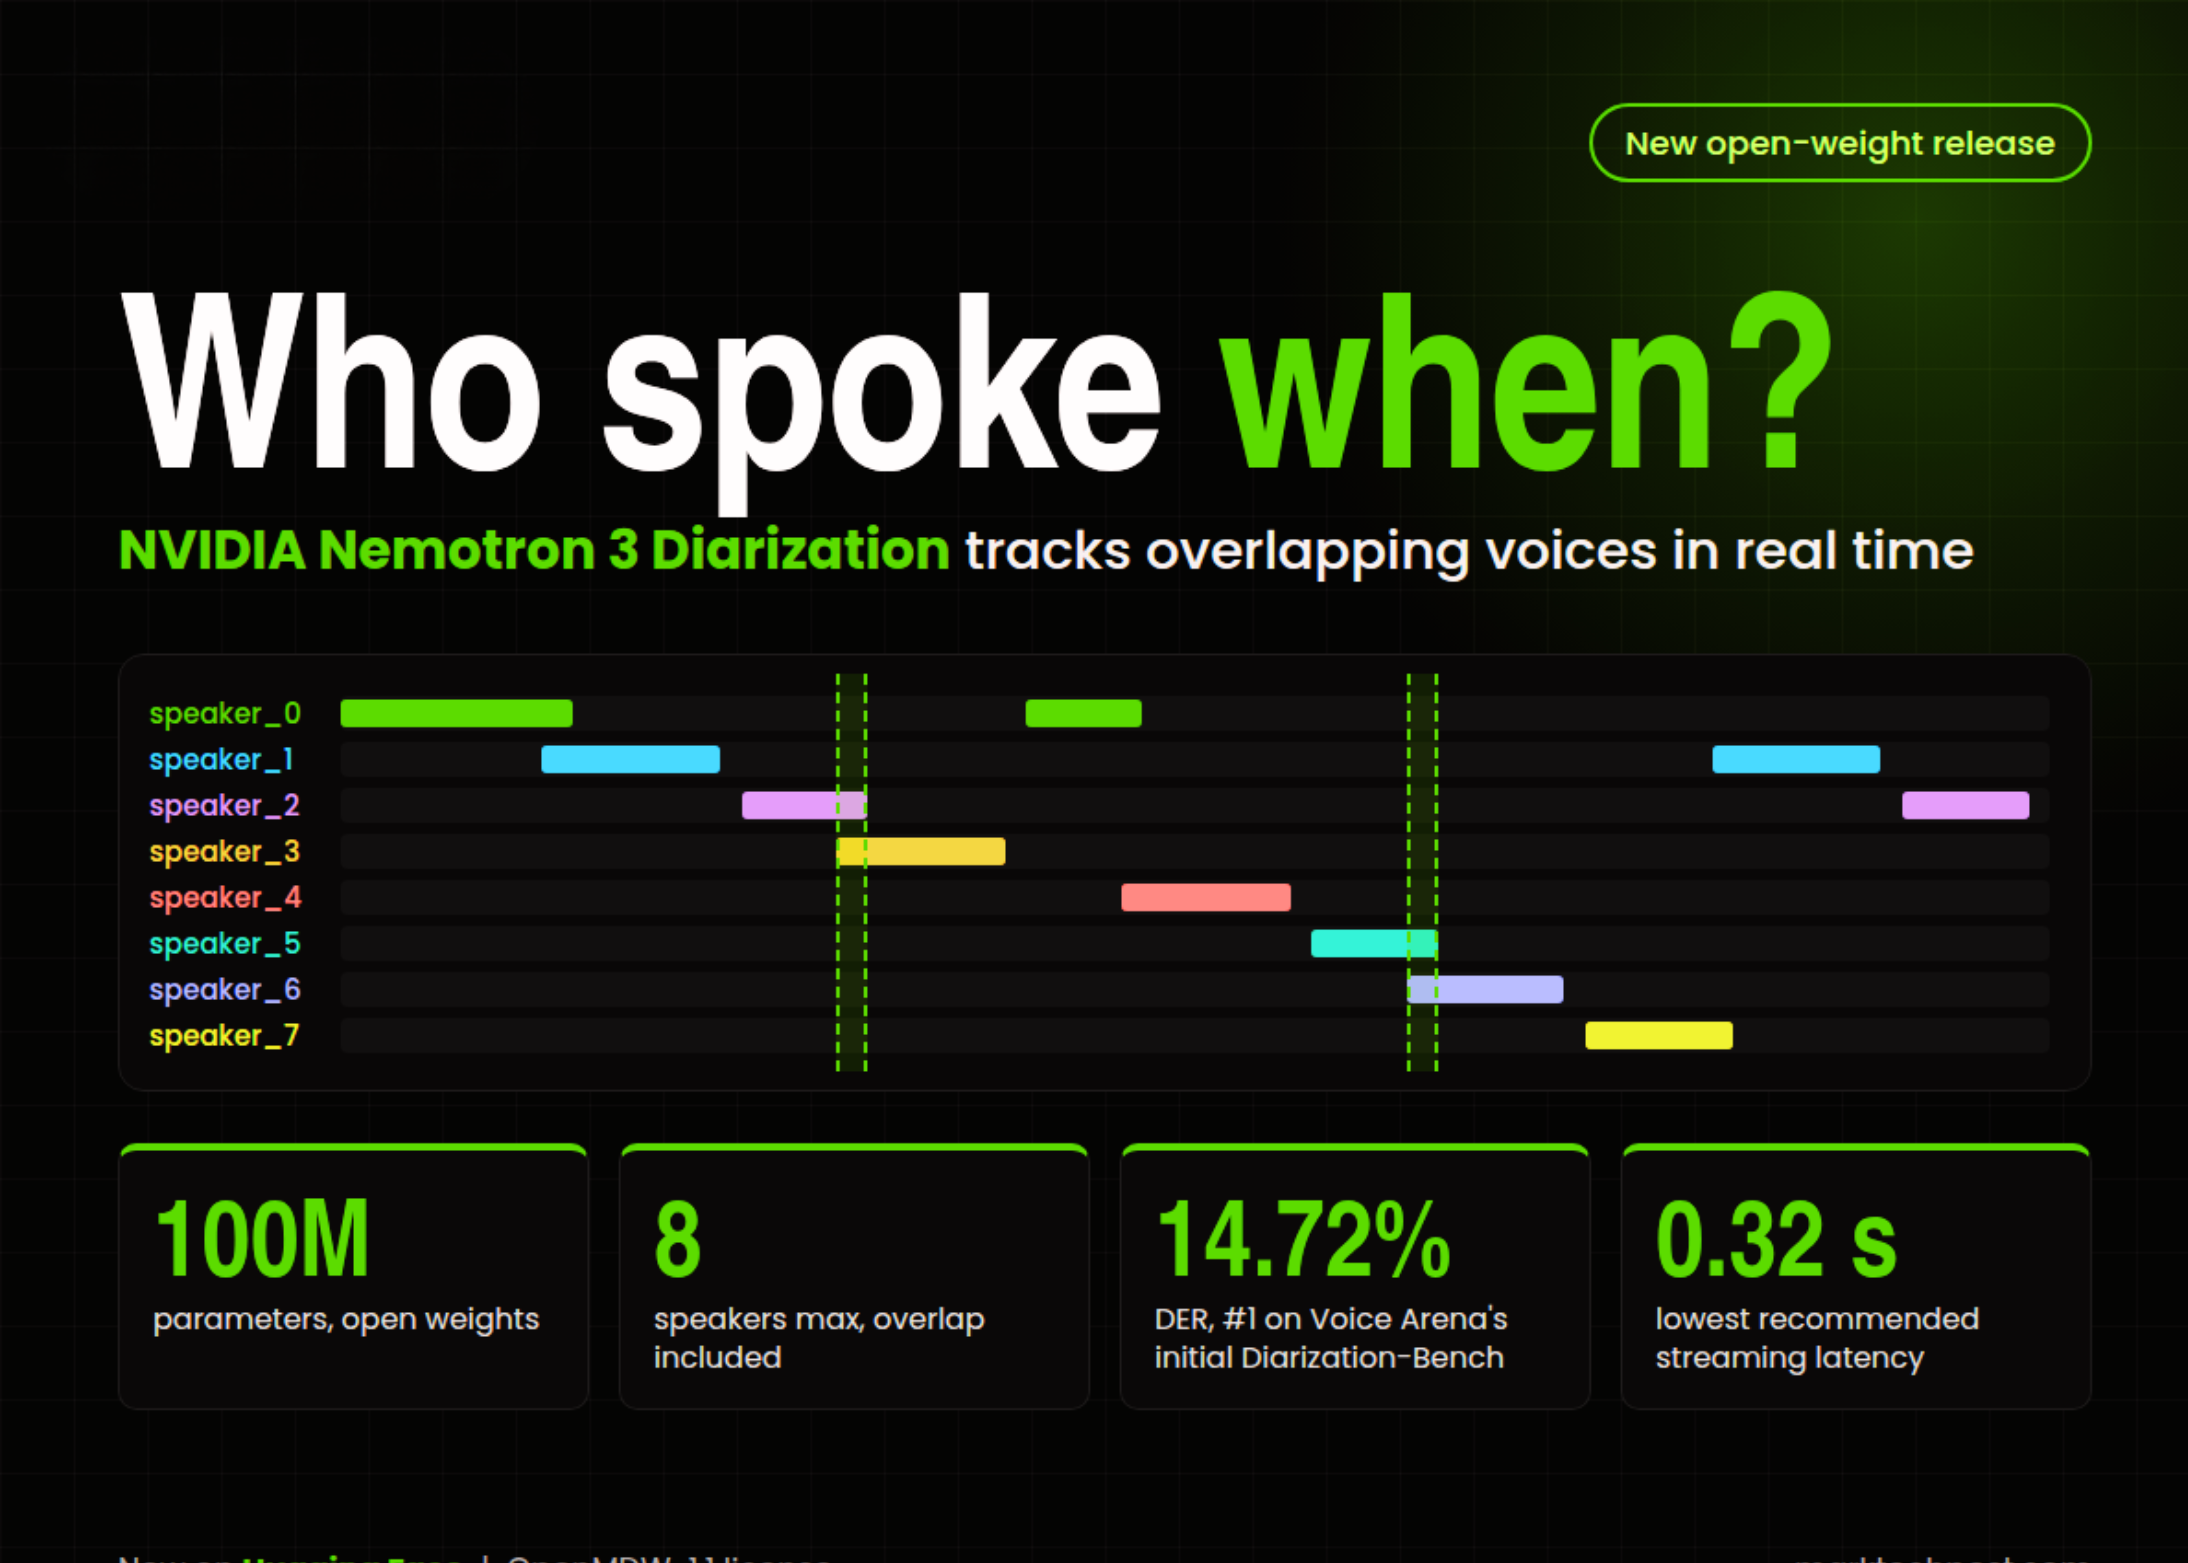
NVIDIA đã phát hành Nemotron 3 Diarization, một mô hình phân đoạn người nói (speaker diarization) với trọng số mở trên Hugging Face. Mô hình này giải đáp một câu hỏi về bất kỳ cuộc hội thoại nào: ai đã nói khi nào. Với 100 triệu tham số, mô hình có thể theo dõi tối đa 8 người nói, bao gồm cả những đoạn giọng nói chồng lấn. Một checkpoint duy nhất có thể xử lý cả bản ghi ngoại tuyến (offline) và phát trực tuyến thời gian thực.
Có thể triển khai được không? Có. Các trọng số được phát hành theo Giấy phép OpenMDW 1.1, cho phép sử dụng cho mục đích thương mại. Mô hình chạy trên Linux thông qua NVIDIA NeMo, sử dụng các GPU kiến trúc Ampere, Ada Lovelace, Hopper hoặc Blackwell.
Tại sao cần Phân đoạn người nói (Speaker Diarization)?
Nhận dạng giọng nói tự động (ASR) cung cấp cho bạn các từ ngữ. Nó không cho bạn biết ai là người nói những từ đó. Nếu không có sự phân định, một công cụ tóm tắt không thể biết ai đã đưa ra cam kết hoặc ai đã nêu phản đối.
Phân đoạn người nói xuất ra các khoảng thời gian mà mỗi người nói hoạt động. Các dấu thời gian đó kết hợp với đầu ra của ASR để tạo ra bản ghi có phân định người nói. Các công cụ họp, phân tích cuộc gọi, quy trình xử lý podcast và bộ nhớ của tác nhân giọng nói đều phụ thuộc vào bước này.
Những thay đổi so với Streaming Sortformer
Checkpoint Streaming Sortformer trước đây của NVIDIA, diar_streaming_sortformer_4spk-v2.1, hỗ trợ 4 người nói. Nemotron 3 Diarization tăng gấp đôi giới hạn đó lên 8 người. Theo thông báo của NVIDIA, mục tiêu là xử lý các đoạn âm thanh đa bên phức tạp nơi nhiều người nói cùng một lúc.
Kiến trúc hoạt động như thế nào
Mô hình chấp nhận âm thanh đơn kênh 16 kHz ở định dạng.wav,.flac,.opus hoặc.mp3. Nó chuyển đổi âm thanh thành các đặc trưng Mel-spectrogram với bước nhảy 10 ms. Các đặc trưng này được xếp chồng theo hệ số 8, tạo ra các khung encoder 80 ms.
Một Transformer encoder 31 lớp với cơ chế nhúng vị trí xoay (RoPE) sẽ xử lý các khung đó. Sau đó, một lớp Conv1D sẽ lấy mẫu lại các dự đoán về độ phân giải 10 ms. Đầu ra là một tensor [T, 8] chứa xác suất hoạt động của từng người nói.
Thiết kế này xử lý trực tiếp sự chồng lấn. Nếu 2 người nói cùng lúc, 2 kênh sẽ được kích hoạt trong cùng một khung hình.
Mô hình tuân theo phương pháp Sortformer là sắp xếp người nói theo thời gian xuất hiện. Giọng nói mới đầu tiên chiếm kênh 1, giọng tiếp theo chiếm kênh 2, và cứ thế tiếp tục. Điều này giúp các nhãn ổn định trên các đoạn phát trực tuyến, vì vậy mô hình không cần phải khớp lại người nói với các kênh cho mỗi đoạn.
Phát trực tuyến sử dụng 2 cơ chế bộ nhớ. Arrival-Order Speaker Cache (AOSC) lưu giữ thông tin người nói từ các đoạn trước đó. Một hàng đợi FIFO cung cấp ngữ cảnh khung hình gần đây. Các nhãn này là ẩn danh, và việc ánh xạ chúng với danh tính thực tế được để lại cho các ứng dụng hạ nguồn.
4 Điểm vận hành độ trễ
Độ trễ bộ đệm đầu vào bằng (đoạn + ngữ cảnh bên phải) × 80 ms. Bảng dưới đây sử dụng chỉ số DER tập đầy đủ của DIHARD III và thông lượng biên dịch batch-32 từ thẻ mô hình.
| Cấu hình | Độ trễ bộ đệm | DIHARD III DER | RTFx (batch 32, đã biên dịch) |
|---|---|---|---|
| Kiểu ngoại tuyến (Offline) | 30.4 s | 12.73% | 15,113× |
| Độ trễ thấp | 1.04 s | 13.18% | 865× |
| Độ trễ rất thấp | 0.64 s | 13.28% | 579× |
| Độ trễ cực thấp | 0.32 s | 13.55% | 292× |
Độ trễ này không bao gồm thời gian tính toán, mạng và ASR. Về mặt kỹ thuật, mô hình có thể chạy với bộ đệm 80 ms, nhưng 0.32 s là cài đặt thấp nhất được khuyến nghị.
Kết quả đánh giá (Benchmark)
Trong kết quả Diarization-Bench ban đầu của Voice Arena, mô hình xếp thứ nhất trong số 12 hệ thống và 17 cấu hình. Bài kiểm tra bao gồm 139 cuộc hội thoại tiếng Anh với tổng thời lượng khoảng 22 giờ. Nó đạt 14.72% DER so với 19.3% của hệ thống xếp hạng tiếp theo, giảm tương đối khoảng 24%. NVIDIA lưu ý rằng các kết quả này có thể thay đổi sau khi Voice Arena hoàn tất đánh giá Phiên bản 1.
So với baseline 4 người nói ở độ trễ 1.04 s, DER giảm trên tất cả 8 điều kiện đánh giá. Mức giảm tương đối dao động từ 9.0% trên CALLHOME-Part2 đến 65.2% trên NOTSOFAR1 MHM. Trung bình không trọng số trên 8 điều kiện là 41.0%.
Có một sự suy giảm hiệu suất. Trên CALLHOME 2 người nói ở độ trễ 30.4 s, DER tăng từ 5.68% lên 5.98%. Tuy nhiên, tập đầy đủ CALLHOME-Part2 vẫn cải thiện từ 10.32% xuống 9.10%.
Thông lượng cũng tăng vọt. Ở mức 30.4 s, mô hình đạt 15,113× RTFx so với 2,619× của baseline. Các bài kiểm tra sử dụng BF16 trên NVIDIA RTX PRO 5000 với torch.compile. Đây là các con số theo lô (batch), không phải độ trễ ứng dụng luồng đơn.
Dữ liệu huấn luyện
Quá trình huấn luyện kết hợp khoảng 10.000 giờ hội thoại thực tế với 82.611 giờ hỗn hợp đa người nói mô phỏng. Hỗn hợp này bao gồm âm thanh đa người nói trong thế giới thực được cấp phép từ David AI. Việc thêm dữ liệu của David AI đã cắt giảm DER tổng hợp từ 11.19% xuống 10.42%. Âm thanh nguồn được cấp phép cho các hỗn hợp mô phỏng bao gồm 21 ngôn ngữ.
Bắt đầu sử dụng
Cài đặt NVIDIA NeMo Speech với Python 3.12 trở lên:
uv pip install 'nemo-toolkit[asr]'from nemo.collections.asr.models import SortformerEncLabelModel
diar_model = SortformerEncLabelModel.from_pretrained("nvidia/Nemotron-3-Diarization")
diar_model.eval()
segments = diar_model.diarize(audio=["conversation.wav"], batch_size=1)Các phân đoạn đầu ra có dạng start end speaker_id. Để lấy cả nội dung văn bản, hãy kết hợp mô hình với Parakeet TDT 0.6B v3 bằng cách sử dụng hướng dẫn tích hợp ASR.
Space demo trực tiếp cung cấp các cuộc hội thoại tổng hợp, micrô trực tiếp, micrô trực tiếp đa ngôn ngữ và tải lên âm thanh. Đối với sản xuất, NVIDIA liệt kê Baseten và DigitalOcean. Hỗ trợ trên thiết bị có sẵn thông qua Argmax Pro SDK 3. Mô hình hiện chưa có sẵn thông qua các Nhà cung cấp suy luận Hugging Face.
Mô hình có những giới hạn. Các bản ghi có hơn 8 người nói có thể dẫn đến bỏ sót hoặc gán nhầm giọng nói. Tiếng ồn lớn, độ vang và thu âm trường xa cũng có thể làm tăng tỷ lệ lỗi.
Những điểm chính
- Mô hình trọng số mở 100 triệu tham số theo dõi tối đa 8 người nói chồng lấn.
- Một checkpoint duy nhất bao phủ mọi thứ từ ngoại tuyến (30.4 s) đến phát trực tuyến độ trễ cực thấp 0.32 s.
- Xếp hạng #1 trên Diarization-Bench ban đầu của Voice Arena với 14.72% DER.
- Giảm trung bình 41.0% DER tương đối so với Streaming Sortformer ở độ trễ 1.04 s.
- Giấy phép OpenMDW-1.1 cho phép sử dụng thương mại; mô hình chạy trên GPU NVIDIA thông qua NeMo.
Hãy xem Trọng số mô hình, Blog kỹ thuật và Demo. Mọi công lao thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit 150k+ ML của chúng tôi cũng như đăng ký Bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Bạn cần hợp tác với chúng tôi để quảng bá GitHub Repo HOẶC Trang Hugging Face HOẶC Phát hành sản phẩm HOẶC Hội thảo trực tuyến, v.v.? Kết nối với chúng tôi

Asif Razzaq
Asif Razzaq là CEO của Marktechpost AI Media Inc.. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt Nền tảng truyền thông Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về tin tức học máy và học sâu, vừa đảm bảo tính kỹ thuật vừa dễ hiểu đối với đông đảo khán giả. Nền tảng này tự hào với hơn 2 triệu lượt xem hàng tháng, minh chứng cho sự phổ biến của nó đối với độc giả.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.