Tin ngành
5 tiêu chuẩn vàng để đánh giá cơ sở dữ liệu cho AI Agent
(giờ Việt Nam)
Tóm tắt AI
Bài viết đề xuất khung đánh giá 5 tiêu chí quan trọng, bao gồm khả năng phân tách nhánh (branch isolation) và kiến trúc serverless, giúp xác định cơ sở dữ liệu phù hợp cho khối lượng công việc của AI Agent.
Bản dịch AI
Năm tiêu chí để đánh giá một cơ sở dữ liệu cho các AI agent bao gồm: phân tách nhánh (branch isolation), mở rộng serverless (serverless scaling), tìm kiếm kết hợp (hybrid search), đảm bảo tính ACID và truy cập nền tảng hợp nhất (unified platform access). Tổng hợp lại, các tiêu chí này giúp các nhà phát triển và đội ngũ dữ liệu xác định liệu một cơ sở dữ liệu có thể hỗ trợ các agent hay không khi chúng chuyển từ giai đoạn thử nghiệm sang vận hành thực tế (production) và bắt đầu xử lý các tác vụ đồng thời, dữ liệu vận hành trực tiếp và trạng thái bền vững.
Cơ sở dữ liệu cho AI agent là một hệ thống được thiết kế để lưu trữ trạng thái, bộ nhớ, kết quả công cụ và dữ liệu vận hành mà một agent cần để hoàn thành các tác vụ qua nhiều bước và phiên làm việc. Không giống như cơ sở dữ liệu phục vụ ứng dụng thông thường, nó cần hỗ trợ việc đọc và ghi lặp đi lặp lại, hoạt động đồng thời của agent, truy xuất qua các loại bộ nhớ khác nhau và truy cập vào dữ liệu vận hành hiện tại.
Sự trỗi dậy của AI agent khiến các yêu cầu này trở nên quan trọng hơn. Khi các nhà phát triển chạy các agent lập trình, agent hỗ trợ khách hàng hoặc các nền tảng đa người thuê (multi-tenant), các agent không chỉ đơn thuần truy xuất thông tin. Chúng ghi lại trạng thái, tiếp tục các tác vụ, điều phối các lệnh gọi công cụ và hành động dựa trên dữ liệu vận hành đang thay đổi. Khi các đội ngũ dữ liệu đưa agent vào môi trường production, những hạn chế của cơ sở dữ liệu có thể tạo ra bộ nhớ lỗi thời, xung đột ghi, độ trễ và chi phí tính toán không cần thiết.
Tại sao cơ sở dữ liệu cho AI agent lại là một vấn đề khác biệt
Một agent sẵn sàng cho môi trường production cần phải ghi nhớ những gì nó đã thực hiện, tiếp tục tác vụ từ nơi nó đã dừng lại và thu thập đúng ngữ cảnh trước khi hành động. Nếu kết hợp với sai cơ sở dữ liệu, bộ nhớ đó có thể trở nên lỗi thời, không đầy đủ hoặc không nhất quán.
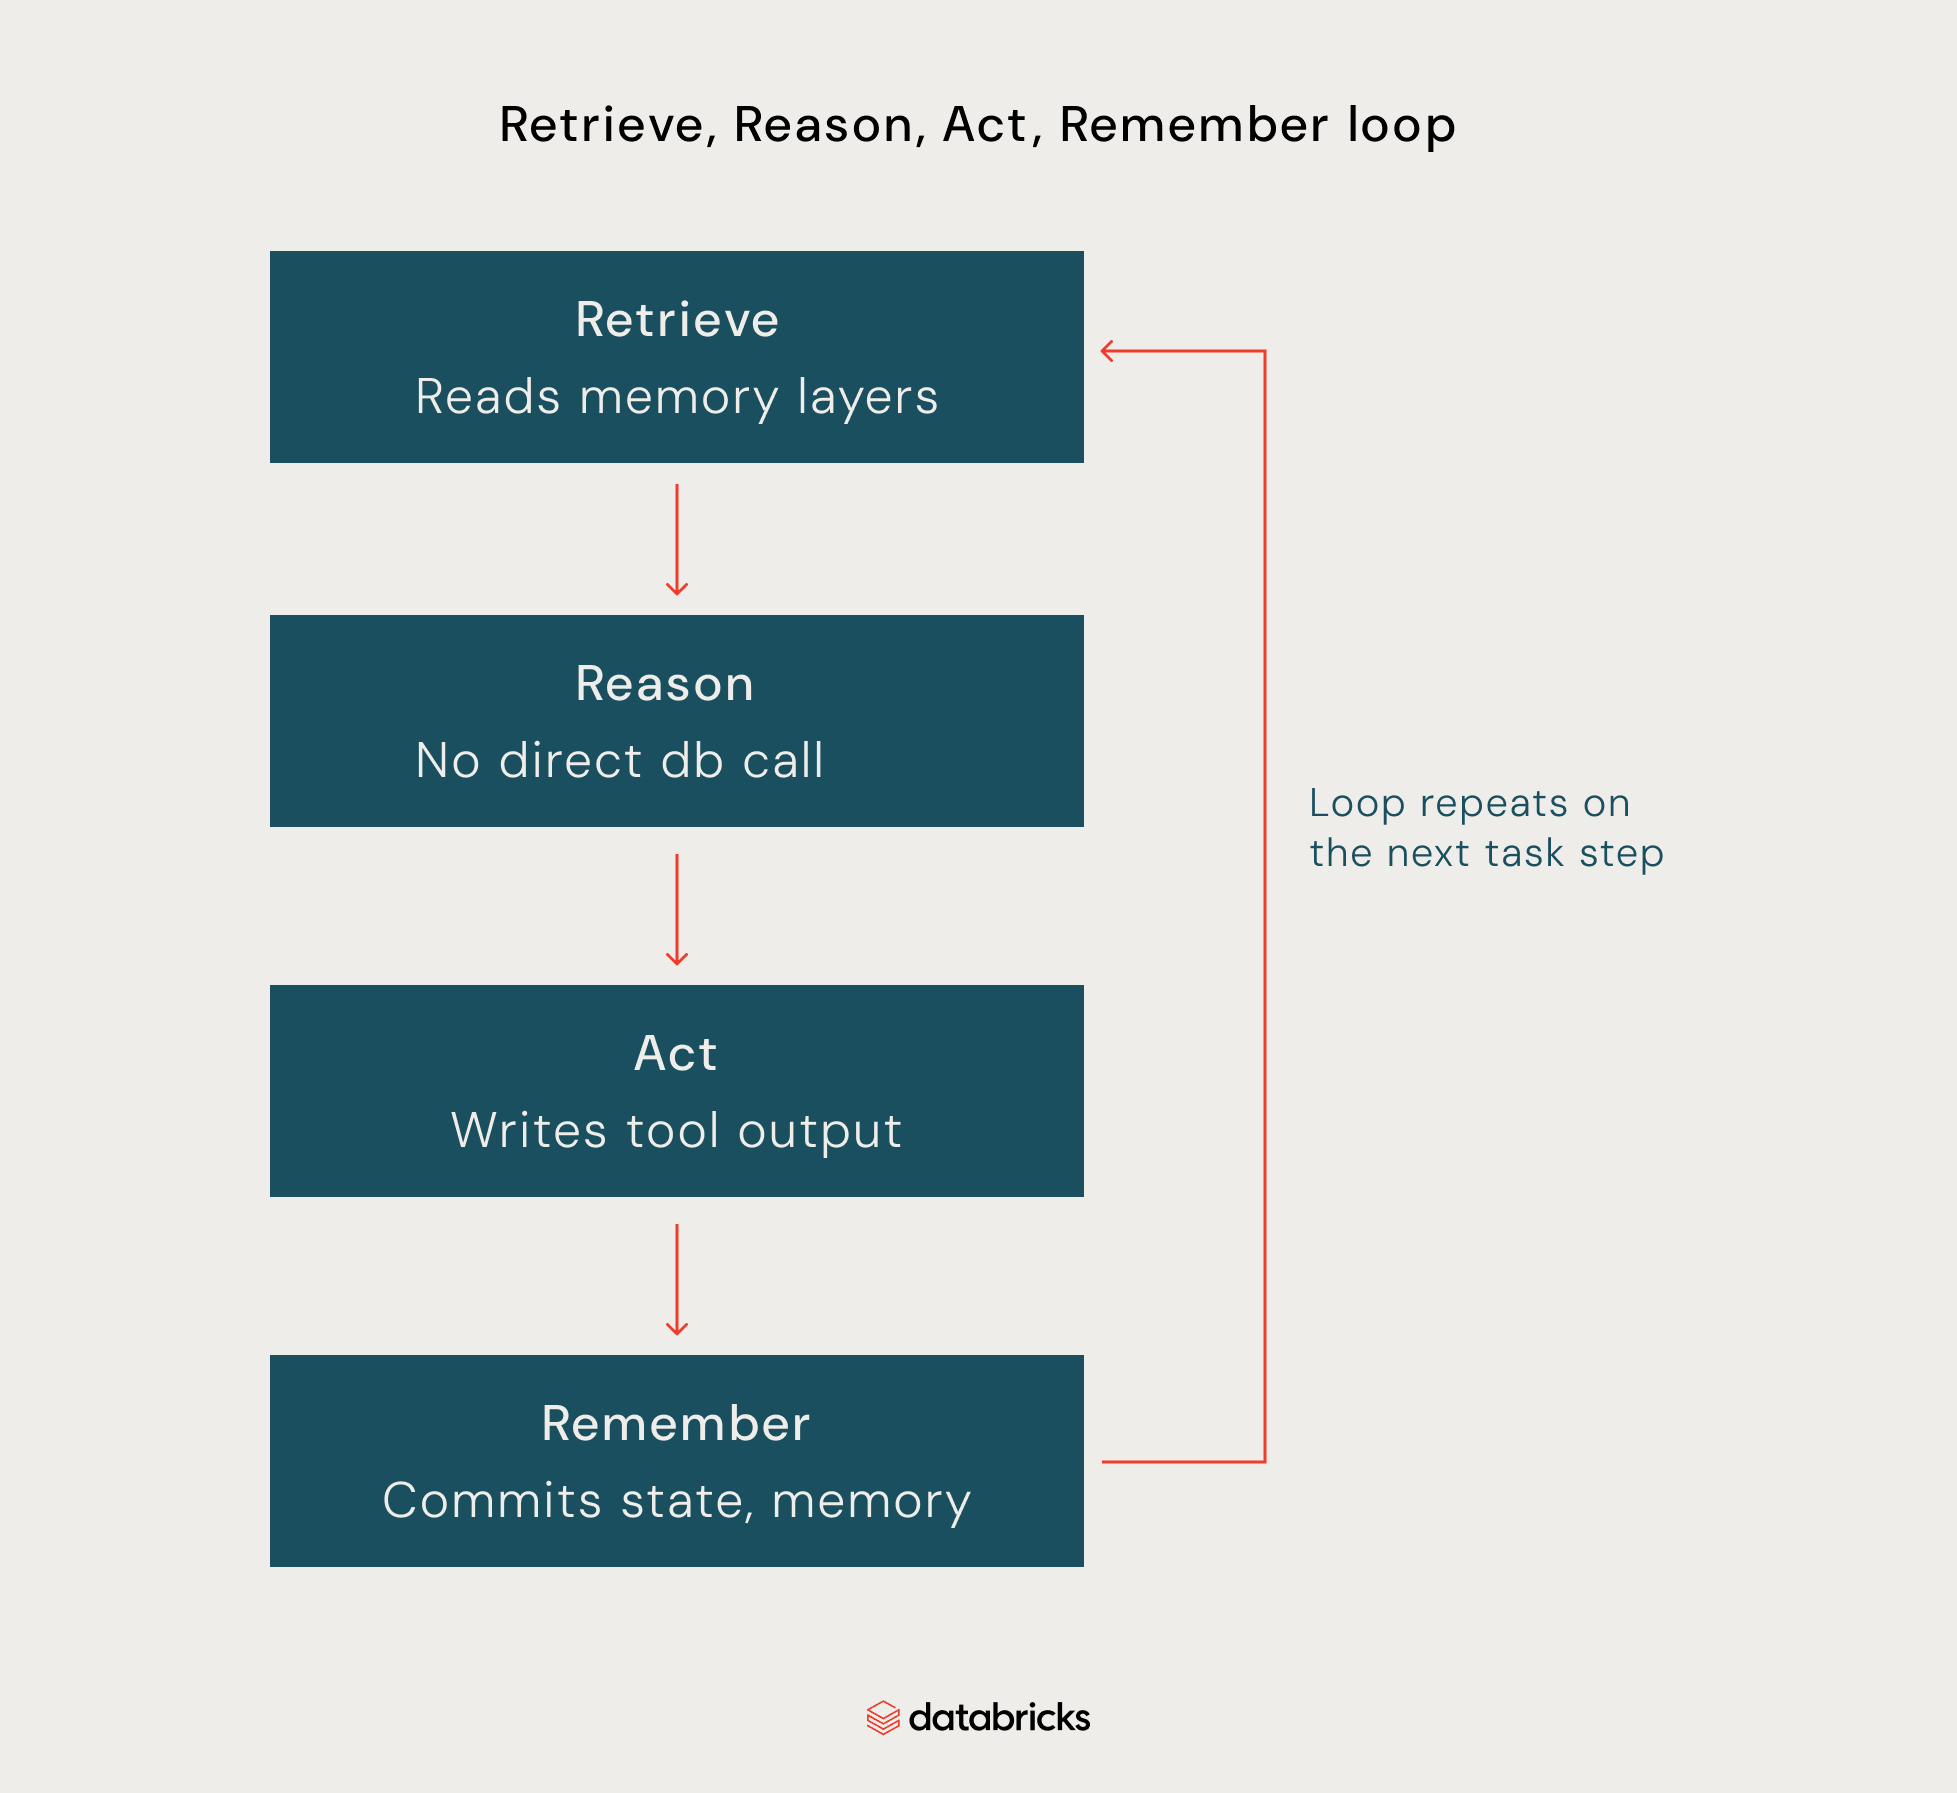
Các agent trong môi trường production dựa vào bốn lớp bộ nhớ để thực hiện điều này:
Đây là khối lượng công việc phức tạp hơn so với một ứng dụng thông thường, vốn chỉ gửi một truy vấn đến cơ sở dữ liệu rồi kết thúc. Hầu hết các cơ sở dữ liệu production là cơ sở dữ liệu vận hành, còn được gọi là hệ thống xử lý giao dịch trực tuyến (OLTP), được xây dựng dựa trên mô hình mỗi lần một yêu cầu. Một agent không hoạt động theo cách đó. Nó thực hiện liên tiếp các lệnh đọc và ghi trong một tác vụ duy nhất, không có sự tạm dừng của con người giữa các lệnh, trong khi hàng trăm agent khác cũng đang làm điều tương tự.
5 tiêu chí để đánh giá bất kỳ cơ sở dữ liệu nào cho khối lượng công việc của AI agent
Khi chọn cơ sở dữ liệu cho AI agent, có một vài tiêu chí quan trọng, nhưng năm tiêu chí dưới đây là những điều đáng đánh giá bất kể bạn đang cân nhắc nhà cung cấp nào, dù là được quản lý (managed) hay tự lưu trữ (self-hosted).
Phân tách nhánh cho mỗi agent: Kiểm thử an toàn trên dữ liệu thực
Kiểm thử một agent chỉ với dữ liệu tổng hợp (synthetic data) cũng giống như kiểm thử một hệ thống hỗ trợ với một vài tài khoản khách hàng được định dạng hoàn hảo. Nó có thể hoạt động chính xác như mong đợi, nhưng các tài khoản thực tế luôn phức tạp hơn nhiều. Các đội ngũ dữ liệu cuối cùng sẽ gặp phải các trường thông tin bị thiếu, bản ghi không nhất quán, dữ liệu cũ và các trường hợp ngoại lệ chưa từng xuất hiện trong các bộ dữ liệu kiểm thử của họ.
Đó là lý do tại sao chúng tôi khuyên bạn nên coi việc kiểm thử cô lập trên dữ liệu thực là một tiêu chí đánh giá cơ sở dữ liệu. Mục tiêu là để agent làm việc với trạng thái giống như môi trường production mà không cho phép nó sửa đổi dữ liệu production. Một cách để đạt được sự cô lập đó là phân nhánh không sao chép (zero-copy branching), cho phép các nhà phát triển tạo ra một môi trường riêng biệt mà không cần duy trì bản sao đầy đủ thứ hai của cơ sở dữ liệu.
Lakebase Projects được thiết kế để xử lý loại hình phát triển và kiểm thử cô lập này bằng cách cho phép các nhà phát triển tạo các nhánh từ dữ liệu production mà không cần sao chép dữ liệu gốc. Việc phân nhánh một cơ sở dữ liệu quy mô terabyte chỉ mất khoảng một giây, không tốn thêm chi phí lưu trữ cho đến khi nhánh đó khác biệt so với nhánh gốc.
Mở rộng về 0 (Scale to zero): Cách định giá serverless thay đổi kinh tế học của agent
27% chi phí đám mây bị lãng phí mỗi năm, và tài nguyên tính toán nhàn rỗi, không được sử dụng hết luôn là nguyên nhân lớn nhất gây ra điều đó. Cơ sở dữ liệu cho agent là một ví dụ rõ ràng về lý do tại sao. Hầu hết các agent không chạy liên tục. Chúng thức dậy, thực hiện một tác vụ, ghi lại kết quả, sau đó im lặng cho đến khi yêu cầu tiếp theo đến. Việc trả tiền cho tài nguyên tính toán chuyên dụng suốt ngày đêm đồng nghĩa với việc trả tiền cho cùng một vấn đề lãng phí tài nguyên trên mọi cơ sở dữ liệu agent mà một đội ngũ đang vận hành.
Mô hình serverless scale-to-zero giải quyết vấn đề này bằng cách tạm dừng tính toán sau một khoảng thời gian không có kết nối hoạt động và tiếp tục lại khi công việc bắt đầu. Điều đó giúp chi phí bám sát mức sử dụng thực tế thay vì thời gian nhàn rỗi. Tuy nhiên, tốc độ khởi động cũng quan trọng không kém việc tiết kiệm chi phí. Một agent phải đợi 20 hoặc 30 giây để cơ sở dữ liệu thức dậy là không thực tế, đặc biệt là khi nó đang phản hồi người dùng hoặc chờ đợi lệnh gọi công cụ tiếp theo.
Lakebase sử dụng mô hình này cho Postgres, với tài nguyên tính toán được khôi phục trong vòng vài trăm mili giây kể từ khi có truy vấn mới. Điều đó giữ cho độ trễ khởi động đủ nhỏ để mô hình scale-to-zero hoạt động hiệu quả với các khối lượng công việc agent tương tác.
Tìm kiếm kết hợp (Hybrid Search): Truy xuất qua cả bốn lớp bộ nhớ trong một truy vấn
Chỉ sử dụng tìm kiếm vector (vector search) giống như một thủ thư chỉ có thể tìm kiếm theo "cảm giác tương tự", chứ không bao giờ tìm được theo mã số chính xác. Yêu cầu nó tìm tài liệu về kiến trúc cơ sở dữ liệu, nó sẽ làm tốt. Yêu cầu nó tìm bản ghi có ID tài khoản 48291, nó không có cách nào đáng tin cậy để tìm ra. Sự tương đồng về ngữ nghĩa không được xây dựng cho các kết quả khớp chính xác.
Đó là khoảng trống mà nhiều quy trình RAG (retrieval-augmented generation) gặp phải khi chỉ dựa vào tìm kiếm vector. Tìm kiếm kết hợp (hybrid search) lấp đầy khoảng trống đó bằng cách kết hợp sự tương đồng vector, khớp từ khóa và lọc metadata trong một truy vấn duy nhất thay vì chắp vá kết quả từ các hệ thống riêng biệt. Nếu tách biệt giữa chỉ mục vector và kho lưu trữ quan hệ, agent sẽ phải thực hiện hai lệnh gọi thay vì một. Các hệ thống có thể bị lệch đồng bộ, và mỗi bước nhảy thêm vào sẽ tạo ra độ trễ mà vòng lặp của agent không phải lúc nào cũng chịu đựng được. Việc truy xuất cần đạt dưới 100 mili giây để có thể sử dụng được trong một chu trình suy luận chặt chẽ.
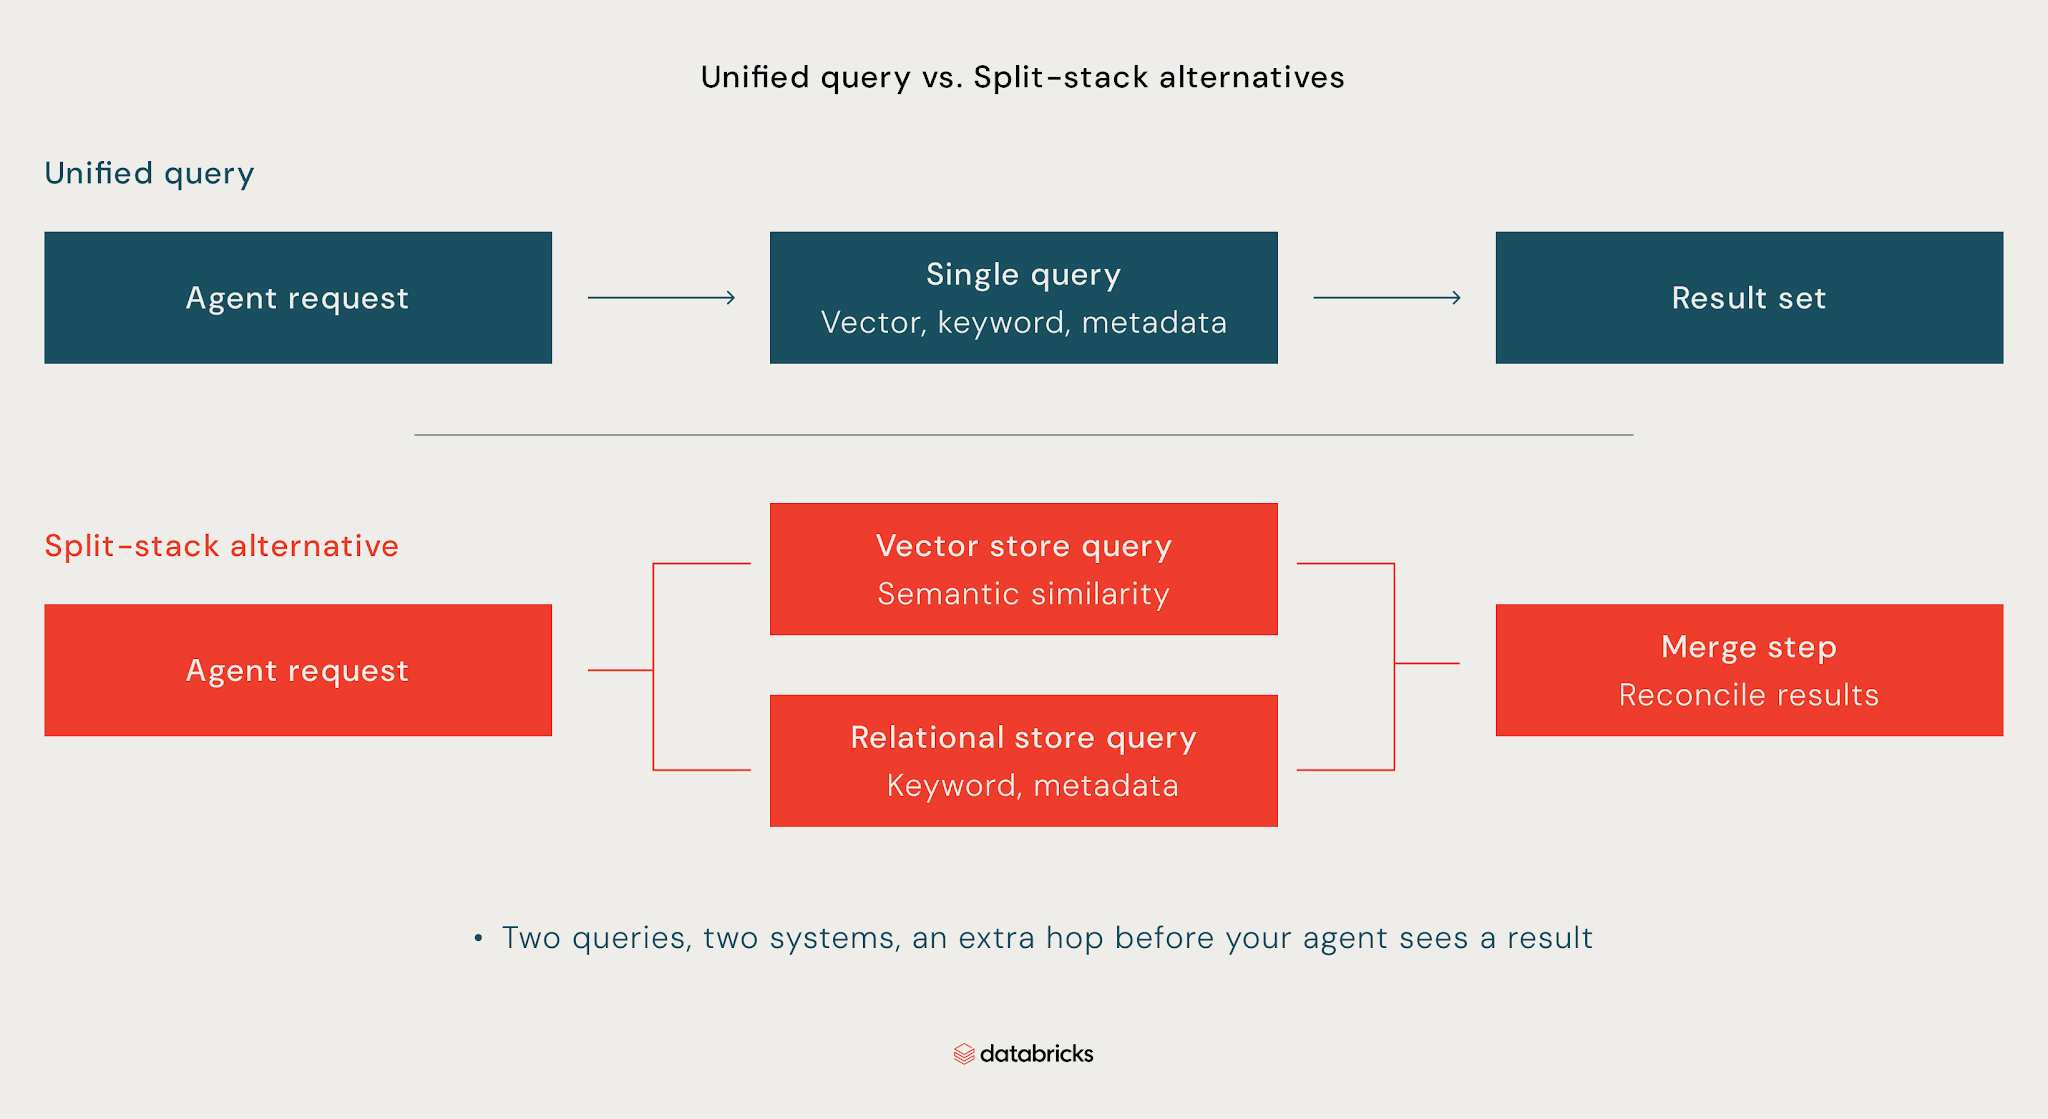
Lakebase Search chạy các truy vấn vector, từ khóa và metadata trên cùng các bảng Postgres nơi dữ liệu vận hành đang tồn tại, vì vậy không có hệ thống thứ hai nào bị lệch đồng bộ. Kiến trúc LTAP của nó là thứ giữ cho dữ liệu đó luôn cập nhật, với hiệu suất ghi nhanh hơn tới 5 lần so với Postgres tiêu chuẩn. Điều đó có nghĩa là những gì agent vừa ghi có thể được truy xuất gần như ngay lập tức.
Đảm bảo tính ACID cho các hệ thống đa agent
Hãy tưởng tượng hai agent hỗ trợ cùng cập nhật một bản ghi khách hàng tại cùng một thời điểm. Một agent đang giải quyết vấn đề thanh toán và điều chỉnh gói đăng ký, trong khi agent kia đang ghi lại khoản hoàn tiền. Nếu không có sự phân tách phù hợp, một bản cập nhật có thể ghi đè lên bản cập nhật kia, khiến bản ghi rơi vào trạng thái mà không agent nào mong muốn.
Đó là lý do tại sao các đảm bảo giao dịch (transactional guarantees) nên là một tiêu chí cứng khi đánh giá cơ sở dữ liệu cho khối lượng công việc đa agent. ACID cung cấp cho các nhà phát triển bốn thuộc tính để kiểm tra:
Đối với các hệ thống đa agent, các câu hỏi thực tế quan trọng hơn thuật ngữ viết tắt. Liệu một lệnh commit đầu ra của công cụ có thể xảy ra một cách nguyên tử (atomically) để một hành động chưa hoàn thành không bao giờ bị coi là đã hoàn tất? Điều gì xảy ra khi hai agent cập nhật cùng một bản ghi? Cơ sở dữ liệu hỗ trợ các mức độ phân tách (isolation levels) nào? Liệu một agent có thể tiếp tục sau khi khởi động lại mà không làm mất trạng thái đã commit?
Khi so sánh các cơ sở dữ liệu, chúng tôi khuyên bạn nên kiểm tra các mức độ phân tách và ngữ nghĩa commit mà chúng thực sự hỗ trợ, thay vì chỉ xem liệu chúng có tuyên bố "hỗ trợ giao dịch" hay không. Khi nhiều agent chia sẻ dữ liệu vận hành, những chi tiết đó quyết định liệu công việc đồng thời có duy trì được tính dự đoán hay không.
Nền tảng hợp nhất: Dữ liệu vận hành trong AI Stack mà không cần ETL
Một agent đang chờ đợi một đường ống dữ liệu (pipeline) cập nhật sẽ đưa ra quyết định dựa trên dữ liệu lỗi thời. Đến khi pipeline đó chạy xong, bản ghi mà nó đang xử lý có thể đã thay đổi lần nữa. Khi đánh giá cơ sở dữ liệu, hãy xem xét mức độ kết nối chặt chẽ giữa dữ liệu vận hành với các hệ thống phân tích và AI phụ thuộc vào nó.
Một nền tảng hợp nhất giữ cho các lệnh ghi vận hành và lệnh đọc phân tích trên cùng một dữ liệu, mà không cần một pipeline ETL (trích xuất, biến đổi, tải) riêng biệt nằm ở giữa. Các agent của bạn có thể làm việc với dữ liệu hiện tại, trong khi các mô hình của bạn có thể sử dụng kết quả trực tiếp thay vì chờ đợi một công việc xử lý hàng loạt (batch job). Các đội ngũ dữ liệu cũng giữ được quyền quản trị và dấu vết kiểm toán trong cùng một nền tảng, thay vì đẩy khối lượng công việc của agent vào một hệ thống riêng biệt khó theo dõi hơn. Unity Catalog là thứ thực thi lớp quản trị đó trên cả dữ liệu vận hành và phân tích trong Databricks. Trải nghiệm của Superhuman cho thấy điều này trong thực tế: việc thay thế các pipeline đồng bộ tùy chỉnh vào một lớp lưu trữ đệm và một kho NoSQL được quản lý bằng một nền tảng hợp nhất đã rút ngắn thời gian tích hợp dữ liệu từ gần ba tháng xuống còn khoảng hai tuần.
easyJet đã áp dụng cách tiếp cận tương tự trong stack quản lý doanh thu của mình. Kể từ khi chuyển sang Lakebase, hãng hàng không này đã nắm bắt được hoạt động đặt chỗ và định giá trực tiếp cùng với các phân tích trên cùng một dữ liệu lakehouse, hợp nhất hơn 100 kho lưu trữ Git thành hai, và rút ngắn chu kỳ phát triển ứng dụng từ sáu đến chín tháng xuống còn khoảng bốn tháng.
Lakebase giữ dữ liệu vận hành trong Databricks lakehouse, vì vậy cùng một dữ liệu có thể hỗ trợ các khối lượng công việc giao dịch và phân tích hạ nguồn mà không cần pipeline ETL riêng biệt.
Bảng điểm đánh giá cơ sở dữ liệu cho AI agent
Hãy chạy bất kỳ ứng viên nào qua năm bài kiểm tra này, và bạn sẽ biết trong vòng vài phút nơi nó đáp ứng được và nơi nó không đáp ứng được, bất kể bạn đang so sánh với nhà cung cấp nào.
Một cơ sở dữ liệu không vượt qua được nhiều hơn một trong các tiêu chuẩn tối thiểu này sẽ là một rủi ro cho môi trường production khi bạn chạy các agent ở quy mô lớn, chứ không chỉ là một sự đánh đổi nhỏ mà bạn có thể giải quyết sau này.
Tổng kết
Việc chọn cơ sở dữ liệu cho AI agent phụ thuộc vào sự phù hợp với khối lượng công việc, không phải danh sách tính năng. Năm tiêu chí trong hướng dẫn này cung cấp cho các nhà phát triển và đội ngũ dữ liệu một khung làm việc thực tế để đánh giá bất kỳ cơ sở dữ liệu nào trước khi cam kết sử dụng trong môi trường production. Nếu một ứng viên không thể đáp ứng các yêu cầu đó ngay hôm nay, các agent trong môi trường production cuối cùng sẽ bộc lộ những khoảng trống khi chúng đảm nhận nhiều người dùng hơn, nhiều tác vụ hơn và nhiều công việc đồng thời hơn.
Nếu bạn đang đánh giá cơ sở dữ liệu cho AI agent, hãy khám phá Lakebase để xem cách Databricks hỗ trợ các khối lượng công việc giao dịch, phân nhánh, mở rộng serverless, tìm kiếm kết hợp và truy cập hợp nhất vào dữ liệu vận hành.
Bài viết được AI dịch và tổng hợp tự động từ Databricks: Blog. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.