Thủ thuật
Giải mã Engram trên DeepSeek-V4.1-Flash: Tối ưu hóa bộ nhớ HBM bằng cách đẩy dữ liệu sang DRAM/SSD
(giờ Việt Nam)
Tóm tắt AI
SemiAnalysis phân tích kiến trúc Engram giúp DeepSeek-V4.1-Flash giảm tải bảng nhúng (embedding) sang DRAM hoặc SSD, từ đó tiết kiệm dung lượng HBM mà vẫn duy trì chất lượng mô hình.
Bản dịch AI
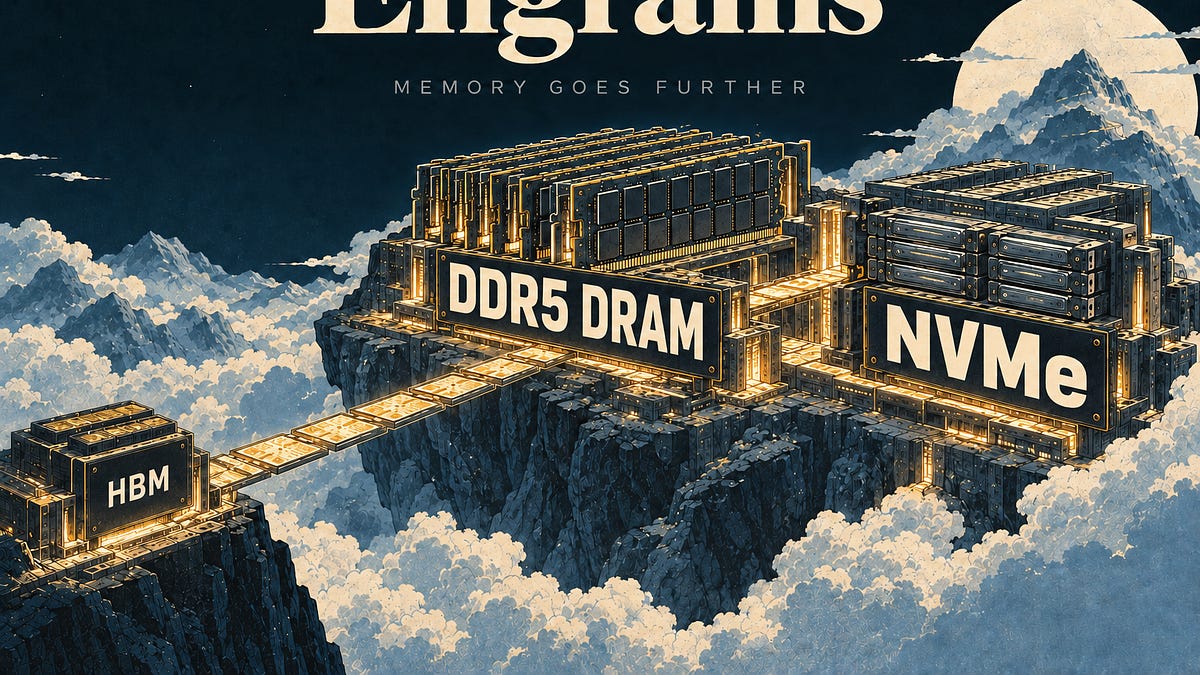
Engram mở rộng các embedding token tiêu chuẩn bằng các tra cứu đa token đã được học. Các mẫu cục bộ lặp lại sẽ truy xuất trực tiếp các vector, giúp giảm nhu cầu tái tạo chúng thông qua các lớp attention và feed-forward.
Với việc tối ưu hóa kiến trúc mô hình Engram, nó cho phép các mô hình có cùng chất lượng yêu cầu dung lượng HBM thấp hơn. Điều này không có nghĩa là nhu cầu về HBM sẽ không còn cao khủng khiếp, mà chỉ có nghĩa là kiến trúc mô hình sẽ tiếp tục đổi mới để thích nghi với các hạn chế.
Thiết kế kiến trúc mô hình này được đồng thiết kế một cách tự nhiên cho việc offloading tham số: mỗi token truy cập vào một vài hàng embedding có địa chỉ phụ thuộc vào ID token chứ không phải trạng thái ẩn (hidden states). Runtime có thể prefetch các hàng đó từ DRAM của máy chủ trong khi các lớp trước đó đang tính toán, giữ cho bảng nằm ngoài HBM mà không cần chuyển toàn bộ ma trận trọng số. Mô hình bộ nhớ của chúng tôi chứa các ước tính mới nhất về cung và cầu HBM, DRAM và NAND theo từng quý.
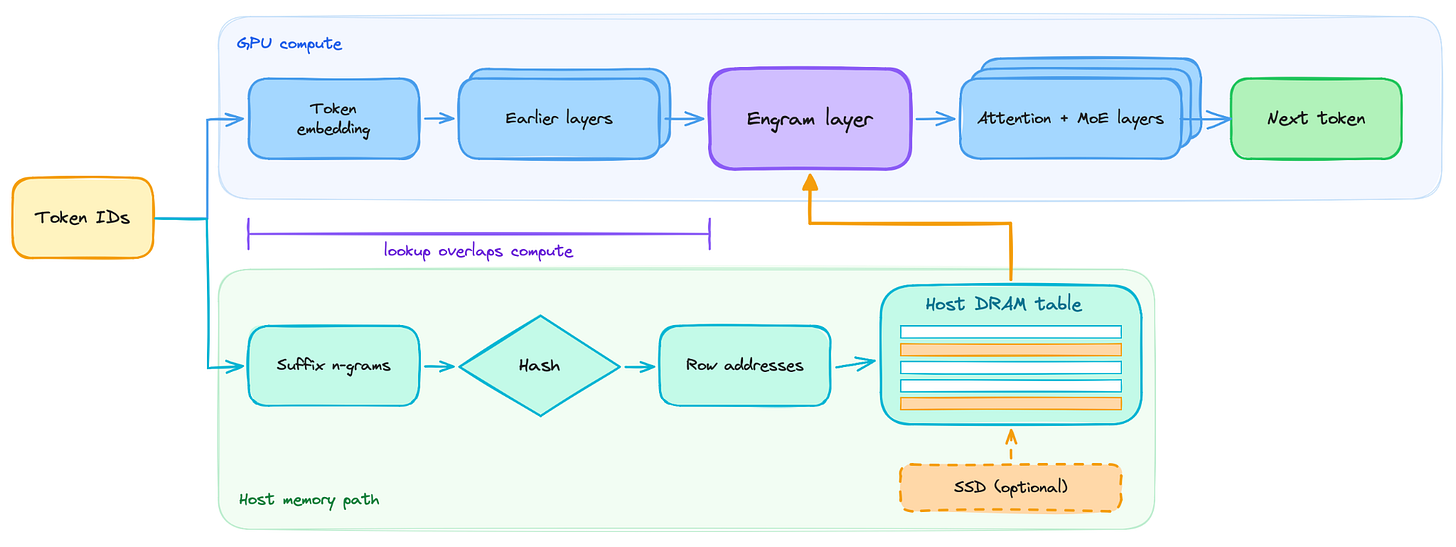
Offloading giải phóng HBM cho trọng số mô hình và KV cache, có khả năng hỗ trợ các batch lớn hơn hoặc nhiều phiên làm việc đồng thời hơn. Khi DRAM trở thành hạn chế tiếp theo, NVMe cung cấp một tầng lưu trữ khác. Các hệ thống gợi ý (recommendation systems) đã lưu trữ các hàng embedding được truy cập thường xuyên hoặc gần đây vào bộ nhớ nhanh hơn, trong khi các hàng ít được truy cập hơn được hỗ trợ bởi SSD. Sau khi lộ trình của NVIDIA phải thay đổi do cắt giảm mạnh thông số của Rubin Ultra từ 1024GB xuống còn khoảng 200GB HBM mỗi chip, các tối ưu hóa kiến trúc mô hình như Engram có thể sẽ hữu ích.
Cấu hình DeepSeek-V4.1-Flash của chúng tôi sử dụng khoảng 189 GiB bộ nhớ cho Engram. Chúng tôi thay thế nó bằng một tệp ánh xạ bộ nhớ (mmap) và đo lường hiệu suất phục vụ (serving performance) với việc offload sang SSD.
Sau đó trong báo cáo, chúng tôi sẽ trình bày các thí nghiệm offloading Engram cùng với kết quả phục vụ suy luận tác nhân (agentic inference serving) chính thức của InferenceX trên các mô hình Engram như DeepSeekv4.1 Flash trên tất cả 6 SKU GPU NVIDIA cùng với MI355X. Không có gì ngạc nhiên khi "CUDA Moat" vẫn đang vượt trội hơn hẳn MI355X trên mô hình DeepSeekV4.1 Flash cực kỳ phổ biến.
Chúng tôi cũng chỉ ra cách mà ngay cả trên các SKU HBM dung lượng cao, việc offload các Engram sang DRAM có thể mang lại hiệu suất tốt hơn cho hầu hết các trường hợp so với việc giữ Engram trong HBM.
Điểm chuẩn (benchmark) của chúng tôi đã được tái lập, xác thực và/hoặc hỗ trợ rộng rãi bởi hầu hết các bên mua tài nguyên tính toán lớn từ Google Cloud đến Microsoft Azure, Oracle, Meta và nhiều bên khác. Hơn nữa, nó còn nhận được sự hỗ trợ từ cộng đồng ML bao gồm vLLM, LMCache, SGLang, PyTorch, Huggingface và sự hỗ trợ từ các phòng thí nghiệm lớn như OpenAI, MiniMax, ZAI, Qwen, Moonshot Kimi, v.v.
Hãy gắn sao (star) cho kho lưu trữ InferenceX trên GitHub nếu bạn thấy điểm chuẩn và dữ liệu mã nguồn mở này hữu ích! InferenceX là điểm chuẩn suy luận duy nhất trên thế giới có TPUv7, Jalapeño, Nvidia Rubin NVL72, AMD và sắp tới là SambaNova và Trainium. Do kịch bản AgentX rất thực tế đối với các khối lượng công việc suy luận tác nhân trong thế giới thực, AMD cũng đã cam kết hợp tác trên MI455X UALoE72.
DeepSeek đã không phát hành hai mô hình Engram đã được huấn luyện trong bài báo gốc. Chúng tôi đã tái lập thiết lập của nó trên fineweb-edu bằng cách sử dụng mã nguồn và các siêu tham số huấn luyện đã được công bố, với ước tính 6E18 FLOPs mỗi lần chạy. Chúng tôi quan sát thấy cùng một kiểu mở rộng hình chữ U:
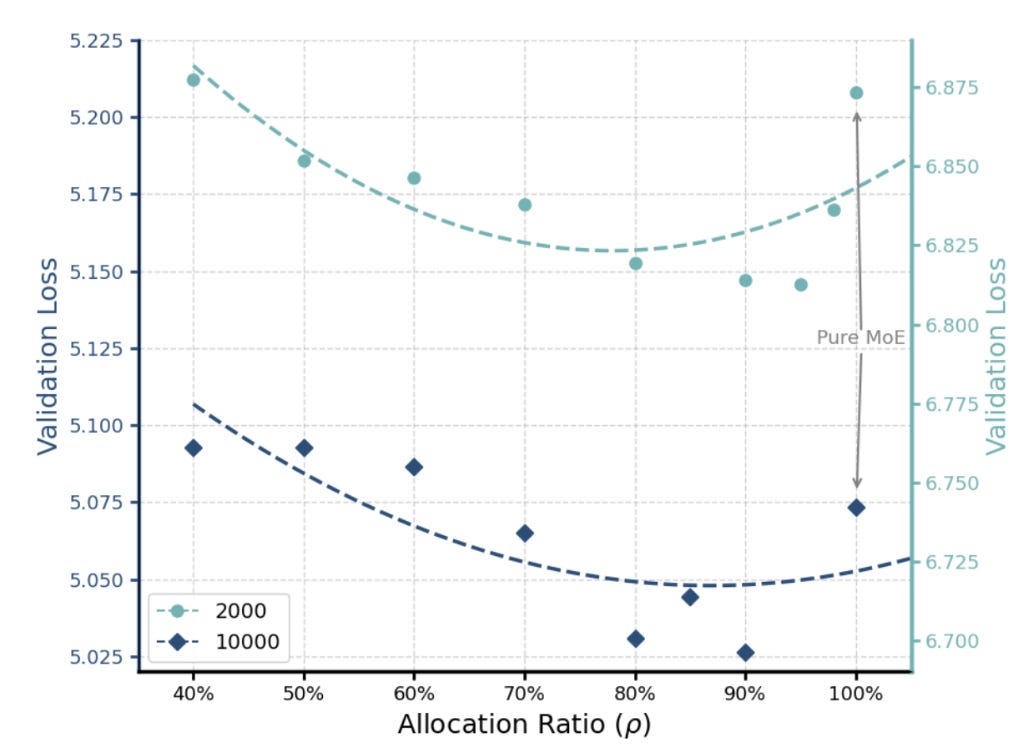
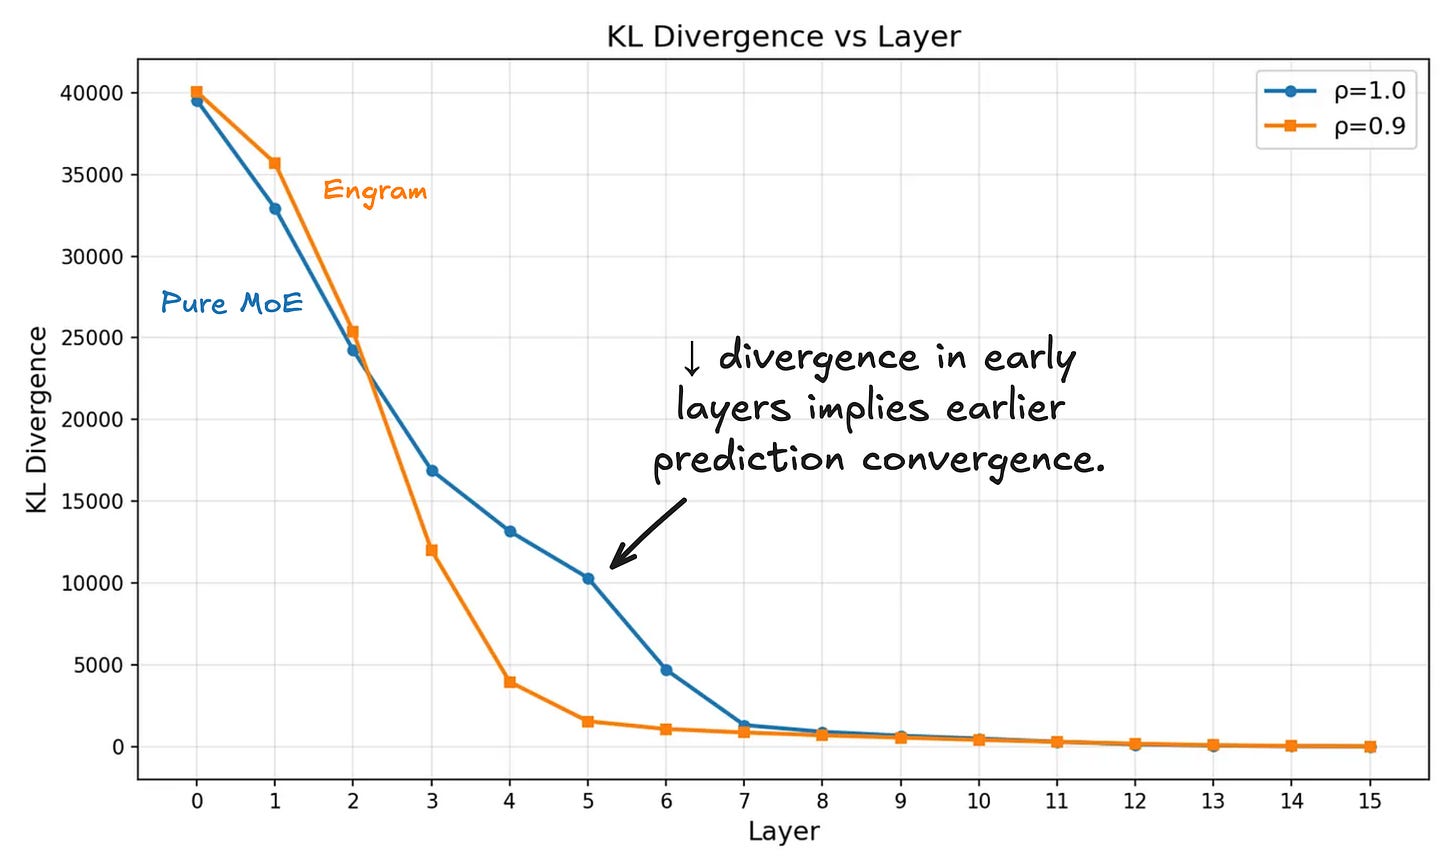
Engram đã cải thiện hiệu suất so với các mô hình MoE thuần túy. Chúng tôi cũng đã tái lập các kết quả của DeepSeek, trong đó các biểu diễn ở lớp trước với Engram giống với các lớp sau hơn.
Giống như bài báo Engram gốc, có thể thăm dò điểm cổng (gate scores) của Engram để xem DeepSeek-V4.1-Flash sử dụng n-gram nào nhiều nhất. Quét cổng của chúng tôi tìm thấy tên, đoạn mã, cụm từ quan hệ và các văn bản mẫu (boilerplate). Các ví dụ này ưu tiên tính thú vị hơn là độ mạnh của cổng.
Một kết quả bất ngờ là Wright: Ace Attorney.
Những ví dụ này cho thấy bộ nhớ đã học tối ưu hóa mục tiêu huấn luyện, chứ không phải là sự đánh giá xem dữ liệu nào xứng đáng được lưu trữ. Giấy phép, đoạn thư mục, khung API và các thành phần trang web có thể cung cấp các lối tắt dự đoán, vì vậy giá trị của dung lượng Engram bổ sung có thể phụ thuộc vào những gì còn sót lại sau quá trình chuẩn bị dữ liệu. Điều này không cho thấy dung lượng bảng bị "lãng phí": việc quét kho dữ liệu đánh giá không xác định được mức độ tiếp xúc trong huấn luyện hay dung lượng bị chiếm dụng bởi mỗi danh mục.
Đối với offloading, các cổng mạnh không xác định được các hàng "nóng" trong cache. Các cổng yếu cũng không tự động tiết kiệm lượt đọc: việc tính toán cổng đòi hỏi khóa đã truy xuất và làm mất đi lợi ích hiệu suất của kernel hợp nhất (fused kernel). Việc bỏ qua các lượt đọc sẽ đòi hỏi một bộ dự đoán tính hữu ích riêng biệt trước khi truy xuất.
Trong thử nghiệm cắt bỏ (ablation) tại thời điểm suy luận của bài báo gốc, các điểm chuẩn về kiến thức thực tế chỉ giữ lại 29–44% hiệu suất ban đầu, trong khi khả năng đọc hiểu giữ lại 81–93%. Điều này là do sự không khớp giữa huấn luyện và suy luận. Do đó, sự suy giảm kết quả đo lường sự phụ thuộc của mô hình đã huấn luyện này vào Engram, chứ không phải sự khác biệt hiệu suất giữa các mô hình được huấn luyện có và không có nó.
Trong các thử nghiệm cắt bỏ của chúng tôi, việc triệt tiêu Engram làm xấu đi khả năng dự đoán token trên tất cả các miền được đánh giá, đặc biệt là văn bản bách khoa toàn thư và một số kho dữ liệu mã nguồn. Đáng ngạc nhiên là độ chính xác của GSM8K vẫn nằm trong phạm vi biến thiên giữa các lần chạy và việc loại bỏ Engram không có tác dụng gì.
Engram không phải là một từ điển có thể tháo rời bên cạnh một MoE không thay đổi. Việc loại bỏ nó làm thay đổi các đặc trưng hạ nguồn và việc lựa chọn chuyên gia (expert selection).
Chúng tôi đã kiểm tra xem việc định tuyến lại (rerouting) gây hại hay bù đắp bằng cách giữ cố định các token trong một thí nghiệm teacher-forced trên CRUXEval, một điểm chuẩn suy luận mã nguồn gồm các hàm Python nhỏ, nơi mô hình dự đoán đầu ra của hàm từ mã nguồn và đầu vào, sau đó chấm điểm câu trả lời tham chiếu.
Việc loại bỏ Engram làm tăng mất mát câu trả lời từ 0,2848 lên 0,3093 bit/token. Việc buộc mô hình đã cắt bỏ phải sử dụng các lựa chọn chuyên gia Engram-on ban đầu còn làm cho kết quả tệ hơn, ở mức 0,3375 bit/token.
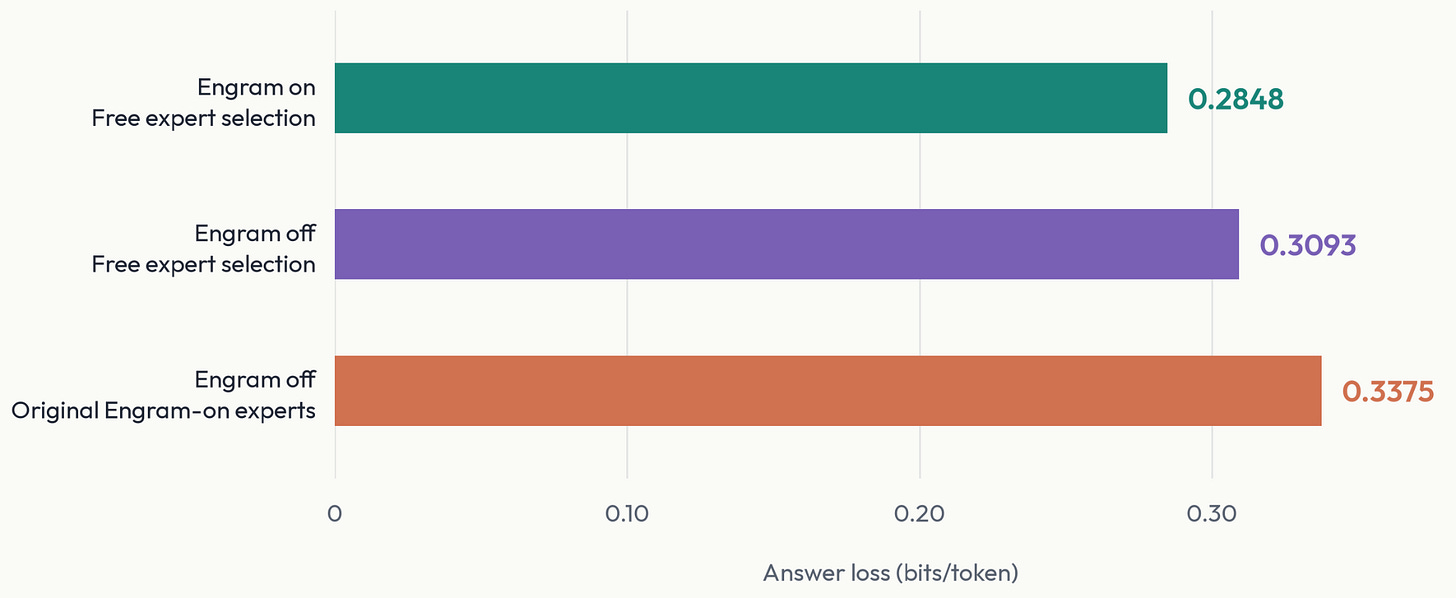
Định tuyến lại bù đắp một phần cho bộ nhớ bị thiếu. Các đặc trưng bộ nhớ và lựa chọn chuyên gia hoạt động cùng nhau, thay vì tuân theo sự phân chia rõ ràng "bộ nhớ lưu trữ sự thật; chuyên gia suy luận".
Trên cùng CRUXeval, việc loại bỏ Engram trong bất kỳ giai đoạn nào cũng làm giảm độ chính xác và tăng số lượng token được tạo ra; việc loại bỏ nó trong toàn bộ quá trình tạo ra những thay đổi lớn nhất.
Giữ Engram cho giai đoạn prefill dẫn đến nhiều câu trả lời đúng hơn so với giữ cho giai đoạn decode, có khả năng là do KV cache giàu ngữ nghĩa hơn được chuyển đến các worker decode, cho phép nó giảm thiểu một phần sự sụt giảm hiệu suất.
Bảng của Engram rất lớn, nhưng mỗi lần tra cứu lại nhỏ. DeepSeek-V4.1-Flash yêu cầu 24 hàng tại mỗi lớp trong hai lớp Engram, khoảng 12,4 KiB cho mỗi vị trí token được xử lý trên toàn bộ mô hình, hoặc 3,1 KiB mỗi GPU khi chia trên bốn GPU.
Hiện tại, tính đến ngày thứ 7 kể từ khi phát hành mô hình, MI355X vẫn có hiệu suất trên mỗi đô la kém hơn 2-4 lần so với B200 ngay cả khi đã chuẩn hóa theo TCO thấp hơn của MI355X. Phân tích chi phí sở hữu toàn diện (TCO) của chúng tôi đến từ Mô hình TCO AI Cloud của chúng tôi cùng với các khảo sát thị trường hàng tháng của hơn 100+ đám mây GPU và khách hàng đám mây GPU.
Vào ngày phát hành DeepSeekv4.1 Flash, NVIDIA vLLM hoạt động ngay lập tức mà không gặp vấn đề gì trên tất cả 6 SKU: H100, H200, B200, B300, GB200, GB300! Điều này là nhờ công việc tuyệt vời của các đội ngũ NVIDIA & Interact! Ngược lại, AMD vLLM đã không hoạt động vào ngày đầu tiên cho DeepSeekv4.1 Flash. Nguồn: SemiAnalysis InferenceX
Tài liệu vLLM của AMD chỉ ra việc sử dụng vllm/vllm-openai-rocm:deepseekv41-flash-0909, nhưng từ giờ thứ 0 đến giờ thứ 23 sau khi phát hành mô hình, AMD vẫn chưa công khai hình ảnh (image) đó. AMD tuyên bố "TỐC ĐỘ LÀ CON HÀO KINH TẾ" (SPEED IS THE MOAT), nhưng họ vẫn chưa phát hành nó vào giờ thứ 23. Chúng tôi hy vọng rằng trong tương lai, đội ngũ AMD sẽ có quy trình tốt hơn cho việc phát hành mô hình vào giờ thứ 0.
Cuối cùng khi họ công khai hỗ trợ hình ảnh cho "ngày 0", về mặt hiệu suất, nó hiện kém hơn tới 14,8 lần về hiệu suất trên mỗi đô la so với H200 và kém hơn tới 42 lần so với B200/B300.
Sức mạnh của CUDA MOAT chính là sự hợp tác của NVIDIA với hệ sinh thái cộng đồng 6 triệu nhà phát triển khổng lồ của họ, bao gồm hầu hết những người bảo trì vLLM, SGLang và Tokenspeed, điều này có nghĩa là CUDA được tối ưu hóa ngay từ ngày đầu tiên.
Nhìn chung, AMD đã có những cải tiến đáng kể nhưng hiệu suất trên mỗi đô la hiện vẫn kém hơn 2-4 lần so với B200.
Việc offload HBM và DRAM sử dụng cùng một GPU kernel để chọn và giải lượng tử (dequantize) các hàng. Với HBM, nó đọc bộ nhớ GPU; với Unified Virtual Addressing (UVA), nó đọc trực tiếp bộ nhớ máy chủ đã được ghim (pinned host memory).
Cả hai đều hỗ trợ các biểu đồ giải mã (decode graphs) đầy đủ. Việc di chuyển bảng vào HBM chỉ tăng tốc tra cứu thưa (sparse lookup), để lại các tính toán và giao tiếp của bộ giải mã không thay đổi, dẫn đến ít lợi ích tổng thể trong khi tiêu tốn bộ nhớ vốn có thể dành cho KV cache.
Một lợi ích khác của việc offload Engram sang DRAM là bạn có thể giảm chi phí giao tiếp bằng cách sử dụng ít GPU HBM hơn cho mỗi bản sao (replica). Ví dụ, khi bật offloading Engram trên B300, chúng tôi có thể chuyển từ TP4 sang TP2, giúp cải thiện đường cong pareto lên tới 1,6 lần.
Khi chất lượng mô hình tương đương, cần ít HBM hơn vì các Engram có thể được offload sang DRAM máy chủ. Do đó, băng thông HBM quan trọng hơn nhiều so với dung lượng HBM. Đối với các khối lượng công việc suy luận mà băng thông bộ nhớ quan trọng nhất, HBM 4-hi cung cấp tỷ lệ $/băng thông tốt nhất và do đó chi phí thấp nhất trên mỗi token. Nếu Trung Quốc tiếp tục tạo ra ngày càng nhiều đổi mới kiến trúc mô hình mang tính cách mạng, sớm thôi, họ có thể đạt tới các stack HBM 0-hi.
Bài viết được AI dịch và tổng hợp tự động từ SemiAnalysis RSS. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.