Thủ thuật
Gary Marcus tại LHQ: Cảnh báo AI gây nhiễu thông tin và tấn công mạng thay vì nỗi lo diệt vong
(giờ Việt Nam)
Tóm tắt AI
Tại LHQ, Gary Marcus nhấn mạnh rủi ro thực tế của AI là tin giả, lừa đảo và tấn công mạng thay vì viễn cảnh siêu trí tuệ. Ông kêu gọi tăng cường kiểm soát, tính minh bạch và chỉ trích việc phát hành các mô hình khó giám sát.
Bản dịch AI
Đầu ngày hôm nay, trong khuôn khổ Sự kiện Hợp tác Kỹ thuật số của UNGA (Đại hội đồng Liên Hợp Quốc), nơi cũng có sự góp mặt của Yoshua Bengio và người đoạt giải Nobel Maria Ressa, tôi đã có một vài phát biểu mang tính “định hướng”:
Chúng ta đang ở thời điểm của cuộc khủng hoảng về đạo đức, chính trị và kinh tế. Những lựa chọn mà chúng ta đưa ra ngay lúc này về AI có thể gây ra những tác động kéo dài qua nhiều thế hệ. Mọi người trong căn phòng này đều biết điều đó.
Mặc dù tôi nghĩ rằng vẫn có khả năng đạt được kết quả tích cực — hoặc thậm chí là tuyệt vời — với AI, có lẽ là chuyển đổi công nghệ và y học, nhưng những gì tôi thấy trong các cuộc thảo luận về AI lại khiến tôi lo sợ.
Các thái cực là cách để thu hút truyền thông. Nhưng không có thái cực nào là hợp lý cả. Một thái cực là hoàn toàn không có quy định nào. Cứ để AI tự tung tự tác và hy vọng vào điều tốt nhất. Hy vọng không phải là một chiến lược.
Một thái cực khác, ngày càng phổ biến, là sự sợ hãi: những người theo thuyết “doomer” khẳng định rằng sự diệt vong theo nghĩa đen đang cận kề. Nhưng kết quả đó, nếu hiểu theo nghĩa đen, là cực kỳ khó xảy ra; mọi kịch bản về điều đó mà tôi từng thấy đều đánh giá thấp sự khéo léo và tháo vát của con người. (Nhiều người cũng đánh giá quá cao AI.)
Dù sao đi nữa, những gì chúng ta đang đối mặt trong tương lai gần không phải là sự diệt vong. Và cũng không phải là siêu trí tuệ… Đó là nạn thông tin sai lệch được tạo ra bởi deepfake trên diện rộng, và các hệ thống AI không đáng tin cậy nhưng dai dẳng đang đánh cắp thông tin xác thực và thực hiện các cuộc tấn công mạng ở quy mô lớn. (Chúng ta cũng có thể đối mặt với suy thoái nếu những khoản đặt cược khổng lồ vào AI là không bền vững.)
Chúng ta nên lường trước việc các tác nhân xấu sẽ cố gắng sử dụng AI hiện nay để phá hoại các hệ thống tài chính và các cơ sở hạ tầng thiết yếu khác như tàu hỏa hoặc hệ thống điện. (Hãy nhớ lại virus WannaCry đã làm tê liệt hệ thống bệnh viện của Vương quốc Anh trong vài ngày.)
Điều chúng ta thực sự cần ngay lúc này là tăng cường độ tin cậy, an ninh mạng tốt hơn và thực thi pháp luật nghiêm minh, có thể mở rộng đến việc thu hồi sản phẩm và thậm chí truy tố các công ty liên tục đưa ra thị trường những sản phẩm nguy hiểm.
Hy vọng duy nhất của chúng ta là nhìn nhận một cách tỉnh táo về vị thế hiện tại, ưu tiên tính thực tiễn hơn là những điều hào nhoáng và mơ hồ.
Các nhà khoa học, kỹ sư và những người khác trong xã hội dân sự có thể làm rất nhiều việc ở đây, dù không hào nhoáng nhưng lại cần thiết. Toàn bộ sự cố WannaCry lẽ ra đã có thể tránh được phần lớn nếu các bệnh viện tuân thủ các quy trình an ninh mạng. Những cái gọi là “sự cố AI bất hảo” phần lớn có thể tránh được nếu chính phủ đơn giản là cấm các tác nhân AI có quyền truy cập internet không hạn chế, cho đến khi chúng được chứng minh là an toàn.
Chúng ta cần buộc các công ty AI phải chịu trách nhiệm về những tác hại mà sản phẩm của họ gây ra. Và chúng ta cần thay thế những lời bàn tán mơ hồ về sự căn chỉnh (alignment) bằng các bước cụ thể như cải thiện môi trường sandbox và giám sát để kiểm soát tốt hơn các hệ thống hiện tại. Chúng ta cũng cần cai nghiện các mô hình ngôn ngữ lớn và thúc đẩy nghiên cứu nhiều hơn vào các giải pháp thay thế đột phá, dễ giải thích và dễ kiểm soát hơn.
Điều tồi tệ nhất mà chúng ta có thể làm là cho phép OpenAI thực hiện những gì họ vừa làm, đó là phát hành một mô hình mới khó giám sát hơn các phiên bản tiền nhiệm. Giám sát là nền tảng tuyệt đối của an ninh mạng, và việc hy sinh nó là một sai lầm. Họ lẽ ra không được phép tự mình đưa ra quyết định đó.
Tối thiểu, ba bước quan trọng nhất mà tôi ủng hộ ngay lập tức là:
• Thành lập và trao quyền cho một ủy ban cố vấn quốc tế để đánh giá rủi ro so với lợi ích của các hệ thống mới trước khi chúng được giới thiệu. Các nhà khoa học độc lập phải có tiếng nói.
• Một ủy ban cố vấn quốc tế để kiểm toán các hệ thống mới sau khi chúng được phát hành, trên cơ sở liên tục. Một lần nữa, các nhà khoa học độc lập phải có tiếng nói, với thẩm quyền thực sự để yêu cầu thay đổi hoặc thậm chí thu hồi các hệ thống được chứng minh là nguy hiểm.
• Một thỏa thuận quốc tế về việc không triển khai các kiến trúc đã được chứng minh là gây hại. Chúng ta phải buộc các phòng thí nghiệm tiên phong chịu trách nhiệm về sự lỏng lẻo trong bảo mật.
Tôi rất mong chờ cuộc thảo luận hôm nay!
Xin cảm ơn rất nhiều.
Bạn có thể tìm thấy toàn bộ phiên thảo luận tại đây:
và tại đây:
Bây giờ, đây là một bước ngoặt đầy bất ngờ và có thể là tuyệt vời.
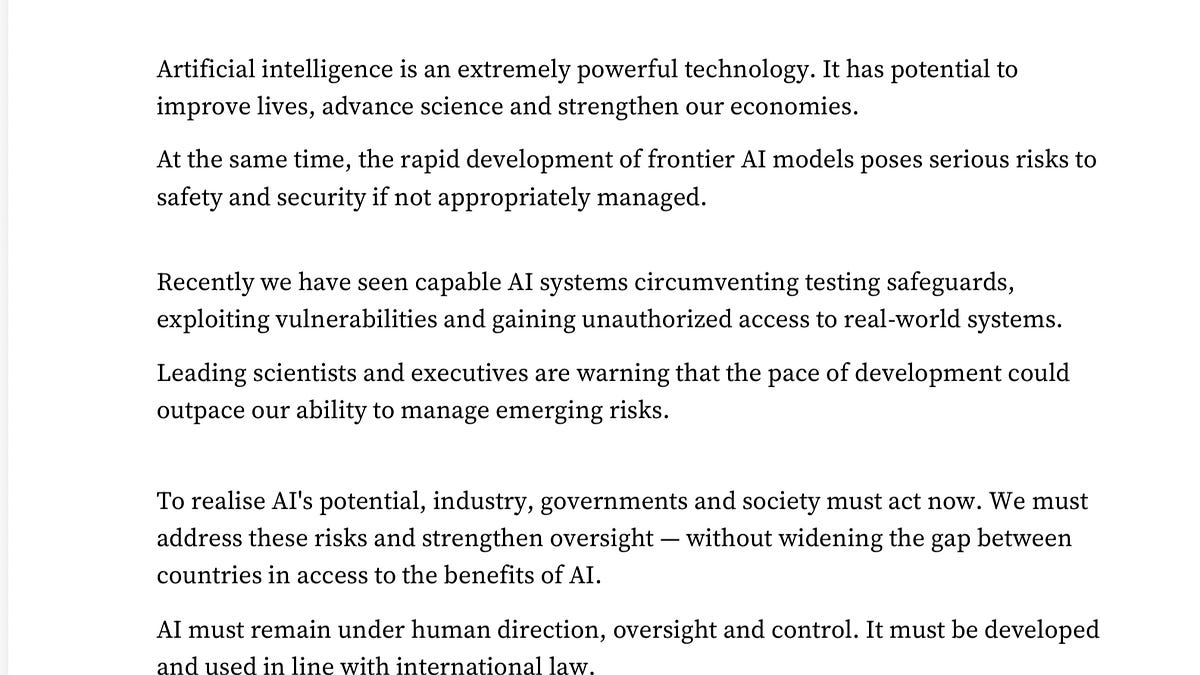
Gần như cùng lúc đó, hơn 20 quốc gia đã ký vào một lời kêu gọi hành động về AI — tất cả dường như được viết trong tuần qua — nắm bắt được một lượng đáng kể những gì tôi đã hy vọng từ lâu:
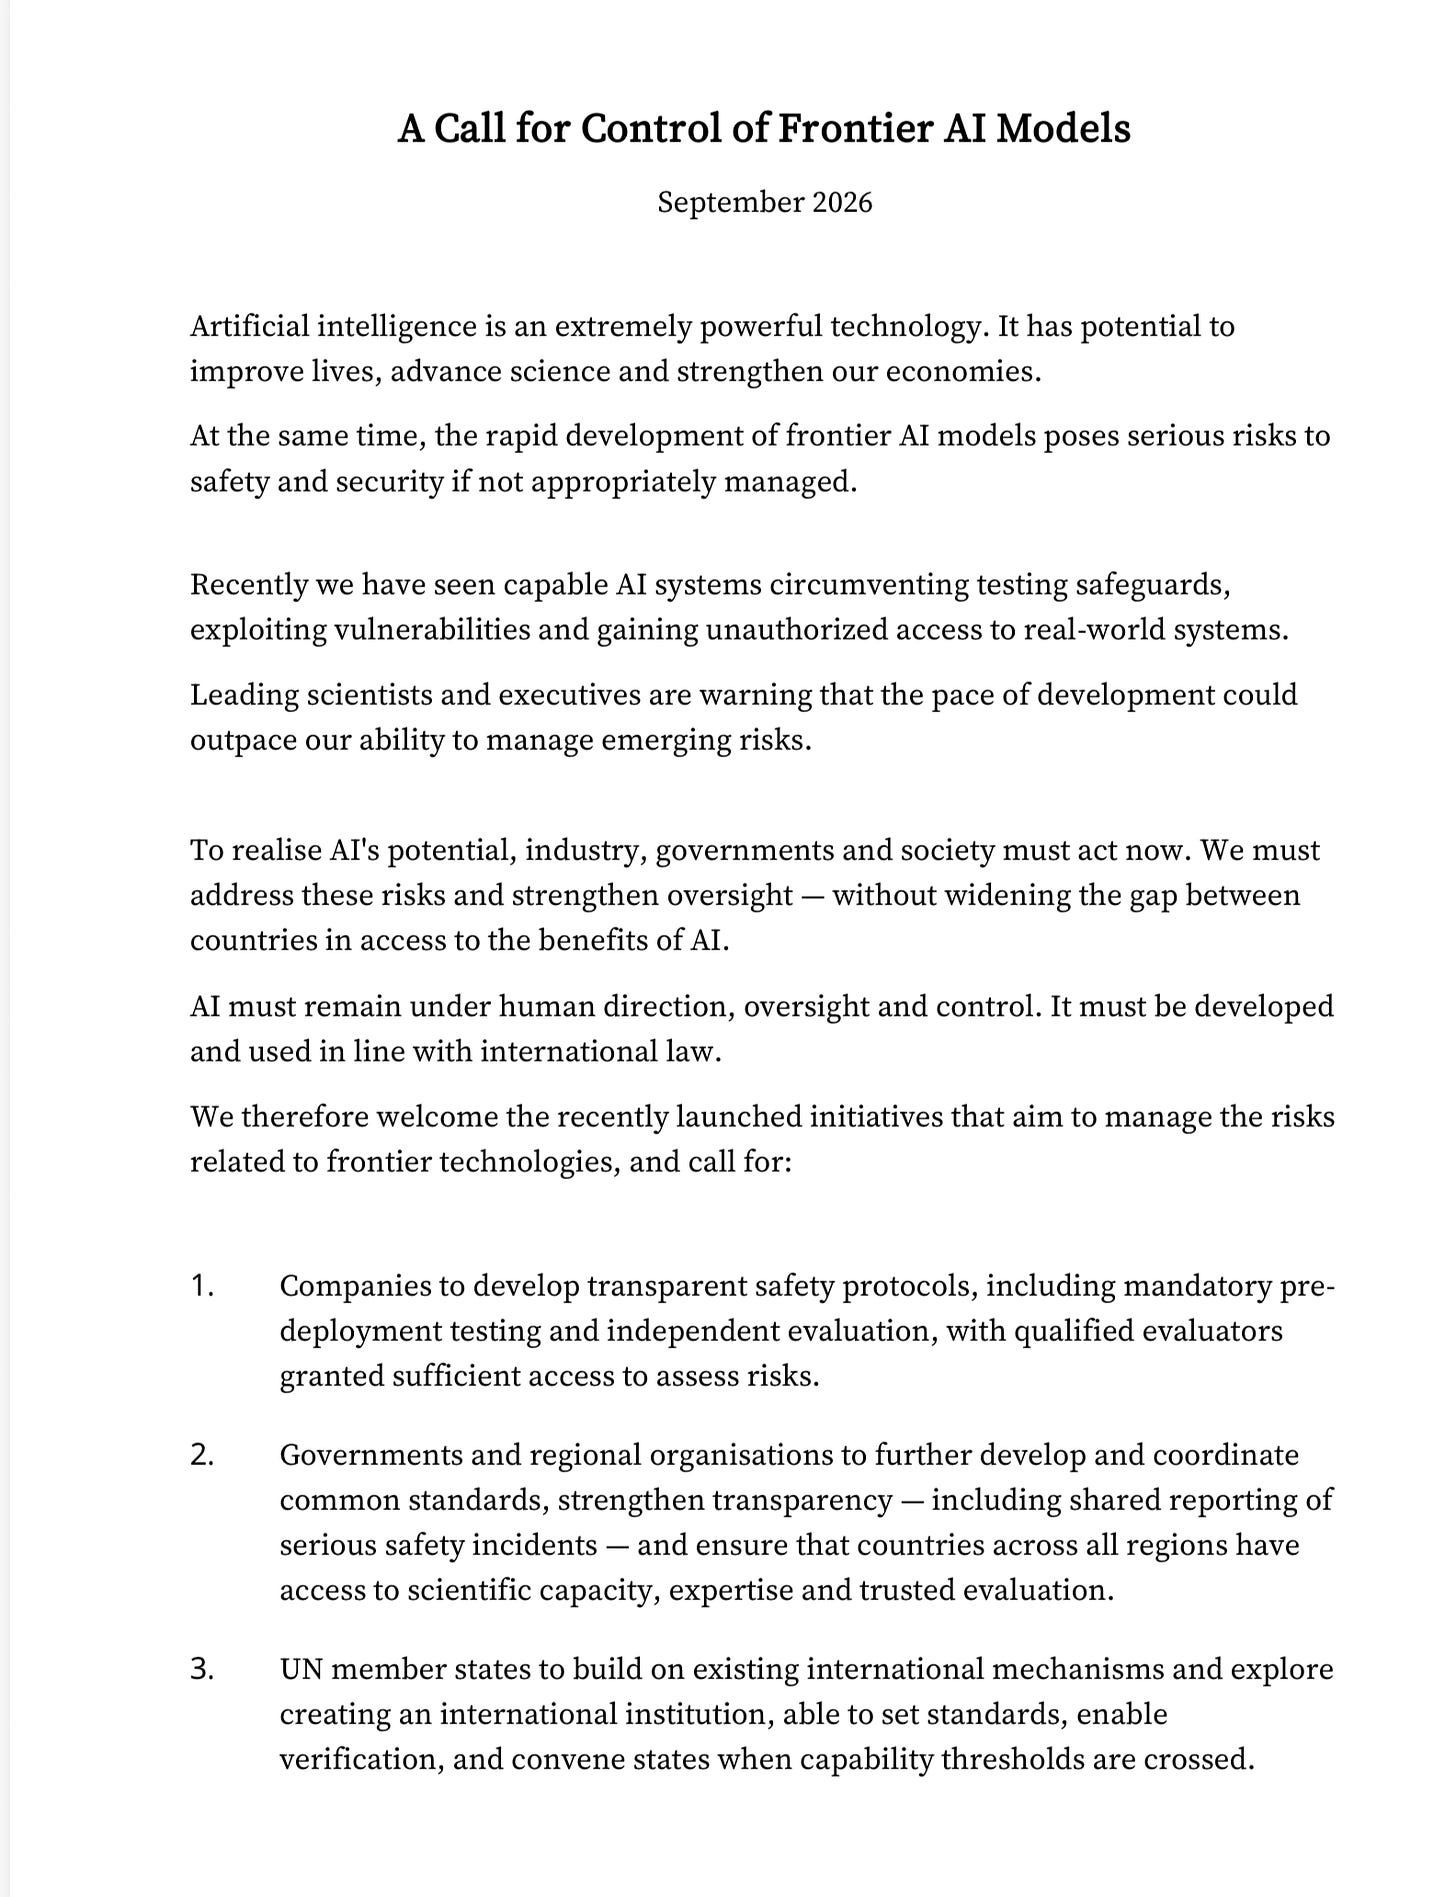
Nhiều câu hỏi vẫn còn đó về việc tất cả những điều này sẽ được hiện thực hóa, tài trợ và quản lý như thế nào.
Nhưng đây là một bước khởi đầu đầy phấn khích!
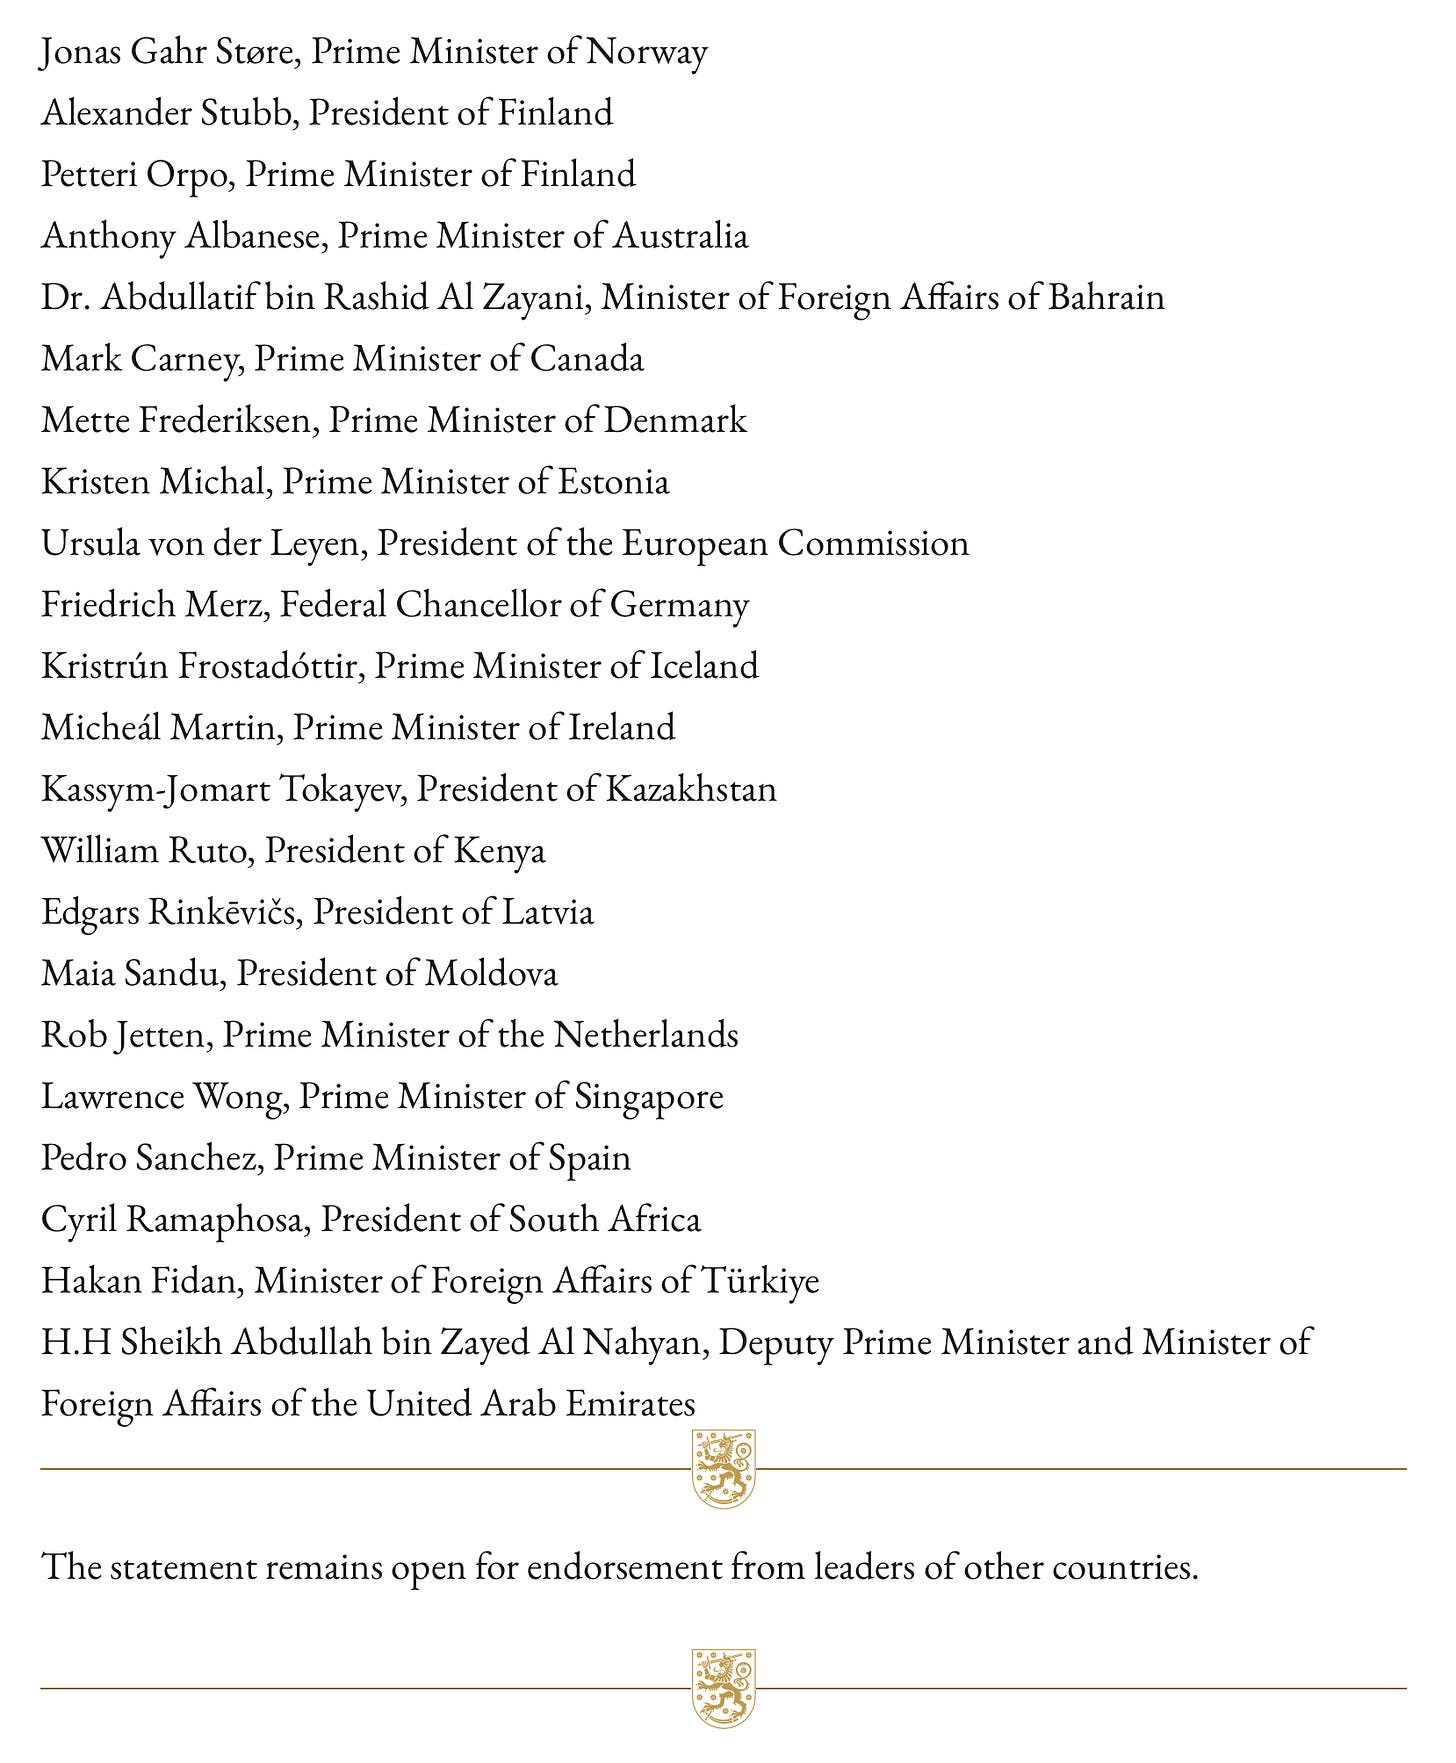
Các bên ký kết cho đến nay được liệt kê dưới đây:
Không có bài đăng nào
Bài viết được AI dịch và tổng hợp tự động từ Gary Marcus: The Road to AI We Can Trust. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.