Tin ngành
LangSmith ra mắt tính năng đánh giá tự động Jev-as-a-Judge
(giờ Việt Nam)
Tóm tắt AI
LangSmith vừa tích hợp Jev vào quy trình đánh giá, cho phép phản hồi có cấu trúc cho các tác nhân AI với chi phí thấp và tốc độ xử lý nhanh hơn trong môi trường sản xuất.
Bản dịch AI
Jev hiện đã có sẵn dưới vai trò giám khảo (judge) để đánh giá trong LangSmith. Jev cung cấp cho các đội ngũ một phương thức nhanh chóng, chi phí thấp để đánh giá hành vi của các agent mở (open-ended) và chuyển đổi kết quả thành phản hồi có cấu trúc mà họ có thể theo dõi trong LangSmith.
Dưới đây, chúng tôi giải thích lý do tại sao một mô hình System One như Jev lại hữu ích cho việc đánh giá agent, chia sẻ những gì chúng tôi tìm thấy khi thử nghiệm nó, và hướng dẫn cách thiết lập trình đánh giá Jev-as-a-judge cho các đánh giá trực tuyến (online evals).
Hãy thử nghiệm Jev-as-a-judge trong LangSmith ngay hôm nay bằng cách truy cập tab Evaluators trong bất kỳ dự án tracing nào.
Lược sử về đánh giá agent
Quay lại năm 2023 khi chúng tôi bắt đầu xây dựng các agent (thời điểm đó chúng tôi chủ yếu gọi là các ứng dụng LLM), phương pháp đánh giá chính là dựa trên mã nguồn (code-based). Cuối năm đó, các nhà nghiên cứu đã giới thiệu LLM-as-a-judge, và kể từ đó, code-based và LLM-as-a-judge đã trở thành hai cách chính để đánh giá agent.
Các trình đánh giá dựa trên mã nguồn kiểm tra các điều kiện cụ thể, có tính xác định: Agent có gọi công cụ không? Đầu ra có khớp với một mẫu không? Một trường dữ liệu có tồn tại không? Cách này nhanh và đáng tin cậy, nhưng nó chỉ bao phủ một phần nhỏ hành vi của agent mà bạn có thể xác định đầy đủ trước khi agent chạy. Vì các agent có tính không xác định, một agent giải quyết cùng một vấn đề theo ba cách hợp lệ khác nhau sẽ thất bại trước một bài kiểm tra dựa trên mã nguồn vốn chỉ mong đợi một trong số đó.
Các trình đánh giá LLM-as-a-judge lấp đầy khoảng trống đó. Bạn cung cấp cho một giám khảo LLM một bản ghi (trace) của agent, cùng với các hướng dẫn và thang điểm để chấm, và nó sẽ suy luận thông qua bản ghi đó bằng văn bản tự do trước khi đưa ra phán quyết. Tuy nhiên, sự linh hoạt đó phải trả giá. Các trình đánh giá LLM-as-a-judge chậm hơn và tốn kém hơn khi chạy so với một lệnh gọi hàm (function call), và vì chúng có tính không xác định, cùng một đầu vào có thể tạo ra các phán quyết khác nhau giữa các lần chạy. Hơn nữa, bước chuyển đổi văn bản tự do thành đầu ra có cấu trúc bản thân nó đã là một nguồn gây lỗi, độc lập với việc suy luận của giám khảo có đúng hay không.
Giờ đây, các mô hình System One như Jev giới thiệu loại hình đánh giá agent thứ ba, một loại hình đánh đổi một phần tốc độ của đánh giá dựa trên mã nguồn để lấy sự linh hoạt trong việc đánh giá hành vi agent mở, với chi phí chỉ bằng một phần nhỏ so với giám khảo LLM.
Jev là gì?
Jev không phải là một LLM truyền thống và không tạo ra văn bản. Đội ngũ TypeSafe AI gọi nó là một mô hình System One:
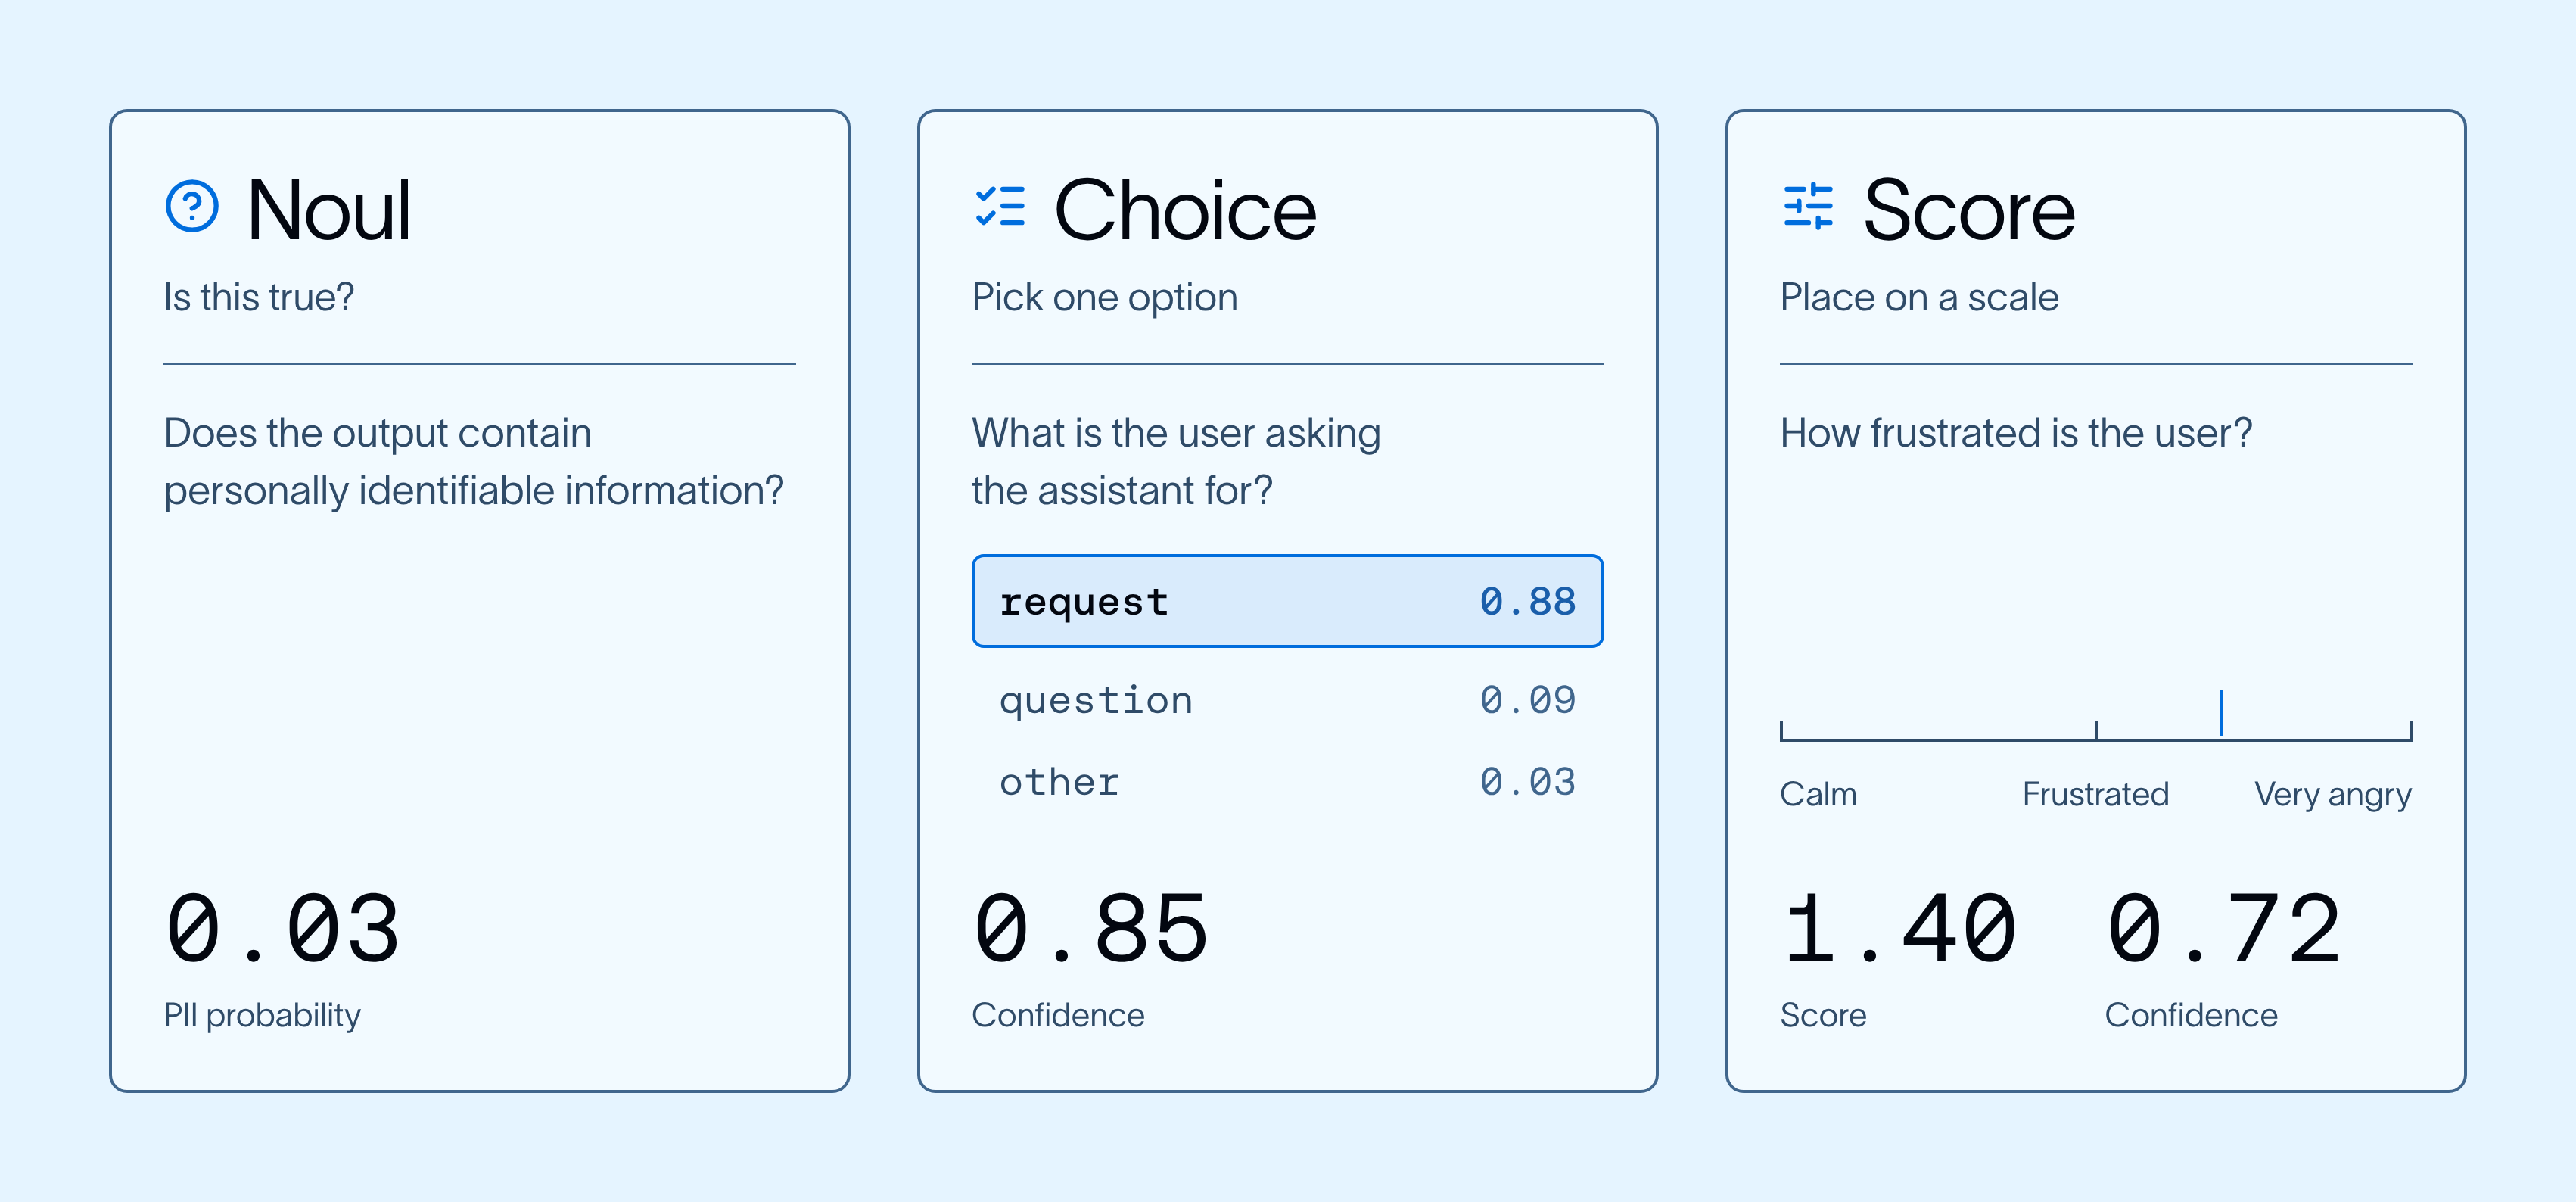
Đối với việc đánh giá, trạng thái (state) có thể là một bản ghi agent, một tin nhắn đơn lẻ, hoặc bất kỳ ngữ cảnh nào khác mà bạn muốn đánh giá. Các câu hỏi xác định tiêu chí mà bạn muốn đánh giá trạng thái đó, chẳng hạn như liệu phản hồi có làm lộ thông tin PII không, ý định của người dùng là gì, hoặc người dùng có vẻ thất vọng như thế nào. Jev có thể trả lời ba loại câu hỏi: (1) một câu hỏi nhị phân (noul) trả về xác suất có/không, (2) một lựa chọn chọn một phương án từ một tập hợp, và (3) một điểm số đánh giá trạng thái trên một thang đo có thứ tự. Mỗi câu trả lời đều được định kiểu (typed), thay vì một khối văn bản được tạo ra rồi mới chuyển đổi thành đầu ra có cấu trúc.
Tại sao Jev lại thú vị đối với việc đánh giá agent?
Ba đặc điểm của Jev liên quan trực tiếp đến các điểm đau (pain points) trong đánh giá agent. Theo TypeSafe AI, Jev rẻ hơn tới ~450 lần và nhanh hơn tới ~200 lần so với các LLM tương đương trong các tác vụ phân loại, và nó có thể đánh giá nhiều câu hỏi về cùng một trạng thái song song.
Chi phí là lý do phổ biến khiến các đội ngũ đánh giá agent ít hơn mức họ muốn. Mỗi lần đánh giá đều đi kèm với sự đánh đổi: chấm điểm nhiều lần chạy agent hơn, đánh giá nhiều tiêu chí hơn, hoặc kiểm tra nhiều thay đổi hơn, và chi phí kiểm tra tăng tỷ lệ thuận. Với nhiều agent và lưu lượng sử dụng lớn, một giám khảo LLM tốn vài xu cho mỗi lần đánh giá sẽ nhanh chóng trở nên đắt đỏ khi áp dụng trên lưu lượng sản xuất, các tập dữ liệu lớn, và các bài kiểm tra hồi quy cho mỗi thay đổi về mô hình hoặc prompt. Các đội ngũ cuối cùng phải thực hiện ít đánh giá hơn để quản lý chi phí, điều này làm chậm vòng lặp phản hồi vốn là yếu tố then chốt để xây dựng các agent tuyệt vời. Với chi phí chỉ bằng một phần nhỏ, một giám khảo Jev có thể loại bỏ sự đánh đổi đó.
Với Jev-as-a-judge, bạn có thể chấm điểm mọi bản ghi thay vì chỉ lấy mẫu, kiểm tra nhiều tiêu chí hơn trên mỗi bản ghi, và chạy cùng một phán quyết nhiều lần để xem giám khảo nhất quán đến mức nào. Giám khảo càng rẻ, bạn càng có khả năng đánh giá nhiều hành vi của agent hơn, và vòng lặp cải thiện agent đó càng trở nên chặt chẽ.
Tốc độ rất quan trọng đối với các đánh giá trực tuyến, nơi giám khảo đang chấm điểm lưu lượng truy cập trực tiếp. Với tốc độ nhanh hơn tới ~200 lần so với giám khảo LLM, giám khảo Jev giỏi hơn trong việc bắt kịp lưu lượng truy cập khi nó đến. Điều này quan trọng nhất đối với các khóa phản hồi (feedback keys) cảnh báo về rủi ro bảo mật hoặc an toàn, như rò rỉ PII, tấn công prompt (prompt injection), hoặc nội dung độc hại, nơi bạn có thể đặt cảnh báo trên khóa phản hồi để kích hoạt webhook nhằm tự động hóa phản hồi. Giám khảo càng nhanh, khoảng thời gian từ khi có sự cố xảy ra đến khi được xử lý càng ngắn.
Khả năng song song hóa thay đổi số lượng tiêu chí bạn có thể đánh giá trên một bản ghi agent duy nhất. Jev đánh giá mọi câu hỏi trong một yêu cầu cùng lúc, vì vậy việc chấm điểm một bản ghi dựa trên nhiều khóa phản hồi, chẳng hạn như rò rỉ PII, ý định người dùng, và sự thất vọng của người dùng, chỉ tốn kém hơn một chút so với việc chấm điểm dựa trên một khóa duy nhất.
Ngược lại, một giám khảo LLM cần một lệnh gọi riêng cho mỗi tiêu chí hoặc phải suy luận qua tất cả chúng một cách tuần tự trong một prompt với số lượng token đầu ra tăng dần theo số lượng tiêu chí.
Các mô hình System One giải quyết tốt các điểm đau này, nhưng không có nghĩa là giám khảo LLM trở nên lỗi thời. Các mô hình đã tinh chỉnh (fine-tuned) và mô hình mở có thể là những giám khảo hiệu quả với chi phí thấp hơn nhiều so với một mô hình tiên phong (frontier model), và đối với các tiêu chí mở nơi bạn muốn có lập luận bằng văn bản đi kèm với phán quyết, giám khảo LLM vẫn là công cụ tốt hơn. Jev phù hợp khi quyết định bạn cần là hẹp và có định kiểu, và bạn đang thực hiện nó với khối lượng lớn.
Jev-as-a-judge có thực sự hiệu quả không?
Chúng tôi đã đưa Jev vào thử nghiệm trong bài kiểm tra "Jev-as-a-Judge for Agent Evals", so sánh nó với GPT-5.6 Luna, GPT-5.6 Terra, và Claude Sonnet 4.6 về độ chính xác, tính nhất quán, tốc độ, và chi phí. Jev chính xác hơn, nhất quán hơn đáng kể, đồng thời nhanh hơn và rẻ hơn so với các giám khảo LLM.
Jev khớp với kết quả của người đánh giá là con người trong mọi quyết định, với độ biến thiên thấp hơn 92-913 lần so với các giám khảo LLM. Nó đạt trung bình 0,44 giây mỗi lần gọi, so với 2,16-2,83 giây của các giám khảo LLM. Với mức giá 0,00035 USD mỗi lần gọi, việc chạy toàn bộ tập hợp các phán quyết tốn 0,34 USD với Jev, so với 0,39 USD với GPT-5.6 Luna, 2,90 USD với GPT-5.6 Terra, và 28,17 USD với Claude Sonnet 4.6.
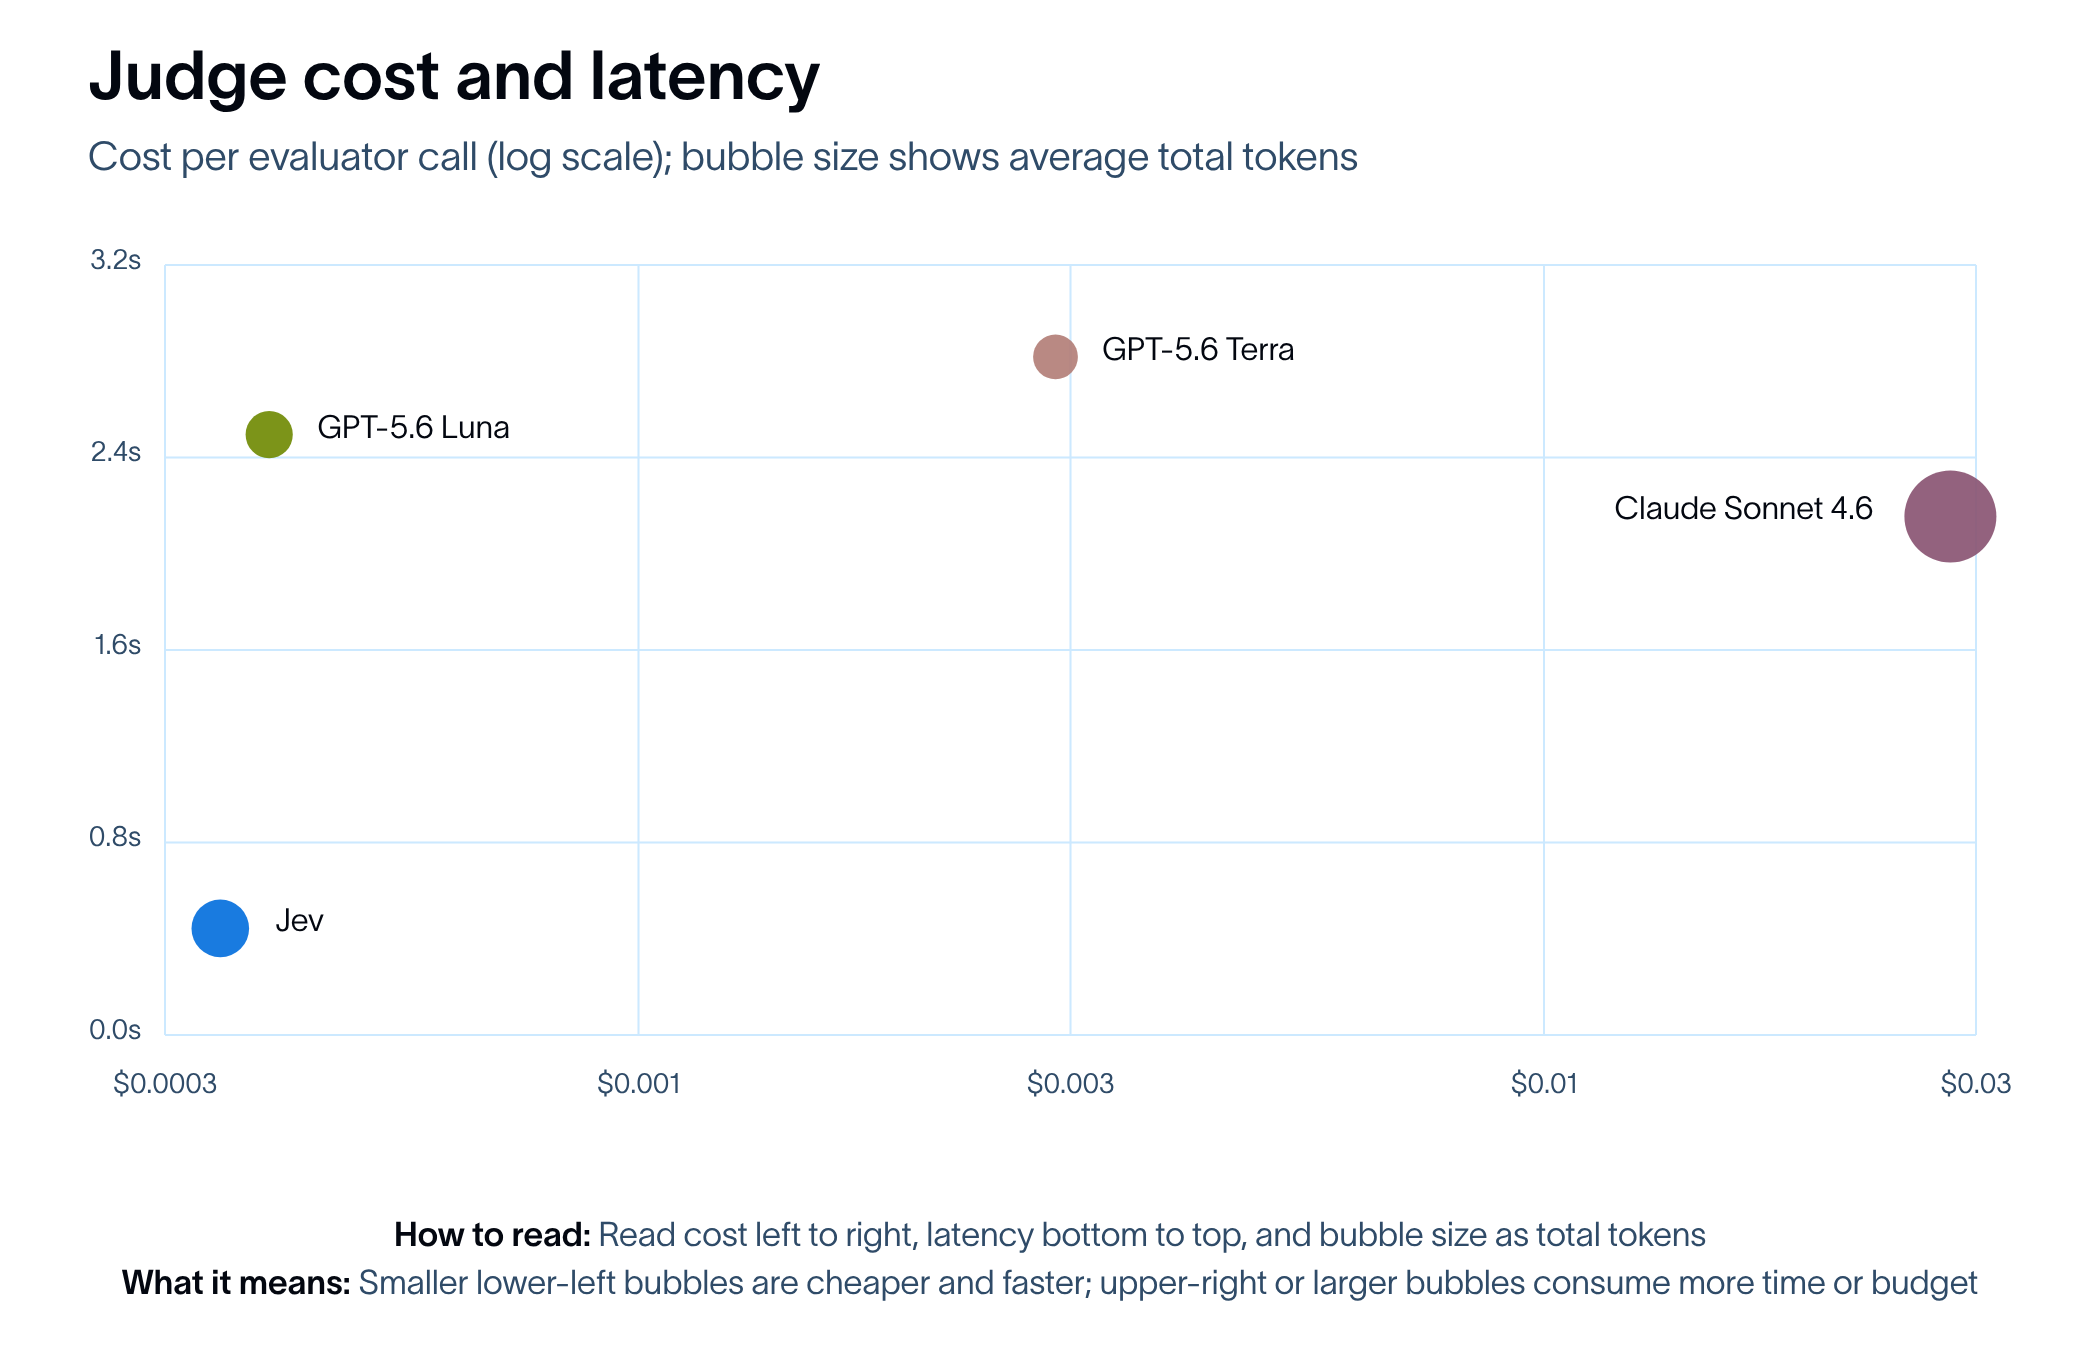
Đây là một bài kiểm tra trên một agent, nhưng kết quả là một dấu hiệu sớm đầy hứa hẹn rằng Jev-as-a-judge là một loại hình đánh giá agent thứ ba khả thi, bên cạnh code-based và LLM-as-a-judge.
Cách sử dụng Jev-as-a-judge trong LangSmith
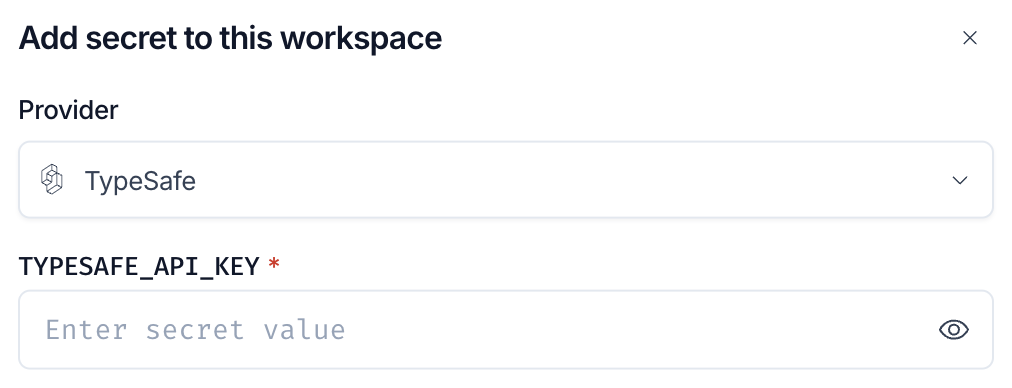
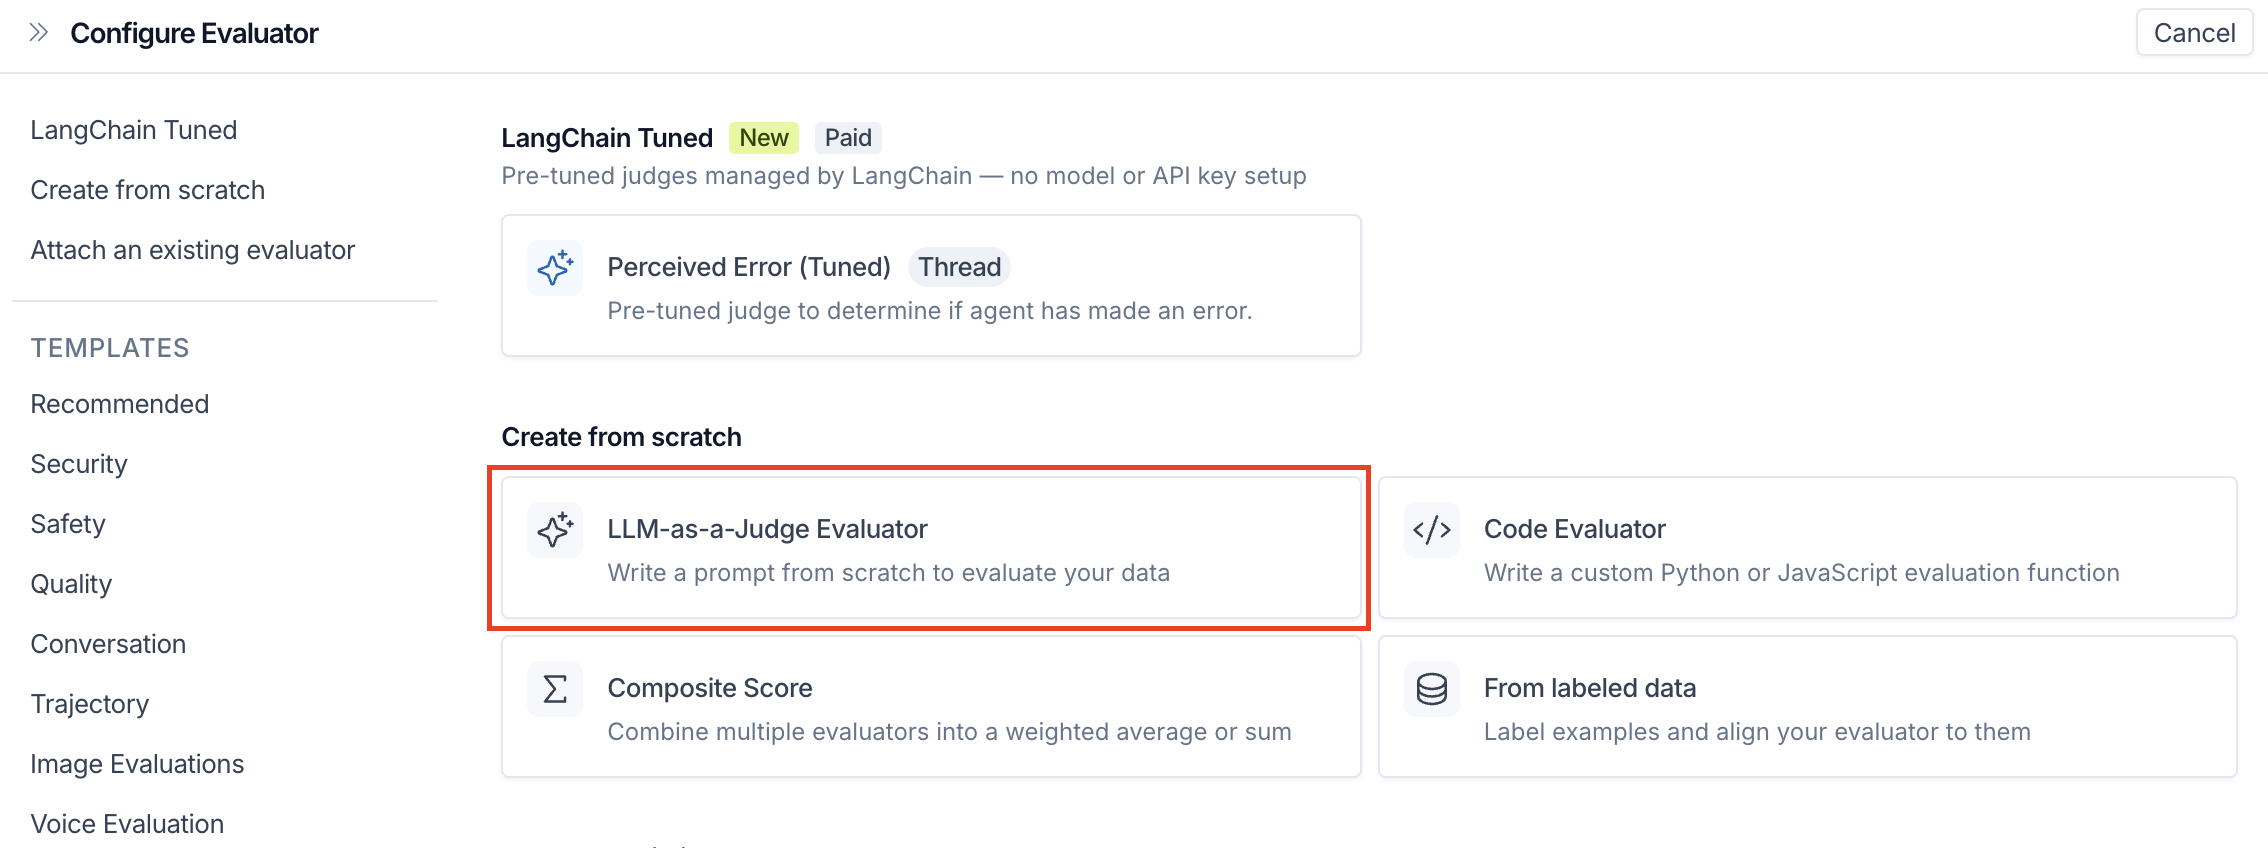
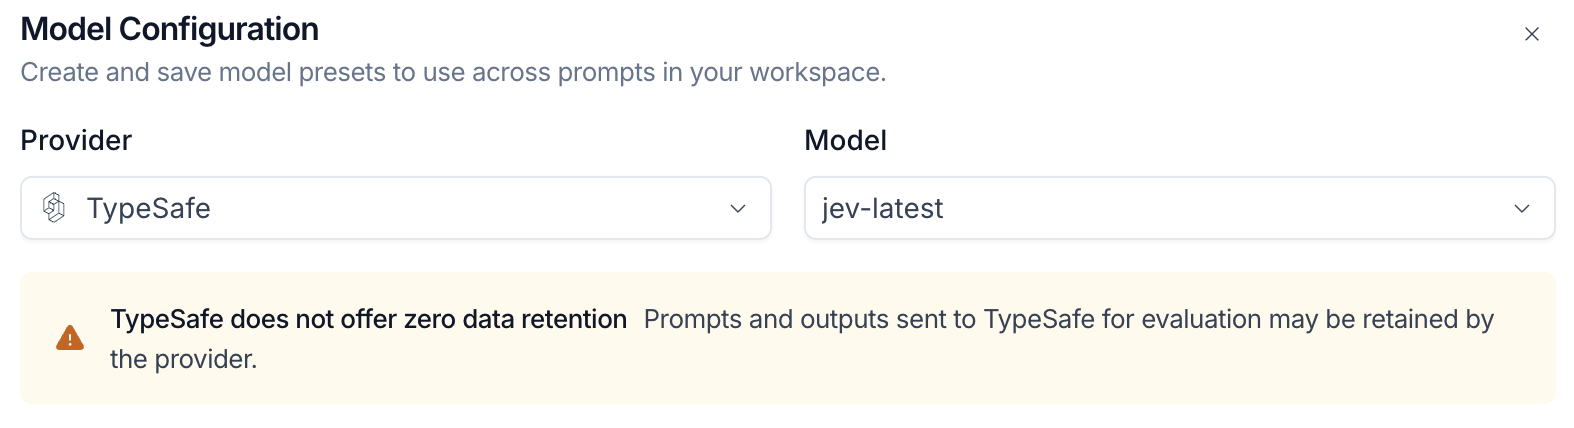
TypeSafe hiện là một nhà cung cấp mô hình trong LangSmith, với Jev có sẵn dưới dạng một mô hình. Việc thiết lập một trình đánh giá Jev-as-a-judge tuân theo quy trình tương tự như trình đánh giá LLM-as-a-judge. Điểm khác biệt chính là trình đánh giá Jev-as-a-judge xác định một trạng thái và một tập hợp các câu hỏi có định kiểu thay vì một prompt và các tiêu chí đánh giá.
Bắt đầu
Jev-as-a-judge đã có sẵn trong LangSmith ngay hôm nay.
Đăng nhập hoặc đăng ký LangSmith, sau đó mở tab Evaluators trong bất kỳ dự án tracing nào, thêm trình đánh giá LLM-as-a-Judge, và chọn TypeSafe làm nhà cung cấp để dùng thử. Để biết thêm chi tiết về các đánh giá trực tuyến, bao gồm các bộ lọc và tùy chọn nâng cao, hãy xem hướng dẫn về trình đánh giá trực tuyến.
Nếu bạn thử nghiệm Jev làm giám khảo trên các agent của mình, chúng tôi rất muốn biết kết quả ra sao, đặc biệt là so với các giám khảo LLM mà bạn đang sử dụng hiện nay. Hãy chia sẻ những gì bạn tìm thấy trên diễn đàn hoặc gắn thẻ chúng tôi trên X.
Để xem cách Jev phù hợp với vòng lặp agent ngoài việc đánh giá, bao gồm định tuyến mô hình (model routing) và kiểm soát rủi ro công cụ (tool-risk gating), hãy đọc bài viết "Building a harness with Jev".
Bài viết được AI dịch và tổng hợp tự động từ LangChain: Blog. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.