Ngành
Khi AI Agent bùng nổ, H3C chuyển hướng từ chạy đua GPU sang tối ưu hóa hiệu suất Token
(giờ Việt Nam)
Tóm tắt AI
Thay vì chỉ tập trung vào sức mạnh tính toán thuần túy, H3C nhấn mạnh tại Hội nghị Apsara 2026 rằng việc tối ưu hóa hiệu suất Token là chìa khóa để triển khai các AI Agent quy mô lớn một cách thực tế và bền vững.
Chính văn · Bản dịch AI
Nếu từ khóa cho hạ tầng AI trong vài năm qua chỉ đơn giản là tăng cường sức mạnh tính toán (compute), thì việc triển khai Agentic AI trên quy mô lớn đang buộc ngành công nghiệp phải đối mặt với một câu hỏi thực tế hơn: Làm thế nào để sử dụng tất cả sức mạnh tính toán đó một cách hiệu quả nhất?
Tại Hội nghị Apsara 2026, H3C đã đặt vấn đề này dưới góc độ Tokens. Khi các AI agents liên tục gọi đến các mô hình nền tảng (foundation models), các dịch vụ ở quy mô hàng nghìn tỷ Tokens đang nổi lên như một yêu cầu hạ tầng mới.
Việc chỉ đơn thuần bổ sung thêm GPU không nhất thiết mang lại hiệu suất tăng tương ứng. Tài nguyên tính toán nhàn rỗi, tắc nghẽn mạng, nguồn cung cấp dữ liệu không đủ, cùng các thách thức về vận hành và lỗi trong các cụm (clusters) quy mô lớn đều có thể làm xói mòn giá trị của việc bổ sung thêm sức mạnh tính toán.
Đó là lý do tại sao dòng sản phẩm của H3C tại sự kiện, dù bao phủ nhiều công nghệ khác nhau, lại tuân theo một logic khá rõ ràng: từ tính toán đến mạng và lưu trữ, từ phần mềm đến vận hành, hạ tầng AI đang chuyển dịch từ việc xếp chồng phần cứng sang tối ưu hóa ở cấp độ hệ thống.

Nhiều GPU hơn không nhất thiết đồng nghĩa với hiệu suất cao hơn
Zhu Shiyin, Tổng giám đốc Bộ phận Nghiên cứu Công nghệ Tiên tiến của H3C, mô tả các cụm AI là những hệ thống tích hợp cao, đòi hỏi sự phối hợp chặt chẽ giữa phần cứng và phần mềm.
Khi quy mô cụm tăng từ hàng trăm GPU lên hàng nghìn hoặc thậm chí hàng chục nghìn, bản thân các GPU chỉ trở thành một phần của phương trình. Giao tiếp giữa các chip, truyền tải dữ liệu, lập lịch tác vụ, cấp nguồn và làm mát đều có thể ảnh hưởng trực tiếp đến hiệu suất sử dụng tính toán tổng thể.
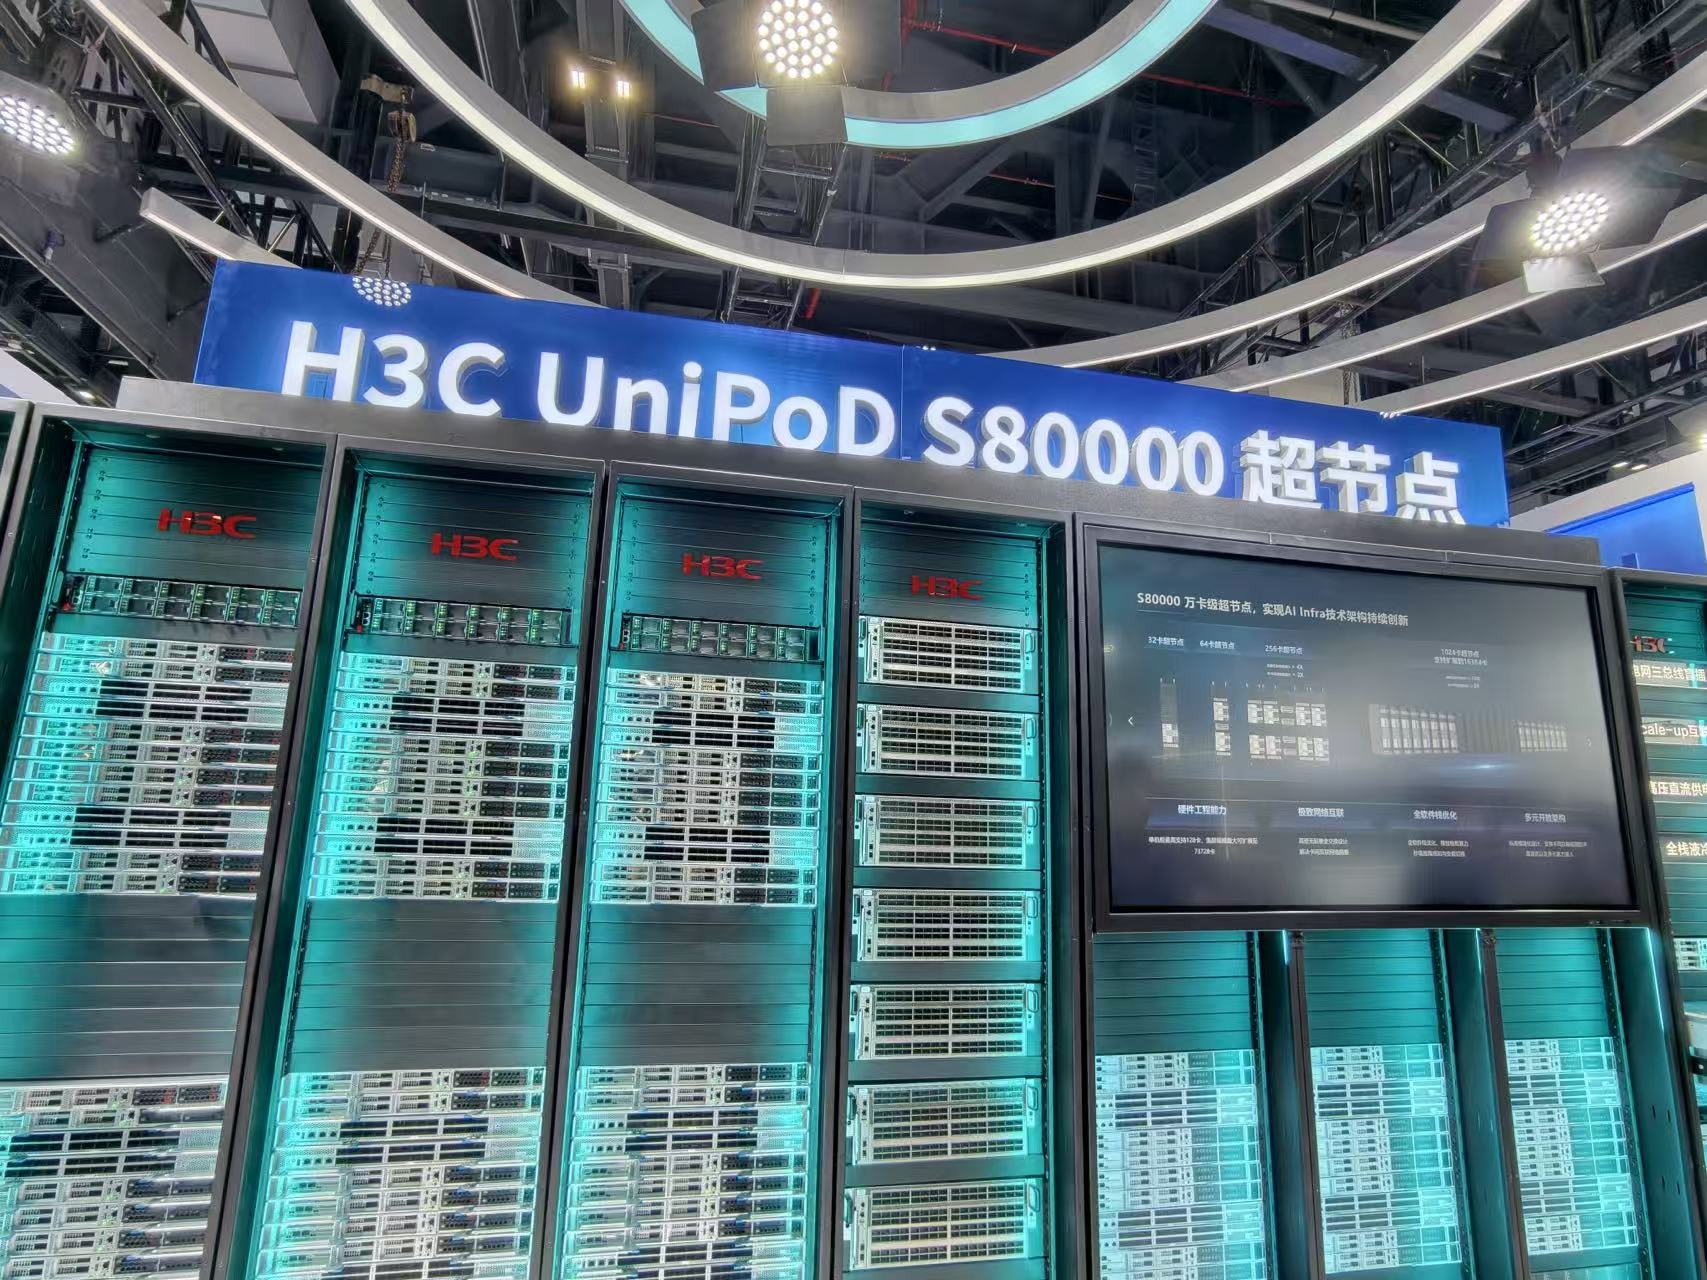
Dòng sản phẩm SuperPod UniPoD S80000 của H3C, được giới thiệu tại sự kiện, phản ánh cách tiếp cận này. Nó hỗ trợ các cấu hình từ 32 đến 1.024 GPU và có thể mở rộng lên tới 16.384 GPU, đồng thời hỗ trợ các tài nguyên tính toán không đồng nhất bao gồm CPU, GPU, NPU, DPU và các framework phổ biến.
Trọng tâm không chỉ đơn giản là đưa nhiều chip hơn vào một hệ thống duy nhất, mà là phối hợp tính toán, mạng, lưu trữ, đám mây, bảo mật và vận hành để các loại tài nguyên tính toán khác nhau có thể được quản lý như một hệ thống thống nhất.
Nói cách khác, cuộc cạnh tranh trong các cụm AI đang chuyển dịch từ việc một hệ thống có bao nhiêu GPU sang việc mỗi GPU thực sự có thể tạo ra bao nhiêu Tokens hữu ích.

Khi GPU ngày càng nhanh, mạng có thể trở thành nút thắt cổ chai
Zhu cũng nhấn mạnh các kết nối tốc độ cao (high-speed interconnects), một phần ngày càng quan trọng của hạ tầng AI. Lý do rất đơn giản: khi hiệu suất GPU cải thiện, lượng dữ liệu trao đổi giữa các GPU cũng tăng lên. Nếu mạng không theo kịp, các GPU buộc phải chờ đợi.
Đây là lý do tại sao H3C đã giới thiệu ba kịch bản kết nối tại sự kiện: Scale-Up, Scale-Out và Scale-Across.
Trong một node, H3C giới thiệu S9828-128EO, một switch tính toán thông minh 102.4T NPO silicon-photonics sử dụng công nghệ co-packaged optics để giảm độ trễ end-to-end xuống 15%. Giữa các node, switch tính toán thông minh 1.6T S9828-64FP của công ty áp dụng công nghệ 224G SerDes, giúp cắt giảm hơn 20% mức tiêu thụ điện năng trong môi trường mật độ cao để hỗ trợ mở rộng cụm quy mô lớn.
Trên các trung tâm dữ liệu, switch DCI tính toán thông minh 800G S12500R-64EP được thiết kế để hỗ trợ lập lịch tính toán và đồng bộ hóa gradient giữa các trung tâm dữ liệu trong cùng thành phố.
Logic đằng sau ba lớp này quy về một câu hỏi cốt lõi: Khi các cụm AI phát triển, làm thế nào để các kết nối không trở thành "phanh hãm" hiệu suất tính toán?
Kết nối cũng không còn chỉ là vấn đề về băng thông. Khi các cụm mở rộng, các giao thức, kiểm soát tắc nghẽn, độ tin cậy của liên kết và chẩn đoán lỗi trở nên quan trọng không kém. Nếu các nhà cung cấp phát triển các hệ sinh thái kỹ thuật đóng một cách độc lập, họ có thể tạo ra các "ốc đảo" công nghệ mới. Do đó, các giao thức mở và tiêu chuẩn ngành sẽ ngày càng trở nên quan trọng.

Ngoài tính toán, còn một thách thức thường bị đánh giá thấp: dữ liệu
GPU không thể hoạt động nếu thiếu dữ liệu. Trong huấn luyện mô hình lớn, việc chuẩn bị dữ liệu, huấn luyện mô hình và trao đổi tham số đều liên quan đến lượng dữ liệu di chuyển khổng lồ. Trong quá trình suy luận (inference), KV Cache gây thêm áp lực lên tài nguyên lưu trữ và bộ nhớ đệm.
Do đó, H3C cũng định vị lưu trữ hiệu năng cao là một phần của quy trình sản xuất Token rộng lớn hơn. Dòng UniStor X20000 series X20836 của hãng có thể cung cấp băng thông lên tới 200GB/s và 3 triệu IOPS mỗi node, đồng thời hỗ trợ khả năng tương tác giữa các giao thức block, file, object và HDFS.
Theo H3C, công cụ full-speed của họ có thể giảm thời gian chờ đợi của GPU xuống 30%, trong khi khả năng tăng tốc suy luận XCache có thể cắt giảm độ trễ time-to-first-token lên tới 90% trong các kịch bản suy luận.
Bài học rút ra khá thực tế: Hạ tầng AI đang tiến hóa từ một trung tâm tính toán thành một hệ thống xử lý dữ liệu toàn diện. Từ chuẩn bị dữ liệu và huấn luyện đến suy luận và tạo Token, mỗi khoảng thời gian chờ đợi cuối cùng đều chuyển hóa thành chi phí.

Phần mềm có thể là chiến trường tiếp theo
Khi phần cứng đạt đến một quy mô nhất định, tối ưu hóa phần mềm trở nên ngày càng quan trọng. Zhu lưu ý rằng mọi thứ từ hệ điều hành và thư viện truyền thông đến các nền tảng quản lý tài nguyên và lập lịch đều cần phối hợp chặt chẽ với phần cứng bên dưới.
Tối ưu hóa truyền thông, chồng lấp tính toán với truyền thông, lập lịch tác vụ, cân bằng tải động và quản lý tài nguyên thống nhất đều có thể giúp giảm thời gian nhàn rỗi của GPU và các xung đột truyền thông.
Đây cũng là lý do tại sao hạ tầng AI hiện đại ngày càng giống một siêu hệ thống. Các chip cung cấp sức mạnh tính toán, mạng kết nối các tài nguyên, lưu trữ cung cấp dữ liệu, còn điện năng và làm mát giữ cho hệ thống hoạt động. Trong khi đó, phần mềm chịu trách nhiệm điều phối các tài nguyên này thành một chỉnh thể vận hành.
Nếu bất kỳ thành phần nào trong số này trở thành nút thắt cổ chai, tác động không còn giới hạn ở một chỉ số phần cứng đơn lẻ. Nó cuối cùng ảnh hưởng đến việc hệ thống có thể tạo ra bao nhiêu Tokens hữu ích mỗi giây và chi phí sản xuất mỗi Token là bao nhiêu.
Giai đoạn tiếp theo của hạ tầng AI là cuộc cạnh tranh về hiệu suất sử dụng tính toán
Từ gian hàng triển lãm đến các phiên thảo luận tại Hội nghị Apsara, H3C về cơ bản đều đưa ra cùng một quan điểm từ các góc độ khác nhau.
Supernodes giải quyết cách tổ chức tài nguyên tính toán ở quy mô lớn. Mạng tốc độ cao giải quyết cách các tài nguyên đó giao tiếp hiệu quả. Lưu trữ hiệu năng cao đảm bảo dữ liệu được cung cấp kịp thời. Phần mềm, lập lịch, vận hành và quản lý thống nhất sau đó biến các tài nguyên này thành các năng lực AI có thể sử dụng liên tục và hiệu quả.
Do đó, giai đoạn cạnh tranh tiếp theo trong hạ tầng AI có thể không chỉ được quyết định bởi việc ai có nhiều GPU hơn. Khi quy mô mô hình đạt tới hàng nghìn tỷ tham số và các AI agents ngày càng gọi nhiều đến các mô hình nền tảng, các chỉ số như hiệu suất sử dụng tính toán, thông lượng Token, độ trễ, tiêu thụ năng lượng và chi phí trên mỗi Token đang trở nên ngày càng quan trọng.
Đó là ý nghĩa sâu xa đằng sau việc theo đuổi hiệu quả chi phí Token cực hạn: không phải là gom nhiều GPU lại với nhau, mà là làm cho mỗi GPU, mỗi liên kết mạng và mỗi đơn vị lưu trữ trong hệ thống dành ít thời gian chờ đợi hơn và nhiều thời gian làm việc hơn.
Khi AI bước vào giai đoạn sản xuất quy mô lớn, năng lực tính toán không còn chỉ là vấn đề về chip. Nó đang trở thành cuộc cạnh tranh về hiệu suất của toàn bộ hệ thống cơ sở hạ tầng.
Bài viết được AI dịch và tổng hợp tự động từ TechNode. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.