Nghiên cứu
Báo cáo Epoch AI: Chi phí để đạt cùng mức hiệu năng AI giảm 47% mỗi quý
(giờ Việt Nam)
Tóm tắt AI
Nghiên cứu từ Epoch AI cho thấy chi phí để đạt được cùng một mức hiệu năng AI giảm trung bình 47% mỗi quý. Tốc độ này cho thấy sự tiến bộ vượt bậc trong hiệu quả tính toán kể từ khi các mô hình ngôn ngữ lớn thương mại ra đời vào cuối năm 2021.
Bản dịch AI
Các điểm chính
Dữ liệu và mã nguồn được đăng tải trên GitHub. Một trang tổng hợp có chứa nhiều biểu đồ và bảng biểu để bạn khám phá.
Tổng quan
Chữ “GPT” trong “ChatGPT” là viết tắt của “Generative Pre-trained Transformer” (mô hình biến đổi được huấn luyện trước có khả năng tạo sinh), một mô tả kỹ thuật về cách thức hoạt động của AI bên trong nó. Tuy nhiên, chắc chắn rằng những người tạo ra các mô hình GPT của OpenAI đã ngầm ý đến một ý nghĩa cũ hơn của cụm từ viết tắt này: công nghệ đa năng (general-purpose technology). Họ đã dự đoán chính xác rằng — giống như động cơ hơi nước, điện năng và internet — các mô hình ngôn ngữ lớn (LLM) rồi sẽ tác động đến mọi khía cạnh của xã hội.
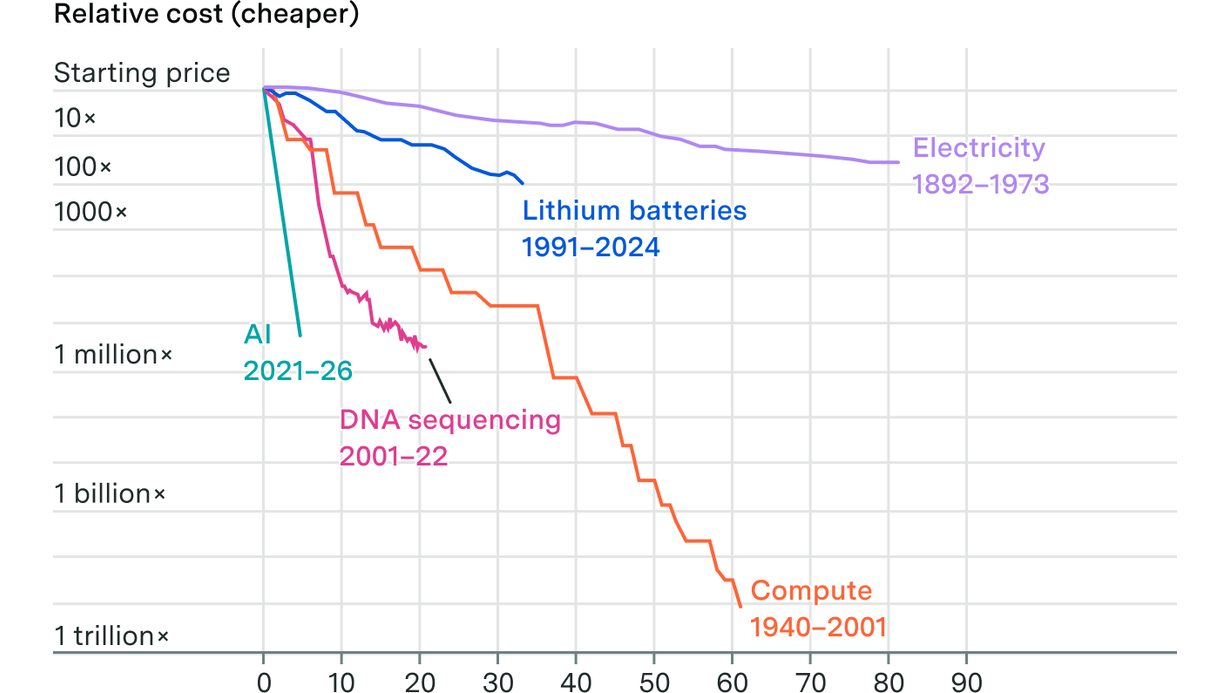
Hiện nay, ai cũng hiểu rằng sự bùng nổ của AI là một lực lượng kinh tế vĩ mô đủ mạnh để đẩy giá các yếu tố đầu vào mà nó yêu cầu: chip, năng lượng, thậm chí là cả nhân lực thợ điện. Điều ít được công nhận hơn là một mặt trái nghịch lý: giá thành đầu ra từ tất cả các trung tâm dữ liệu đó đang giảm xuống với tốc độ cực kỳ nhanh chóng:
Biểu đồ tiếp theo cho thấy một vài ví dụ. Vào ngày 31 tháng 1 năm 2025, OpenAI đã phát hành một phiên bản mới trong loạt mô hình “suy luận” (reasoning) của mình, có tên là o3. Chúng tôi ước tính rằng với chi phí trung bình 30 xu cho mỗi câu hỏi, nó có thể đạt điểm số 75% trên GPQA Diamond, một bài kiểm tra trắc nghiệm bao gồm các kiến thức vật lý, hóa học và sinh học trình độ tiến sĩ. Chỉ chưa đầy 18 tháng sau, OpenAI đã phát hành GPT-5.6 Luna. Nó đạt điểm số tương đương — với giá bốn phần trăm của một xu cho mỗi câu hỏi ($0,0004). Đó là mức giảm giá 725 lần cho chi phí của tư duy trong chưa đầy 18 tháng. Nó giống như việc giá niêm yết của một chiếc ô tô mới giảm từ 50.000 đô la xuống còn 69 đô la. Không có công nghệ đa năng nào khác trong lịch sử dường như trở nên rẻ và nhanh đến vậy.
Để đo lường các xu hướng này, chúng tôi đã phân tích hiệu suất bằng một bộ dữ liệu mới và toàn diện hơn, bao gồm năm tiêu chuẩn đánh giá (benchmark) hiệu suất AI về toán học, các ngành khoa học cứng và các trò chơi kỹ năng trong ba năm qua.
Trong khoảng thời gian đó, chúng tôi nhận thấy rằng giá cho một mức hiệu suất nhất định đã giảm khoảng 47% mỗi quý, tương đương 13 lần mỗi năm. Chúng tôi thấy mức giảm chậm hơn ở các câu đố dựa trên trò chơi, ở mức khoảng 39–43% mỗi quý (7–10 lần mỗi năm), và tiến bộ nhanh hơn ở các bài toán, ở mức 50–52% mỗi quý (16–19 lần mỗi năm).
Mức giảm chi phí cho một mức hiệu suất nhất định có xu hướng chậm lại theo thời gian, mặc dù mô hình này không phổ biến ở mọi nơi. Một lời giải thích khả thi: khi một mức hiệu suất lần đầu tiên đạt được, các công ty AI có thể tính phí cao trong thời gian ngắn, trước khi sự cạnh tranh và cải tiến công nghệ nhanh chóng đẩy giá xuống. Theo thời gian, động lực đó chậm lại. Tính trung bình trên năm tiêu chuẩn đánh giá chính, chi phí giảm 66% mỗi quý (75 lần mỗi năm) lúc ban đầu. Hai năm sau, nó giảm chậm hơn một nửa, ở mức “chỉ” 32% mỗi quý (4,7 lần mỗi năm).
Phân tích của chúng tôi đi kèm với những lưu ý quan trọng. Các công ty AI có thể đang huấn luyện mô hình của họ một cách rõ ràng cho một số tiêu chuẩn đánh giá (“benchmaxxing”), khiến cho sự cải thiện trên các tiêu chuẩn này vượt xa sự cải thiện đối với các tác vụ thực tế. Ngay cả khi họ không làm vậy, việc đạt kết quả tốt trên một tiêu chuẩn đánh giá không đồng nghĩa với việc thực hiện công việc hữu ích. Vì chúng tôi tập trung vào biên giới — mô hình rẻ nhất tuyệt đối có khả năng đạt được bất kỳ mức hiệu suất nào — chúng tôi ngầm định một người dùng AI luôn tìm kiếm mô hình hiệu quả nhất về chi phí cho mỗi tác vụ, trong khi người dùng thực tế không chuyển đổi mô hình thường xuyên như vậy, và do đó không gặt hái được mức tiết kiệm tương tự. Dữ liệu của chúng tôi chưa đầy đủ và còn nhiễu: khung thời gian chỉ vỏn vẹn ba năm và chúng tôi không bao gồm tất cả các kết hợp giữa mô hình AI và tiêu chuẩn đánh giá. Giá cả giảm khác nhau đối với các mô hình, tiêu chuẩn đánh giá, khoảng thời gian và phạm vi hiệu suất khác nhau, và có nhiều cách hợp lý để tính trung bình trên trải nghiệm đa dạng này. Nhìn chung, mặc dù chúng tôi tin rằng các con số cuối cùng của mình đại diện khá chính xác cho thực tế, nhưng chúng không nên được coi là con số chính xác tuyệt đối.
Phần còn lại của báo cáo này trình bày chi tiết phân tích của chúng tôi. Một số phần trong đó mang tính kỹ thuật.
Các nghiên cứu trước đây
Chúng tôi không phải là những người đầu tiên định lượng tốc độ giảm giá của AI. Một bài đăng năm 2024 của Guido Appenzeller cho Andreessen Horowitz đã ghi lại cách mà trong ba năm sau khi GPT-3 được phát hành rộng rãi, chi phí LLM đã giảm 1000 lần, tức là 10 lần mỗi năm. Vài tháng sau, vào tháng 3 năm 2025, một phân tích của Epoch AI đã tìm thấy mức giảm 9–900 lần mỗi năm trên sáu tiêu chuẩn đánh giá hiệu suất.
Cả hai phân tích ban đầu đó đều đo lường giá mỗi token cho các mô hình có khả năng đạt được hiệu suất nhất định, khác với chi phí thực tế để đạt được hiệu suất đó. Với sự ra đời của các mô hình suy luận — OpenAI đã phát hành o1 vào tháng 12 năm 2024 — việc bỏ qua sự khác biệt này đã trở nên bất cập hơn. Các mô hình suy luận có thể tiêu thụ nhiều token hơn một cách hiệu quả, nhưng kết quả là đạt được hiệu suất tốt từ một LLM nền tảng nhỏ hơn và rẻ hơn để chạy trên mỗi token.
Vào tháng 9 năm 2025, Håvard Tveit Ihle đã chia sẻ một phân tích trên LessWrong so sánh trực tiếp hiệu suất và chi phí trên hai bộ thử thách lập trình. Phân tích cho thấy chi phí giảm một nửa sau mỗi 1,4–2 tháng (64–380 lần mỗi năm).
Phân tích kỹ lưỡng nhất cho đến nay là bài báo tháng 3 năm 2026 của Gundlach và cộng sự. Bài báo này cũng so sánh chi phí thực tế với hiệu suất. Giống như phân tích hiện tại, nó ước tính các xu hướng trong cả tập dữ liệu đầy đủ và trong tập hợp con các mô hình xác định biên giới chi phí tại bất kỳ thời điểm nào. Nó cũng phân tách theo mức hiệu suất — giá giảm nhanh hơn ở phân khúc cao cấp — và theo loại mô hình (mở hoặc đóng, dày đặc hoặc hỗn hợp chuyên gia). Nhìn chung, họ nhận thấy mức giảm 5–10 lần mỗi năm.
Dữ liệu
Điểm mới chính trong phân tích hiện tại là phân tích các xu hướng chi phí bằng phương pháp nắm bắt toàn bộ phạm vi chi phí-hiệu suất của mỗi mô hình.
Nếu một LLM có thể đạt 80% trên một tiêu chuẩn đánh giá với chi phí 1 đô la, và một mô hình khác đạt tối đa 60% với giá 0,50 đô la, thì không rõ cái nào hiệu quả về chi phí hơn. Có lẽ mô hình mạnh hơn sẽ đạt 60% với chi phí rẻ hơn mô hình yếu hơn nếu chạy với ít token suy luận hơn.
Tổng quát hơn, mối quan tâm của chúng tôi là lập bản đồ biên giới “Pareto” về hiệu quả chi phí — cách rẻ nhất để đạt được từng mức hiệu suất từ các mô hình có sẵn tại bất kỳ thời điểm nào. Chúng tôi sẽ để lại rất nhiều vùng chưa được lập bản đồ, và có khả năng là cả một phần lớn biên giới, nếu chúng tôi chỉ ước tính chi phí và hiệu suất khi các LLM được cấp ngân sách không giới hạn. Bất kỳ LLM hiện đại nào cũng có thể tạo ra một loạt các mức hiệu suất, tùy thuộc vào việc suy luận của nó được đặt ở mức thấp, trung bình, cao hay tối đa, và tùy thuộc vào việc có áp đặt giới hạn ngân sách hay không.
Một cách để theo dõi đường cong chi phí-hiệu suất của mô hình là chạy nó nhiều lần so với một tiêu chuẩn đánh giá, ở các mức suy luận và ngân sách token khác nhau. Tuy nhiên, quá trình đó sẽ tốn kém và chậm chạp. Thay vào đó, chúng tôi tuân theo quy trình do Trung tâm Tiêu chuẩn và Đổi mới AI (CAISI) liên bang phát triển. Nó sử dụng bản ghi từ một lần chạy tiêu chuẩn đánh giá với giới hạn ngân sách cao (hoặc không giới hạn) để dự đoán hiệu suất dưới các ngân sách chặt chẽ hơn. Ý tưởng cốt lõi là vì các tiêu chuẩn đánh giá bao gồm nhiều câu hỏi, người ta có thể ước tính một LLM sẽ trả lời được bao nhiêu câu trước khi tiêu thụ một ngân sách nhất định. Bản ghi cung cấp thông tin cần thiết: mô hình đã tiêu thụ bao nhiêu token để trả lời mỗi câu hỏi và câu nào nó trả lời đúng.
Đối với bất kỳ ngân sách X token tùy ý cho mỗi câu hỏi, chúng tôi tính tổng số câu hỏi được trả lời đúng trong ít hơn X token đầu ra. Hãy coi đây là chi phí tối đa mà mô hình có thể phải chịu trước khi buộc phải bỏ cuộc. Khi một mô hình không trả lời kịp thời cho một ngưỡng ngân sách cụ thể, câu hỏi đó được tính điểm là xác suất đoán đúng, ví dụ: 0,25 đối với trắc nghiệm bốn lựa chọn và thực tế là 0 đối với các loại vấn đề khác. Việc lặp lại trên một loạt ngân sách tạo ra một đường cong hiệu suất như một hàm của chi phí giả định.
Một mối lo ngại về quy trình này là nó có thể ước tính sai cách các LLM thực sự hoạt động nếu được thông báo về ngân sách. Nếu các mô hình được yêu cầu tối ưu hóa để đạt điểm tốt ở một ngưỡng thấp hơn, chúng có thể hoạt động tốt hơn so với việc các câu hỏi bị cắt bớt một cách âm thầm như mô phỏng trong phương pháp CAISI.
Để kiểm tra mối lo ngại này, chúng tôi đã sửa đổi các đánh giá của mình bằng cách thông báo rõ ràng cho các mô hình về ngân sách mỗi câu hỏi của chúng. Kết quả của chúng tôi cho thấy mặc dù các phiên bản nỗ lực cao của các mô hình tư duy thường cải thiện hiệu suất ngân sách thấp khi các ngân sách đó được công bố, nhưng chúng không vượt trội hơn các biến thể nỗ lực thấp trong các điều kiện tiêu chuẩn, không được công bố. Nghĩa là, việc chỉ chạy các mô hình tư duy ở mức nỗ lực tư duy thấp tạo ra các đường cong chi phí-hiệu suất tương tự như khi chạy ở mức nỗ lực tư duy cao dưới các giới hạn đã công bố. (Xem Hình 3 để biết ví dụ trên một số mô hình.) Kết quả là, miễn là chúng tôi sử dụng phương pháp CAISI trên phạm vi các mức tư duy, chúng tôi có thể sẽ bao phủ hầu hết miền khả năng chi phí-hiệu suất của một mô hình.
Hình 3. Việc công bố giới hạn ngân sách cho một mô hình tạo ra mối quan hệ chi phí-hiệu suất tương tự như việc chỉ giới hạn ngân sách của nó.
Vì trước đây các nỗ lực đánh giá của chúng tôi có xu hướng tập trung vào việc nắm bắt các giới hạn hiệu suất cao nhất mà ít quan tâm đến hiệu quả chi phí, dữ liệu của chúng tôi thiếu một cách hệ thống các đánh giá sử dụng nỗ lực suy luận thấp hơn và các mô hình nhỏ, tập trung vào hiệu quả. Để tránh làm chệch kết quả, chúng tôi đã thực hiện một nỗ lực thu thập dữ liệu phối hợp để lấp đầy những khoảng trống này cho FrontierMath Tiers 1-3 (v2), OTIS Mock AIME 2024-2025, GPQA Diamond, Chess Puzzles và Mystery Game Puzzles. Điều này bao gồm việc chạy trực tiếp một số mô hình trọng số mở, vì chúng có khả năng nằm dọc theo biên giới Pareto về chi phí và hiệu suất, nhưng không có sẵn từ bất kỳ API suy luận chuyên dụng nào. Để có được giá cho các đánh giá trên các mô hình này, chúng tôi đã sử dụng chi phí phần cứng thuê của chúng, nỗ lực tối ưu hóa cả việc lựa chọn phần cứng và cài đặt đánh giá để tối đa hóa hiệu quả chi phí dựa trên độ trễ hợp lý. Chúng tôi đã xác thực phương pháp của mình bằng cách sử dụng nó để chạy năm mô hình trọng số mở cũng có sẵn thông qua API suy luận. Trong mỗi trường hợp này, sự khác biệt giữa chi phí trực tiếp của chúng tôi và giá API là dưới 30%.
Mô hình hóa
Thách thức
Đối với mỗi tiêu chuẩn đánh giá, chúng tôi có một tập hợp các bộ ba \((a_i, t_i, c_i)\) đại diện cho độ chính xác của câu trả lời của mô hình trong một lần chạy cụ thể, ngày phát hành của mô hình và chi phí bằng đô la của lần chạy đó. Như đã giải thích, phương pháp CAISI tạo ra nhiều bộ ba cho mỗi kết hợp giữa mô hình, mức tư duy và tiêu chuẩn đánh giá, khi giới hạn token giả định thay đổi.
Chúng tôi muốn mô tả tốc độ giảm giá cho các mức hiệu suất nhất định — không phải của mô hình trung bình, mà là tại “biên giới”, nghĩa là mô hình rẻ nhất hiện có có thể mang lại hiệu suất yêu cầu trên một tiêu chuẩn đánh giá.
Cụ thể, chúng tôi xác định hai biên giới Pareto thực nghiệm, cho độ chính xác và chi phí. Biên giới độ chính xác thực nghiệm là hiệu suất cao nhất đạt được trong một ngân sách nhất định bằng cách sử dụng các mô hình có sẵn cho đến một ngày nhất định:
Biên giới chi phí thực nghiệm là chi phí thấp nhất mà tại đó ít nhất một mô hình có sẵn có thể đáp ứng hoặc vượt qua mục tiêu độ chính xác nhất định:
Các bề mặt này có đặc điểm bậc thang hai chiều, vì chúng trải qua những bước nhảy không liên tục trong một trong các chiều của chúng, luôn theo cùng một hướng.
Việc đại diện cho các biên giới di động này bằng một mô hình thống kê là một thách thức theo một vài cách:
Các mục 2–4 có nghĩa là khi chúng tôi mô hình hóa biên giới, rất khó để tạo ra các sai số chuẩn đáng tin cậy, do đó khó ước tính ý nghĩa thống kê. Những điều đó luôn dựa trên một mô hình của quá trình tạo dữ liệu trông có vẻ thực tế, bao gồm cả việc chỉ định các thành phần nhiễu.
Một phản ứng phổ biến khi không thể ước tính sai số chuẩn thông qua các phương pháp phân tích là sử dụng phương pháp bootstrap. Nhưng chúng tôi hoài nghi ngay cả với biện pháp khắc phục này, như sẽ được giải thích.
Vì những lý do này, chúng tôi từ bỏ mô hình suy luận thống kê chính thức. Chúng tôi mượn các phương pháp từ kinh tế lượng, chẳng hạn như hồi quy logistic và phân tích biên giới ngẫu nhiên. Nhưng chúng tôi không báo cáo sai số chuẩn và không kiểm tra chính thức các giả thuyết về giá trị của các tham số trong các mô hình của quá trình tạo dữ liệu. Chúng tôi tin rằng các kết quả nên được coi là những phép đo hợp lý nhưng thô dựa trên dữ liệu tốt nhất hiện có, về một hiện tượng chắc chắn đang tồn tại.
Các mô hình
Chúng tôi khớp năm mô hình chính với dữ liệu, hai mô hình cho các biên giới thực nghiệm và ba mô hình cho toàn bộ tập kết quả đánh giá. Trong số các mô hình sau, hai mô hình là ứng dụng của phân tích biên giới ngẫu nhiên. Kết quả của chúng không đáng tin cậy — chúng thường ngụ ý rằng biên giới đã di chuyển ngược lại — và bị đẩy xuống phần phụ lục.
Bài viết được AI dịch và tổng hợp tự động từ Epoch AI: Nghiên cứu、. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.