Link bài viết gốc: https://mp.weixin.qq.com/s/AciT5C6ypT35F...
Lập trình viên Tencent · WeChat Official Account · Tencent Technology Engineering · 2026-10-19 17:36
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
Tác giả: leonjia
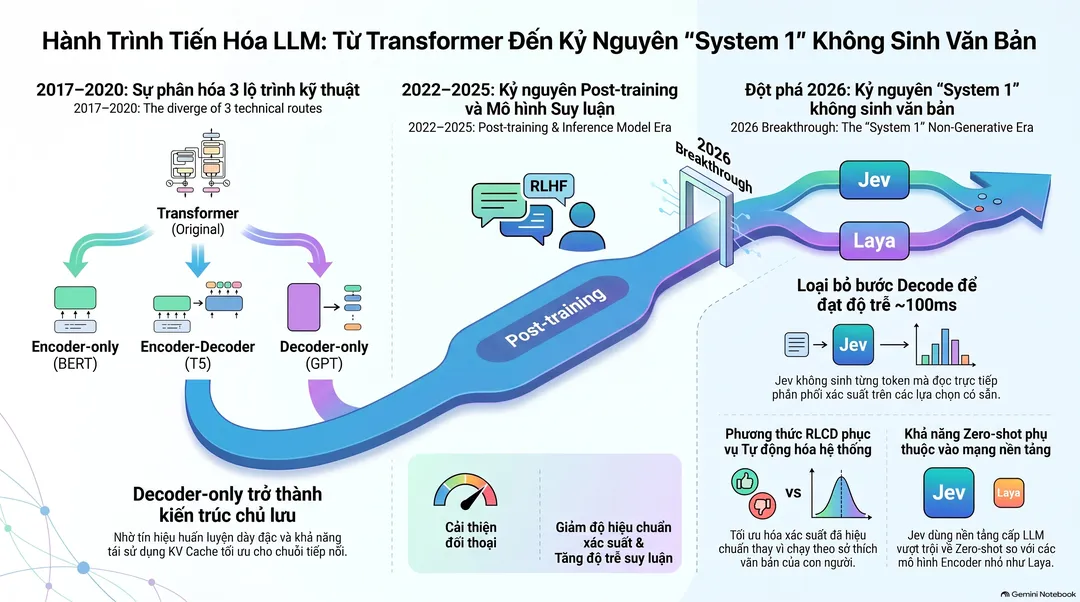
Vào tháng 9 năm 2026, TypeSafe AI đã phát hành Jev. Khác với các mô hình ngôn ngữ thông thường, Jev không sinh văn bản, mà trả lời ba dạng câu hỏi có cấu trúc giới hạn dựa trên tài liệu đầu vào được cung cấp: chọn một trong số các phương án, chấm điểm theo các mức thang định sẵn, hoặc phán đoán một nhận định có đúng hay không, đồng thời trả về trực tiếp xác suất của từng câu trả lời. Các mô hình ngôn ngữ phổ biến mất từ vài giây đến vài phút để hoàn thành một lượt trả lời, trong khi Jev hoàn thành một nhóm phán đoán chỉ ở mức vài trăm mili-giây.
Để làm rõ mối quan hệ giữa Jev và các mô hình lớn (LLM) chủ lưu, chúng ta cần quay lại với chính kiến trúc Transformer. Từ cấu trúc nguyên bản năm 2017, đến hai lộ trình kỹ thuật chủ lưu do BERT và GPT đại diện, rồi đến các model tiên phong hiện nay như DeepSeek, Qwen, cách thức model tiếp nhận đầu vào và tạo đầu ra đã trải qua nhiều lần thay đổi, và điểm khác biệt của Jev cũng nằm chính ở hai khâu này. Cuối bài viết sẽ lấy Laya mã nguồn mở làm đối chứng, một model có phương thức đầu ra tương tự Jev nhưng mạng bên dưới lại khác biệt.
01 2017: Transformer và dịch máy
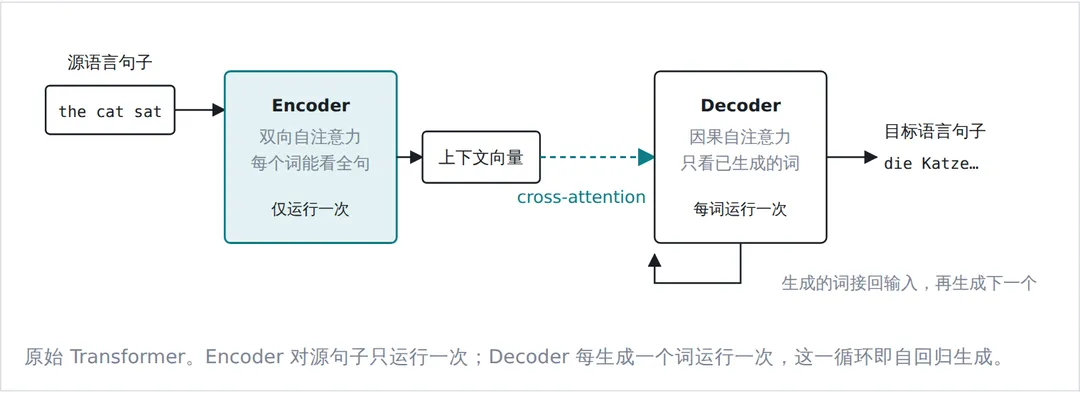
Bài báo đề xuất Transformer mang tên "Attention Is All You Need" nhắm đến nhiệm vụ dịch máy, do đó cấu trúc nguyên bản gồm hai giai đoạn: Encoder đọc câu ở ngôn ngữ nguồn và xuất ra một tập hợp các vector context; Decoder đọc tập hợp vector này thông qua cross-attention, đồng thời sinh câu ở ngôn ngữ đích theo từng từ. Encoder chỉ chạy một lần đối với câu nguồn, còn Decoder chạy một lần cho mỗi từ được sinh ra, từ vừa sinh sẽ được nối ngược lại vào đầu vào để sinh từ tiếp theo.
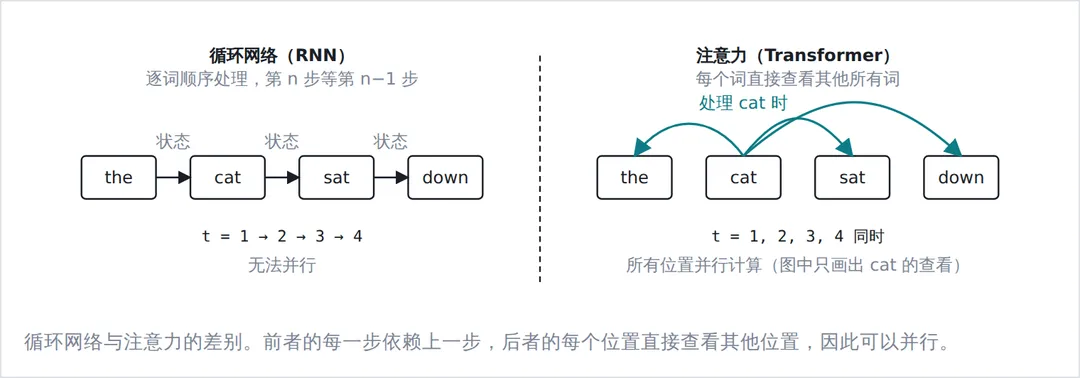
Bản thân khung kiến trúc hai giai đoạn không phải là đóng góp của bài báo này, mô hình seq2seq thời kỳ RNN đã áp dụng cấu trúc tương tự. Đóng góp của nó nằm ở việc dùng cơ chế chú ý (attention) để thay thế hoàn toàn cấu trúc tuần hoàn. Mạng tuần hoàn đọc vào từng từ một, trạng thái của mỗi bước được truyền từ bước trước, từ thứ n bắt buộc phải đợi n−1 từ trước xử lý xong; trong khi đó, attention khi xử lý mỗi từ sẽ trực tiếp xem xét các từ khác trong câu, tổng hợp thông tin của chúng theo trọng số tương quan, và tất cả các vị trí đều có thể tính toán đồng thời. Một tầng attention kết hợp với một tầng mạng truyền thẳng (feedforward) tạo thành một khối cơ bản, xếp chồng hàng chục tầng như vậy sẽ tạo thành một Transformer. Việc tính toán song song đã giúp tận dụng triệt để GPU, tạo tiền đề về mặt kỹ thuật cho việc mở rộng quy mô model lên hàng trăm tỷ tham số sau này.
Sự khác biệt giữa Encoder và Decoder cũng nằm ở cơ chế attention: khi Encoder đọc câu nguồn, mỗi vị trí đều có thể nhìn thấy toàn bộ câu, attention mang tính hai chiều; còn khi Decoder sinh dữ liệu, mỗi vị trí chỉ có thể nhìn thấy chính nó và các từ đã được sinh ra trước đó, attention mang tính nhân quả (sơ đồ phạm vi quan sát ở phần tiếp theo sẽ minh họa sự khác biệt này qua ví dụ câu cụ thể). Đơn vị thực tế mà model xử lý là token do tokenizer phân tách ra, trong tiếng Trung tương ứng với khoảng một chữ đến một từ, còn tiếng Anh tương ứng với khoảng một từ hoặc một phần của từ.
02 2018–2020: Sự phân hóa của ba lộ trình kỹ thuật
Khoảng năm 2018, các nhà nghiên cứu phát hiện ra rằng hai thành phần của Transformer có thể tách rời để sử dụng độc lập, và mỗi thành phần phù hợp với các tác vụ tiền huấn luyện khác nhau. Từ đó hình thành ba lộ trình kỹ thuật. Chúng gần như tương đồng về cấu trúc tầng, sự khác biệt thực chất chỉ nằm ở hai điểm: Phạm vi quan sát của attention , tức là khi đọc đầu vào có thể thấy được phần văn bản phía sau hay không; và Tác vụ tiền huấn luyện , tức là trong quá trình huấn luyện mô hình thực hiện điền vào chỗ trống hay viết tiếp. Hai điểm này quyết định model phù hợp với tác vụ nào.
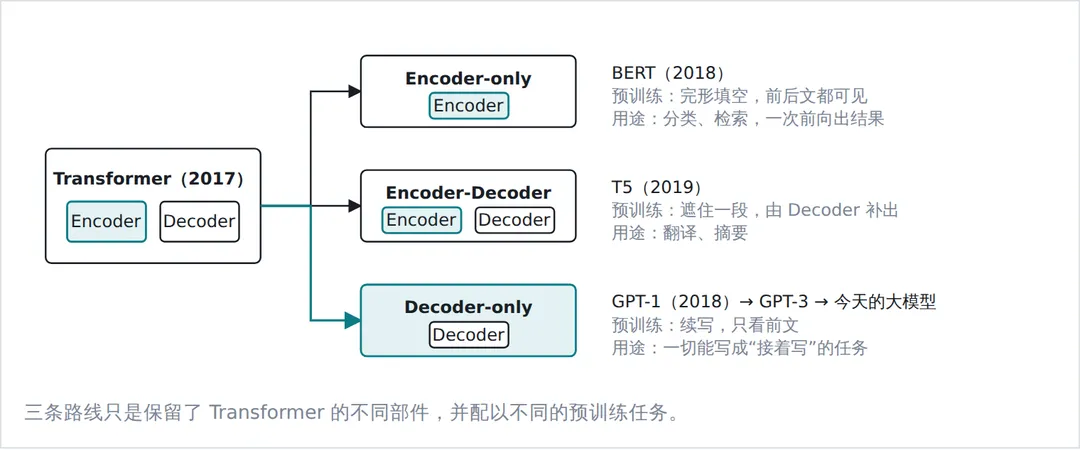
Lộ trình Encoder-only do BERT (tháng 10 năm 2018) tiên phong, chỉ giữ lại nửa phần đọc, tác vụ tiền huấn luyện là điền vào chỗ trống: che ngẫu nhiên một phần từ trong câu để model dựa vào ngữ cảnh trước sau khôi phục lại. Lộ trình Encoder-Decoder lấy T5 (tháng 10 năm 2019) làm đại diện, giữ lại cả hai nửa, tác vụ tiền huấn luyện là che một đoạn văn rồi để Decoder bù vào, phù hợp với các tác vụ có cấu trúc đầu vào và đầu ra cố định như dịch thuật hay tóm tắt. Lộ trình Decoder-only do GPT-1 (tháng 6 năm 2018) mở đầu, chỉ giữ lại nửa phần viết, tác vụ tiền huấn luyện chính là viết tiếp: cho trước đoạn văn trước và dự đoán từ tiếp theo. Ở đây cũng cần làm rõ một khái niệm dễ gây nhầm lẫn: Decoder trong mô hình Decoder-only vốn không còn chứa cross-attention vì không có Encoder nào để đọc, về mặt cấu trúc nó tương đương với một Encoder được áp dụng causal mask, việc tiếp tục gọi là Decoder chỉ là do yếu tố lịch sử.
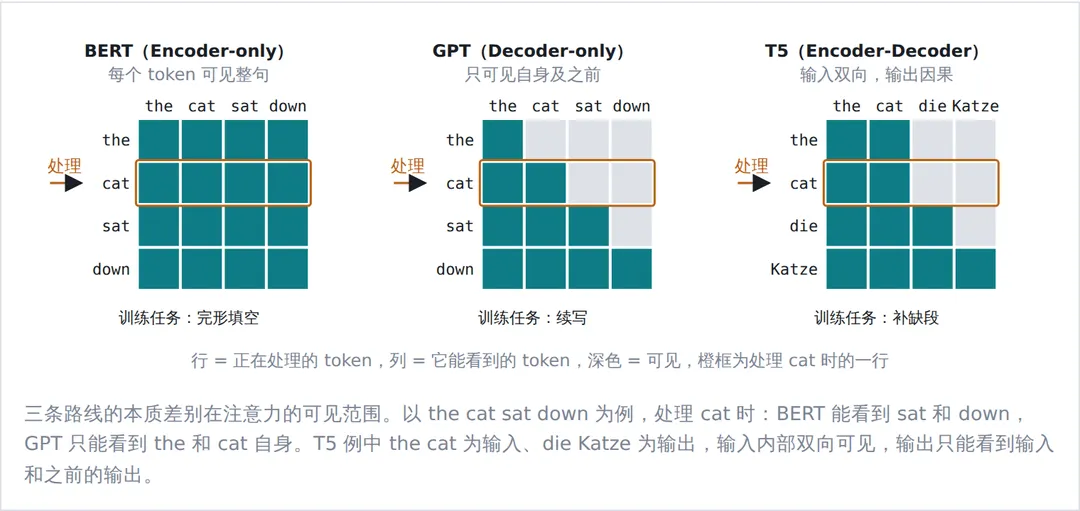
Lộ trình Encoder-only đã rút khỏi cuộc đua năng lực tổng quát, nhưng đặc tính chạy một lượt truyền thẳng với độ trễ cỡ mili-giây giúp nó vẫn được ứng dụng rộng rãi trong các kịch bản phân loại/phán đoán thông lượng cao như tìm kiếm, gợi ý, kiểm duyệt nội dung; ModernBERT ra mắt năm 2024 là một minh chứng. Cách thức sử dụng loại model này là "tiền huấn luyện kết hợp fine-tune": BERT thu được sau tiền huấn luyện vốn chỉ biết điền từ, để nó thực hiện một phán đoán cụ thể, cần gắn thêm một classification head ở ngõ ra và dùng dữ liệu gán nhãn của tác vụ đó để fine-tune toàn bộ mạng. Model sau khi fine-tune chỉ đọc đầu vào một lần và xuất trực tiếp xác suất của các phân loại, nhưng nó chỉ làm được tác vụ duy nhất này; tập hợp nhãn đã được cố định ngay từ lúc huấn luyện, nếu đổi sang tác vụ khác thì bắt buộc phải gán nhãn lại và fine-tune lại từ đầu.
03 Decoder-only trở thành xu hướng chủ lưu
Quá trình suy luận: prefill và decode
Đối với mô hình Decoder-only, "hiểu đầu vào" và "tạo đầu ra" không tương ứng với hai mạng riêng biệt, mà là hai giai đoạn trong quá trình suy luận của cùng một mạng với cùng một bộ tham số.
Giai đoạn thứ nhất gọi là điền sẵn : toàn bộ prompt được đưa vào mạng một lần duy nhất, tất cả các token được tính toán song song, vector key và value của từng tầng được lưu vào bộ nhớ đệm (KV cache) để các token phía sau tra cứu. Giai đoạn này thâm dụng tính toán, tương ứng với độ trễ token đầu tiên mà người dùng cảm nhận được.
Giai đoạn thứ hai gọi là decode : mạng dựa vào KV cache để sinh từng token một, mỗi khi sinh ra một token sẽ bổ sung key và value của nó vào bộ nhớ đệm. Giai đoạn này diễn ra tuần tự và thâm dụng bộ nhớ, mỗi bước đều phải đọc toàn bộ trọng số và toàn bộ bộ nhớ đệm, tương ứng với tốc độ sinh từ mà người dùng cảm nhận được.
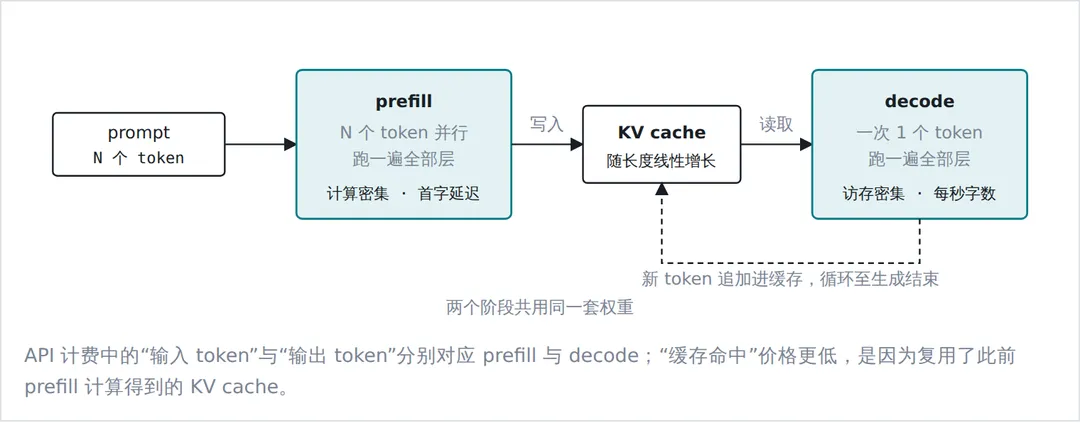
Việc "đầu ra đọc đầu vào" cũng diễn ra tương tự trong cấu trúc Decoder-only, chỉ là không còn thông qua cross-attention nữa mà thông qua self-attention thông thường: mỗi token của câu trả lời và prompt cùng nằm trên một chuỗi, có thể trực tiếp tra cứu key và value ở các vị trí của prompt. Cái giá phải trả là bên trong prompt chỉ có thể quan sát một chiều, nhưng sau khi xếp chồng hàng chục tầng, vị trí cuối cùng của prompt đã tích hợp được thông tin của toàn bộ phần trước, nên trên thực tế hạn chế này không trở thành điểm yếu rõ rệt.
Lý do trở thành xu hướng chủ lưu
- Tín hiệu huấn luyện dày đặc hơn. Tác vụ viết tiếp có thể tạo ra một đề bài ở mọi vị trí trong câu, mỗi từ đều là mục tiêu dự đoán cho phần văn bản đi trước; trong khi tác vụ điền từ chỉ có thể tạo đề bài ở một số ít vị trí bị che khuất. Với cùng một lượng văn bản, phương pháp trước mang lại tín hiệu huấn luyện nhiều hơn đáng kể.
- Định dạng tác vụ thống nhất. Đối thoại, hoàn thiện mã nguồn, suy luận chuỗi tư duy, gọi công cụ đều có thể biểu diễn dưới dạng "tiếp tục sinh dữ liệu trên cùng một chuỗi", không cần phải tái định nghĩa ranh giới giữa đầu vào và đầu ra cho từng loại tác vụ. Khả năng in-context learning mà GPT-3 (2020, 175B) thể hiện — tức chỉ cần đưa ra vài ví dụ trong prompt là có thể hoàn thành tác vụ mới — chính là thành quả từ sự thống nhất này.
- Có thể tái sử dụng KV cache. Causal mask đảm bảo key và value của các token đã xử lý không bị ảnh hưởng bởi nội dung tiếp theo, đối thoại nhiều lượt và vòng lặp agent chỉ cần ghi nối tiếp vào. Encoder hai chiều không có đặc tính này, mỗi khi có đầu vào mới đều phải tính toán lại toàn bộ.
So sánh có hệ thống của nhóm nghiên cứu Wang và cộng sự vào năm 2022 đã đưa ra kết luận thực nghiệm: trong điều kiện chỉ tiền huấn luyện phi giám sát quy mô lớn mà không fine-tune chuyên biệt, Decoder-only kết hợp với mục tiêu viết tiếp có khả năng khái quát hóa zero-shot mạnh nhất; còn ưu thế của khả năng quan sát hai chiều kết hợp mục tiêu điền từ chỉ bộc lộ sau khi fine-tune đa tác vụ. Hướng đầu tư của toàn ngành lại tình cờ rơi đúng vào trường hợp đầu tiên.
04 2022–2025: Post-training và model suy luận
ChatGPT là sản phẩm đối thoại được OpenAI ra mắt vào tháng 11 năm 2022, mô hình nền tảng ban đầu là GPT-3.5, sau đó liên tục được cập nhật qua GPT-4, GPT-4o, dòng o cho đến GPT-5.x hiện nay. Kể từ GPT-4, OpenAI không còn công khai chi tiết kiến trúc, nhưng tất cả đều là các model Decoder-only tự hồi quy sinh theo từng token. Năng lực đối thoại của ChatGPT không xuất phát từ việc thay đổi cấu trúc, mà đến từ nhiều vòng post-training sau tiền huấn luyện. Các model suy luận xuất hiện sau năm 2024 như OpenAI o1 và DeepSeek-R1 cũng không thay đổi kiến trúc, mà thông qua học tăng cường để model sinh ra một quá trình suy nghĩ tương đối dài trước khi đưa ra câu trả lời.
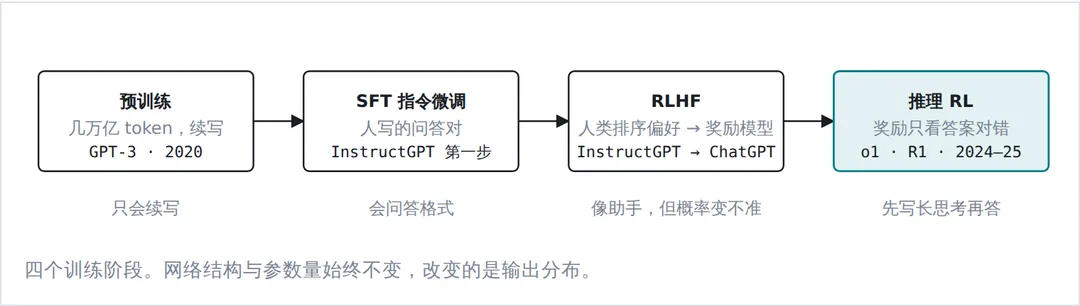
Cách làm của RLHF là: con người xếp hạng nhiều câu trả lời của model, huấn luyện một mô hình phần thưởng để khớp với sở thích của con người, sau đó dùng học tăng cường để điều chỉnh đầu ra của model nghiêng về hướng nhận được phần thưởng cao. Điều này giúp phong cách phản hồi của model gần gũi với sở thích của người gán nhãn, nhưng cũng dẫn đến hai tác dụng phụ đã được chứng minh. Thứ nhất là Giảm khả năng hiệu chuẩn : OpenAI từng đưa ra một nhóm đối chứng trong báo cáo kỹ thuật GPT-4, theo đó độ tin cậy do mô hình tiền huấn luyện đưa ra về cơ bản khớp với tỷ lệ chính xác thực tế, những câu hỏi model khẳng định nắm chắc tám phần thì có khoảng 80% trả lời đúng; nhưng sau quá trình post-training, tính nhất quán này giảm sút rõ rệt. Thứ hai là Tự tin thái quá , bởi vì người gán nhãn có xu hướng ưa chuộng các câu trả lời mang giọng điệu quả quyết.
Bản thân quá trình suy nghĩ của model suy luận vẫn là quá trình sinh tự hồi quy từng token, chỉ là không hiển thị cho người dùng thấy. Nó giúp nâng cao năng lực của model trong các tác vụ có thể kiểm chứng như toán học hay lập trình, nhưng cái giá phải trả là độ trễ của một lượt trả lời tăng từ vài giây lên đến vài phút.
05 2026: Mối quan hệ giữa các model tiên phong và mạch phát triển chính
Lấy hai model mã nguồn mở năm 2026 làm ví dụ — DeepSeek-V4.1-Flash ra mắt vào tháng 9 và Qwen3.8-27B phát hành mã nguồn mở vào tháng 8 — chúng ta có thể thấy rõ mối liên hệ giữa các model tiên phong với mạch phát triển nói trên. Cả hai vẫn là Transformer tự hồi quy sinh theo từng token; quy trình hai giai đoạn prefill và decode cũng như quy trình post-training đều áp dụng nguyên vẹn. Các cải tiến kiến trúc những năm gần đây không hề thay đổi bộ khung này, mà tập trung vào các thành phần bên trong khung sườn, với mục tiêu chung: giảm khối lượng tính toán và mức chiếm dụng VRAM trong khi vẫn duy trì năng lực tương đương.
Các thay đổi tập trung nhiều nhất ở hai điểm. Một là Chuyển mạng truyền thẳng sang MoE (Mixture of Experts) : tách mạng truyền thẳng ở mỗi tầng thành hàng trăm mạng con, mỗi token chỉ kích hoạt một vài mạng con trong số đó, giúp tách rời tổng lượng tham số khỏi khối lượng tính toán trên mỗi token. DeepSeek-V4.1-Flash với tổng 552B tham số nhưng chỉ kích hoạt 16B trên mỗi token chính là thuộc loại này; trong khi Qwen3.8-27B lại là mô hình dày đặc kích hoạt toàn bộ 27B. Hai là Nén KV cache : trong các kịch bản context dài và agent, dung lượng bộ nhớ đệm thậm chí vượt qua cả dung lượng trọng số model, các bên lựa chọn những giải pháp khác nhau. DeepSeek áp dụng nén vector tiềm ẩn chiều thấp kết hợp chọn lọc thưa, đồng thời trong V4.1-Flash đã dùng 20 tầng đầu làm causal encoder, key-value của 20 tầng sau được chiếu từ đó ra, giúp giai đoạn prefill chỉ cần chạy một nửa mạng; Qwen kể từ phiên bản Qwen3-Next đã thay thế 3 trong mỗi 4 tầng bằng linear attention (Gated DeltaNet), dùng trạng thái có kích thước cố định thay cho bộ nhớ đệm lưu theo từng token.
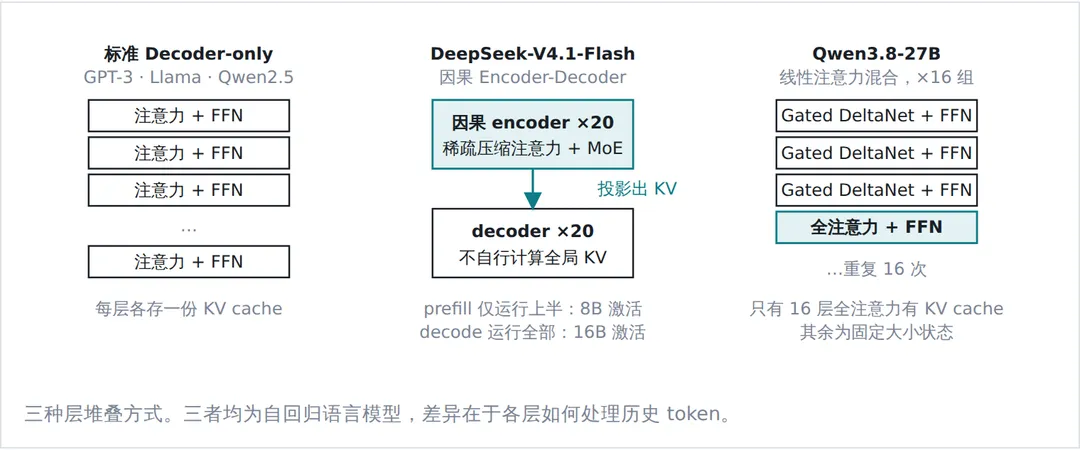
Khái niệm "encoder-decoder" của V4.1-Flash mang ý nghĩa khác với cấu trúc hai giai đoạn dành cho dịch máy ở mục 01: encoder của nó vẫn dùng causal mask, toàn bộ model vẫn là mô hình ngôn ngữ tự hồi quy chuẩn mực, chỉ là các tầng decoder không còn tự tính toán key-value toàn cục nữa. Để đánh giá một model thuộc lộ trình nào, ta không nhìn vào tên gọi mà nhìn vào hai điểm: cơ chế attention có dùng causal mask hay không, và kết quả có được sinh ra theo từng token hay không. DeepSeek và Qwen hoàn toàn đồng nhất với GPT-3 ở cả hai điểm này; còn Jev lại khác biệt ở điểm thứ hai.
06 Jev
Vì sao phải xây dựng một dòng model hoàn toàn khác biệt
TypeSafe AI đã ra mắt Jev vào ngày 15 tháng 9 năm 2026. Nhà sáng lập Diogo Almeida là một trong những tác giả của bài báo InstructGPT và từng phụ trách mảng post-training tại OpenAI. Câu mở đầu trong bài viết công bố đã chỉ rõ trăn trở của họ: "Models have been superhuman at chat for years, so where is all the automation?" (Các mô hình đã vượt xa con người ở khả năng trò chuyện suốt nhiều năm qua, vậy sự tự động hóa đang ở đâu?). Họ giải thích rằng, các model được huấn luyện bằng RLHF ngay từ thiết kế đã nhằm mục đích hỗ trợ con người: reward model khớp với sở thích của người đánh giá, model học cách làm cho câu trả lời trông có vẻ đúng, thay vì để xác suất phản ánh tỷ lệ chính xác thực tế. Nếu một model có thể hoàn thành nhiệm vụ trong 95% trường hợp nhưng không thể chỉ ra 5% sai sót nằm ở đâu, thì nó không thể đưa vào tự động hóa không người giám sát. TypeSafe xếp phương pháp RLCD (Reinforcement Learning for Calibrated Decisions) của mình ngang hàng với RLHF và RLVR như một mô thức post-training thứ ba: hai phương pháp trước lần lượt tối ưu hóa sở thích của con người và phần thưởng có thể kiểm chứng, còn RLCD tối ưu hóa các quyết định đã được hiệu chuẩn, huấn luyện ra model "không sinh văn bản, mà trả về quyết định cùng xác suất". Cái tên "System One" bắt nguồn từ thuyết hai hệ thống tư duy nhanh và chậm của Kahneman, trong đó mô hình lớn (LLM) được xếp vào Hệ thống 2 (chậm), còn Jev được định vị là Hệ thống 1 (nhanh).
Trạng thái và câu hỏi
Mỗi yêu cầu sẽ cung cấp một đoạn state (tài liệu cần phán đoán, có thể là chuỗi ký tự, đối tượng JSON hoặc mảng), sau đó đính kèm số lượng câu hỏi tùy ý. Các câu hỏi được giới hạn trong ba dạng nguyên thủy:
| Nguyên tắc | Loại vấn đề | Quay lại | Ví dụ |
|---|---|---|---|
| Choice | Chọn một trong tối đa 255 phương án | Xác suất của từng phương án, cùng một mức độ tin cậy | Phiếu yêu cầu này nên chuyển cho đội ngũ nào |
| Score | Đánh giá theo 2–10 mức thang có thứ tự | Điểm số tính theo trọng số xác suất | Mức độ không hài lòng của khách hàng |
| Noul | Đánh giá xem một nhận định có đúng hay không | Một xác suất từ 0–1 | Tin nhắn này có khẩn cấp hay không |
Một ví dụ trong tài liệu: cùng lúc đặt ba câu hỏi cho cùng một tin nhắn chăm sóc khách hàng, kết quả trả về là phân phối xác suất trên từng câu hỏi, chứ không phải văn bản.
// Request{""state": "Hi, I've been trying to connect my Stripe account for 3 daysand the integration keeps failing. I'm losing sales. Please help ASAP.","questions": {"department": {"type": "choice","instructions": "Which team should handle this","criteria": { "billing": "…", "technical": "…", "sales": "…" }},"frustration": {"type": "score","instructions": "How frustrated the customer appears","criteria": [ "Calm", "Frustrated but civil", "Very angry" ]},"is_urgent": {"type": "noul","instructions": "The message conveys urgency"}}### // Response{""answers": {"department": {"choice": "technical","confidence": 0.78,"probabilities": { "technical": 0.85, "billing": 0.15, "sales": 0.0 }},"frustration": {"score": 1.0,"probabilities": { "0": 0.0, "1": 1.0, "2": 0.0 }},"is_urgent": { "noul": 1.0 }}###confidence được tính từ hình dạng của phân phối xác suất: khi phân phối đồng đều thì bằng 0, khi tập trung hoàn toàn thì bằng 1; tài liệu khuyến nghị phân luồng theo chỉ số này: độ tin cậy cao thì tự động thực thi, độ tin cậy thấp thì chuyển cho con người xử lý. Các chỉ số chính thức: phần lớn truy vấn mất khoảng 100 ms, việc thêm câu hỏi trong cùng một request hầu như không làm tăng độ trễ; 0,042 USD cho mỗi triệu token đầu vào, đầu ra miễn phí; chỉ hỗ trợ văn bản, chủ yếu là tiếng Anh; không mở mã nguồn.
Chia nhỏ câu hỏi
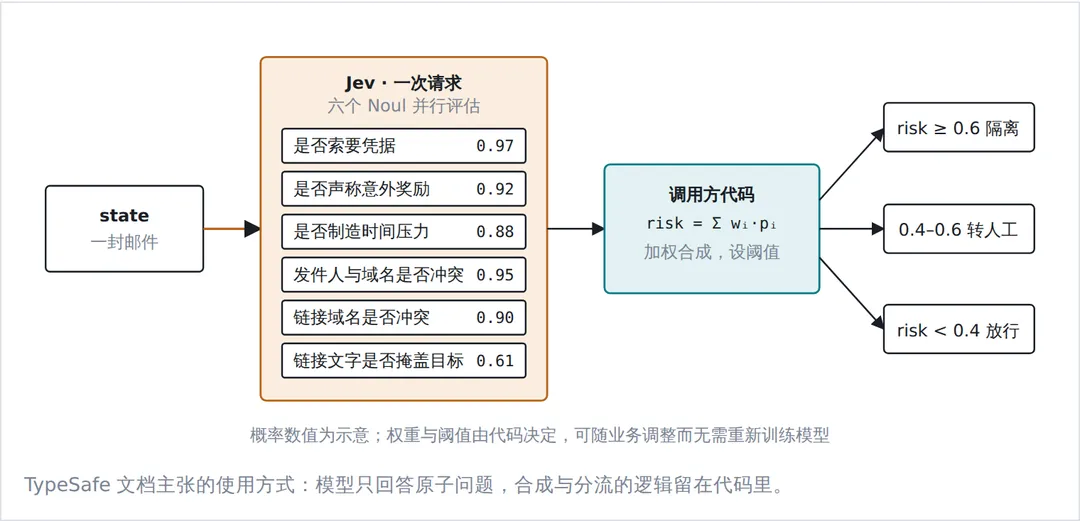
Hình thái mà TypeSafe ủng hộ là để code nắm quyền kiểm soát luồng, chỉ gọi model ở những chỗ cần phán đoán theo trực giác thông thường, và mỗi câu hỏi đều phải được chia nhỏ đến mức nguyên tử. Lấy việc nhận diện email rác làm ví dụ, thay vì hỏi "Đây có phải là email rác không?", hệ thống sẽ hỏi đồng thời sáu câu Noul trên cùng một email: có đòi hỏi thông tin đăng nhập không, có tuyên bố phần thưởng bất ngờ không, có tạo áp lực thời gian không, người gửi và tên miền có xung đột không, tên miền trong liên kết có xung đột không, chữ hiển thị của liên kết có che giấu đích đến thực tế không. Sáu câu hỏi được đánh giá song song, trả về sáu xác suất, sau đó code sẽ tính trọng số để tổng hợp thành điểm rủi ro và áp ngưỡng.
Mối quan hệ với mô hình ngôn ngữ
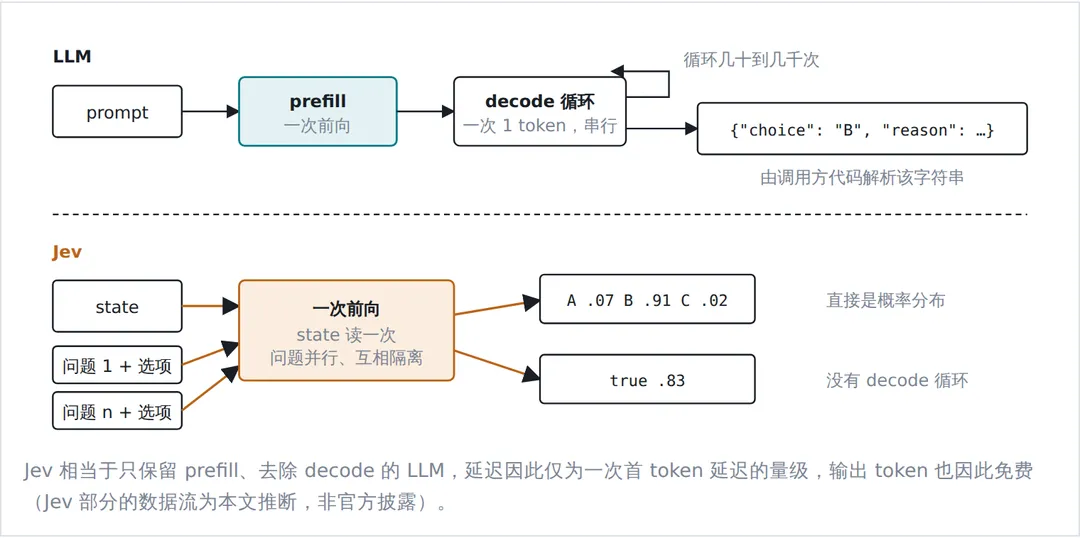
Rất có khả năng Jev sử dụng một Transformer tiền huấn luyện làm mạng nền tảng, và khả năng hiểu bất kỳ câu hỏi ngôn ngữ tự nhiên nào của nó cũng bắt nguồn từ đây — phần này có cùng gốc rễ với LLM. Điểm khác biệt nằm ở cách tạo ra kết quả. Dù LLM xuất ra văn bản thông thường hay JSON, nó đều phải trải qua giai đoạn decode để sinh từng token một, sau đó bên gọi mới phân tích cú pháp chuỗi đó; còn Jev sau bước prefill sẽ không bước vào decode, mà đọc trực tiếp phân phối xác suất trên từng lựa chọn của mỗi câu hỏi từ mạng lưới. Điều này hoàn toàn khác với việc áp đặt một schema bắt buộc cho LLM (như JSON mode, structured output): cách sau chỉ ràng buộc định dạng của chuỗi được sinh ra, quá trình sinh từng token không bớt đi bước nào; trong khi cách trước hoàn toàn không có quá trình sinh. Trong bài viết công bố, họ gọi sự khác biệt này là "lấy mẫu tuần tự" và "lấy mẫu song song", và khái niệm "type-safe" cũng xuất phát từ đây: đầu ra bị giới hạn trong các lựa chọn được chỉ định sẵn, không thể xuất hiện nội dung nào nằm ngoài các lựa chọn đó.
Một đối tượng tham chiếu khác là bộ phân loại BERT ở mục 02. Hình thái tính toán của cả hai là gần nhau nhất, đều đọc đầu vào một lần và đưa ra trực tiếp xác suất phân loại. Điểm khác biệt nằm ở cách chỉ định tác vụ: tác vụ của bộ phân loại BERT được ghi vào tham số trong quá trình fine-tune, các danh mục là cố định, hễ đổi một phán đoán khác là phải gán nhãn và huấn luyện lại; còn câu hỏi và các lựa chọn của Jev lại là một phần của request, được viết bằng ngôn ngữ tự nhiên khi gọi. Tính tổng quát này đến từ mạng nền tảng cấp LLM, trong khi BERT chỉ được tiền huấn luyện dạng điền vào chỗ trống với quy mô vài trăm triệu tham số, nên không thể hiểu được những chỉ dẫn như "tên hiển thị của người gửi và tên miền email có xung đột hay không". Đi kèm với đó cũng là sự đánh đổi: trên các tác vụ cố định có đầy đủ dữ liệu gán nhãn, một mô hình BERT được fine-tune chuyên biệt thường sẽ chuẩn xác hơn.
Hiểu về Jev
Phía phát triển không công bố kiến trúc chính thức, mà chỉ đưa ra vài câu ngắn gọn: "kiến trúc model mới, bộ lấy mẫu song song, phương pháp huấn luyện RLCD". Nhưng từ hành vi của API, ta có thể suy đoán hình thái của nó: việc tăng số lượng câu hỏi trong cùng một request hầu như không làm tăng thời gian xử lý, chứng tỏ state chỉ được đọc một lần và các câu hỏi được xử lý song song; 255 lựa chọn cũng tốn thời gian tương đương với 2 lựa chọn, chứng tỏ không có quá trình giải mã từng token; vị trí của các lựa chọn ảnh hưởng đến độ chính xác, điều này khớp với đặc trưng của Transformer nhân quả. Cách triển khai khả dĩ hơn cả là: sử dụng Transformer nhân quả tiền huấn luyện làm mạng nền tảng, thực hiện prefill một lần cho state, các câu hỏi cùng với các lựa chọn được đưa vào dưới dạng các nhánh song song để forward cùng lúc, đọc điểm số ở cuối mỗi lựa chọn, áp dụng softmax cho các lựa chọn của cùng một câu hỏi, và dùng dữ liệu tổng hợp để huấn luyện độ hiệu chuẩn của xác suất. Cái gọi là "kiến trúc mới" mà họ tuyên bố nhiều khả năng chỉ là sự kết hợp giữa hệ thống phân nhánh, đầu đọc và mục tiêu huấn luyện này, chứ không phải một cơ chế attention hoàn toàn mới.
Từ đó, chúng ta có thể định vị tổng thể cho Jev. Nó không giới thiệu một cấu trúc Transformer mới, mà đã biến cách dùng vốn tồn tại từ lâu dưới dạng "hack" — "đặt câu hỏi trắc nghiệm cho mô hình ngôn ngữ, chỉ đọc xác suất mà không để nó sinh văn bản" — thành một sản phẩm hoàn chỉnh, đồng thời lấy việc hiệu chuẩn xác suất làm mục tiêu huấn luyện; hai điều này lại chính là thứ mà các LLM hướng tới hội thoại bấy lâu nay không hề bận tâm. Cả đánh giá chính thức lẫn độc lập đều cho thấy, trên các tác vụ phán đoán đã được chia nhỏ, độ chính xác của nó tương đương với các model tiên phong ở mức ngân sách suy luận trung bình, trong khi chi phí và độ trễ thấp hơn khoảng hai bậc độ lớn; song ở những lĩnh vực không quen thuộc, xác suất có thể bị sai lệch, và nó cũng không thể tính toán số học hay suy luận nhiều bước. Nó giữ lại khả năng hiểu của LLM, loại bỏ phần sinh nội dung, do đó không thể viết, không thể suy nghĩ, không thể chạy như một agent, đổi lại là độ trễ chỉ ở mức hàng trăm mili-giây cùng các giá trị xác suất có thể trực tiếp đưa vào các câu lệnh điều kiện của chương trình.
07 Một đối chiếu: Laya
Mục 06 đã tách Jev thành hai phần: một mạng nền tảng cấp LLM, và một phương thức xuất dữ liệu trực tiếp đọc ra xác suất chỉ sau một lần forward. Ba ngày sau khi Jev ra mắt, vào ngày 18 tháng 9, Nandakishor M từ Convai Innovations đã phát hành Laya dưới dạng mã nguồn mở theo giấy phép Apache 2.0, được định vị là "công cụ ra quyết định System 1 mã nguồn mở với độ trễ 33 ms". Tác giả cho biết ý tưởng bắt nguồn từ nghiên cứu năm 2025 của mình, còn cộng đồng thì thường gọi đây là phiên bản mã nguồn mở của Jev. Phương thức xuất dữ liệu của nó khá tương đồng với những suy đoán của bài viết này về Jev, còn mạng nền tảng lại là một encoder công khai với quy mô nhỏ hơn rất nhiều.
Kiến trúc của Laya có thể đọc thấy trực tiếp từ mã nguồn mở. Mạng nền tảng là ModernBERT-large, một encoder hai chiều quy mô khoảng 400 triệu tham số, tức phiên bản hiện đại của hướng tiếp cận Encoder-only ở mục 02; bên trên gắn thêm một decision head nhỏ. Mỗi câu hỏi được ghép thành một chuỗi: loại câu hỏi và hướng dẫn nằm ở đầu, các lựa chọn ở giữa, trước mỗi lựa chọn đặt một token [MASK], và state được nối ở cuối cùng. Sau khi chuỗi đi qua encoder và decision head, vector ẩn tại mỗi vị trí [MASK] sẽ được trích xuất để chấm điểm, rồi áp dụng softmax cho tất cả các lựa chọn của cùng một câu hỏi để thu được phân phối xác suất. Ba nguyên ngữ này hoàn toàn giống Jev, và mục tiêu huấn luyện cũng là hiệu chuẩn xác suất. Mỗi lần nó chỉ đọc tối đa 512 token, tương đương độ dài của một email. Phiên bản phát hành đưa ra các xác suất nhìn chung bị lệch cao (tức mức độ tự tin tuyên bố cao hơn tỷ lệ chính xác thực tế), tác giả khuyến nghị người dùng nên hiệu chuẩn lại trên dữ liệu của chính mình trước khi ra quyết định dựa trên các xác suất này.
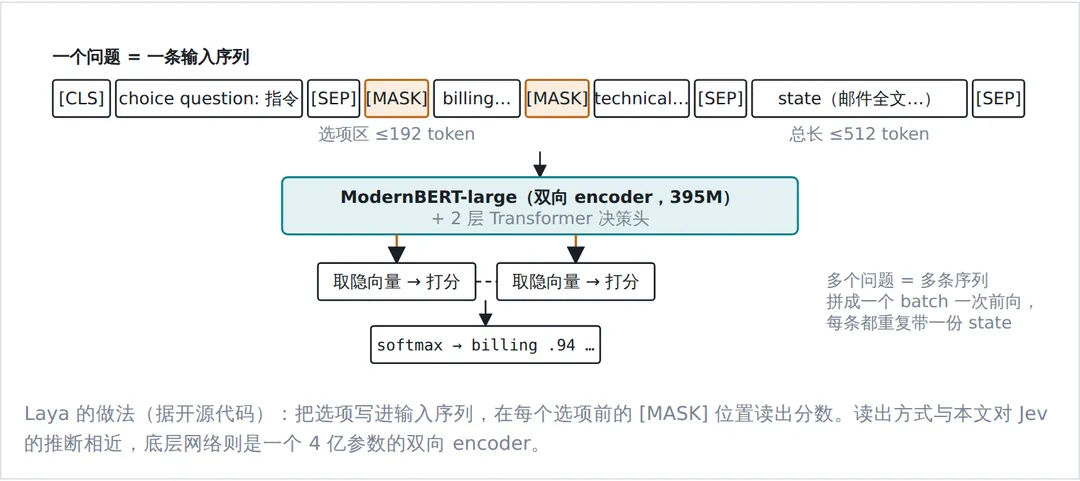
Cách làm của Laya (theo mã nguồn mở): đưa các lựa chọn vào chuỗi đầu vào, đọc điểm số tại vị trí [MASK] phía trước mỗi lựa chọn. Phương thức đọc ra tương tự như suy đoán của bài viết này về Jev, còn mạng nền tảng là một encoder hai chiều với 400 triệu tham số.
Theo cách phân loại ở phần trước, Laya là một bước tiến xa hơn của bộ phân loại BERT: đưa các lựa chọn vào đầu vào thay vì ghi vào tham số, nhờ đó không cần phải huấn luyện lại cho từng tác vụ riêng biệt. Bước đi này chính là điểm khác biệt giữa Jev và bộ phân loại BERT được nêu ở mục 06, và Laya đã đi cùng một bước đó bằng một encoder 400 triệu tham số. Xét về cách tạo ra kết quả, nó tương tự với suy đoán của bài viết về Jev: một lần forward, đọc xác suất theo từng lựa chọn, lấy hiệu chuẩn làm mục tiêu huấn luyện. Điểm khác biệt nằm ở mạng nền tảng. Số lượng tham số và kiến trúc của Jev đều chưa được công bố, bài viết này căn cứ vào hiệu năng zero-shot của nó để suy đoán rằng nó dùng Transformer nhân quả cấp LLM làm nền tảng; còn nền tảng của Laya đã rõ ràng: một encoder hai chiều 400 triệu tham số, chỉ mới trải qua tiền huấn luyện dạng điền vào chỗ trống.
Cùng một phương thức xuất dữ liệu khi đặt trên một mô hình BERT 400 triệu tham số thì hiệu năng phán đoán zero-shot kém xa Jev, kết quả tốt nhất mà tác giả công bố cũng đến từ phiên bản đã được fine-tune trên tập benchmark; còn bản thân phương thức xuất dữ liệu thì chỉ cần dùng encoder mã nguồn mở kết hợp với một readout head là có thể thực hiện được, Laya và nhiều dự án tương tự xuất hiện sau đó đều là minh chứng. Đặt hai bên cạnh nhau để đối chiếu, khoảng cách giữa Jev và các bản triển khai mã nguồn mở này không nằm ở phương thức đọc kết quả, mà nằm ở mạng lưới bên dưới phương thức đó: khả năng đọc hiểu bất kỳ câu hỏi nào mà không cần huấn luyện phụ thuộc vào năng lực hiểu ở cấp độ LLM. Đối với người dùng, nếu cần đưa ra phán đoán cố định trên dữ liệu của riêng mình, Laya sau khi fine-tune là một giải pháp mã nguồn mở khả thi; còn nếu cần xử lý zero-shot bất kỳ câu hỏi nào, hiện tại vẫn bắt buộc phải có một mạng nền tảng cấp LLM.
08 Bức tranh toàn cảnh
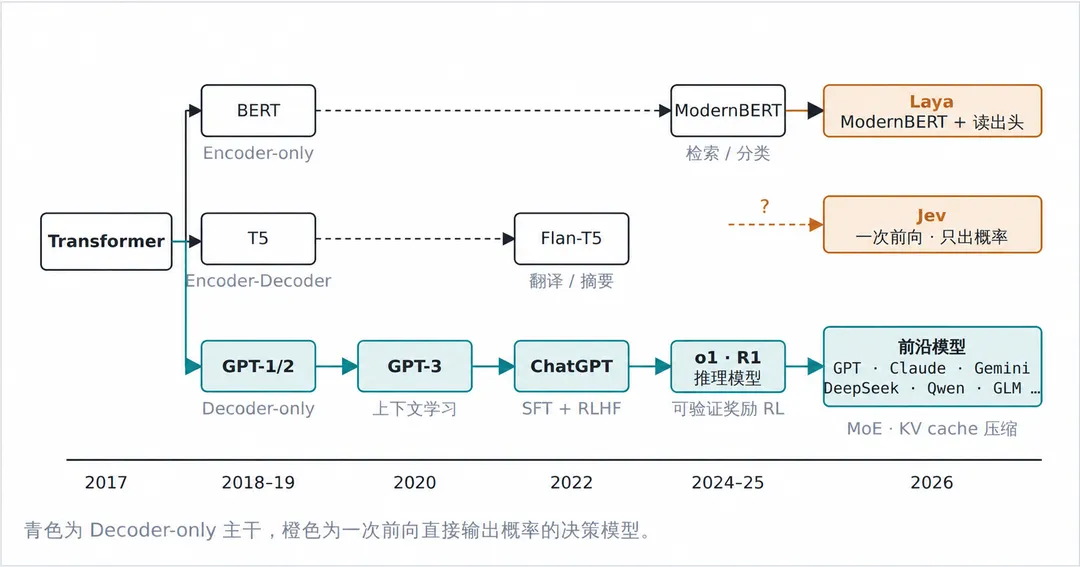
Quay lại câu hỏi ở phần mở đầu. Từ Transformer cho đến nay, khung xương của các model chủ lưu vẫn chưa hề thay đổi: ChatGPT và các mô hình suy luận thay đổi phương pháp huấn luyện, DeepSeek và Qwen thay đổi các thành phần bên trong. Jev giữ lại phần đọc của bộ khung này cùng năng lực hiểu ở cấp độ LLM, đồng thời lược bỏ phần sinh nội dung; phép đối chiếu với Laya cho thấy, việc bỏ đi bước sinh nội dung tự thân nó không hề khó, cái khó vẫn nằm ở năng lực hiểu của mạng nền tảng. Jev không phải là giải pháp thay thế cho LLM, mà là một cách dùng khác của cùng một mạng nền tảng trên một nhóm tác vụ khác. Việc có nên áp dụng hay không phụ thuộc vào việc bản thân tác vụ đó cần khả năng sinh văn bản tự do, hay là cần đưa ra phán đoán giữa các lựa chọn hữu hạn.
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác