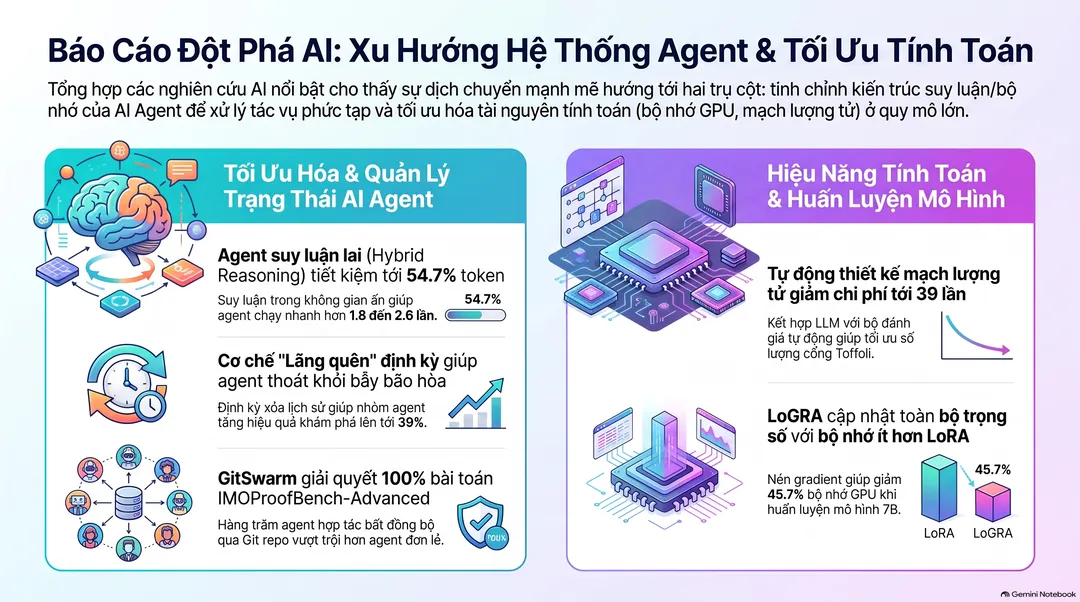
Link bài viết gốc: Top bài báo AI tiêu biểu trong tuần
DAIR.AI · X · @dair_ai · 2026-10-19 00:51
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
1. Quantum Circuit Discovery (Khám phá mạch lượng tử)
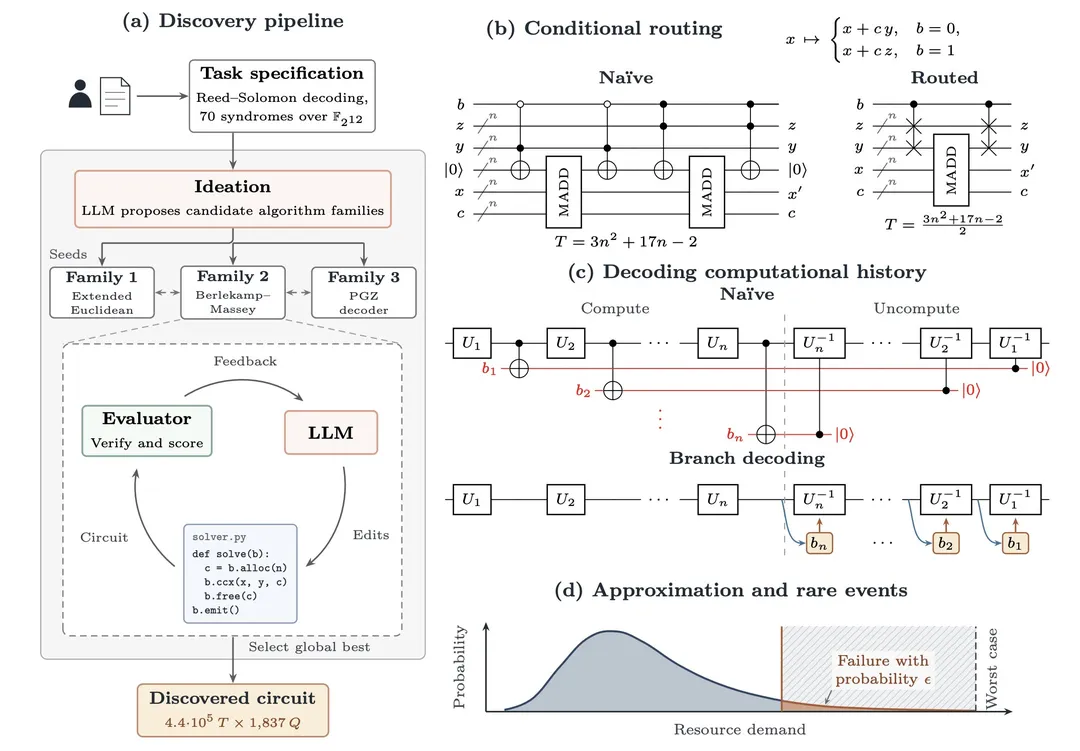
Nhiều thuật toán lượng tử phụ thuộc vào một tập hợp nhỏ các hàm nguyên thủy tính toán, và việc biên dịch các nguyên thủy này thành mạch lượng tử là một bài toán hóc búa vì quá trình tính toán bắt buộc phải khả nghịch. Các nhà nghiên cứu từ Anthropic, Đại học Harvard và QuEra Computing đã kết hợp một LLM đề xuất thiết kế mạch với một bộ đánh giá độc lập để xác minh và chấm điểm từng phương án ứng viên.
- Tìm kiếm tiến hóa: Quá trình tìm kiếm chạy trên các chương trình tạo mạch bằng OpenEvolve, sử dụng Claude Mythos 5 để đề xuất kiến trúc và viết lại chương trình. Mỗi lượt tìm kiếm bắt đầu từ bản đặc tả nhiệm vụ viết tay và một chương trình trống, trong đó thiết kế tối ưu nhất sẽ làm hạt giống cho vòng tiếp theo.
- Mạch đã được xác minh: Bộ đánh giá kiểm tra tính chính xác của từng mạch trước khi chấm điểm theo số lượng cổng Toffoli và số lượng qubit đỉnh. Mọi cải tiến được báo cáo đều là các mạch đã vượt qua bước kiểm tra này.
- Kết quả: Trong tám nhiệm vụ trải dài từ tính toán số học, hóa học, tối ưu hóa, mô phỏng lượng tử đến lý thuyết số, các mạch được phát hiện ở bảy nhiệm vụ đều sử dụng ít cổng Toffoli và qubit hơn so với các thiết kế tối ưu đã biết, giúp giảm tổng chi phí từ 4,1 đến 39 lần. Đối với bộ giải mã Reed-Solomon, quá trình tìm kiếm đã chuyển sang hệ thức truy hồi Berlekamp-Massey, cắt giảm số lượng cổng Toffoli từ 5,1 triệu xuống còn 440 nghìn.
- Tầm quan trọng: Ở nhiệm vụ thứ tám, quá trình tìm kiếm đã phát hiện ra kiến trúc khả nghịch mới cho phép nghịch đảo modulo trên trường nguyên tố, giúp thuật toán divsteps (một thuật toán cổ điển trước đây không thực tế cho số học nguyên khả nghịch) trở nên khả thi và cải thiện sự đánh đổi giữa Toffoli - qubit. Các tác giả cho rằng một số chi phí bề mặt trong số học lượng tử thực chất phản ánh hạn chế của các cấu trúc khả nghịch hiện hành, chứ không phải hạn chế của chính thuật toán.
bài báo | Bài viết gốc
2. LongHarness
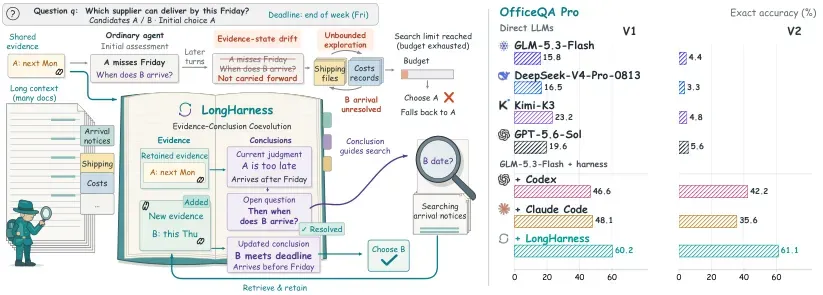
Các agent thực hiện suy luận trên các tập tài liệu có context window lớn hơn thường gom chung bằng chứng truy xuất được và các kết luận đang phát triển vào một lịch sử tương tác ngày càng phình to. Các nhà nghiên cứu từ Phòng thí nghiệm AI Thượng Hải, Đại học Phục Đán và các tổ chức hợp tác đã đề xuất LongHarness, một framework model-agnostic dành cho các ngữ liệu từ 100 triệu token trở lên, giúp lưu trữ bằng chứng và kết luận dưới dạng các trạng thái tường minh.
- Hai dạng lỗi: Các tác giả chỉ ra hiện tượng khám phá không giới hạn (việc truy xuất liên tục mở rộng lịch sử nhưng không lấp đầy được lỗ hổng thông tin liên quan) và trôi dạt trạng thái bằng chứng (bằng chứng ban đầu hoặc các chỉnh sửa sau này không còn tác động đến kết luận hiện tại).
- Bằng chứng - kết luận đồng tiến hóa: Các kết luận mở quyết định những gì cần truy xuất tiếp theo, và mỗi bằng chứng mới sẽ củng cố hoặc hiệu chỉnh kết luận đã đưa ra yêu cầu đó. Các bước trong vòng đời bằng chứng giúp duy trì tính cập nhật và khả năng truy xuất nguồn gốc của các bằng chứng tích lũy trong toàn bộ quá trình tương tác.
- Cùng model, điểm số cao hơn: Khi sử dụng GLM-5.3-Flash, so với suy luận trực tiếp, độ khớp chính xác trên OfficeQA Pro tăng từ 15,8% lên 60,2% ở V1, và từ 4,4% lên 61,1% ở V2. LongHarness đạt điểm cao hơn Claude Code 12,0 điểm ở V1 và cao hơn Codex 18,9 điểm ở V2, trong khi Qwen3.8-Flash đạt 61,7% ở V1.
- Tầm quan trọng: Những cải tiến này đến từ chính framework trong khi backbone model vẫn giữ nguyên. Các đội ngũ đang xây dựng agent để xử lý context dài trên các ngữ liệu nội bộ quy mô lớn có thể đạt được những bước tiến vượt bậc bằng cách quản lý tường minh bằng chứng thay vì phụ thuộc vào lịch sử trò chuyện ngày một dài thêm.
bài báo | Bài viết gốc
3. Hybrid Reasoning Agents (Agent suy luận lai)
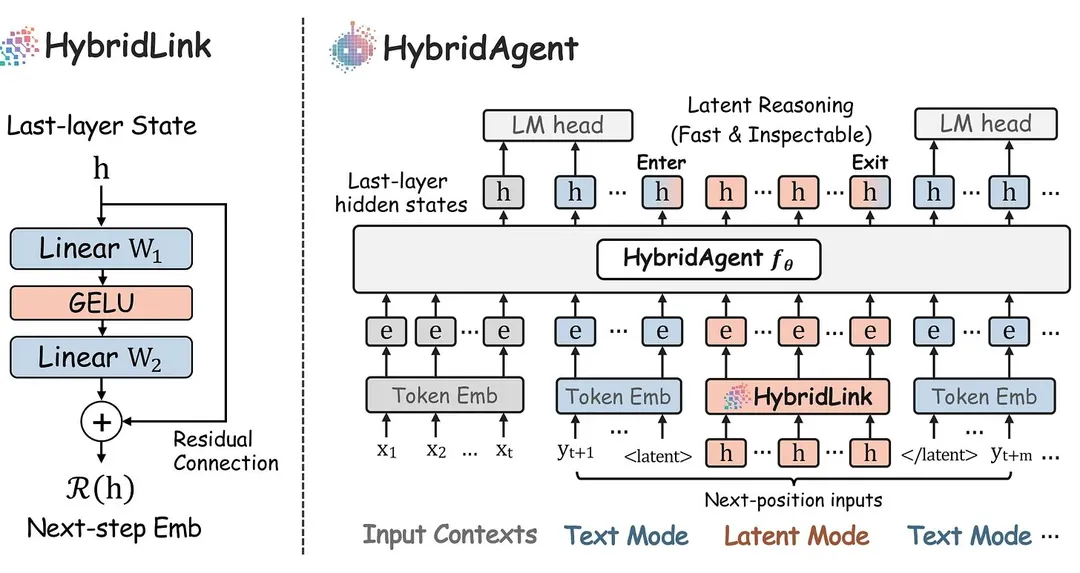
Các LLM agent hiện nay thường viết ra từng bước suy luận dưới dạng văn bản trước khi tìm kiếm, chạy code hoặc thực hiện hành động, điều này tiêu tốn cả token lẫn thời gian. Các nhà nghiên cứu từ Đại học Stanford, Together AI và các tổ chức đối tác đã đề xuất các agent suy luận lai (Hybrid Reasoning Agents), có khả năng suy luận nội bộ trong latent space và chỉ chuyển sang văn bản khi gọi công cụ hoặc đưa ra câu trả lời.
- HybridLink: Một module gọn nhẹ có thể chuyển đổi model giữa chế độ tiềm ẩn (latent) và chế độ văn bản ngay trong một lần sinh duy nhất. Bộ nhớ làm việc liên tục (continuous working memory) duy trì cả hai loại context giữa các lượt, các lệnh gọi công cụ vẫn giữ ở dạng văn bản thuần, trong khi các bước suy luận tiềm ẩn vẫn có thể kiểm tra được.
- Huấn luyện hai giai đoạn: HybridSFT trước tiên huấn luyện backbone model phối hợp với HybridLink trong quá trình sinh tích hợp công cụ. Sau đó, HybridRL dạy model biết khi nào nên tư duy trong latent space và khi nào nên hành động thông qua văn bản.
- Kết quả: Trên 3 quy mô model và 11 benchmark (bao gồm toán học, khoa học, y học, tìm kiếm và suy luận của agent), phương pháp này đạt mức cải thiện trung bình 10,4% so với các LLM agent và agent framework hàng đầu (dù dựa trên văn bản hay tiềm ẩn). Model 14B vượt qua baseline agent mạnh nhất tới 17,4% trong các nhiệm vụ suy luận của agent.
- Tầm quan trọng: Các agent này sử dụng ít hơn từ 35,5% đến 54,7% token, chạy nhanh hơn 1,8 đến 2,6 lần và giảm chi phí từ 2,7 đến 3,7 lần. Các nhà nghiên cứu trước đây chủ yếu tập trung vào suy luận tiềm ẩn không dùng công cụ; công trình này chứng minh cách kết hợp hiệu quả vượt trội của nó với việc sử dụng công cụ tiêu chuẩn.
bài báo | Bài viết gốc
4. Harness^2
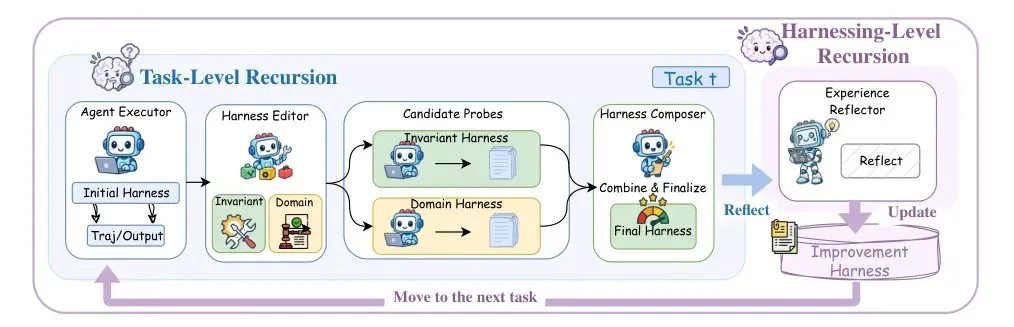
Quá trình tự cải tiến đệ quy của các agent framework thường phụ thuộc vào bộ xác thực (verifier), nhưng các nhiệm vụ thế giới mở khi test lại hoàn toàn mới lạ nên không có sẵn bộ kiểm tra ground-truth. Các nhà nghiên cứu từ Google Cloud AI Research và Đại học Northwestern đã giới thiệu Harness^2, một framework plug-and-play giúp nâng cấp framework ngay tại thời điểm test thông qua hai cấp độ đệ quy liên kết chặt chẽ.
- Đệ quy cấp nhiệm vụ: Bước Propose-Probe-Compose mang tính đối chiếu sẽ đề xuất nhiều sửa đổi cho framework đối với nhiệm vụ hiện tại, kiểm thử chéo giữa chúng và giữ lại tổ hợp hiệu quả nhất. Cơ chế này giúp định hướng các chỉnh sửa một cách đáng tin cậy mà không cần đến verifier chuẩn ground-truth.
- Đệ quy cấp framework: Những bài học kinh nghiệm từ các chỉnh sửa này sẽ cập nhật framework cải tiến liên tục thứ hai, và agent sẽ mang chúng sang các nhiệm vụ tương lai, giúp những cải tiến được duy trì lâu dài thay vì chỉ gói gọn trong một nhiệm vụ cụ thể.
- Kết quả: Thao tác đơn bước giúp GLM-5 và Gemini 3.5 Flash cải thiện hiệu năng so với framework cơ sở trên mọi cấu hình thử nghiệm, với mức tăng cao nhất lên tới 11,5 điểm trên WorkBuddy-Bench, 4,5 điểm trên JobBench và 11,8 điểm trên LAB. Việc chạy song song năm đề xuất sửa đổi ứng viên giúp tăng thêm từ 2,9 đến 3,9 điểm trên WorkBuddy-Bench.
- Tầm quan trọng: Trong cùng phép so sánh, baseline về memory ReasoningBank lại có kết quả thấp hơn framework cơ sở tới 6,6 điểm ở các nhiệm vụ coding. Đối với các đội ngũ đang phát triển framework của riêng mình, bài báo chỉ ra rằng ngay cả khi không có verifier, việc sửa đổi framework tại thời điểm test vẫn có thể mở rộng quy mô hiệu quả khi được cấp thêm ngân sách đệ quy.
bài báo | Bài viết gốc
5. Scaling Discovery Requires Forgetting (Mở rộng quy mô khám phá đòi hỏi sự lãng quên)
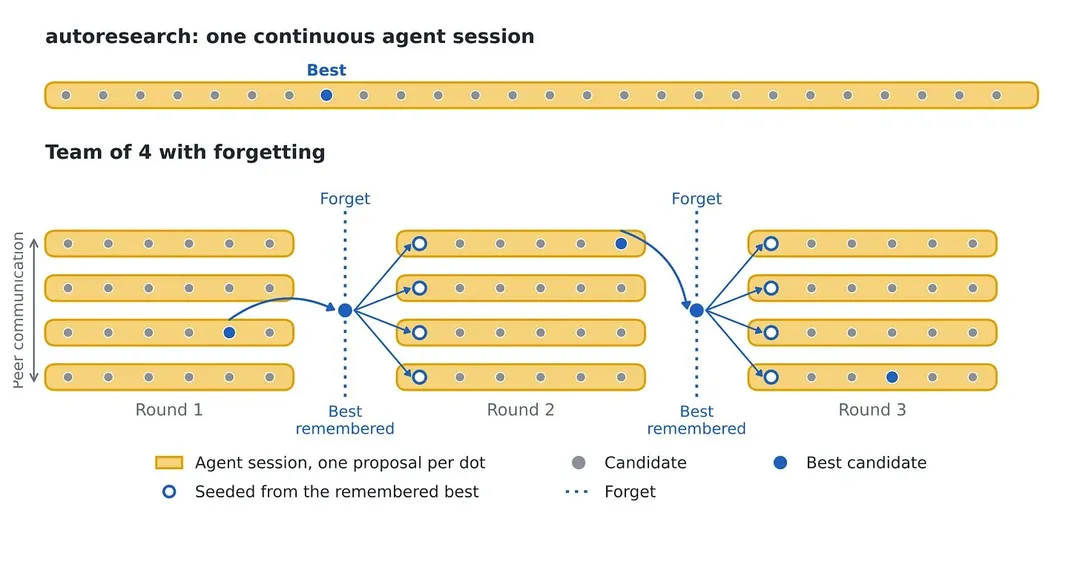
Việc sử dụng coding agent để nghiên cứu tự động hiện có thể chạy liên tục nhiều ngày cho một vấn đề duy nhất, nhưng quá trình tìm kiếm thường chững lại từ sớm mà không cải thiện thêm. Các nhà nghiên cứu từ Đại học California, Berkeley, Đại học Stanford và Bespoke Labs đã chỉ ra rằng giải pháp chính là để agent quên đi.
- Giai đoạn bão hòa: Việc để một agent đơn lẻ lặp lại lâu hơn, chạy các agent song song hay cho phép các agent song song chia sẻ các phương án ứng viên đều sẽ chạm ngưỡng bão hòa khi lịch sử tương tác tích lũy ngày một nhiều. Mỗi agent bị neo vào những nỗ lực trong quá khứ của chính mình, thực hiện ít chỉnh sửa hơn và với quy mô nhỏ hơn, khiến ngân sách bổ sung hầu như không mang lại cải thiện đáng kể.
- Sự lãng quên: Phương pháp này định kỳ loại bỏ phiên làm việc và lịch sử ứng viên của từng agent, sau đó khởi động lại nhóm từ phương án ứng viên tốt nhất đã tìm thấy cho đến thời điểm đó. Các tác giả đã hiện thực hóa điều này trong một nhóm các agent giao tiếp với nhau.
- Kết quả: Trong bốn nhiệm vụ về lập trình heuristic, tối ưu hóa kernel và huấn luyện model, cơ chế lãng quên mang lại mức cải thiện lên tới 15% so với việc chạy agent song song, và tới 39% so với một agent đơn lẻ có cùng mức ngân sách. Trong tác vụ kernel VLIW của Anthropic, nhóm áp dụng cơ chế lãng quên đạt 1.077 chu kỳ, so với 1.172 của bốn agent chạy song song và 1.262 của một agent đơn lẻ.
- Tầm quan trọng: Hầu hết các thiết kế agent nghiên cứu đều cố gắng lưu giữ lịch sử càng nhiều càng tốt. Bài báo này chứng minh rằng đối với việc khám phá mở, những gì agent có thể ghi nhớ cũng quan trọng không kém lượng sức mạnh tính toán mà nó được cấp.
bài báo | Bài viết gốc
6. ReHarness
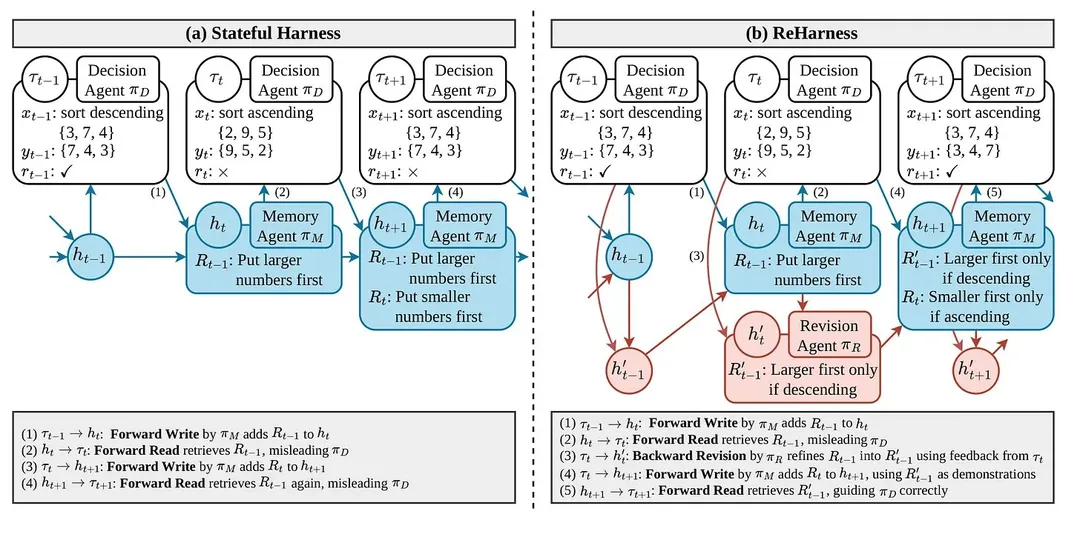
Các framework memory cho agent thường chỉ ghi theo chiều xuôi, do đó một khi bài học kinh nghiệm đã đi vào kho lưu trữ memory, nó sẽ không bao giờ được kiểm tra lại xem có thực sự hữu ích hay không. Các nhà nghiên cứu từ MIT, Meta và Đại học Yale đã đề xuất ReHarness, một framework đệ quy phục vụ học tập liên tục cho agent, bổ sung cơ chế hiệu chỉnh chiều ngược bên cạnh các thao tác đọc-ghi chiều xuôi thông thường.
- Hiệu chỉnh chiều ngược: Sau khi mỗi nhiệm vụ hoàn thành, ReHarness sử dụng quỹ đạo đã thực hiện làm phản hồi cho các reflection cụ thể đã truy xuất trước đó và viết lại chúng. Phản hồi sẽ truyền ngược qua trạng thái framework dạng văn bản, tương tự như một bản cập nhật đệ quy.
- Hoàn toàn trực tuyến: Phương pháp này vận hành theo giao thức dạng luồng, không cần replay buffer hay tập xác thực. Việc chỉ dựa vào thao tác thêm và xóa có thể giúp kho reflection gọn gàng nhưng lại bỏ qua các kết quả hạ nguồn, trong khi ReHarness sẽ hiệu chỉnh các bài học kinh nghiệm dựa trên chính hiệu quả thực tế của chúng.
- Kết quả: Trên ba benchmark học tập liên tục gồm 16 nhiệm vụ và ba backbone model, ReHarness vượt trội hơn hẳn so với các baseline về context gốc, memory, reflection và tối ưu hóa prompt. Sau khi thực hiện hiệu chỉnh đa so sánh, các mức tăng này vẫn đạt ý nghĩa thống kê rõ rệt.
- Tầm quan trọng: Các agent chạy trên các luồng tương tác dài thường phải đối mặt với hiện tượng dịch chuyển phân phối, khiến các bài học được lưu trữ có thể bị khái quát hóa quá mức hoặc trở nên lỗi thời. Phân tích chỉ ra rằng ReHarness tạo ra các hiệu chỉnh dựa trên nguồn gốc, giúp khắc phục những bài học dạng này đồng thời nâng cao cả tính ổn định lẫn tính khả biến (plasticity).
bài báo | Bài viết gốc
7. The Agentic Scientist (Nhà khoa học Agent)
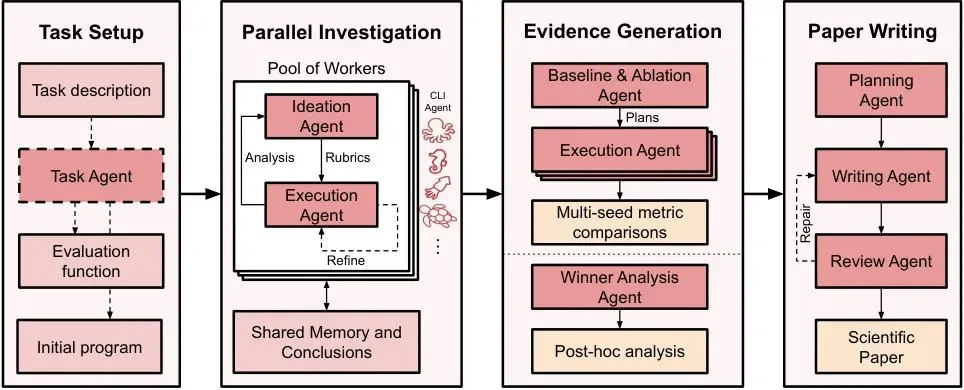
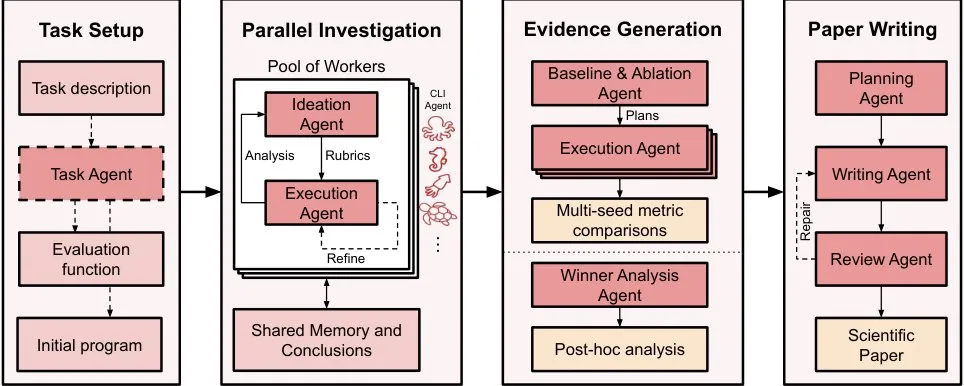
Các research agent hoàn toàn tự chủ thường có phạm vi ý tưởng hạn hẹp và dễ rơi vào bẫy leo đồi thiển cận. Các nhà nghiên cứu từ Sakana AI đã đề xuất Nhà khoa học Agent (The Agentic Scientist), một pipeline phân tán đầu-cuối cho phép các nhà nghiên cứu con người phối hợp cùng các coding agent hiện đại để thực hiện các nghiên cứu tính toán.
- Pipeline phân giai đoạn: Hệ thống chia nhỏ dự án thành các giai đoạn: soạn thảo nhiệm vụ, lên ý tưởng, lập kế hoạch, thử nghiệm trong sandbox, thiết lập baseline và nghiên cứu ablation, phân tích và viết báo cáo. Mỗi giai đoạn đều được thực thi bởi một coding agent có khả năng tự kiểm chứng công việc của mình.
- Meta-controller: Một bộ điều khiển sẽ quản lý song song nhiều research agent và kiểm tra từng giai đoạn dựa trên các tiêu chí đánh giá. Cùng một lớp điều phối này có thể tái sử dụng trên nhiều lĩnh vực khác nhau với các môi trường thực thi, framework lập trình và chỉ số đánh giá khác nhau.
- Bài báo được chấp nhận: Với vai trò là một nhà đồng nghiên cứu, phiên bản thử nghiệm của hệ thống này, sau khi được con người kiểm chứng và biên tập, đã hỗ trợ viết một bài báo được chấp nhận làm báo cáo tại hội nghị chính ALIFE 2026. Hệ thống cũng có thể vận hành hoàn toàn tự chủ, và các tác giả đã ứng dụng nó vào các bài toán machine learning mở trong nhiều lĩnh vực nghiên cứu tính toán khác nhau.
- Tầm quan trọng: Các thử nghiệm ablation chỉ ra rằng tính tự chủ khoa học đáng tin cậy phụ thuộc vào cả lớp điều phối liên agent lẫn model nền tảng. Đây là tài liệu tham khảo hữu ích cho bất kỳ ai đang xây dựng hệ thống multi-agent xoay quanh các coding agent.
bài báo | Bài viết gốc
8. GitSwarm
Các nhà nghiên cứu tại Meta Superintelligence Labs cùng các đồng nghiệp đã xây dựng GitSwarm, trong đó hàng trăm agent bất đồng bộ cùng chia sẻ một Git repo. Mỗi đóng góp là một commit ghi nhận lại việc nó được xây dựng dựa trên những commit trước đó trên bất kỳ nhánh nào mà không cần đến bộ lập kế hoạch trung tâm để phân chia công việc. Sử dụng các worker GPT-5.5 Codex, hệ thống đã giải quyết toàn bộ 30 bài toán trong IMOProofBench-Advanced ngay từ lần chạy đầu tiên, đạt 79,4% điểm trên ProgramBench (tăng từ 73,1% khi dùng 100 worker lên 79,4% khi dùng 500 worker), trong khi một agent Codex đơn lẻ với mức ngân sách tương đương chỉ đạt 65,1%. Các worker tiếp theo đã kế thừa 94,7% các đóng góp đã phát hành, và các công việc được chấp nhận sau đó đã tham chiếu tới 70,1% các commit nghiên cứu thất bại.
bài báo | Bài viết gốc
9. LoGRA
Các nhà nghiên cứu của NVIDIA đã đề xuất LoGRA, một phương pháp post-training bằng RL giúp cập nhật toàn bộ trọng số của model nhưng lại tiêu tốn ít bộ nhớ hơn LoRA. Cách tiếp cận này nén từng gradient trọng số thành một bản phác thảo hạng thấp (low-rank sketch) được vẽ lại ở mỗi bước, đồng thời bổ sung cơ chế kiểm soát bước nhảy KL dự đoán để giữ các cập nhật nằm trong giới hạn ngân sách. Ở quy mô 1.5B, phương pháp này chỉ sử dụng trung bình 7,2 GiB bộ nhớ huấn luyện so với 13,2 GiB của LoRA rank-256 trong khi đạt Pass@4 tương đương; ở quy mô 7B, nó cắt giảm 45,7% bộ nhớ huấn luyện trung bình trên mỗi GPU mà vẫn duy trì độ chính xác đỉnh tiệm cận dense Adam. Hệ thống cũng đã huấn luyện thành công một model 27B trên một node đơn gồm 8 GPU qua hơn 1.100 bước, trong khi dense Adam gặp lỗi tràn bộ nhớ (OOM) trong điều kiện tương tự.
bài báo | Bài viết gốc
10. AutoEnvScaling
Các nhà nghiên cứu từ Microsoft và các cộng sự đã giao việc thiết kế môi trường RL cho một agent đề xuất (proposer agent) hoạt động trong terminal; agent này sẽ phân tích các kết quả rollout của model đang được huấn luyện và từ đó xây dựng các môi trường mới, với mỗi vòng rollout sẽ định hướng cho vòng tiếp theo. Việc xây dựng môi trường ngay trong terminal giúp tăng tỷ lệ môi trường hợp lệ lên tới 25 lần so với việc chỉ tạo bằng prompt, đồng thời cắt giảm chi phí cho mỗi môi trường hợp lệ tới 75%. Khi sử dụng Qwen3.6-35B-A3B đồng thời làm cả bên đề xuất lẫn bên giải quyết (solver), điểm số trên Terminal-Bench 2.1 đã tăng từ 41,1 lên 53,3. Pipeline này cũng có khả năng tạo môi trường cho các tác vụ kỹ nghệ phần mềm, thao tác máy tính và tác vụ kernel GPU.
bài báo | Bài viết gốc
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác