Link bài viết gốc: https://x.com/dongxi_nlp/status/21133943...
Dongxi Đông Tích NLP · X · @dongxi_nlp · 2026-10-23 06:17
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
Bài viết thứ hai trong series Post-training, bàn về instruction fine-tuning.
Tháng 3 năm 2023, một nhóm nghiên cứu tại Stanford đã dùng LLaMA 7B của Meta để huấn luyện ra Alpaca — model có khả năng trả lời câu hỏi theo chỉ dẫn. LLaMA 7B ban đầu vốn chỉ trải qua giai đoạn pre-training, nên chỉ biết dự đoán token tiếp theo.
Nhóm nghiên cứu không hề thay đổi cấu trúc model, chỉ dùng 52.000 mẫu dữ liệu, mỗi mẫu gồm một chỉ dẫn và một câu trả lời, nhưng đã giúp LLaMA 7B học được cách trả lời theo chỉ dẫn.
Số dữ liệu này được tạo tự động bởi text-davinci-003 của OpenAI với chi phí chưa tới 500 USD. Quá trình huấn luyện diễn ra trên 8 GPU trong 3 giờ, tiêu tốn chưa đầy 100 USD.
Alpaca cũng đưa ra những câu trả lời sai. Khi hỏi về thủ đô của Tanzania, nó trả lời là Dar es Salaam, trong khi đáp án chính xác là Dodoma.
Các ví dụ đã dạy cho model cách trả lời, nhưng không dạy cho nó biết sự thật nào mới là chính xác.
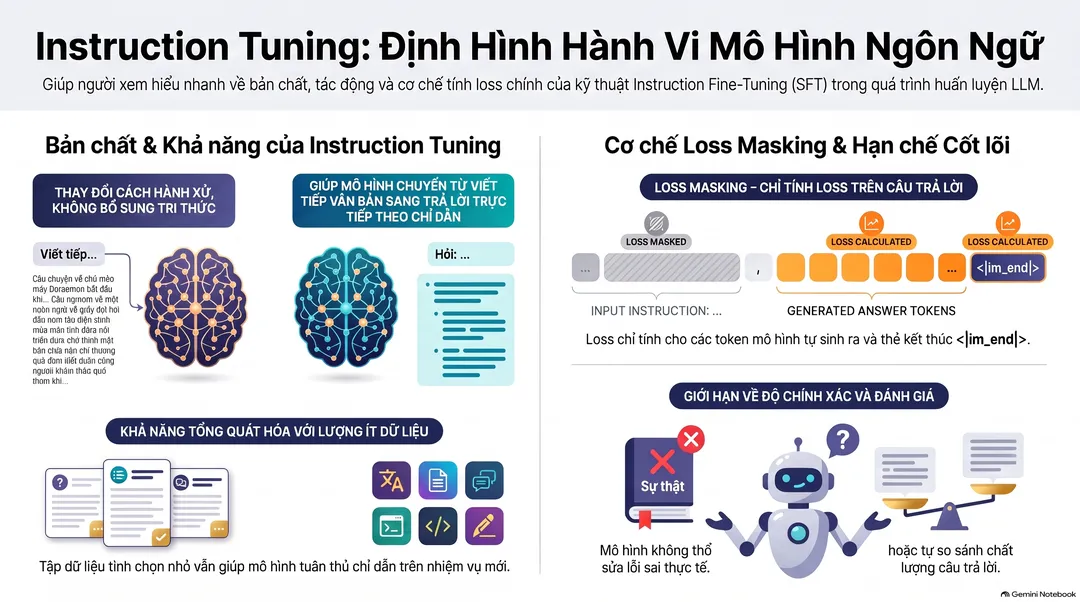
Tại sao chỉ một lượng nhỏ ví dụ lại có thể thay đổi rõ rệt hành vi của model, nhưng không thể sửa được các lỗi sai về mặt sự thật? Bài viết này xuất phát từ câu hỏi đó để giới thiệu kỹ thuật đầu tiên của post-training: instruction tuning (fine-tune theo chỉ thị) , còn gọi là supervised fine-tuning (SFT, fine-tune có giám sát) . Đây là bài viết thứ hai trong series post-training.
Cùng một hàm loss, khác biệt về nhiệm vụ
Instruction fine-tuning kế thừa mục tiêu huấn luyện của pre-training: dự đoán token tiếp theo ở từng vị trí, dùng cross-entropy loss để đo lường khoảng cách giữa token dự đoán và token chính xác, thông qua huấn luyện để nâng cao xác suất xuất hiện của token chính xác.
Điểm khác biệt nằm ở dữ liệu và nhiệm vụ. Pre-training sử dụng văn bản thô, nhiệm vụ là viết tiếp; instruction fine-tuning dùng dữ liệu theo cặp, mỗi cặp gồm một chỉ dẫn và một câu trả lời, nhiệm vụ là tạo ra câu trả lời dựa trên chỉ dẫn.
Hàm loss giống nhau, dữ liệu và nhiệm vụ khác nhau: pre-training học cách viết tiếp văn bản, còn instruction fine-tuning học cách trả lời theo chỉ dẫn.
Phương pháp này được gọi là fine-tune có giám sát (SFT) vì mỗi đầu vào đều có một đầu ra mục tiêu được chỉ định sẵn, bất kể dữ liệu đó do ai biên soạn. Văn bản pre-training cũng do con người viết; còn toàn bộ ví dụ của Alpaca đều do model sinh ra, nhưng vẫn thuộc về dữ liệu có giám sát.
Instruction fine-tuning đã học được những gì
Model nền tảng (base model) trong quá trình pre-training đã tích lũy một lượng lớn tri thức, bao gồm sự thật, ngữ pháp, code và đa dạng văn phong, nhưng hành vi mặc định của nó là viết tiếp văn bản đầu vào. Khi nhận được một câu hỏi, nó có thể tiếp tục viết thêm nhiều câu hỏi khác.
Instruction fine-tuning làm thay đổi cách thức hành vi của model:
- Đưa ra câu trả lời trực tiếp cho yêu cầu, không còn viết tiếp văn bản đầu vào.
- Xuất kết quả đúng định dạng được yêu cầu trong chỉ dẫn, ví dụ như danh sách, từ đơn lẻ hoặc bản dịch.
- Phân biệt lời thoại của người dùng và trợ lý trong hội thoại nhiều lượt.
- Dừng sinh văn bản ngay khi hoàn thành câu trả lời.
- Từ chối một số yêu cầu nhất định nếu trong tập ví dụ có chứa các trường hợp từ chối.
Hai nghiên cứu LIMA và FLAN đã chỉ rõ đặc điểm của sự thay đổi này.
LIMA (2023) chỉ dùng 1.000 ví dụ tinh tuyển để fine-tune LLaMA 65B mà không cần đến học tăng cường (RL). Trong đánh giá của con người, 43% câu trả lời tương đương hoặc tốt hơn GPT-4. Các tác giả dựa vào đó nhận định rằng tri thức của model gần như hoàn toàn đến từ pre-training, còn một lượng nhỏ dữ liệu chỉ dẫn chủ yếu quyết định phong cách và phương thức trả lời.
FLAN (2021) chuyển đổi hơn 60 tác vụ NLP thành các chỉ dẫn bằng ngôn ngữ tự nhiên, dùng để fine-tune một model 137B. Trên những tác vụ chưa từng xuất hiện trong quá trình huấn luyện, model này đã vượt qua GPT-3 175B ở thiết lập zero-shot trong 20 trên tổng số 25 bài benchmark.
Điều này chứng minh instruction fine-tuning giúp model học được năng lực tuân thủ chỉ dẫn mang tính tổng quát, có thể khái quát hóa sang các tác vụ chưa từng gặp trong quá trình huấn luyện. Do đó, instruction fine-tuning là bước đầu tiên của post-training: trước hết giúp model biết cách trả lời theo chỉ dẫn, sau đó mới dùng căn chỉnh sở thích và học tăng cường để nâng cao chất lượng câu trả lời.
Quy trình huấn luyện
Instruction fine-tuning gồm 5 bước:
- Thu thập : Chuẩn bị các cặp dữ liệu gồm chỉ dẫn và câu trả lời.
- Định dạng : Dùng chat template của model để chuyển đổi từng cặp dữ liệu thành chuỗi token theo định dạng hội thoại.
- Tạo mask : Sử dụng loss mask đánh dấu các token cần tính loss, chỉ tính riêng phần câu trả lời.
- đã huấn luyện : Sử dụng loss dự đoán token tiếp theo, learning rate tương đối nhỏ, thường chỉ huấn luyện qua vài epoch. Bạn có thể cập nhật toàn bộ tham số, tức full fine-tuning ; hoặc có thể đóng băng tham số gốc, chỉ huấn luyện một lượng nhỏ tham số mới thêm vào, tức LoRA , đây là chủ đề của bài viết tiếp theo.
- Đánh giá : Đánh giá hiệu quả trên các tác vụ chưa từng xuất hiện trong quá trình huấn luyện.
Bước 2 và 3 có khá nhiều chi tiết kỹ thuật cần chú ý, dưới đây sẽ giải thích cụ thể từng bước.
Ba trạng thái của một mẫu dữ liệu
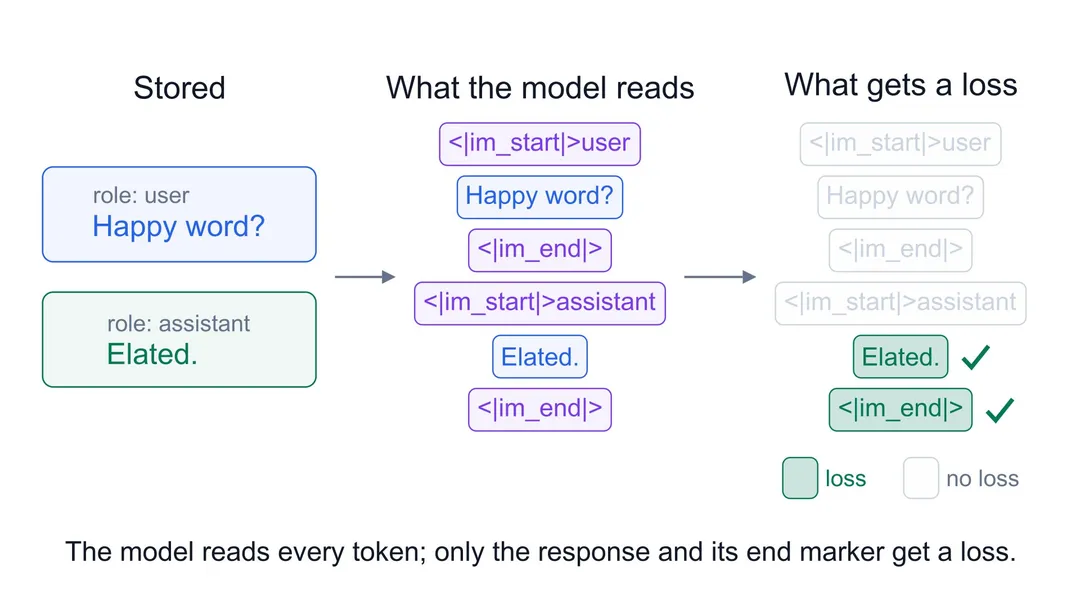
Dạng lưu trữ : Một đoạn hội thoại gồm nhiều tin nhắn, mỗi tin nhắn ghi rõ vai trò (system, user, assistant).
Dạng đầu vào : Chat template ghép nối tất cả tin nhắn thành một chuỗi token duy nhất và chèn các token đặc biệt. Trong template của Qwen, mỗi lượt đối thoại bắt đầu bằng <|im_start|> kèm tên vai trò, và kết thúc bằng <|im_end|>.
Dạng huấn luyện : Loss mask đánh dấu những token trong chuỗi tham gia vào việc tính loss. Model đọc toàn bộ chuỗi, nhưng chỉ những token được đánh dấu mới được tính vào loss.
Hình dưới đây đặt cả ba trạng thái cạnh nhau để đối chiếu:
Những token nào được tính loss
Tiêu chí xác định chỉ có một nguyên tắc duy nhất:
Chỉ tính loss cho những token mà model thực sự cần sinh ra trong quá trình sử dụng thực tế.
Dựa vào đó để xét từng thành phần:
- Tin nhắn của người dùng: Không tính. Model cần đọc nhưng không cần sinh ra phần này. Nếu tính loss cho nó, model sẽ học cách tự sinh câu hỏi của người dùng.
- token bắt đầu của assistant assistant: Không tính. Khi sử dụng thực tế, token này do ứng dụng tự động đưa vào prompt.
- Câu trả lời: Có tính.
- token kết thúc : Có tính. Model thông qua token này để học thời điểm cần dừng sinh văn bản. Nếu thiếu mục này, model có thể tiếp tục nói sau khi đã trả lời xong, thậm chí tự sinh luôn tin nhắn của người dùng ở lượt tiếp theo.
- Dấu xuống dòng sau : Không tính. Lúc này quá trình sinh đã kết thúc.
Biểu diễn dưới dạng công thức, mₜ = 1 nghĩa là vị trí t có tính loss, ngược lại mₜ = 0:
loss = − (1 / số lượng token được tính loss) × Σₜ mₜ · log p(token tiếp theo chính xác tại vị trí t)
Các vị trí không tính loss sẽ đóng góp giá trị bằng 0, giá trị trung bình chỉ được tính trên những vị trí có tính loss.
token bị mask vẫn được huấn luyện
Loss mask chỉ quyết định dự đoán ở những vị trí nào được đưa vào tính loss, chứ không ảnh hưởng đến việc attention đọc những token nào. Câu trả lời phụ thuộc vào việc đọc prompt, vì vậy gradient sinh ra từ loss của câu trả lời sẽ thông qua attention truyền ngược lại các token trong prompt, từ đó cập nhật tham số xử lý những token này.
Nói cách khác, token bị mask không trực tiếp tính loss, nhưng vẫn tham gia đầy đủ vào quá trình huấn luyện.
Dịch lệch một vị trí
Đầu ra của model tại vị trí t chính là dự đoán cho vị trí t + 1, do đó khi tính loss, dự đoán phải được căn chỉnh khớp với token ở vị trí kế tiếp. Trong PyTorch được viết là:
cross_entropy(logits[:-1], labels[1:], ignore_index=-100)
Trong đó -100 biểu thị các vị trí không tính loss.
Nếu không dịch lệch một vị trí này, shape vẫn hoàn toàn khớp, code vẫn chạy được, nhưng mỗi dự đoán lại bị căn chỉnh với chính token ở vị trí hiện tại, khiến model chỉ học cách sao chép lại token đang có.
Trước khi huấn luyện, bạn nên decode các token được tính loss ra để rà soát: kết quả chỉ nên bao gồm nội dung các câu trả lời kèm thẻ <|im_end|>.
Dữ liệu đến từ đâu
Dữ liệu chỉ dẫn chủ yếu đến từ ba nguồn:
- Biên soạn thủ công : Do tình nguyện viên hoặc chuyên viên gán nhãn trực tiếp viết chỉ dẫn và câu trả lời, chất lượng cao nhưng chi phí cũng đắt đỏ.
- Viết lại từ các dataset hiện có : Dùng template đơn giản để chuyển đổi các dataset dịch thuật, hỏi đáp, phân tích cảm xúc... thành chỉ dẫn, ví dụ: Người đánh giá này có thích bộ phim không?
- Do model sinh ra : do mô hình ngôn ngữ tạo chỉ thị và câu trả lời, thường được lọc hoặc kiểm duyệt thêm sau đó. Đây là nguồn được sử dụng phổ biến nhất hiện nay.
Chất lượng dữ liệu có ảnh hưởng rất lớn. Một nghiên cứu cho thấy khi thêm 500 ví dụ an toàn vào một dataset chỉ thị quy mô lớn, tỷ lệ mô hình đưa ra câu trả lời độc hại đã giảm rõ rệt.
Khi kết hợp dữ liệu cũng cần chú ý đến độ dài. Loss được tính trung bình theo các token được tính loss; câu trả lời càng dài thì tỷ trọng trong loss càng lớn: một câu trả lời 500 token có trọng số gấp khoảng 250 lần một câu trả lời 2 token. Do đó, khi kết hợp dữ liệu chỉ thị cần cân đối theo số lượng token, chỉ nhìn vào số lượng mẫu ví dụ là chưa đủ.
Khả năng và giới hạn của fine-tune theo chỉ thị
Những gì có thể làm được : với chi phí tương đối thấp, giúp mô hình học cách trả lời theo chỉ thị, tuân thủ định dạng, phân biệt vai trò hội thoại, dừng đúng lúc và từ chối một số yêu cầu nhất định, đồng thời có thể tổng quát hóa sang các tác vụ mới.
Những gì không thể làm được :
- Bổ sung tri thức một cách đáng tin cậy. Ví dụ Alpaca trả lời sai thủ đô cho thấy mô hình chỉ học được hình thức trả lời, chứ tri thức nắm được không hề tăng lên. Nó thậm chí có thể học được cách đưa ra câu trả lời khẳng định ngay cả với những câu hỏi mà nó không chắc chắn.
- Vượt qua dữ liệu huấn luyện. Mô hình bắt chước các ví dụ, nên cũng sẽ bắt chước cả các lỗi sai có trong ví dụ.
- So sánh chất lượng câu trả lời, hoặc đánh giá câu trả lời có đúng hay không. Mỗi ví dụ chỉ cung cấp một câu trả lời tham chiếu, mô hình không thể biết được giữa hai câu trả lời đều hợp lý thì câu nào tốt hơn, cũng như không thể biết một quá trình giải bài rất dài liệu cuối cùng có chính xác hay không.
Điểm cuối cùng được giải quyết bằng hai kỹ thuật tiếp theo: preference alignment (căn chỉnh theo sở thích) học từ việc so sánh giữa các câu trả lời; RLVR (Reinforcement Learning with Verifiable Rewards - học tăng cường với phần thưởng có thể xác minh) học dựa trên việc câu trả lời có chính xác hay không.
Việc huấn luyện mô hình suy luận cũng tuân theo trình tự này: trước tiên dùng các lời giải được viết sẵn để fine-tune theo chỉ thị, giúp mô hình học được định dạng suy luận từng bước, sau đó dùng học tăng cường để nâng cao độ chính xác của suy luận.
Tóm tắt
- fine-tune theo chỉ thị sử dụng cùng một loss như pre-train, tiếp tục huấn luyện trên các cặp dữ liệu bao gồm chỉ thị và câu trả lời.
- Nó được gọi là fine-tune có giám sát vì mỗi đầu vào đều có một đầu ra mục tiêu được chỉ định, không phụ thuộc vào việc ai là người biên soạn dữ liệu.
- Nó chủ yếu thay đổi cách hành xử của mô hình, rất ít khi bổ sung tri thức; chỉ một lượng nhỏ dữ liệu là đã mang lại hiệu quả, đồng thời có thể tổng quát hóa sang các tác vụ mới.
- Chỉ tính loss đối với các token mà mô hình cần sinh ra: câu trả lời và token ở cuối. Các token bị mask vẫn tham gia vào quá trình huấn luyện.
- Nó chỉ có thể bắt chước câu trả lời tham chiếu, không thể so sánh chất lượng hay kiểm tra tính chính xác; phần này do các bước căn chỉnh sở thích và học tăng cường tiếp theo đảm nhiệm.
Bài tiếp theo: LoRA và QLoRA, cùng cách fine-tune mô hình lớn (LLM) trên một GPU.
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác