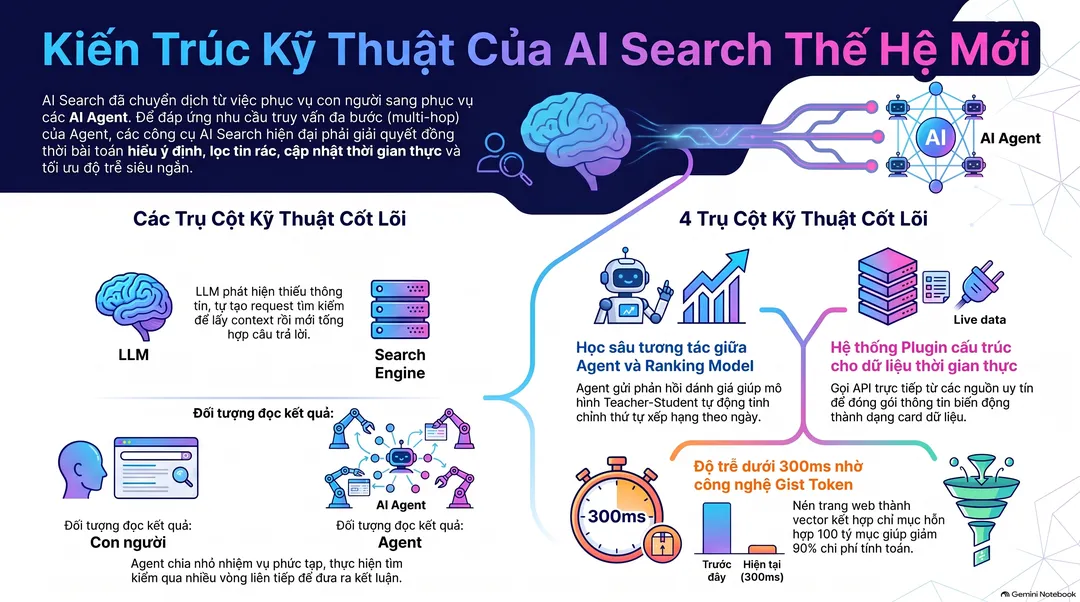
Link bài viết gốc: https://mp.weixin.qq.com/s/03UCiH5uhbpiI...
Kim Sắc Truyền Thuyết Đại Thông Minh · Kênh Official Account · Cyber Thiền Tâm · 2026-10-21 14:45
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
Có thể các bạn đã biết, tôi là một trong những người đầu tiên làm việc trong lĩnh vực AI Search. Hồi đầu, plugin tìm kiếm tích hợp sẵn trong ChatGPT là do tôi viết (nếu bạn là một trong những thành viên trả phí đầu tiên của ChatGPT, rất có thể bạn đã từng dùng code của tôi rồi).
Cuối tuần vừa rồi, DeepSeek đã phát hành giải pháp AI Search; đúng lúc đó, hôm qua Yuanbao cũng đưa ra giải pháp tìm kiếm của riêng mình và mở API. Cả hai nối gót nhau ra mắt, đây cũng có thể coi là một xu hướng nhỏ đạt được sự đồng thuận trong ngành.
Đồng thời, bên phía Yuanbao cũng có một buổi giao lưu trong ngành, nhân dịp này tôi sẽ chia sẻ cụ thể xem thứ này được hiện thực hóa như thế nào. Về nguyên lý, AI Search không quá phức tạp, nhưng để tìm kiếm có khả năng thích ứng tốt hơn, người ta đã bổ sung rất nhiều giải pháp kỹ thuật chuyên sâu.
AI "tìm kiếm" như thế nào
Nếu bạn hỏi AI: “Thời tiết Bắc Kinh ngày mai thế nào, ra ngoài có cần mang ô không?”, nó thường sẽ trả lời bạn một câu như thế này:
Ngày mai (thứ Tư) trời nắng, 3~14℃, không cần mang ô. Nguồn: Bắc Kinh Nhật Báo
Chuẩn xác, đúng không?
Nhưng bản thân mô hình lớn (LLM) không thể biết được thời tiết ngày mai: nó chỉ có thể suy luận nội dung tiếp theo dựa trên context phía trước. Trong quá trình này, mặc định nó không biết hôm nay là ngày mấy, cũng không tự tra cứu được thông tin thời tiết.
Vậy làm sao nó trả lời được? Model và công cụ tìm kiếm đã thực hiện một vòng trao đổi qua lại, sau đó hoàn tất việc bổ sung thêm thông tin:
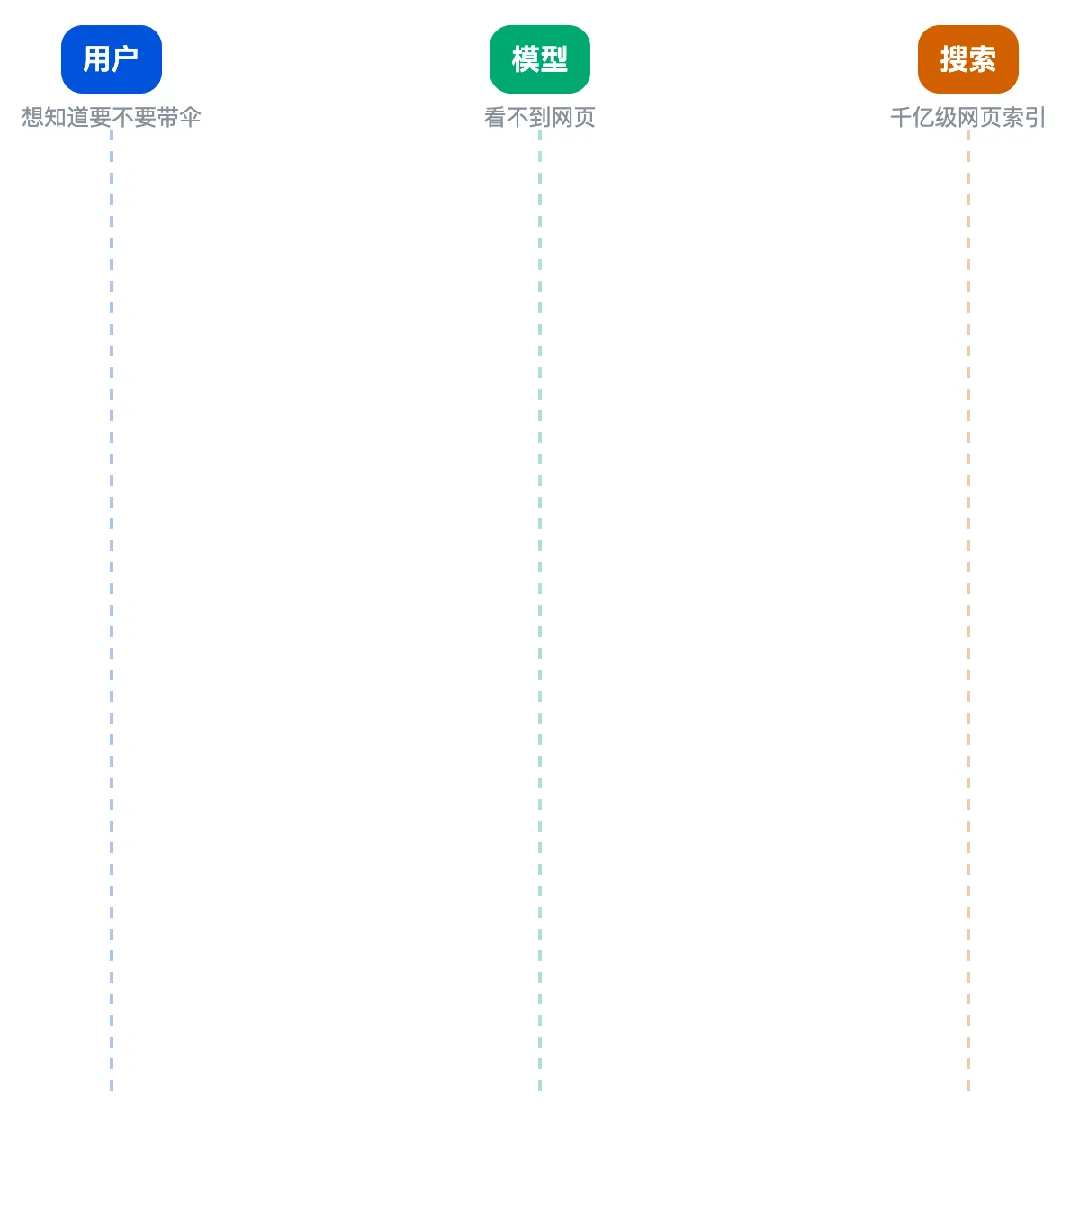
Cụ thể, sau khi model nhận câu hỏi, nhận thấy chỉ dựa vào bản thân thì không trả lời được, nên nó sẽ viết ra một đoạn request có định dạng cố định, nêu rõ cần tìm cái gì và cần bao nhiêu kết quả:
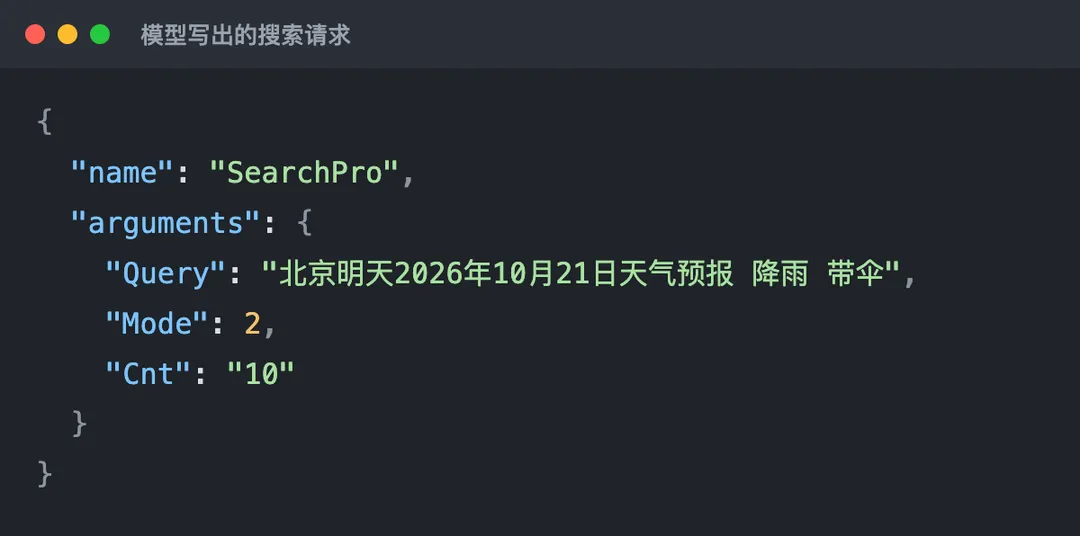
Đoạn request này sẽ được chương trình bên ngoài nhận diện. Chương trình lấy từ khóa tìm kiếm trong đó để đi tra cứu, rồi dán nguyên vẹn 10 kết quả tìm được vào lại context của model:
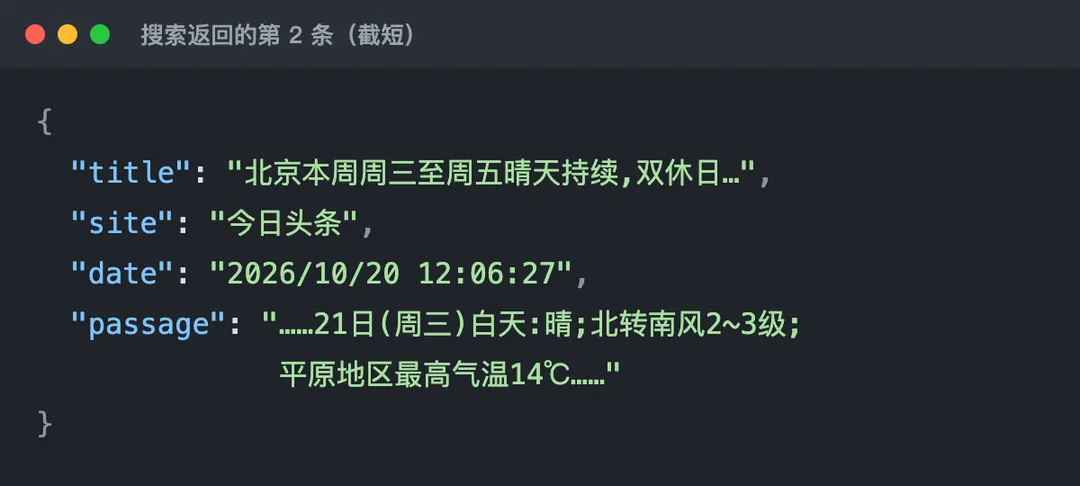
Model đọc xong 10 kết quả này, tiếp tục viết tiếp và cho ra câu trả lời kèm nguồn trích dẫn như ở đầu bài.
Bạn sẽ nhận thấy, trong suốt chu trình này, model chỉ làm hai việc: Quyết định tìm kiếm cái gì, và quyết định sử dụng những thứ tìm được như thế nào
Vì vậy, ở đây tiềm ẩn một cái bẫy: kết quả tìm được phụ thuộc hoàn toàn vào search engine, trong khi model lại không phân biệt được bài viết nào là thật, chẳng hạn thông tin đưa vào có thể là nội dung của các trang câu view hoặc thông tin đã lỗi thời.
Lúc này sẽ cần đến các giải pháp kỹ thuật chuyên sâu (sẽ nói kỹ hơn ở phần sau).
Tìm kiếm bắt đầu phục vụ cho Agent
Ngành tìm kiếm trong những năm qua đã trải qua nhiều đợt biến đổi.
Ban đầu, tìm kiếm là để cho con người dùng, ví dụ như Google, Baidu: bạn gõ vài từ khóa, nó trả về 10 đường link, bạn muốn bấm vào đâu tùy thích.
Về sau có ChatGPT, model đã có thể đọc hiểu trang web, kết quả tìm kiếm được chuyển trước cho model để nó tóm tắt lại thay bạn.
Đến hai năm gần đây khi Agent phát triển bùng nổ, đối tượng đọc kết quả lại chuyển thành Agent: nó chia một nhiệm vụ thành nhiều câu hỏi con, tìm kiếm qua từng vòng, đọc xong vòng này rồi mới quyết định vòng tiếp theo sẽ tìm gì.
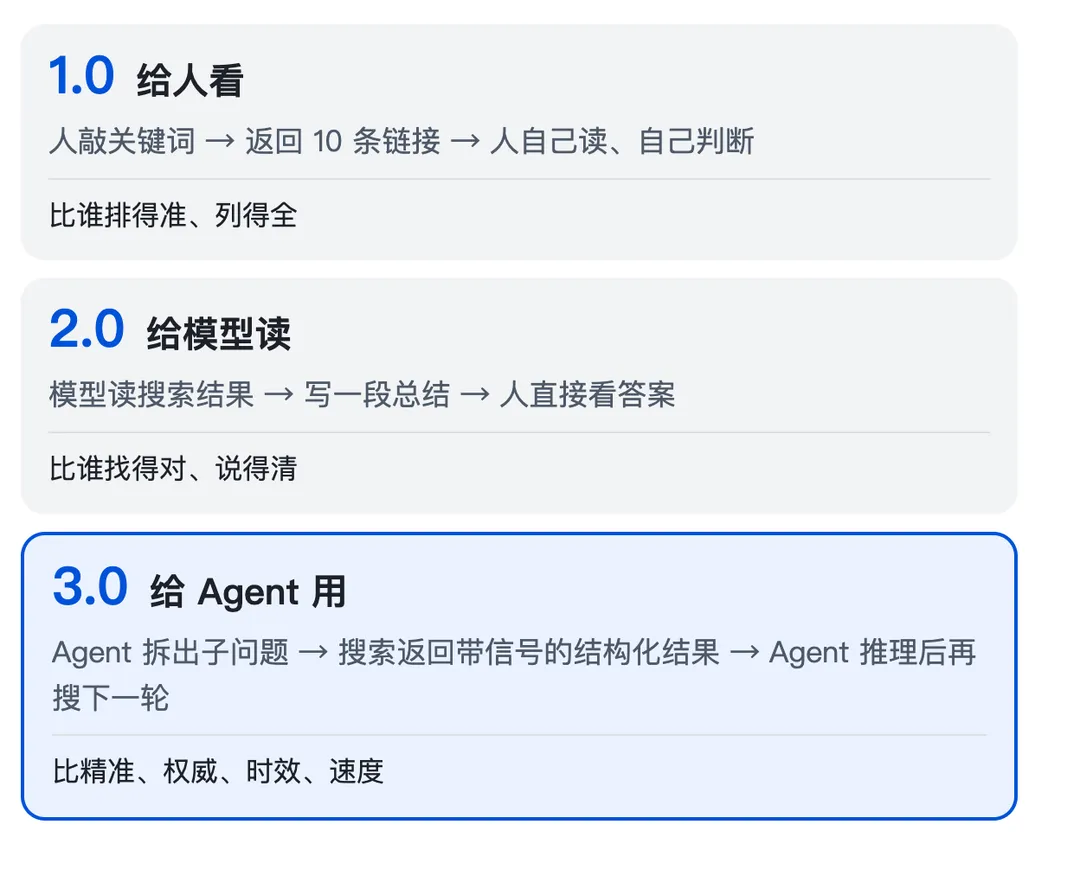
Khi đối tượng đọc kết quả đổi từ con người sang Agent, bài toán mà công cụ tìm kiếm phải đối mặt đã hoàn toàn thay đổi:
- Từ khóa tìm kiếm do Agent tách ra, công cụ tìm kiếm phải hiểu được Agent
- Model đọc kết quả không phân biệt được thật giả, tính xác thực chỉ có thể do công cụ tìm kiếm kiểm soát
- Tri thức của model dừng lại ở ngày kết thúc training, thông tin mới phải nhờ tìm kiếm bù đắp
- Agent thực hiện một nhiệm vụ phải tìm kiếm qua nhiều vòng, vòng nào cũng phải thật nhanh
Đặt lại vào quy trình của một lượt tìm kiếm, bốn việc này nằm ở các khâu khác nhau:
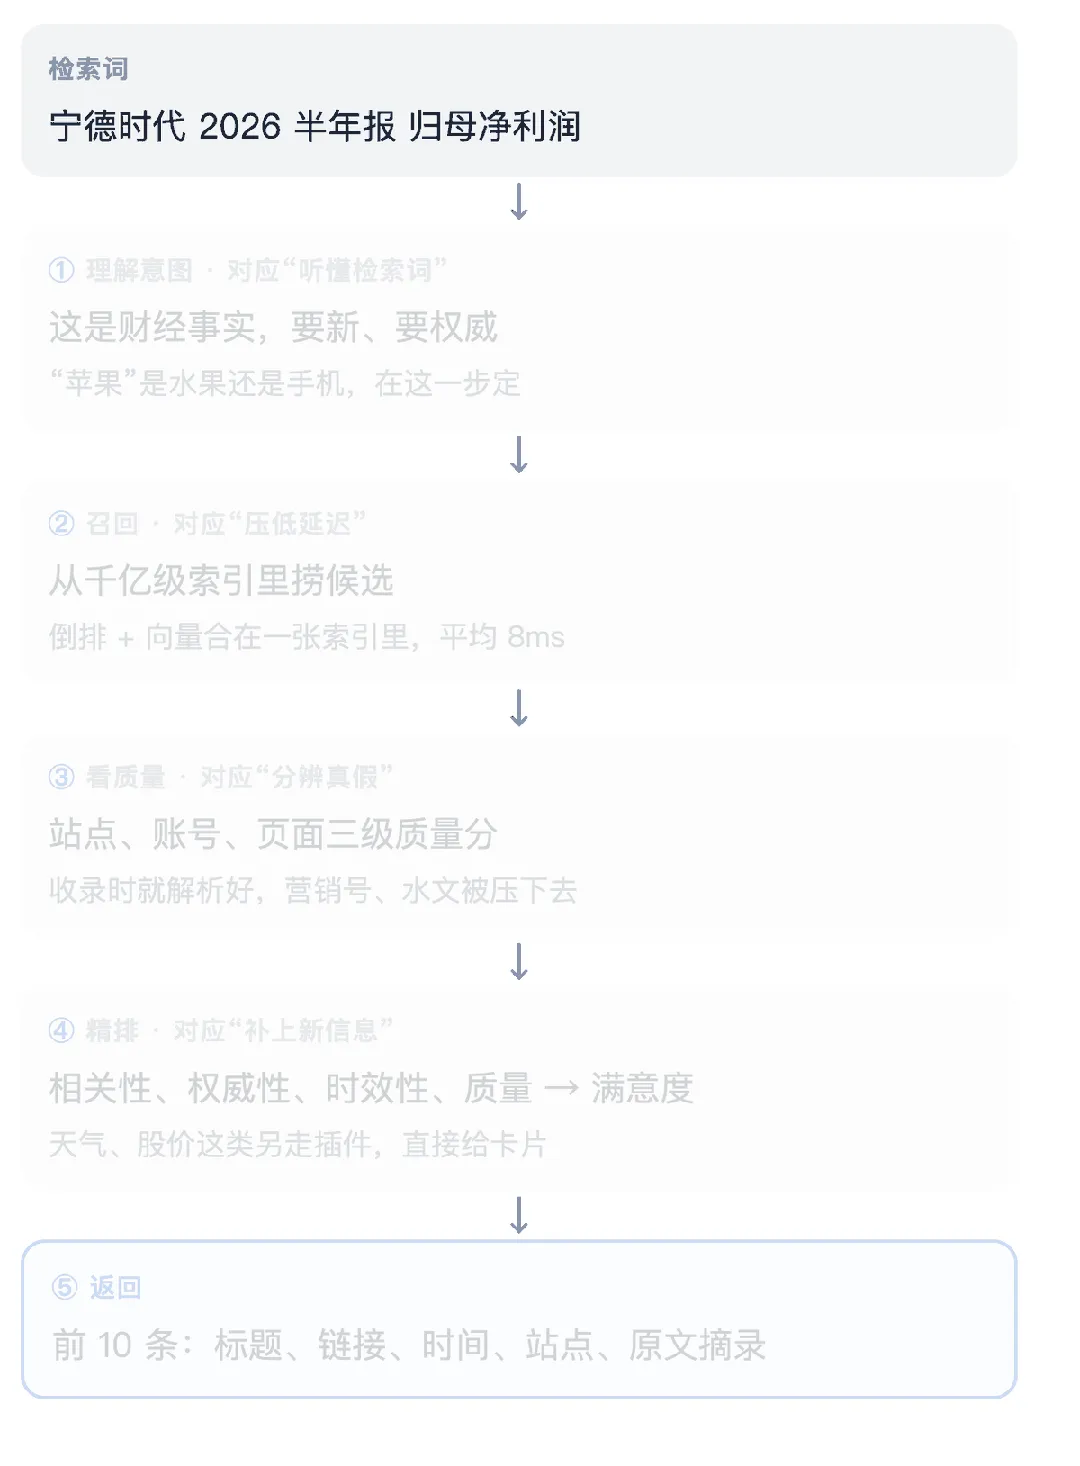
1. Hiểu được từ khóa tìm kiếm
Về từ khóa tìm kiếm, trước tiên có một vấn đề muôn thuở: người dùng hỏi "táo", là trái cây hay điện thoại Apple? Hỏi "sân bay Bắc Kinh", là Đại Hưng hay Thủ Đô? Nếu hiểu sai intent, thì phía sau có xếp hạng tốt đến mấy cũng vô ích.
Bước sang kỷ nguyên Agent, điểm khó là từ khóa do chính Agent tạo ra. Thói quen bóc tách vấn đề của Agent không giống con người, công cụ tìm kiếm phải thích ứng ngược lại với nó.
Cách làm của Yuanbao Search là để công cụ tìm kiếm và Agent trao đổi tín hiệu cho nhau:
- Phía tìm kiếm gửi sang Agent: cấp độ tin cậy của từng kết quả, thời gian đăng tải, mức độ hài lòng về xếp hạng, giúp Agent chọn nên trích dẫn kết quả nào
- Phía Agent gửi ngược lại cho tìm kiếm: cuối cùng đã trích dẫn những kết quả nào, quá trình tư duy, điểm số đánh giá câu trả lời (answer reward), để hệ thống tìm kiếm dùng điều chỉnh lại ranking
Còn việc trao đổi tín hiệu có hiệu quả hay không, nhìn vào số lần Agent phải tìm kiếm là biết. WorkBuddy từng thực hiện đánh giá chung: sau khi tích hợp Yuanbao Search bản nâng cấp, số lần gọi tìm kiếm trung bình cho một nhiệm vụ đã giảm từ 8 lần xuống còn 5 lượt khoảng đó
Tại sự kiện, một nhà phát triển sản phẩm nội dung cũng chia sẻ: trước đây khi hỏi một câu, Agent phải lướt qua 20 trang web, giờ 5 trang là đủ.
Những tín hiệu này cuối cùng được đưa vào mô hình ranking. Mô hình ranking của Yuanbao Search cũng được huấn luyện từ mô hình lớn (LLM):
- Label model trước tiên gán nhãn cho lượng khổng lồ từ khóa tìm kiếm và trang web, tạo ra tín hiệu giám sát
- Dùng các tín hiệu này huấn luyện một Teacher model kích thước lớn để học được sở thích xếp hạng phức tạp
- Sau đó chưng cất thành Student model kích thước nhỏ để triển khai thực tế, đảm bảo tốc độ
Mẫu huấn luyện được lấy từ dữ liệu online: hệ thống trích xuất các từ khóa có kết quả chưa thỏa đáng, giao cho agent gán nhãn, rồi huấn luyện tăng cường. Trước đây dựa vào gán nhãn thủ công và tinh chỉnh tham số bằng tay, lặp lại theo tháng; giờ đây có thể tính theo ngày.
2. Phân biệt thật giả
Về vấn đề thật giả, như đã nói ở đầu: model không tự phân biệt được đúng sai, các bài viết câu view, bài rác do AI viết hàng loạt một khi đã lọt vào context thì nó đều sẽ sử dụng.
Do đó, một trang web có đáng tin hay không tốt nhất nên được đánh giá ngay tại thời điểm thu thập dữ liệu. Yuanbao Search chấm điểm chất lượng 3 cấp cho mỗi trang: website, tài khoản, trang cụ thể. Khi thu thập, hệ thống dùng mô hình lớn (LLM) phân tích trang web một lượt: tác giả là ai, tác giả này trước đây từng đăng gì, nội dung có nguồn dẫn hay không.
Đối phó với bài viết rác từ AIGC và GEO (nội dung viết chuyên để AI trích dẫn) là một cuộc chiến công - thủ: từng bài viết riêng lẻ sẽ dùng model nhận diện chuyên biệt để xử lý, còn các tài khoản và website thường xuyên đăng nội dung AIGC sẽ được nhận diện theo quy luật đăng bài.
Nhưng hiệu quả hơn cả là làm ngược lại: tìm ra các nguồn tin chất lượng cao và đưa lên đầu bảng xếp hạng. "Chất lượng cao" phụ thuộc vào việc người dùng đang hỏi gì:
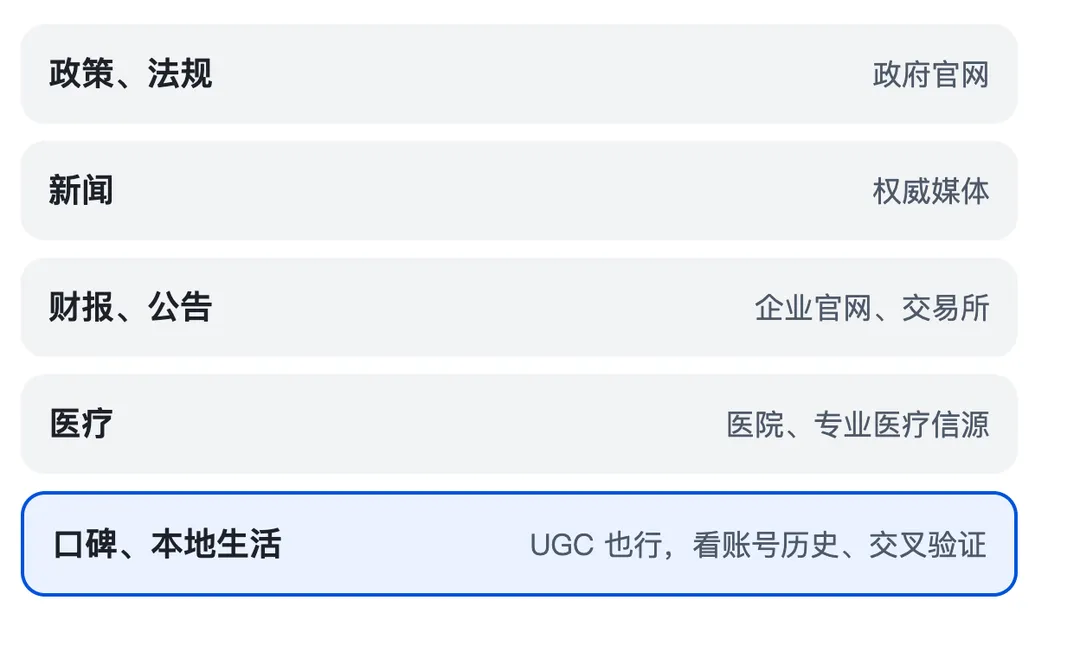
Cũng có những nội dung không tìm được: các website chặn bot thu thập, vì tôn trọng bản quyền nên không thu thập; còn những bên như Ctrip không mở trang ra lấy được thì hợp tác với bên thứ ba để lấy nội dung.
3. Cập nhật thông tin mới
Vấn đề thời gian xuất phát từ chính model: tri thức của nó dừng lại ở ngày kết thúc training, trong khi nội dung trên Internet thay đổi từng giây. Những thông tin như báo cáo tài chính hay lịch thi đấu, chậm một tiếng là đã có thể sai lệch.
Về phía trang web, các website có tính thời sự cao được làm mới thường xuyên hơn, mảng tài chính, chứng khoán khoảng một tiếng một lần.
Nhưng những thứ như giá cổ phiếu, thời tiết, chuyến bay thay đổi còn nhanh hơn cả trang web, chờ trang web cập nhật thì thông tin đã lỗi thời. Do đó, Yuanbao Search đã xây dựng riêng một hệ thống plugin, tương tự như OneBox của Google hay "Aladdin" của Baidu, kết nối 157 nguồn tin hàng đầu thuộc 13 ngành dọc, chẳng hạn như Tencent Zixuangu, VariFlight, Ctrip, JD.com:
Plugin gọi trực tiếp API của đối tác, lấy dữ liệu rồi đóng gói thành dạng card, trả về cùng với kết quả trang web. Khi tôi hỏi "giá cổ phiếu Tencent hôm nay", card nhận về nguyên bản sẽ trông như thế này:
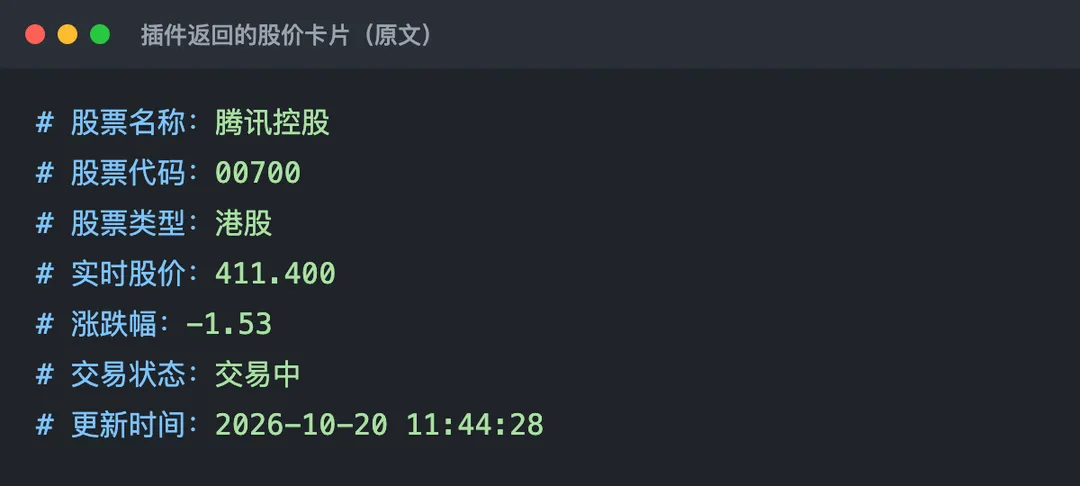
Tên trường là tiếng Trung, có kèm thời gian cập nhật, model nhận được là có thể dùng trực tiếp.
Đối với bên tích hợp, các dữ liệu như chuyến bay, bảng giá thị trường, sản phẩm không còn phải đi đàm phán bản quyền với từng đơn vị nữa.
4. Giảm thiểu độ trễ
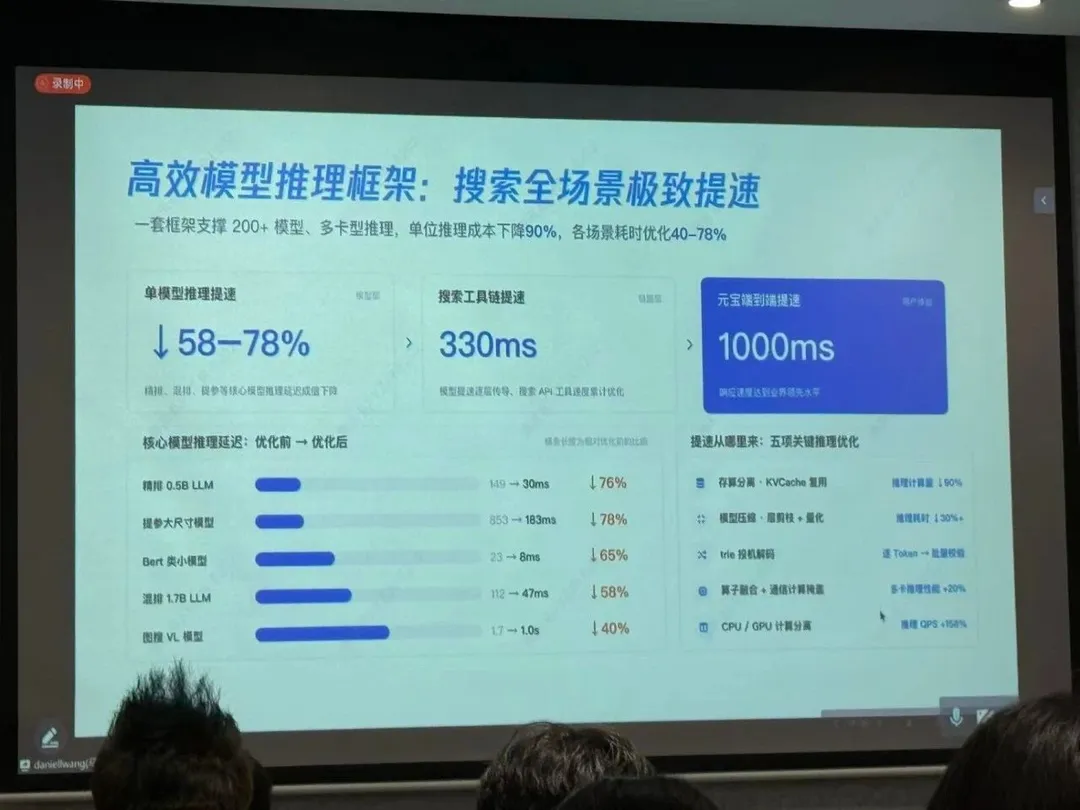
Áp lực về độ trễ đến từ Agent: một nhiệm vụ cần tìm kiếm qua nhiều vòng, mỗi vòng chậm một giây là người dùng không còn kiên nhẫn chờ nổi. Phiên bản nhanh nhất của Yuanbao Search có thời gian phản hồi dưới 300ms cho một lượt (trước khi nâng cấp là 400 đến 500ms), tìm kiếm liên tục 3 vòng mà tổng cộng chưa tới một giây
Chỉ mục . Khâu tốn thời gian đầu tiên là vớt các ứng viên tiềm năng ra từ lượng trang web khổng lồ. Yuanbao Search hợp nhất inverted index tra cứu theo từ khóa và vector index tra cứu theo ngữ nghĩa vào cùng một index quy mô trăm tỷ, tỷ lệ recall đạt trên 94%, thời gian tìm kiếm trung bình chỉ 8ms
Sắp xếp . Sau khi lọc ra còn phải xếp hạng, bước này còn tốn kém hơn: reranking phải chạy model, toàn văn trang web thường lên tới vài nghìn token, mỗi lượt truy vấn đều tính toán lại một lần thì vừa chậm vừa đắt. Giải pháp của Yuanbao Search có tên là Gist token:
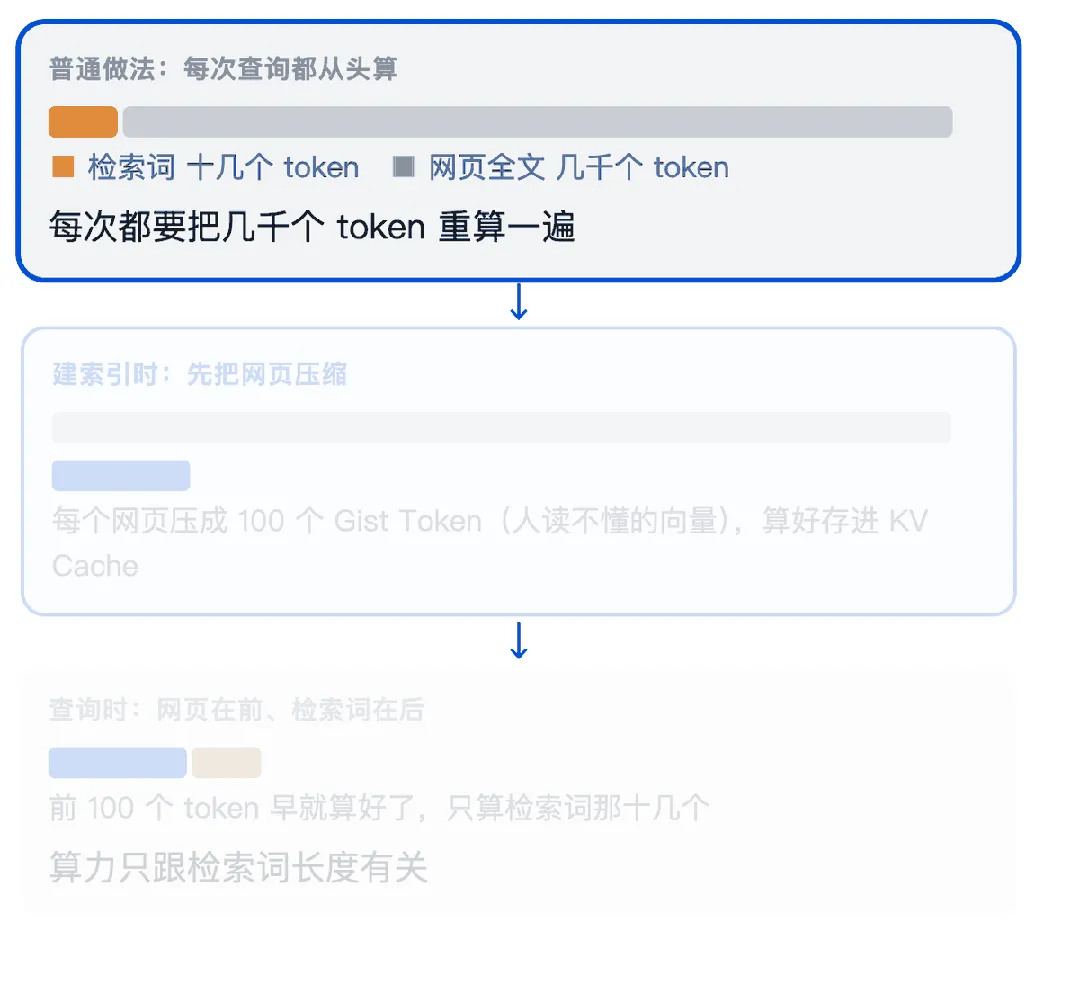
- Khi lập index, trước hết nén mỗi trang web thành 100 Gist token — đây là các vector mà con người không đọc hiểu được, sau khi tính toán xong sẽ lưu vào KV Cache (kết quả trung gian mà model đã tính, lưu lại để không phải tính lại)
- Khi truy vấn, đặt 100 token này ở phía trước, từ khóa tìm kiếm ở phía sau; phần phía trước đã tính xong, chỉ cần tính mười mấy token của từ khóa tìm kiếm
Nhờ đó, khối lượng tính toán khi xếp hạng chỉ phụ thuộc vào độ dài của từ khóa tìm kiếm.
Bộ nhớ cache không thể lưu hết mọi trang web, chỉ lưu các trang phổ biến, vì thế tỷ lệ hit cache càng cao thì càng tiết kiệm. Hạng mục này có thể tiết kiệm khoảng 30% chi phí suy luận online
Suy luận . Bản thân mô hình ranking chạy nhanh hay chậm cũng quyết định tốc độ tổng thể. Framework suy luận của Yuanbao Search có khả năng chạy trên nhiều loại card đồ họa khác nhau, không kén phần cứng, giúp chi phí suy luận trên mỗi đơn vị giảm 90%
Tìm kiếm trở thành API
Khi tìm kiếm đã được tối ưu, bước tiếp theo là đưa nó vào tay Agent. Đối ngoại, nó là một API.
Lấy Yuanbao Search làm ví dụ, bạn có thể lấy API trên Tencent Cloud, sau đó lựa chọn phiên bản và phương thức tính phí. Bản tiêu chuẩn tính phí theo lượng sử dụng (trả sau), 20 NDT/nghìn lượt , tương đương 0,02 NDT một lượt; bạn cũng có thể mua gói tài nguyên. Tôi đang mở bản tiêu chuẩn, trả sau:
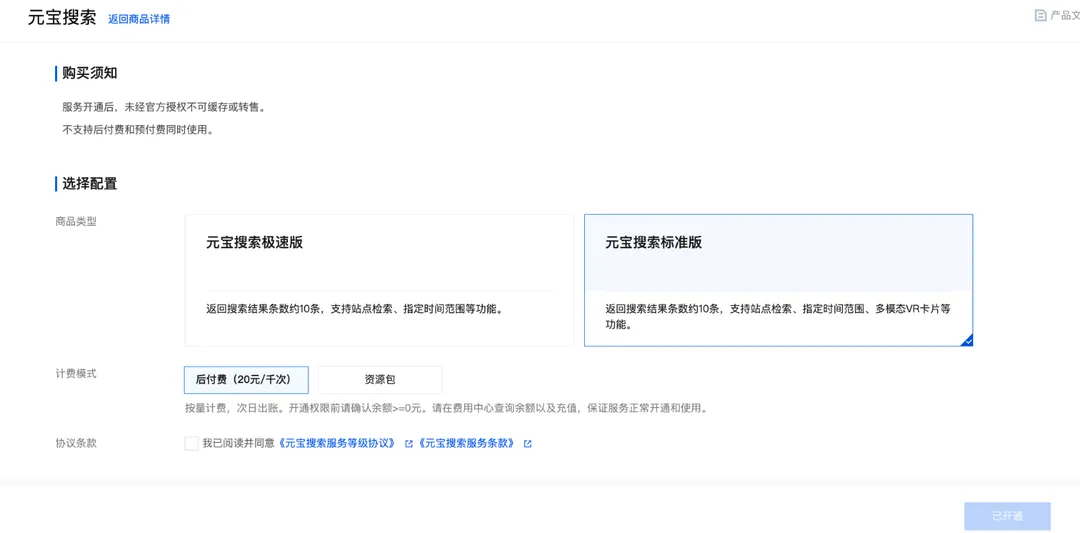
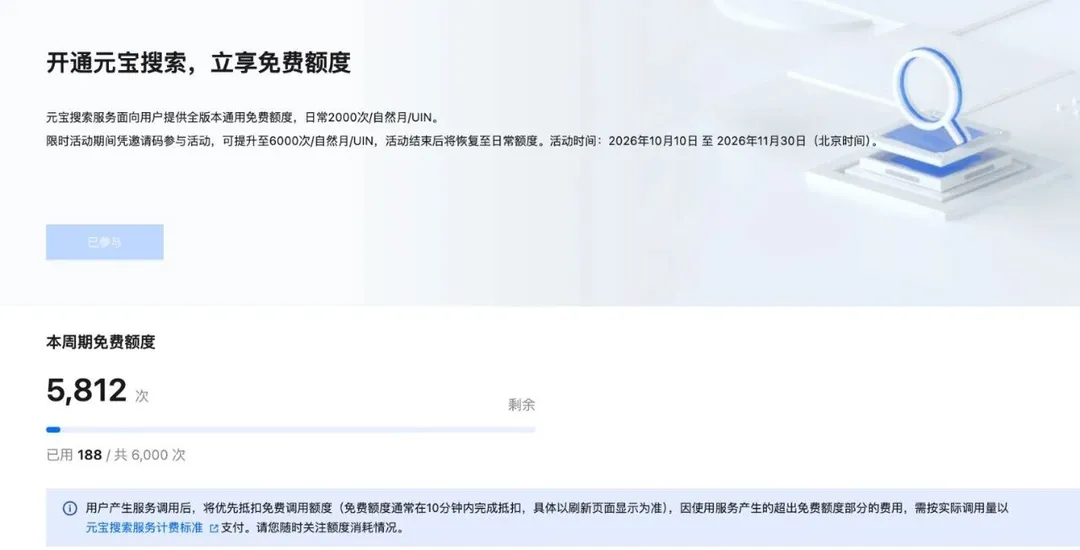
Hạn mức miễn phí là 2.000 lượt/tháng. Từ ngày 10/10 đến ngày 30/11, nếu có mã kích hoạt thì có thể nâng lên 6.000 lượt/tháng (tôi sẽ đi xin rồi gửi dưới phần bình luận sau nhé):
Sau đó vào mục 「Tổng quan → Phương thức API KEY dịch vụ」, bấm 「Tạo API KEY」, đặt tên và nhận được một chuỗi sk- Key bắt đầu bằng:
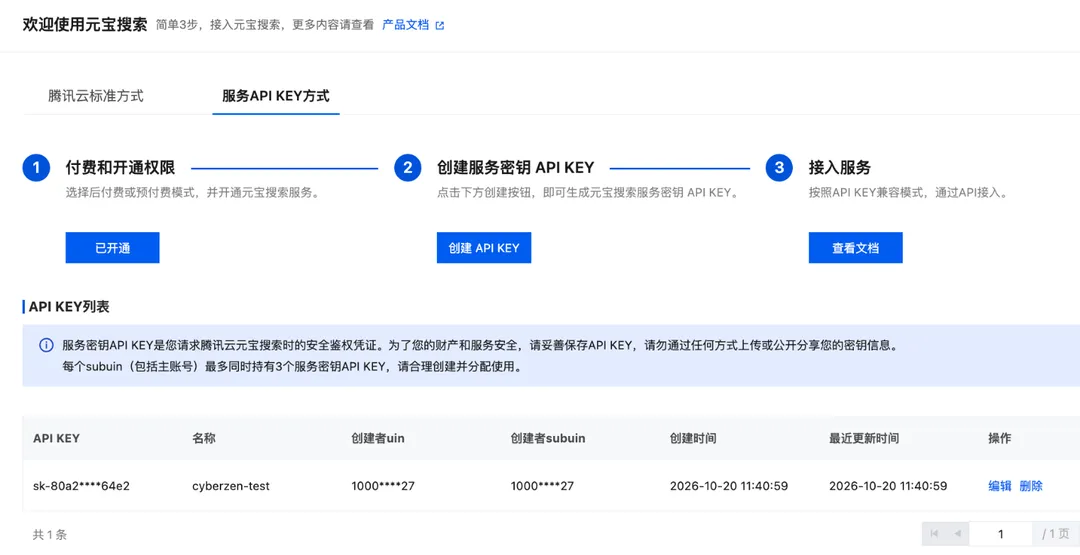
Key dạng plaintext chỉ hiển thị một lần duy nhất khi tạo
Có Key rồi, việc gọi API chỉ là một request HTTPS POST, mang theo Key trong Header và đặt từ khóa tìm kiếm vào Body:
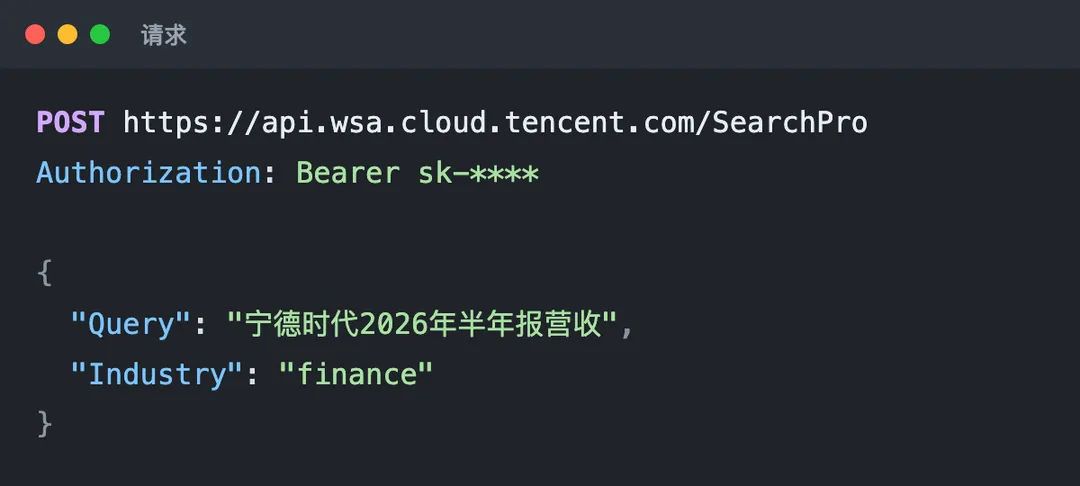
Dữ liệu trả về chính là kết quả được dán lại vào model trong quy trình trao đổi hai chiều ở đầu bài:
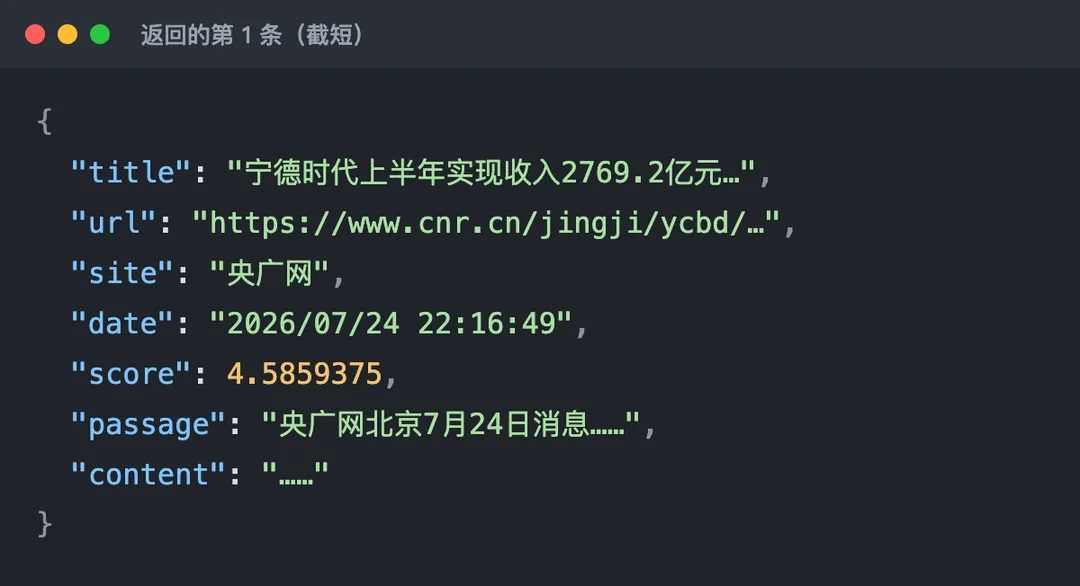
Lưu ý, nó chỉ trả về danh sách các mục kết quả. passage và content đều là trích dẫn nguyên văn, độ dài tối đa lần lượt khoảng 800 từ và 2500 từ. Câu trả lời sẽ do model nhận các mục này tự viết
Mỗi lần lấy bao nhiêu kết quả, tìm ở đâu, bạn đều có thể tự quy định: tối đa 50 kết quả, dùng Cnt tham số để kiểm soát; ngoài ra còn có thể giới hạn website, khoảng thời gian, lĩnh vực chuyên biệt (tài chính, tin tức, chính sách, học thuật), hoặc chỉ lấy card plugin
Các tham số này, cộng với phần tóm tắt động và thẻ plugin, bắt đầu có từ phiên bản Tiêu chuẩn; phiên bản Tốc độ cao chỉ cung cấp 10 kết quả cơ bản. Phiên bản Flagship còn đính kèm thêm điểm độ uy tín từ 0 đến 5 cho mỗi kết quả
Đóng gói tiếp thành MCP
Có API rồi, model vẫn cần phải biết "có một công cụ như thế này, điền tham số ra sao"
Trong ba năm qua, việc này đã đổi qua ba cách viết: Năm 2023 là Plugin của ChatGPT, cần viết một file yaml để mô tả gọi trong trường hợp nào, gửi loại request gì; sau đó là Function Calling; còn bây giờ là MCP. Cách viết tuy khác nhau, nhưng bản chất đều là một bản hướng dẫn sử dụng viết cho model đọc
MCP hiện đang khá phổ biến, bạn có thể lấy các dịch vụ có sẵn trên MCP Square của Tencent Cloud, trên trang đã cung cấp sẵn ví dụ cấu hình, chỉ cần điền Key vừa lấy vào là xong:
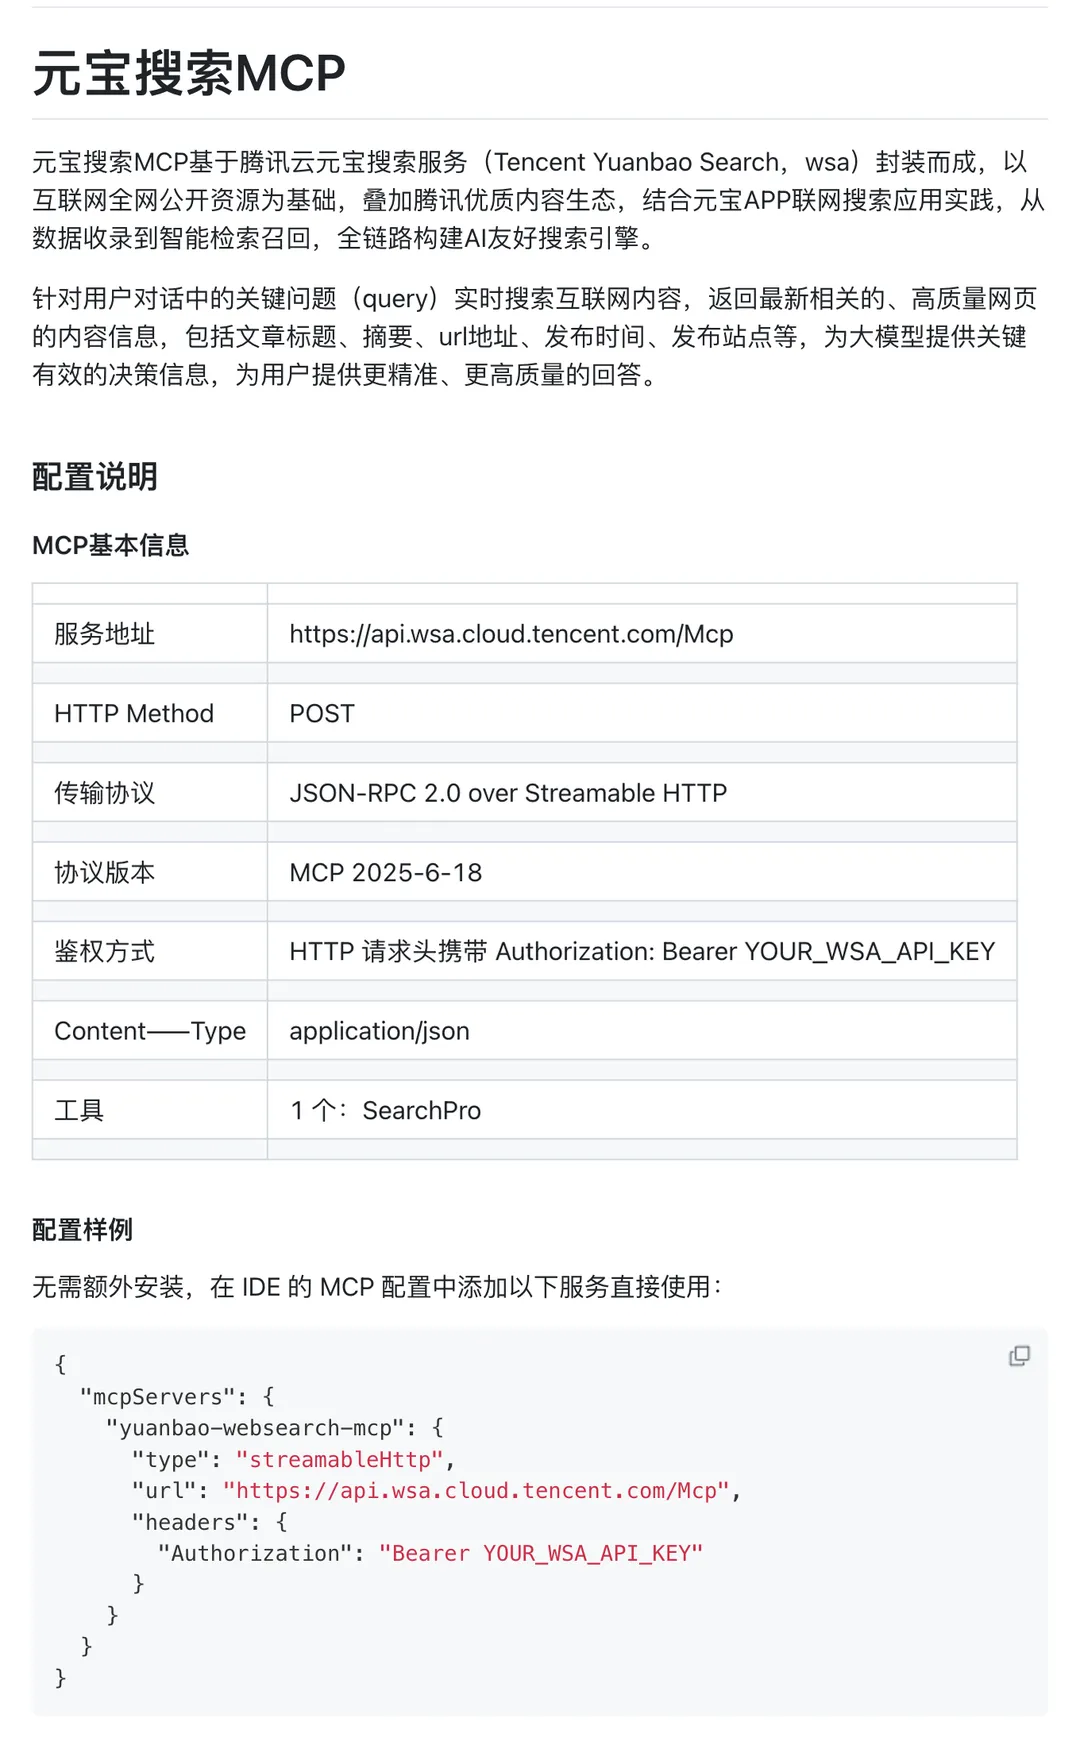
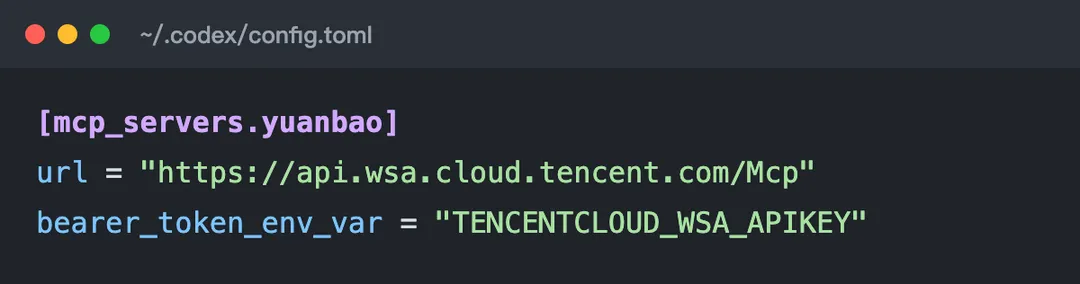
Chuyển sang cách viết của Codex, sẽ gồm ba dòng này:
Nếu agent đang dùng hỗ trợ Skill, thì còn có cách tích hợp tiện hơn nữa: Trên SkillHub của Tencent có Skill chính thức do Yuanbao Search phát hành, bạn chỉ cần gửi prompt cài đặt trên trang đó cho AI của mình, nó sẽ tự động cài đặt:
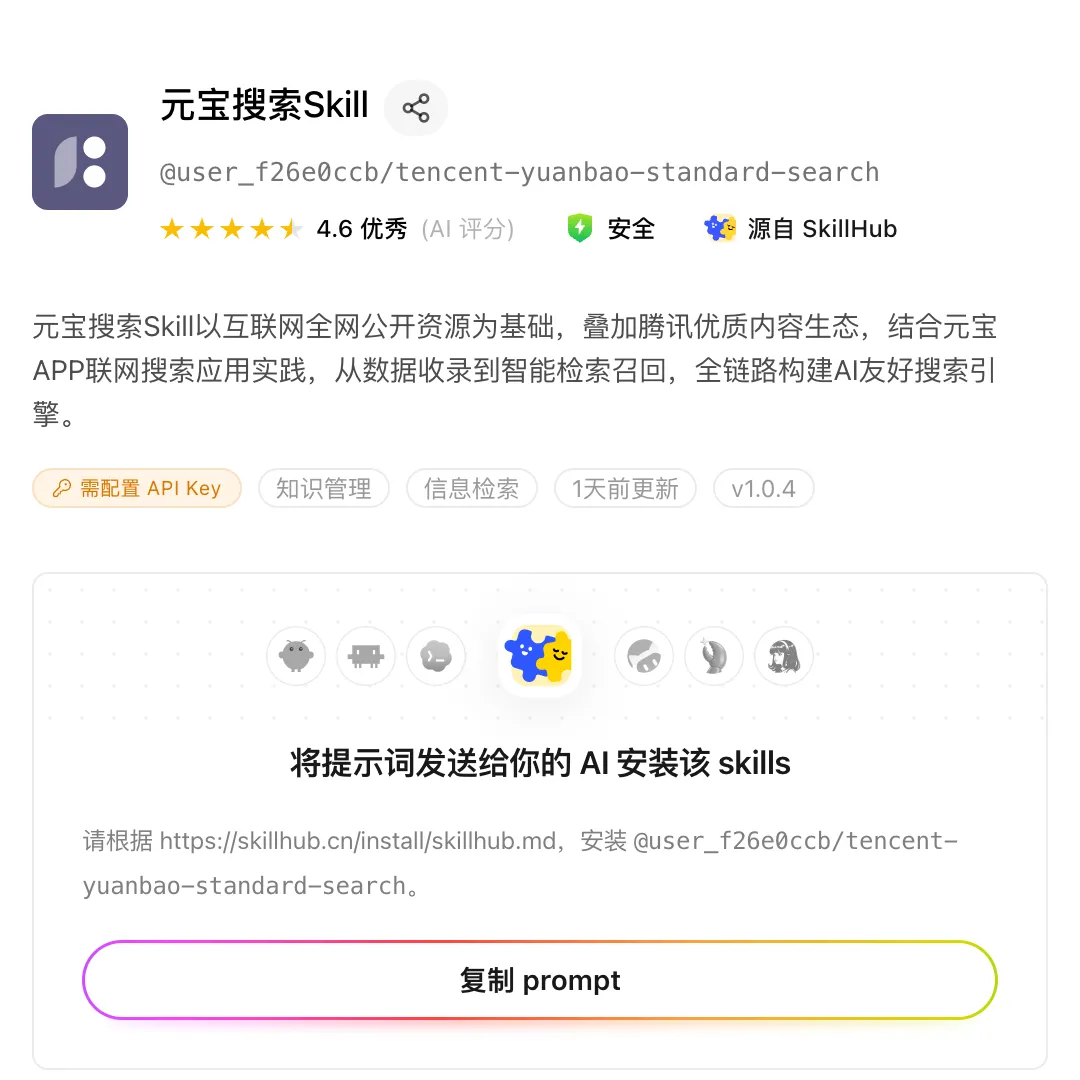
Ba cách tích hợp API, MCP và Skill hoàn toàn không có sự khác biệt về nguồn thông tin bên dưới, chỉ là phương thức đóng gói khác nhau
Quay lại với MCP. Sau khi cấu hình xong, Codex và dịch vụ tìm kiếm sẽ giao tiếp với nhau từng bước như sau:
Bước đầu tiên là initialize, hỏi đối phương là ai:
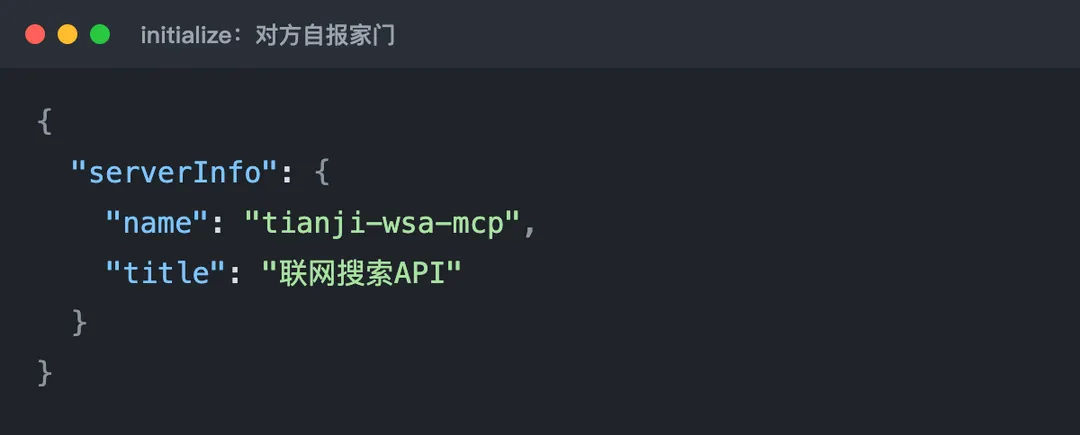
Emmm... trước khi đổi tên, nó có tên là "API tìm kiếm kết nối mạng"
Bước thứ hai là tools/list, hỏi đối phương có những công cụ gì, và nhận về bản hướng dẫn đó:
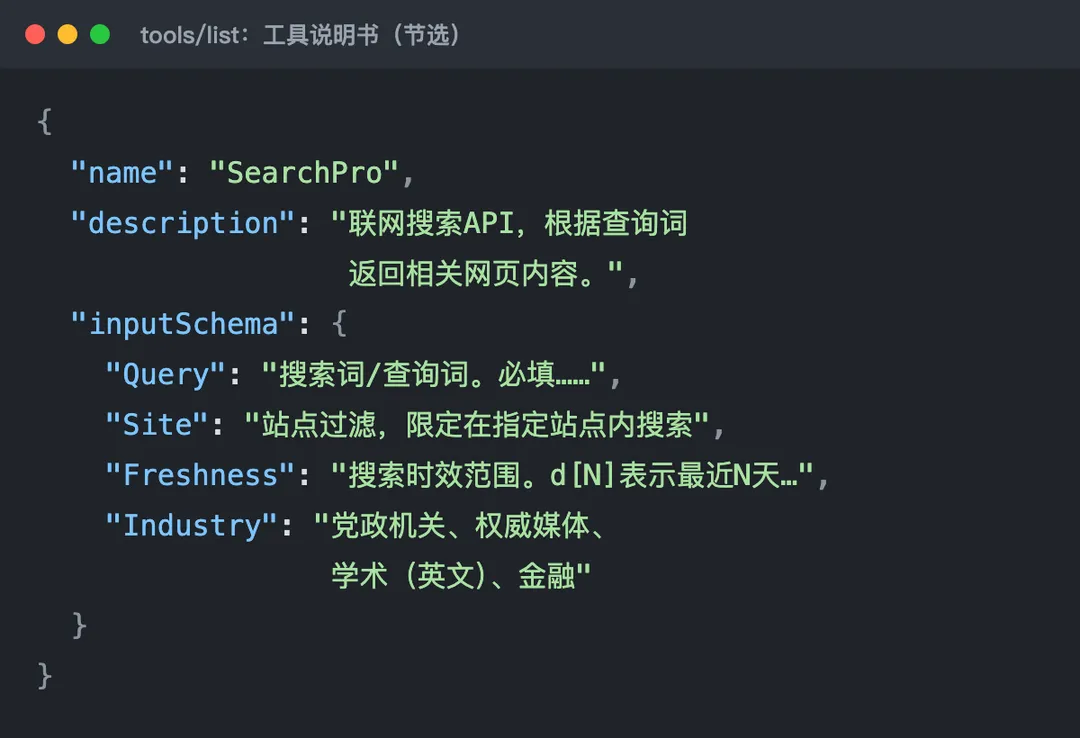
Model dựa vào đó để phán đoán khi nào nên tìm kiếm, và điền tham số như thế nào
Bước thứ ba là tools/call, được gửi đi khi model thực sự muốn tìm kiếm. Dịch vụ MCP sẽ chuyển tiếp các tham số đến API nói trên, rồi đóng gói nguyên vẹn JSON mà API trả về vào một đoạn văn bản để gửi ngược lại
Vì vậy, phiên bản MCP và phiên bản API nhận được cùng một kết quả, MCP chỉ có thêm một bản hướng dẫn sử dụng viết riêng cho model
Khi bản hướng dẫn đã được viết rõ ràng, việc tìm kiếm bao nhiêu lần, tìm kiếm như thế nào sẽ do chính model tự quyết định. Còn chất lượng cuối cùng ra sao cũng chịu ảnh hưởng bởi khả năng lập kế hoạch của model, điển hình là bài toán multi-hop (nhiều bước nhảy)
Cái gọi là multi-hop nghĩa là câu trả lời phải trải qua nhiều khúc quanh: trước tiên tra ra A, mới biết cần đi tra B; tra được B rồi, mới biết bước tiếp theo phải tra cái gì. Ví dụ như câu tôi hỏi Codex dưới đây:
Trong số những người đoạt giải Nobel Vật lý năm 2026, người trẻ nhất hiện đang công tác tại trường đại học nào? Hiệu trưởng đương nhiệm của trường đại học này là ai?
Về phía người dùng, những gì nhìn thấy là như thế này:
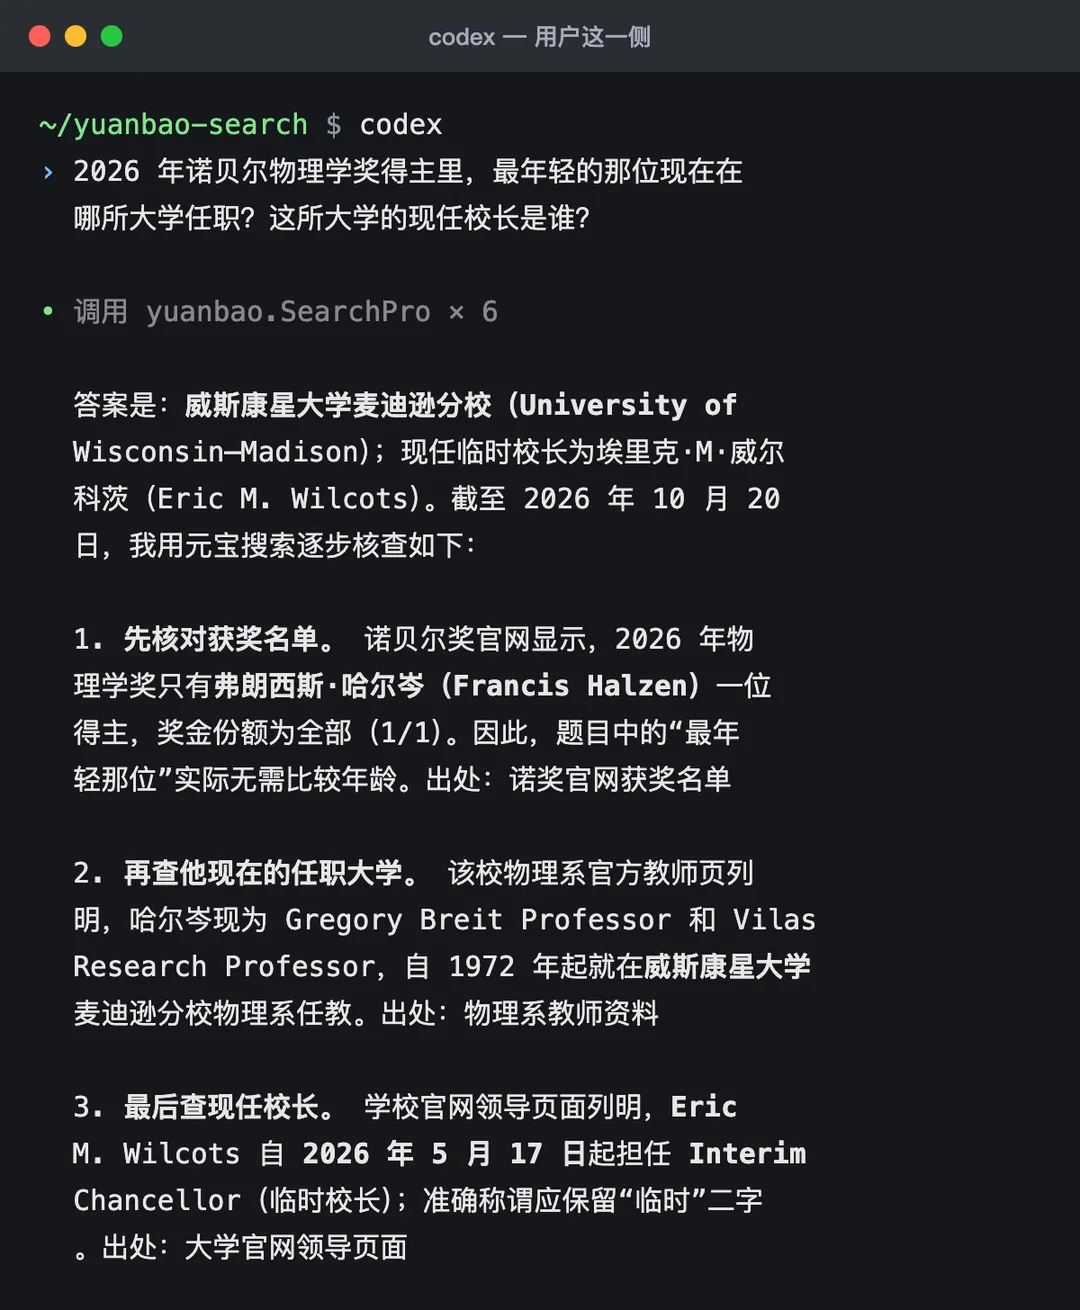
Về phía API, Codex đã gửi tổng cộng 6 lần tools/call:
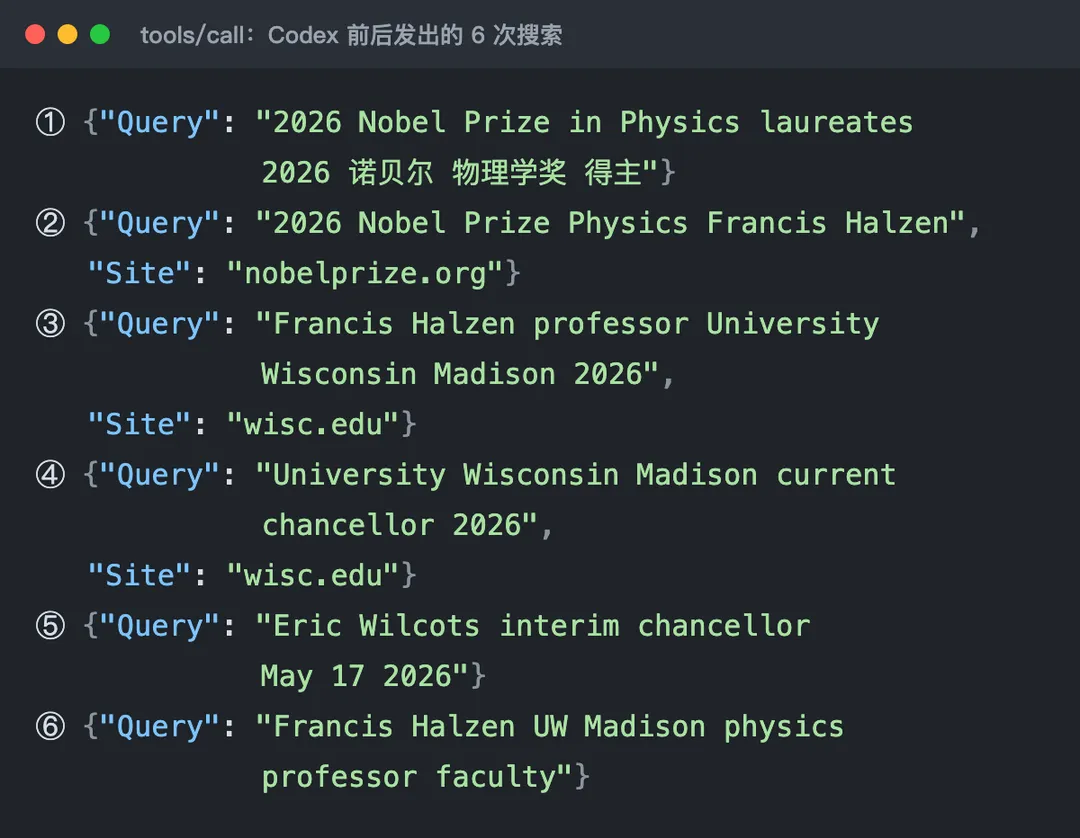
Lần thứ hai, nó thu hẹp phạm vi trong trang web chính thức của giải Nobel, phát hiện năm nay chỉ có một người đoạt giải duy nhất là Francis Halzen, nên không cần so sánh "người trẻ nhất". Lần thứ ba giới hạn trong trang web của Đại học Wisconsin, xác nhận ông đang ở phân hiệu Madison. Lần thứ tư và thứ năm tra được hiệu trưởng đương nhiệm là hiệu trưởng lâm thời Eric Wilcots, nhậm chức ngày 17 tháng 5 năm 2026
Loại trừ vài lần dùng để đối soát kiểm tra, mạch chính gồm ba bước nhảy, và mỗi bước nhảy đều là quy trình khứ hồi như đã nói ở đầu:
Nếu ném nguyên si câu đó cho API tìm kiếm một lần, kết quả trả về sẽ là 10 mẩu tin tức về việc "Halzen đoạt giải", hoàn toàn không có thông tin nào về trường đại học và hiệu trưởng
Điều này thể hiện sự phân công giữa công cụ và việc gọi công cụ: Tìm kiếm là một năng lực mang tính nguyên tử, một request chỉ tìm kiếm một việc; còn việc lập kế hoạch multi-hop thì do agent giải quyết
Lý do cũng rất đơn giản: Bước nhảy thứ hai cần tìm gì, phải đợi đọc xong kết quả của bước nhảy thứ nhất mới biết. Bên đọc kết quả và đưa ra phán đoán chính là agent, nên bước nhảy tiếp theo chỉ có thể do nó quyết định; việc mà công cụ tìm kiếm cần làm là tìm cho thật chuẩn và thật nhanh ở mỗi bước nhảy
Bốn điều đã đề cập ở phần trước đều nói về "một lần thực hiện": hiểu được từ khóa truy vấn, phân biệt được thực hư của kết quả, thông tin đủ mới, và trả về trong vòng vài trăm mili-giây. Chỉ khi từng lần làm thật vững chắc thì agent mới dám tìm kiếm liên tiếp năm, sáu lượt
Ngoài ra, loại API này chỉ cung cấp đoạn trích chứ không cung cấp toàn bộ trang web, muốn đọc toàn văn thì agent vẫn phải tự mình đi crawl
Cuối cùng
Câu mở đầu "Ngày mai trời nắng, không cần mang ô", người dùng chỉ nhìn thấy duy nhất một câu nói. Nhưng đằng sau đó là model đã viết một request, đọc mười kết quả, trong khi công cụ tìm kiếm phải lọc ra mười kết quả này từ hàng trăm tỷ trang web chỉ trong vài trăm mili-giây
Khi chuyển sang để agent thực hiện nhiệm vụ, quy trình khứ hồi này sẽ lặp lại qua nhiều lượt
Vì vậy, khi chọn dịch vụ tìm kiếm cho agent, bạn có thể dựa vào bốn điều nói trên để đánh giá:
- Với các vấn đề như báo cáo tài chính, chính sách, y tế, kết quả trả về có phải từ nguồn chính thức và có thẩm quyền hay không
- Với dữ liệu thời gian thực như giá cổ phiếu, thời tiết, có hỗ trợ thẻ hiển thị có cấu trúc hay không
- Thời gian cho mỗi lần có ép xuống được vài trăm mili-giây không, để agent dù tìm liên tiếp vài lượt cũng không bị gián đoạn
- Có thể giới hạn trang web, thời gian và lĩnh vực hay không, giúp agent tự thu hẹp phạm vi tìm kiếm
Thêm vào đó, tôi vẫn nhớ giá của AI search thời kỳ đầu nhìn chung đều rất đắt, chẳng hạn vào cuối năm 23, mức giá phổ biến trong ngành là khoảng 15~25 USD/nghìn lần (tìm kiếm phi AI là 5 USD/nghìn lần)
Còn hiện tại, cùng với sự phát triển của ngành, mức giá cũng đã giảm sâu rất nhiều, đến mức cá nhân cũng có thể chi trả được. Lấy Yuanbao được nhắc tới trong bài viết này làm ví dụ, mỗi tài khoản hàng tháng có hạn mức 2.000 lần miễn phí, phần vượt quá đối với phiên bản Tiêu chuẩn sẽ tính theo mức 20 NDT/nghìn lần sử dụng, dùng số lượng lớn còn có chiết khấu thêm (ai hiểu thì tự hiểu), có thể coi là công nghệ đã thực sự phổ cập đến mọi người
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác