Link bài viết gốc: https://mp.weixin.qq.com/s/fZGYBZUSLJUpq...
Kim Tiên Sinh là người Triều Tiên a · Official Account · Lão Kim cùng bạn chơi AI · 2026-10-19 23:46
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
Chú thỏ bí ẩn từng khiến cộng đồng developer liên tục đoán già đoán non về danh tính, MiniMax đã chính thức xác nhận rồi,
Ngày 19 tháng 10, MiniMax chính thức cập nhật M3.1 Flash. Phía công ty xác nhận rằng chú thỏ xuất hiện ẩn danh trước đó Space Bunny, chính là phiên bản thử nghiệm ban đầu của M3.1 Flash .
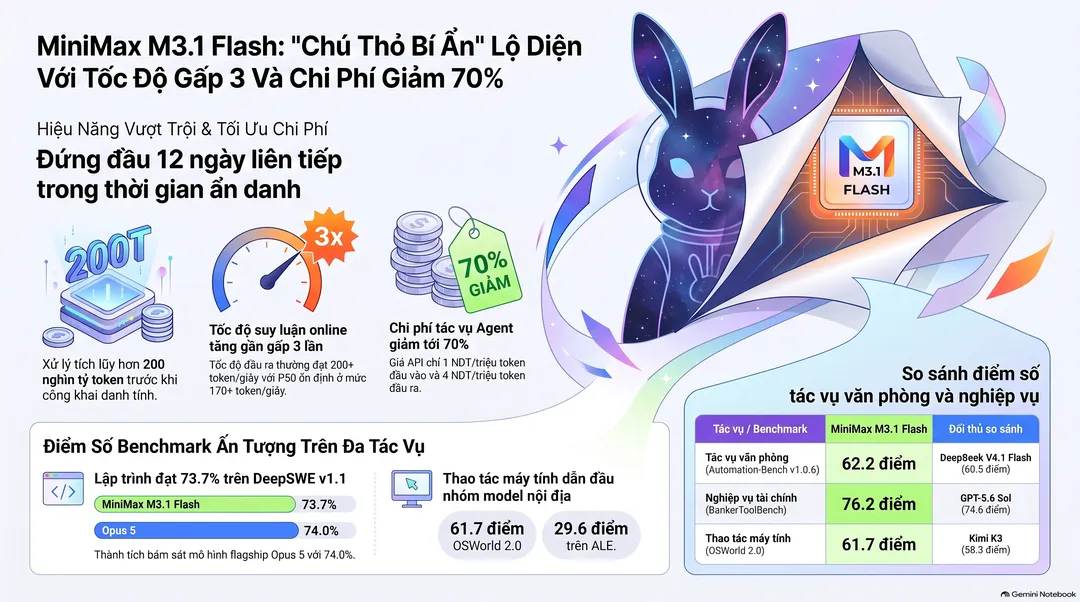
Hơn nữa, trước khi công khai danh tính, chú thỏ này đã xử lý hơn 200T token, tức 200 nghìn tỷ token.
Trước đó nó hot đến mức nào? Lão Kim tôi đã đặc biệt kiểm tra lại dữ liệu trên nền tảng.
Trong lịch sử công khai của OpenCode, từ ngày 24 tháng 9 đến ngày 5 tháng 10, tính theo lượng token sử dụng hàng ngày, nó đã đứng vị trí số 1 trong 12 ngày liên tiếp.
Giờ đây, MiniMax đã tung ra phiên bản chính thức cùng bảng điểm đầy đủ: Tốc độ suy luận online tăng gần gấp 3 lần, chi phí sử dụng tổng hợp cho tác vụ agent giảm 70%.
Điều đáng để theo dõi tiếp là vị trí của nó trong một số bài benchmark về văn phòng, lập trình và thao tác máy tính. Một model Flash giờ đã bắt đầu ngồi chung mâm so kè với các model flagship.
Trước đó, trình độ thực sự của chú thỏ bí ẩn ra sao?
Trước tiên hãy xem lượng sử dụng thực tế.
OpenCode là một công cụ lập trình AI mã nguồn mở, cho phép developer gọi các model khác nhau bên trong đó. Trang dữ liệu công khai của công cụ này vẫn lưu lại lượng sử dụng model hàng ngày, và Space Bunny trong lịch sử hiện đã được gắn tên chính thức là MiniMax-M3.1-Flash.
Ngày 24 tháng 9, lượng sử dụng trong một ngày của nó đạt 6.8T token, cùng ngày đó DeepSeek V4.1 Flash là 6.2T, còn Muse Spark 1.3 là 5.4T.
Đến ngày 25 tháng 9, chú thỏ tăng lên 9.0T, trong khi hai model còn lại lần lượt là 4.6T và 5.1T.
Ngày 30 tháng 9, lượng sử dụng đơn ngày đạt 10T. Kéo dài cho tới tận ngày 5 tháng 10, nó vẫn dẫn đầu với 9.9T.
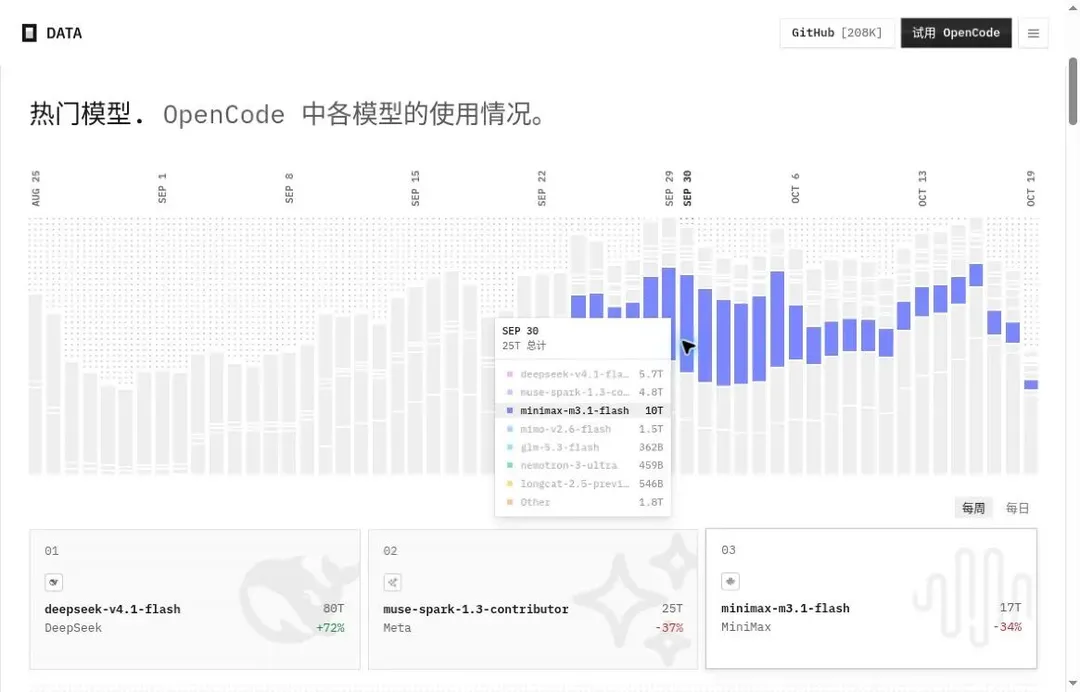
Từ ngày 24 tháng 9 đến ngày 5 tháng 10, suốt 12 ngày liên tục. Kết luận này được rút ra từ việc so sánh từng ngày theo bảng lịch sử công khai hiện tại của OpenCode. Đến ngày 6 tháng 10, lượng dùng một ngày của Muse đã vượt qua nó, nên ở đây chỉ tính thành tích lịch sử trong 12 ngày đó.
Còn một kỷ lục trực tiếp được ghi nhận vào thời điểm đó: Ngày 28 tháng 9, phía OpenCode chính thức đăng bài cho biết Space Bunny đã giữ vị trí số 1 trên nền tảng suốt 5 ngày liên tiếp, xử lý 40T token. Sức nóng trong giai đoạn ẩn danh hoàn toàn có thể kiểm chứng qua bài đăng gốc của nền tảng.
Lượng gọi API bao gồm cả token bộ nhớ cache, đồng thời cũng chịu ảnh hưởng bởi mức giá trải nghiệm, các chương trình ưu đãi và cách thức sử dụng. Nó cho thấy developer thực sự đang gọi model này rất nhiều, còn năng lực rốt cuộc ra sao thì vẫn phải xem tiếp kết quả xử lý tác vụ.
Về năng lực, cũng có những ghi nhận độc lập để lại từ giai đoạn ẩn danh. Mục hiện tại trên AI Coding Daily của developer Povilas Korop cho thấy thành tích của Space Bunny ở mức thiết lập Max khi sử dụng OpenCode là 57.19/80 , với ngày benchmark gần nhất ghi là 30 tháng 9. Phương pháp hiện tại của trang web này bao gồm 7 dự án có sẵn, 27 prompt, trong quá trình không bổ sung thêm hướng dẫn; phương pháp vẫn tiếp tục được cập nhật vào tháng 10, số liệu ở đây lấy theo các mục hiển thị hiện tại.
Trong bản snapshot ngày 19 tháng 10 của bảng xếp hạng này, Space Bunny nằm cạnh Gemini 4 Argon High (57.09) và Kimi K3 High (56.89). Do công cụ và mức suy luận khác nhau nên điểm số cần phải xem xét cùng các thiết lập tương ứng. Ít nhất thì bản ghi này cũng chứng minh rằng ngay trong thời kỳ ẩn danh, nó đã là một ứng viên cạnh tranh đáng gờm về mặt lập trình.
Đây cũng chính là điểm thú vị nhất của màn hé lộ lần này: Mọi người đã dùng thử chú thỏ vô danh kia trước, rồi hôm nay MiniMax mới chính thức dán tên mình lên.
Con số 200T token xử lý tích lũy do phía công ty công bố có phạm vi rộng hơn nhiều so với bảng xếp hạng theo ngày của một nền tảng đơn lẻ, hai bộ số liệu này nên được nhìn nhận độc lập.
Lần nâng cấp này đã đẩy năng lực lên đến đâu?
Trước tiên hãy cùng xem bảng so sánh đầy đủ của hãng, dưới đây sẽ phân tích bóc tách từng hạng mục.
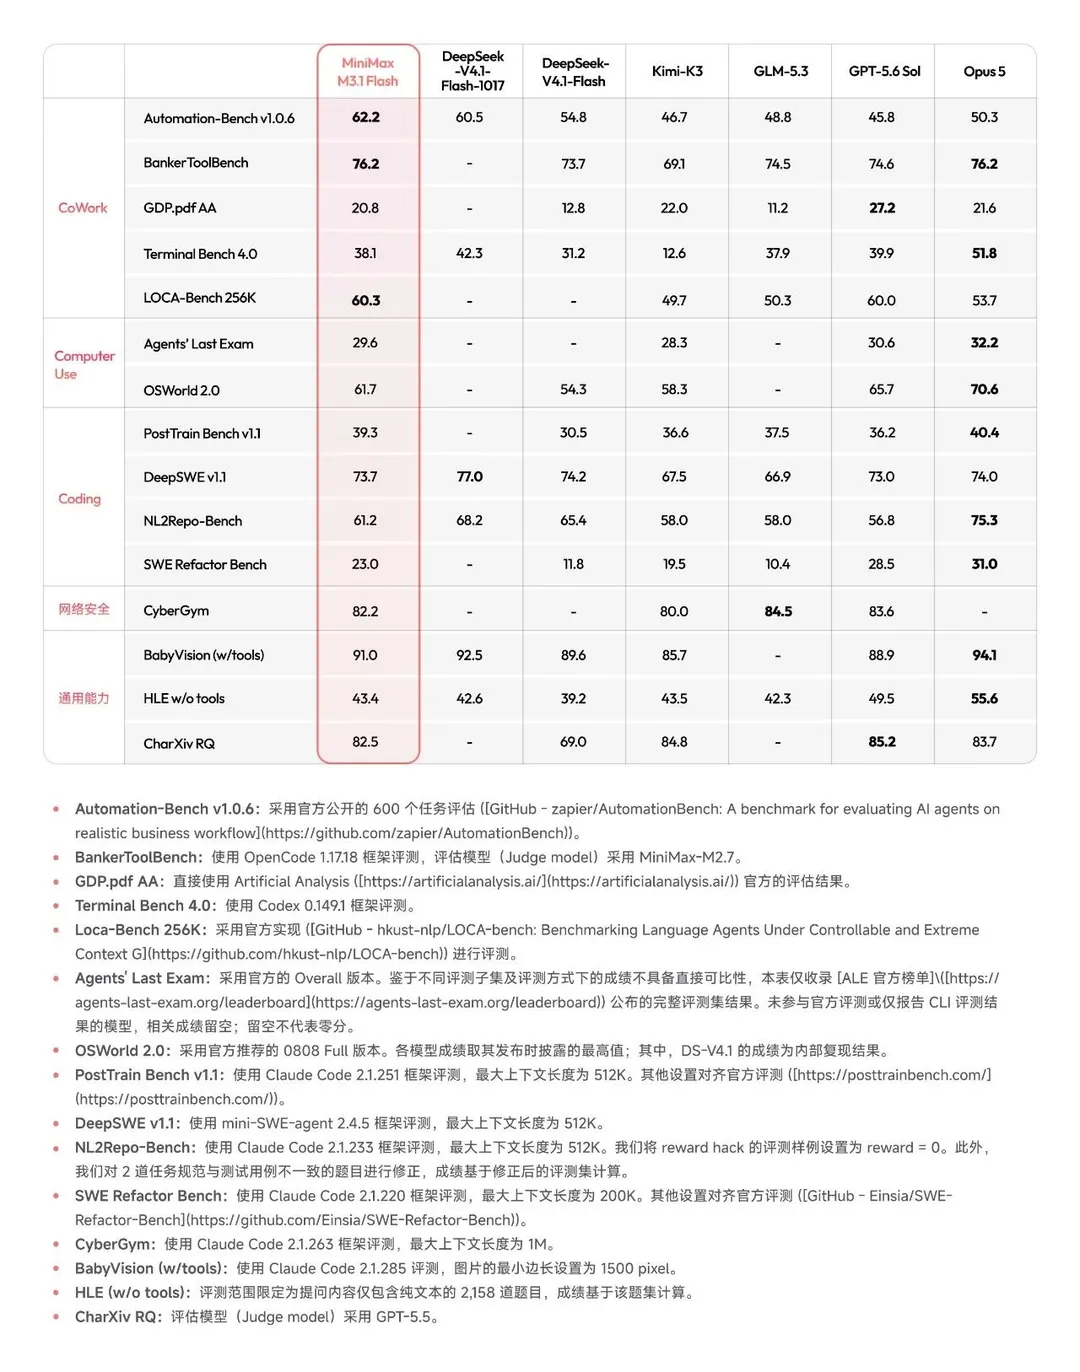
CoWork là làm việc văn phòng cộng tác, Computer Use là thao tác máy tính, còn Coding là lập trình.
Mỗi dòng áp dụng các bài benchmark và thiết lập công cụ khác nhau, phần giải thích chi tiết được giữ lại ở phía dưới ảnh gốc. Nội dung dưới đây đối chiếu theo các phiên bản và điểm số được liệt kê trong bảng này.
Tác vụ văn phòng phức tạp: Hai kết quả vô cùng ấn tượng
Một là Automation-Bench v1.0.6.
Loại benchmark này đặt model vào workflow nghiệp vụ nhiều bước để xem liệu nó có hiểu mục tiêu, gọi công cụ liên tục và thúc đẩy công việc tiến triển hay không. Nó bao gồm các công việc như bán hàng, vận hành, chăm sóc khách hàng..., thử thách không chỉ nằm ở câu trả lời cuối cùng có tốt hay không.
Điểm số mà MiniMax công bố lần này là 62.2 .
Trong cùng bảng dữ liệu chính thức, DeepSeek V4.1 Flash-1017 đạt 60.5, Opus 5 đạt 50.3, GPT-5.6 Sol đạt 45.8. M3.1 Flash xếp dẫn đầu trong nhóm so sánh này.
Hạng mục khác là BankerToolBench, 76.2 điểm, đồng hạng với Opus 5 .
Benchmark này thiên về các tác vụ công cụ nhiều bước trong nghiệp vụ tài chính, đòi hỏi duy trì tính nhất quán giữa tài liệu, tệp tin và công cụ. Trong biểu đồ tương ứng, GPT-5.6 Sol đạt 74.6, GLM-5.3 đạt 74.5, Kimi K3 đạt 69.1.
Dạng tác vụ này rất dễ gặp vấn đề: Bước 1 trông có vẻ đúng, nhưng đến bước 5 thì đã quên sạch các ràng buộc ban đầu. Chỉ khi nắm bắt liền mạch thông tin giữa các file và liên tục thực thi công cụ thì mới có cơ hội đảm nhận các chuỗi công việc dài hơn.
Phía công ty cũng cung cấp một biểu đồ đặt năng lực và chi phí cạnh nhau.
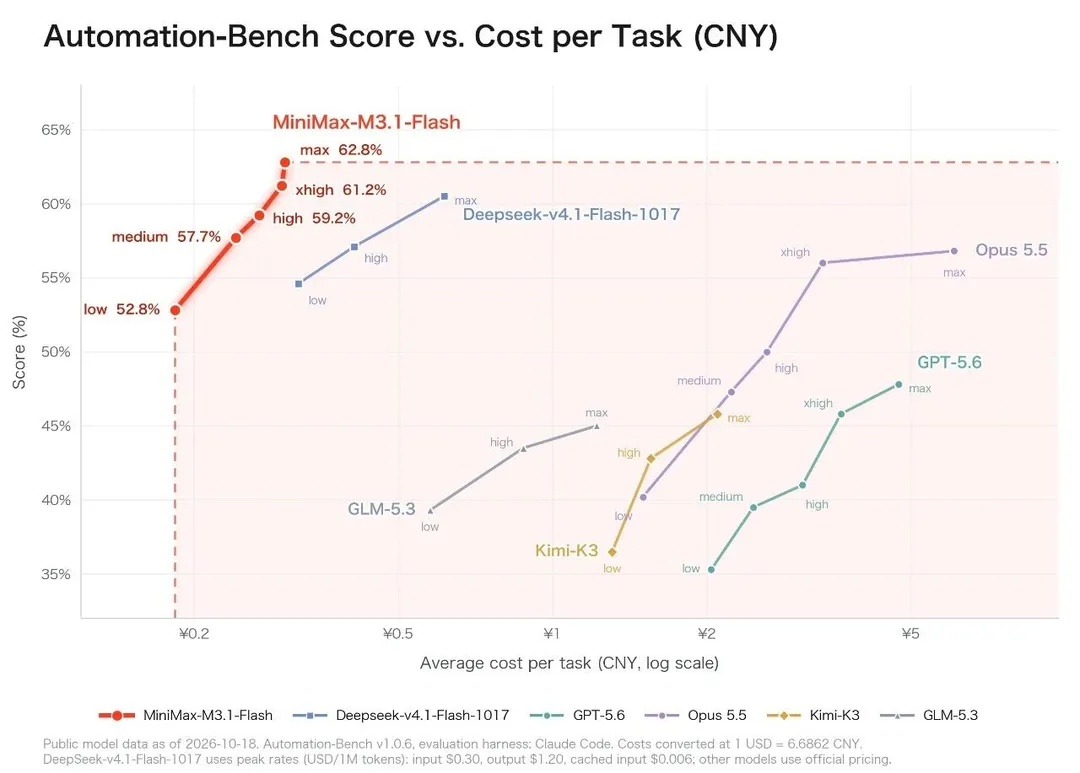
Ở đây trục tung càng cao thì điểm benchmark càng cao; trục hoành là chi phí trung bình cho mỗi tác vụ (đơn vị: NDT, tính theo thang đo logarit), càng về bên trái thì càng rẻ.
low, medium, high, xhigh, max biểu thị các mức cường độ suy luận khác nhau.
Điểm mấu chốt mà biểu đồ này muốn truyền tải rất trực diện: Trong các thiết lập thử nghiệm được công bố, M3.1 Flash nằm nghiêng hẳn về góc trên bên trái.
Nghĩa là vừa nâng cao năng lực hoàn thành tác vụ, vừa giúp chi phí trở nên cạnh tranh hơn rất nhiều.
Lập trình đạt 73.7%, chỉ kém Opus 5 đúng 0.3 điểm phần trăm
Ở benchmark DeepSWE v1.1, M3.1 Flash đạt 73.7% .
Bài benchmark này tập trung vào khả năng hiểu, sửa đổi và kiểm thử code trong các tác vụ phần mềm phức tạp. Đối với những ai thường xuyên dùng AI để làm dự án, nó gần gũi với mối quan tâm thực sự của chúng ta hơn nhiều so với việc chỉ dựng một trang web đẹp mắt.
Trong cùng bảng tổng hợp, GPT-5.6 Sol đạt 73.0%, Opus 5 đạt 74.0%. Khoảng cách giữa chúng thực sự đã rất sít sao.
DeepSeek V4.1 Flash-1017 đạt 77.0%, vẫn tiếp tục dẫn đầu. M3.1 Flash ở hạng mục này đã đuổi sát nút các model flagship, dù chưa thể giành lấy số điểm cao nhất.
Tiếp theo, hãy nhìn vào đường cong chi phí lập trình do hãng công bố.
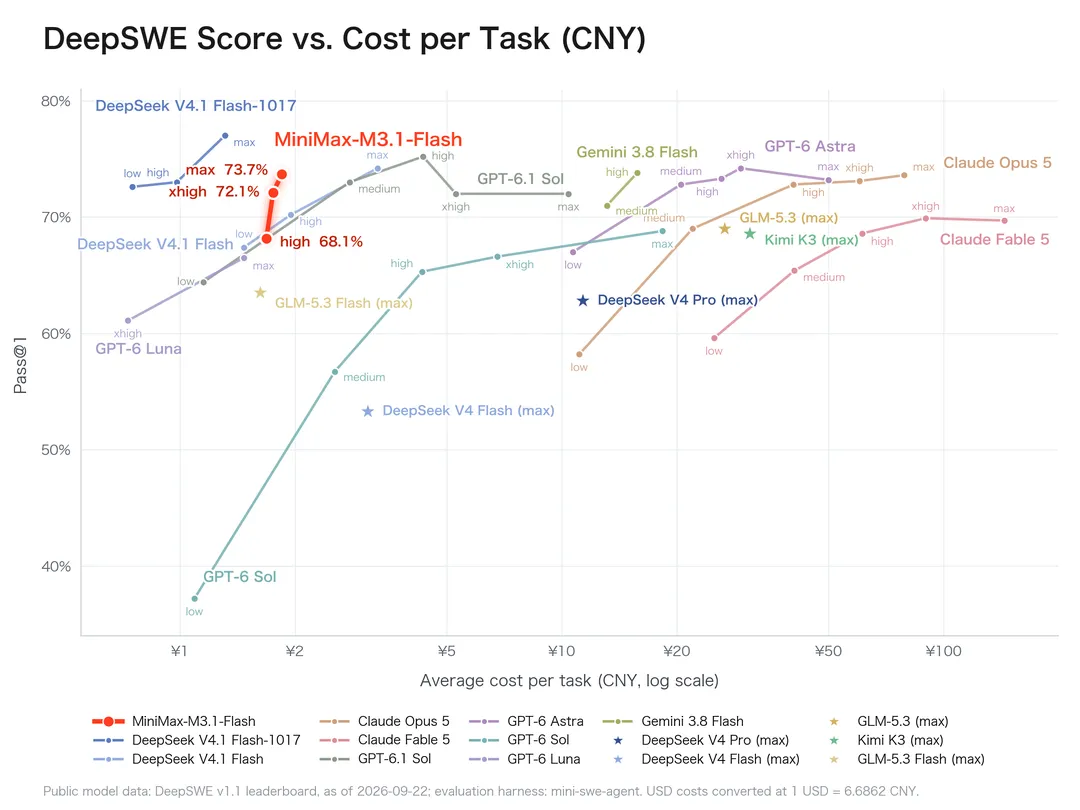
Trục tung Pass@1 biểu thị tỷ lệ vượt qua sau một lần thử, trục hoành là chi phí trung bình cho mỗi tác vụ (đơn vị: NDT, tính theo thang đo logarit).
Đường màu đỏ là M3.1 Flash: high 68.1%, xhigh 72.1%, max 73.7%.
Trong biểu đồ này, Lão Kim để ý nhiều hơn đến đoạn màu đỏ ngắn đó.
Từ high đến xhigh, rồi lên max, điểm số tăng dần và chi phí cũng biến động tương ứng. Nó đưa câu chuyện về cường độ tư duy ra ánh sáng: bạn có thể chọn nấc cấu hình theo độ khó của tác vụ, thay vì lần nào cũng dùng chung một mức thiết lập.
Tuy nhiên, bảng tổng hợp đầy đủ cũng để lộ ra những điểm yếu của nó.
Ở các tác vụ tái cấu trúc mã như SWE Refactor Bench, M3.1 Flash đạt 23.0, GPT-5.6 Sol là 28.5, Opus 5 là 31.0. Trong NL2Repo-Bench, số điểm 61.2 của nó cũng thấp hơn mức 75.3 của Opus 5.
Vì vậy, bước tiến giá trị nhất lần này là ở phân khúc chi phí Flash, model đã có thể áp sát các model flagship trong một số tác vụ lập trình phức tạp . Nhưng khi thực hiện tái cấu trúc hay các dự án kỹ thuật chuỗi dài, bạn vẫn cần tùy biến theo từng tác vụ cụ thể.
Thao tác máy tính: Hai thành tích lọt top đầu model nội địa
Thao tác máy tính là một trọng tâm rõ rệt khác.
Trên OSWorld 2.0, M3.1 Flash ghi được 61.7 . Trong bảng so sánh chính thức, Kimi K3 đạt 58.3, DeepSeek V4.1 Flash là 54.3; còn GPT-5.6 Sol là 65.7, Opus 5 là 70.6.
Xem tiếp Agents’ Last Exam, viết tắt là ALE. M3.1 Flash đạt 29.6 , Kimi K3 là 28.3, GPT-5.6 Sol là 30.6, Opus 5 là 32.2.
MiniMax tuyên bố trong thông báo rằng hai kết quả này đứng đầu trong số các model nội địa. Từ bảng so sánh được cung cấp, M3.1 Flash quả thực cao hơn các đối thủ nội địa được liệt kê.
Loại benchmark này đánh giá khả năng hoàn thành tác vụ của AI trong môi trường máy tính: phải tìm đúng cổng giao diện, hiểu trạng thái hiện tại, thao tác trên ứng dụng, sau đó tiếp tục các bước kế tiếp. Trong quá trình sử dụng AI hàng ngày, rất nhiều điểm nghẽn gây đau đầu thường xảy ra chính ở những khâu này.
ALE còn có một biểu đồ chi phí trực quan hơn nữa.
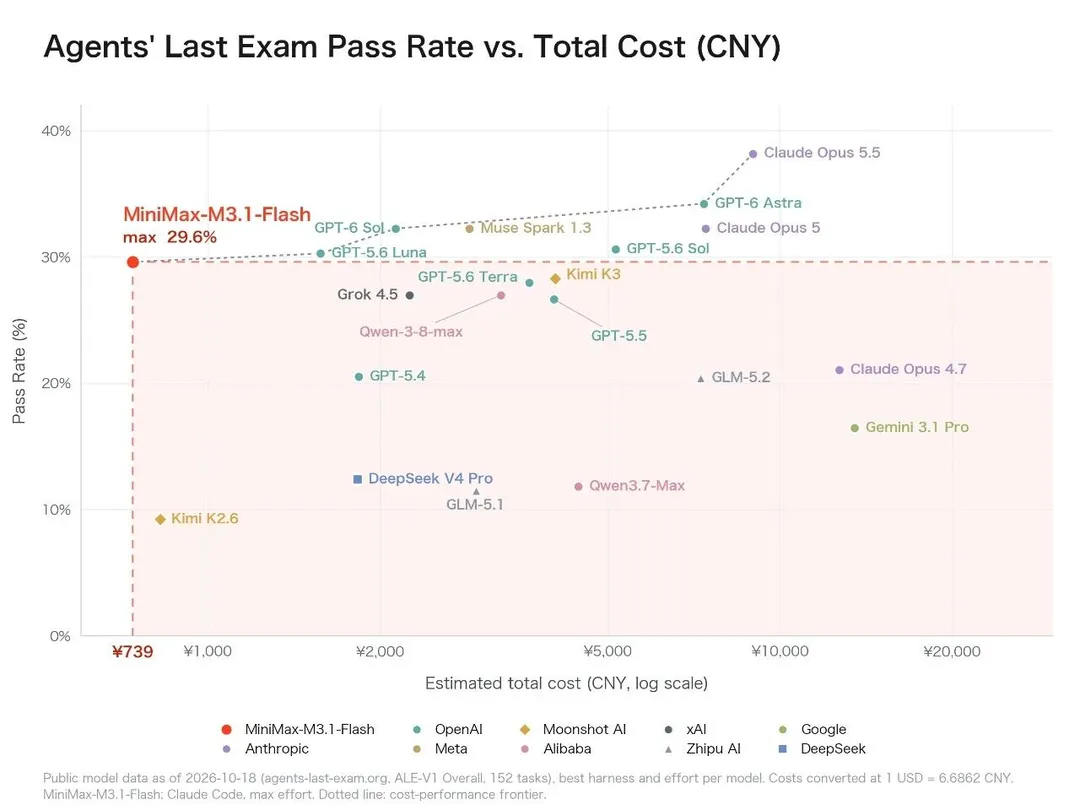
Trục tung là tỷ lệ vượt qua bài benchmark được chú thích trên biểu đồ, trục hoành là tổng chi phí dự kiến cho toàn bộ bài benchmark (đơn vị: NDT, thang đo logarit).
Điểm đỏ của M3.1 Flash là 29.6%, 739 NDT; chú thích biểu đồ áp dụng ALE-V1 Overall với 152 tác vụ.
Con số 739 NDT rất bắt mắt, nhưng khi đọc biểu đồ bạn cần chú ý đơn vị: nó tính tổng chi phí ước tính cho toàn bộ bài benchmark.
Điều mà công ty muốn nhấn mạnh là trong bộ benchmark này, nó có thể đạt điểm số tiệm cận một số model đắt tiền hơn nhiều với mức ngân sách thấp hơn đáng kể.
Nếu agent máy tính phải liên tục chạy tác vụ ở chế độ nền, chi phí sẽ trở thành yếu tố mang tính quyết định thực tế. Thỉnh thoảng chạy một lần và việc ngày nào cũng chạy hàng chục lần có mức độ nhạy cảm về giá model hoàn toàn khác nhau.
Bảo mật và thị giác: Cũng có kết quả cụ thể
Ở CyberGym, hình ảnh gốc của hãng đưa ra 82.2 , phần văn bản được làm tròn thành 82%.
Trong cùng bảng, GLM-5.3 đạt 84.5, GPT-5.6 Sol là 83.6, Kimi K3 là 80.0. M3.1 Flash đã nằm trong nhóm dẫn đầu, và điểm cao nhất vẫn là GLM-5.3 trong hình.
CyberGym chủ yếu kiểm tra việc tái hiện và xác minh các lỗ hổng đã biết. MiniMax cũng tiết lộ rằng đội ngũ bảo mật nội bộ đã đánh giá các kịch bản như audit mã nguồn, vá lỗ hổng, phân tích mã độc. Đối với công việc bảo mật, việc có thể hoàn thành chuỗi xác minh quan trọng hơn nhiều so với việc chỉ đưa ra một đoạn phân tích trông có vẻ chuyên nghiệp.
Hai hạng mục liên quan đến thị giác cũng rất đáng chú ý: BabyVision đạt 91.0 trong thiết lập có sử dụng công cụ, và CharXiv RQ đạt 82.5, bài test sau liên quan đến việc hiểu biểu đồ.
Khi đưa vào các thao tác máy tính, những năng lực này có thể kết nối liền mạch với nhau. Model trước tiên phải hiểu được trang web, hình ảnh và biểu đồ, sau đó mới xác định cần thao tác thế nào. Thị giác, gọi công cụ, thực thi liên tục—bất kỳ mắt xích nào gặp sự cố, tác vụ đều sẽ dừng lại.
Vì sao lần này lại nhanh hơn và rẻ hơn?
Lời giải thích từ MiniMax là tối ưu hóa hơn nữa hiệu quả suy luận, áp dụng kiến trúc sparse attention quyết liệt hơn.
Bạn có thể hiểu đại khái rằng khi xử lý nội dung dài, hệ thống sẽ tính toán có chọn lọc hơn để tập trung vào các phần liên quan, giảm bớt những phép tính không cần thiết. Hiệu quả cụ thể còn phụ thuộc vào model, tác vụ và thiết lập dịch vụ.
Thread kỹ thuật chính thức của dự án vLLM cũng bổ sung thông tin tầng dưới: đợt tối ưu này kết hợp sparse attention, tính toán độ chính xác thấp NVFP4, cùng với kernel suy luận dành riêng cho phần cứng Blackwell. Nói một cách dễ hiểu, nó vừa giảm các phép tính không cần thiết, vừa tiếp tục cắt giảm chi phí tiêu hao trong từng phép tính và quá trình luân chuyển dữ liệu. Các con số tăng tốc gấp nhiều lần được công bố là kết quả benchmark trên kernel cụ thể, không thể nhân trực tiếp lên để coi là mức tăng tốc của toàn bộ tác vụ.
Theo công bố chính thức, tốc độ output thông thường có thể đạt 200+ token/giây , trung vị P50 ổn định ở mức 170+ token/giây .
token là đơn vị xử lý của model, không tương ứng 1:1 với ký tự chữ Hán. Tốc độ ở đây đề cập đến quá trình sinh output, chứ không tính thời gian chờ công cụ chạy, tải trang web,... vào tốc độ nhả token của model.
Còn về mức tăng tốc gần gấp 3 lần và giảm 70% chi phí, tiêu chuẩn so sánh chính thức là dựa trên thế hệ tiền nhiệm, với mức 70% tương ứng với chi phí sử dụng tổng thể cho các tác vụ Agent.
Chỉ nhìn vào bảng giá API nội địa hiện tại đã thấy rất rõ ràng: mỗi 1 triệu token, input là 1 tệ, output là 4 tệ, đọc cache là 0,1 tệ.
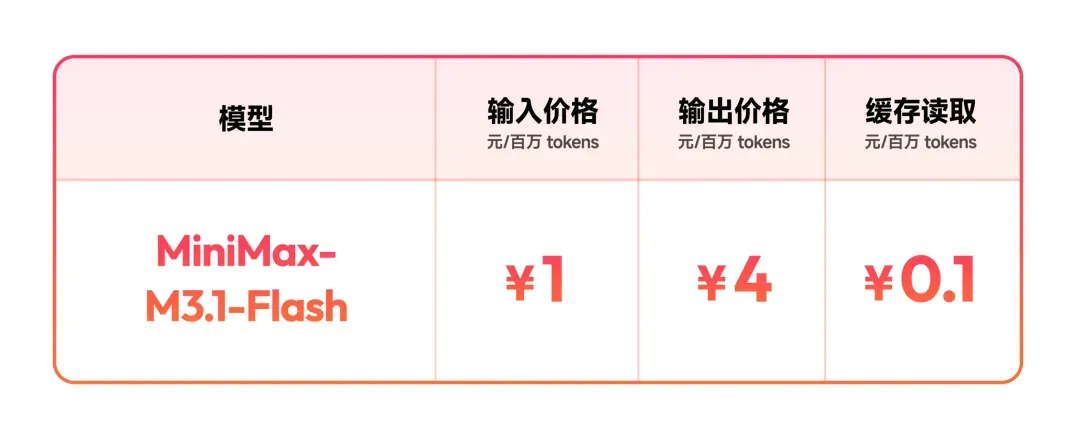
So sánh với gói tiêu chuẩn M3 trên cùng trang có input không vượt quá 512K, đơn giá input và output đều giảm khoảng 52%, đọc cache giảm khoảng 76%. Vì vậy, tổng chi phí giảm 70% khác hoàn toàn với việc mỗi đơn giá đều giảm 30% hay đều giảm 70%.
Đối với các nhà phát triển, điều đáng tính toán hơn là hóa đơn cho toàn bộ tác vụ. Agent thực hiện một công việc sẽ phải gọi qua rất nhiều lượt; chỉ cần model bớt đi vài bước, mỗi bước rẻ hơn một chút, output nhanh hơn một chút, thì mức chênh lệch cuối cùng mới thực sự rõ rệt.
Hiện đã có thể sử dụng, còn một mốc quan trọng vào ngày 23 tháng 10
Model chính thức là MiniMax-M3.1-Flash , hiện đã có thể sử dụng thông qua MiniMax Code, M Plan và API; phía phát triển cũng cung cấp tài liệu hướng dẫn tích hợp cho các công cụ như Claude Code, Codex.
Bài đăng chính thức cũng thông báo rõ: Trọng số model sẽ được phát hành vào ngày 23 tháng 10. Hiện tại mới là kế hoạch mở, trọng số vẫn chưa được phát hành.
Ngoài ra, trong MiniMax Code hiện có một chương trình ưu đãi có thời hạn: tính đến ngày 25 tháng 10, người dùng đăng ký thuê bao có thể sử dụng không giới hạn M3.1 Flash trong MiniMax Code.
Lời kết
Nhìn lại lần ra mắt này, tôi thấy điều thú vị nhất chính là trình tự.
Đầu tiên là một "chú thỏ ẩn danh" được gọi liên tục trong các công cụ của giới developer. Tiếp đó danh tính được công bố, rồi lần lượt các kết quả đánh giá, cấu hình suy luận và chi phí tác vụ được đưa ra đồng loạt.
Bảng xếp hạng lượt gọi chứng minh đã có người dùng, đánh giá tác vụ cho thấy năng lực đạt đến đâu, còn đường cong chi phí sẽ trả lời câu hỏi còn lại: năng lực này liệu có thể dùng hàng ngày được không.
Nhìn nhận đồng thời cả ba vấn đề này, M3.1 Flash mới thực sự đáng để bạn dành sự quan tâm nghiêm túc.
Model flagship tiếp tục nâng cao giới hạn trần, còn model Flash lại mang một phần năng lực đó vào việc sử dụng hàng ngày với mức giá rẻ hơn, tốc độ nhanh hơn. Đối với những ai đang thực sự làm dự án, lựa chọn sẽ ngày càng cụ thể: phần tác vụ nào xứng đáng dùng model mạnh nhất, và phần nào đã có thể giao cho một model chủ lực giá rẻ gánh vác.
Sau khi chú thỏ bí ẩn lộ diện, điều đáng để chờ đợi hơn cả chính là bảng thành tích tiếp theo của nó trong các dự án thực tế.
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác