Link bài viết gốc: https://x.com/dongxi_nlp/status/21127670...
Dongxi Đông Tích NLP · X · @dongxi_nlp · 2026-10-21 12:44
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
Đầu năm 2022, khi OpenAI giới thiệu InstructGPT, họ đã đưa ra một so sánh. Họ gửi cho GPT-3 một yêu cầu rất đơn giản:
"Dùng vài câu giải thích việc con người đặt chân lên mặt trăng cho một đứa trẻ 6 tuổi."
GPT-3 không hề giải thích về việc lên mặt trăng. Nó liền một mạch đưa ra thêm mấy đề bài:
"Giải thích về vạn vật hấp dẫn cho một đứa trẻ 6 tuổi. Giải thích về thuyết tương đối cho một đứa trẻ 6 tuổi. Giải thích về Big Bang cho một đứa trẻ 6 tuổi..."
Cùng một yêu cầu đó khi giao cho InstructGPT thì câu trả lời đã bình thường: con người đặt chân lên mặt trăng, chụp lại những gì nhìn thấy, rồi truyền ảnh về Trái Đất để mọi người cùng xem.
Những gì GPT-3 làm lại chính là điều mà quá trình huấn luyện đã dạy cho nó.
Pre-training (tiền huấn luyện) chỉ dạy model đúng một việc: nhìn một đoạn văn bản và đoán từ tiếp theo.
Dữ liệu huấn luyện là lượng văn bản khổng lồ, phần lớn đến từ các trang web. Trên web, sau một câu hỏi thường là một câu hỏi khác: tập bài tập, danh sách bài tập về nhà, "10 câu hỏi giúp bạn hiểu về..." đều như vậy cả. Thế nên, việc "đưa ra thêm vài đề bài" lại là một phỏng đoán cực kỳ hợp lý cho câu hỏi "câu tiếp theo sẽ là gì".
Model chỉ mới trải qua pre-training được gọi là base model (model nền tảng) . Sau pre-training, toàn bộ quá trình huấn luyện nhằm biến "bộ máy viết tiếp văn bản" này thành một trợ lý hữu ích được gọi chung là post-training (hậu huấn luyện) . InstructGPT chính là được post-training dựa trên nền tảng của GPT-3.
Bài viết này chia sẻ ba điều: vì sao cần post-training, điểm khác biệt giữa nó với pre-training, và ba kỹ thuật thường có trong post-training.
Chỉ có pre-training thì còn thiếu những gì?
Hãy tưởng tượng một người đã đọc hết toàn bộ sách trong một thư viện lớn, nhưng chưa từng đi làm bao giờ. Anh ta hiểu biết rất rộng, bạn chỉ mới nói nửa câu, anh ta gần như đã có thể tiếp lời. Nhưng khi bạn đến nhờ anh ta giúp đỡ, anh ta có thể chỉ bám theo chủ đề của bạn rồi cứ thế tự nói tiếp một mình.
Base model cũng có ba điểm yếu tương tự:
- Chưa biết làm theo chỉ thị. Yêu cầu nó giải thích về việc lên mặt trăng, nó có thể tiếp tục ra đề bài; yêu cầu nó dịch một câu, nó có thể dùng luôn ngôn ngữ gốc để viết tiếp.
- Có thể gây ra tác hại. Trong mục tiêu "đoán từ tiếp theo", không có bất kỳ yêu cầu nào buộc nó phải tránh các lời khuyên nguy hiểm, lời lẽ xúc phạm, hay những nhận định sai nhưng được nói với giọng điệu rất quả quyết, chẳng hạn như đưa ra câu trả lời sai cho một vấn đề y tế.
- Không giỏi suy luận theo chuỗi dài. Biết mặt chữ của một bài toán trông như thế nào vẫn còn cách rất xa việc từng bước giải đúng bài toán đó.
Ba điểm yếu này đều bắt nguồn từ một lý do:
Mục tiêu của pre-training là đoán chuẩn các từ trong văn bản web; trong khi thứ con người thực sự cần lại là một model hữu ích và không gây hại. Hai mục tiêu này không khớp với nhau.
Điều mà post-training muốn bù đắp chính là khoảng cách này.
Pre-training và post-training khác nhau ở đâu?
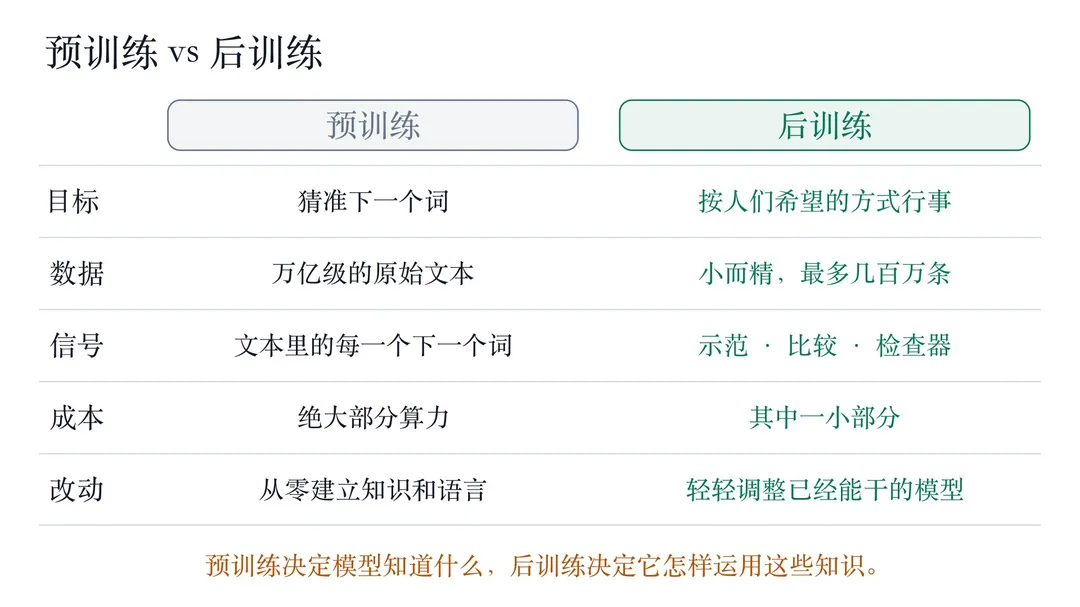
Post-training không tạo ra một model mới tinh, mà tiếp tục huấn luyện trên chính model đó. Thứ thay đổi là dữ liệu, cùng với tín hiệu cho model biết "như thế nào mới được coi là tốt hơn".
Mục tiêu. Pre-training: đoán chuẩn từ tiếp theo trong văn bản. Post-training: hành động theo cách con người mong đợi, hiểu chỉ thị, đảm bảo an toàn và trả lời đúng câu hỏi.
dữ liệu. Pre-training sử dụng văn bản thô với số lượng tính bằng hàng nghìn tỷ. Post-training sử dụng dữ liệu quy mô nhỏ, được chuẩn bị kỹ lưỡng: yêu cầu đi kèm câu trả lời chuẩn, so sánh giữa hai câu trả lời, hoặc những bài toán có đáp án chuẩn để kiểm tra. Một dataset chỉ thị quy mô lớn cũng chỉ có tối đa vài triệu mẫu.
Tín hiệu. Trong pre-training, mỗi từ tiếp theo trong văn bản đều là mục tiêu học tập. Còn trong post-training, tín hiệu đến từ một câu trả lời mẫu, một lượt đánh giá "cái nào tốt hơn", hoặc kết quả đúng sai do verifier đưa ra.
Chi phí. Phần lớn sức mạnh tính toán được dồn vào pre-training; post-training chỉ chiếm một phần nhỏ trong số đó.
Mức độ điều chỉnh. Pre-training xây dựng kiến thức và năng lực ngôn ngữ từ con số 0; post-training chủ yếu là nhẹ nhàng điều chỉnh định hướng trên một model vốn đã rất tài năng.
Nói một cách đại khái: pre-training quyết định model biết những gì, còn post-training quyết định cách nó vận dụng những tri thức đó.
Dữ liệu ít nhưng sự thay đổi có thể rất lớn. Một nghiên cứu cho thấy, khi chỉ trộn thêm 500 ví dụ về an toàn vào tập dữ liệu chỉ thị lớn, tần suất model đưa ra câu trả lời độc hại đã giảm đi rõ rệt.
Ba kỹ thuật, ba người thầy
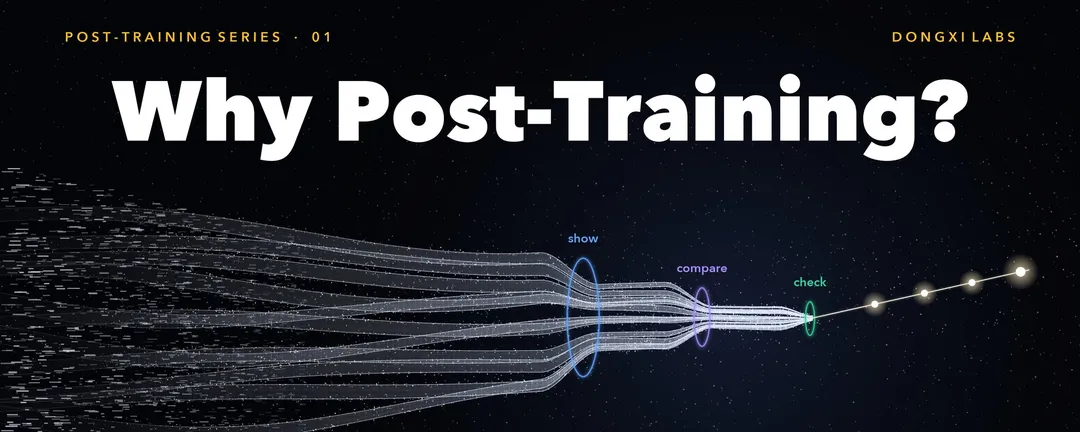
Post-training thường được chia thành ba kỹ thuật: instruction tuning (fine-tune theo chỉ thị) , preference alignment (căn chỉnh theo sở thích) , và RLVR (Reinforcement Learning with Verifiable Rewards - học tăng cường với phần thưởng có thể xác minh) . Cách dễ phân biệt nhất là xem chúng học từ những người thầy như thế nào:
Một người làm mẫu, một người so sánh, một người kiểm tra.
1. Instruction tuning: Học theo người làm mẫu
Nhân viên mới khi nhận việc thường bắt đầu bằng việc xem ví dụ mẫu: đây là một yêu cầu, và đây là một câu trả lời tốt.
Instruction tuning cũng tương tự như vậy. Dữ liệu gồm từng chỉ thị đi kèm một câu trả lời mẫu chất lượng, ví dụ như "Hãy dịch câu tiếng Tây Ban Nha này sang tiếng Anh", kèm theo bản dịch tiếng Anh ở phía sau.
Quy tắc huấn luyện gần như không đổi, model vẫn tiếp tục đoán từ tiếp theo. Sự thay đổi nằm ở chỗ những từ nào được tính điểm:
Chỉ thị chỉ được dùng làm context, model chỉ nhận điểm đánh giá dựa trên các từ trong phần câu trả lời.
Nó còn được gọi là supervised fine-tuning (SFT, fine-tune có giám sát) , bởi vì mỗi chỉ thị đều đi kèm một câu trả lời chính xác để model bắt chước. Sau khi được huấn luyện trên nhiều loại tác vụ khác nhau, khả năng tuân theo chỉ thị của model sẽ được nâng cao toàn diện, thậm chí xử lý tốt hơn cả những tác vụ chưa từng gặp.
2. Preference alignment: Học thông qua so sánh
Sau instruction tuning, câu trả lời vẫn có thể mắc lỗi, thiếu an toàn hoặc chưa thực sự hữu ích.
Viết ra một câu trả lời hoàn hảo là rất khó; nhưng đánh giá xem câu trả lời nào tốt hơn trong hai câu thì dễ hơn nhiều. Nhà phê bình ẩm thực chưa chắc đã biết nấu ăn, nhưng vẫn có thể chỉ ra món nào ngon hơn.
Preference alignment tận dụng chính kiểu đánh giá này. Dữ liệu gồm một câu hỏi, hai câu trả lời, cùng một nhãn chú thích: con người thích câu trả lời nào hơn.
Có hai hướng tiếp cận phổ biến. Một hướng là trước tiên huấn luyện riêng một reward model (model phần thưởng) , đóng vai trò như trọng tài chấm điểm cho câu trả lời bất kỳ, sau đó để model luyện tập lặp đi lặp lại nhằm giành được điểm số cao hơn. Hướng tiếp cận này thường được gọi là RLHF (Reinforcement Learning from Human Feedback - học tăng cường từ phản hồi của con người) , PPO (Proximal Policy Optimization) là thuật toán nổi tiếng trong số đó. Hướng còn lại là DPO (Direct Preference Optimization - tối ưu hóa sở thích trực tiếp) , học trực tiếp từ các cặp so sánh mà không cần trọng tài riêng biệt.
Cả hai hướng tiếp cận đều buộc cho model một sợi "dây dắt" nối liền với model gốc trước khi huấn luyện, về mặt kỹ thuật được gọi là KL penalty (phạt KL) .
Nếu không có sợi dây dắt này, model có thể chỉ mải mê săn điểm mà đi chệch ngày càng xa điểm xuất phát, đánh mất đi nhiều thứ đã học được từ giai đoạn pre-training.
3. RLVR: Để verifier phân định đúng sai
Đáp án của một số tác vụ có thể được kiểm tra bằng chương trình. Bài toán có giá trị số cuối cùng, bài lập trình có test case chạy thành công hay thất bại.
RLVR coi những verifier (bộ kiểm tra) như vậy là người thầy. Model sẽ thử vài cách giải cho cùng một bài toán, verifier chấm từng cách đúng hay sai, sau đó model sẽ nâng cao xác suất sinh ra những cách giải đúng.
Ở đây không cần đến trọng tài con người. Câu trả lời dù có viết hoa mỹ hay dài dòng đến đâu cũng không thể qua mắt được verifier.
Vì vậy, RLVR rất phù hợp cho những bài toán suy luận chuỗi dài mà base model vốn không giỏi. Tuy nhiên cần lưu ý: mức độ đáng tin cậy của verifier phụ thuộc vào các quy tắc của nó. Nếu nó chỉ nhìn vào đáp án cuối cùng, nó sẽ không thể chứng minh từng bước trung gian đều chính xác.
Tóm tắt
- Pre-training dạy model cách viết tiếp văn bản; biết viết tiếp vẫn còn một khoảng cách để trở thành trợ lý hữu ích.
- Post-training tiếp tục huấn luyện trên chính model đó, sử dụng tập dữ liệu nhỏ hơn nhiều và được chuẩn bị kỹ lưỡng để điều chỉnh hành vi của nó.
- Ba kỹ thuật học từ ba người thầy: instruction tuning học theo mẫu, preference alignment dựa vào so sánh, RLVR nghe theo phán quyết của verifier.
Đây là bài viết đầu tiên trong chuỗi bài về post-training. Các phần tiếp theo sẽ đi sâu vào từng kỹ thuật: model thực chất được huấn luyện bằng dữ liệu gì, loss function hoạt động ra sao và những vấn đề tiềm ẩn có thể phát sinh ở đâu.
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác