Link bài viết gốc: System Design 01 - Trước khi bạn vẽ một chiếc hộp nào trong System Design
Anshu · X · @101xanshu · 2026-10-24 21:32
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
Hãy tưởng tượng bạn đang trong một buổi phỏng vấn thiết kế hệ thống, một kỹ sư cấp cao yêu cầu bạn thiết kế một hệ thống thông báo có thể gửi hàng triệu thông báo.
Bạn mở Excalidraw và bắt đầu vẽ: một máy chủ API, Kafka, Redis, một loạt worker và một cơ sở dữ liệu. Bạn từng thấy kiến trúc tương tự trước đây, nên đại khái biết mỗi thành phần nên đặt ở đâu.
Rồi kỹ sư cấp cao hỏi:
“Tại sao bạn lại chọn các thành phần này?”
Bạn khựng lại.
Bởi vì câu trả lời có thể sẽ thay đổi cách bạn thiết kế toàn bộ hệ thống.
Và đó chỉ là một trong những câu hỏi mà bạn vẫn chưa kịp đặt ra.
Phần khó nhất của thiết kế hệ thống không phải là vẽ kiến trúc, mà là làm rõ vấn đề thực sự cần loại kiến trúc nào.
Vì vậy, trước khi vẽ chiếc hộp tiếp theo, chúng ta hãy bắt đầu từ những câu hỏi đáng lẽ phải được đặt ra đầu tiên.
One notification system, several different problems (Một hệ thống thông báo, vài bài toán khác nhau)
Hãy bắt đầu từ những điều quen thuộc.
Hãy tưởng tượng bạn đang xây dựng một ứng dụng mạng xã hội. Có người thích một bài viết, một người dùng khác gửi tin nhắn, và một người nữa đăng nhập từ thiết bị mới.
Ứng dụng muốn thông báo cho những người dùng liên quan về các sự kiện này.
Ban đầu, điều này nghe như một tính năng rất trực diện: nhận sự kiện, tìm người nhận, gửi thông báo.
Nhưng hãy nghĩ xem điều gì sẽ xảy ra nếu chúng ta xử lý cả ba sự kiện này theo cùng một cách.
Thông báo tin nhắn có thể cần đến trong vòng vài giây. Thông báo lượt thích có lẽ có thể chấp nhận độ trễ ngắn. Cảnh báo bảo mật về đăng nhập lạ có thể cần được gửi tới càng sớm càng tốt.
Còn email tóm tắt hàng tuần thì sao? Việc đó có thể xử lý hàng loạt khi hệ thống còn dư tải.
Chúng ta có một tính năng sản phẩm, nhưng lại có nhiều kỳ vọng khác nhau.
Đây chính là nơi thiết kế bắt đầu.
Không phải bắt đầu từ việc chọn cơ sở dữ liệu, không phải bắt đầu từ Kafka, cũng không phải từ việc sao chép sơ đồ kiến trúc của một hệ thống khác.
Mà là bắt đầu từ hành vi mà hệ thống dự kiến sẽ mang lại.
Giả sử chúng ta hỏi đội ngũ sản phẩm về các use case này và thiết lập các yêu cầu ban đầu như sau:
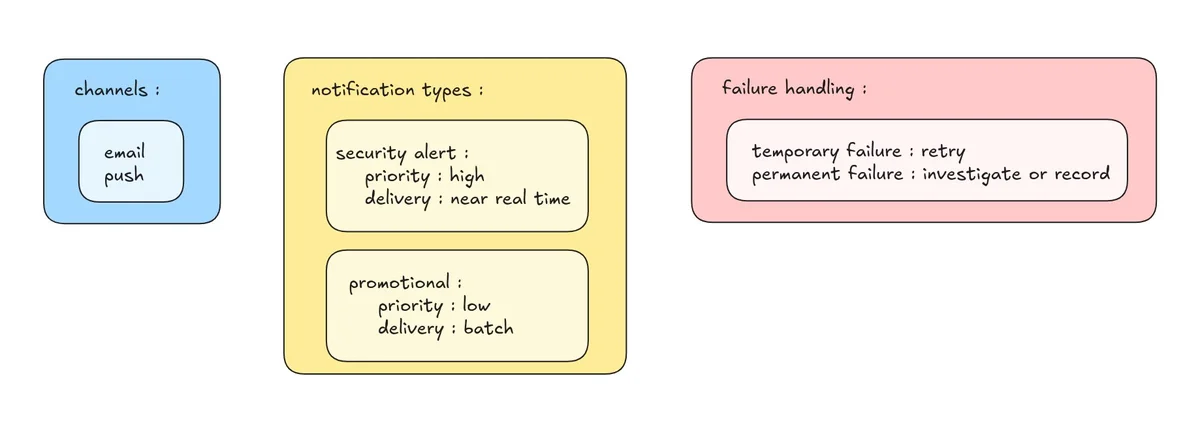
Đây là những giả định mang tính ví dụ, không phải yêu cầu chung cho mọi trường hợp. Hệ thống thực tế có thể có các mục tiêu độ trễ, kênh hoặc mức độ ưu tiên khác nhau.
Nhưng việc viết chúng ra mang lại cho chúng ta một điều hữu ích: một bản mô tả vấn đề mà chúng ta có thể phản biện và tinh chỉnh.
Ví dụ, “gần thời gian thực” rốt cuộc có nghĩa là gì? Hai giây? Năm giây? Và mục tiêu đó ám chỉ việc tiếp nhận thông báo, bắt đầu gửi đi, hay là người nhận thực tế đã nhận được?
Những điểm khác biệt này sau đó đều sẽ trở nên quan trọng.
Bây giờ, chúng ta biết hệ thống phải hỗ trợ các loại thông báo khác nhau, nhiều kênh và các kỳ vọng độ trễ khác nhau.
Điều này đã hữu ích hơn nhiều so với việc chỉ nói đơn thuần là “hàng triệu thông báo”.
What does "millions" actually tell us? (“Hàng triệu” thực sự cho chúng ta biết điều gì?)
Giả sử yêu cầu là 10 triệu thông báo mỗi ngày.
Liệu con số này có đủ để quyết định chúng ta cần bao nhiêu máy chủ?
Vẫn chưa đủ. Nhưng chúng ta có thể bắt đầu với một ước tính sơ bộ.
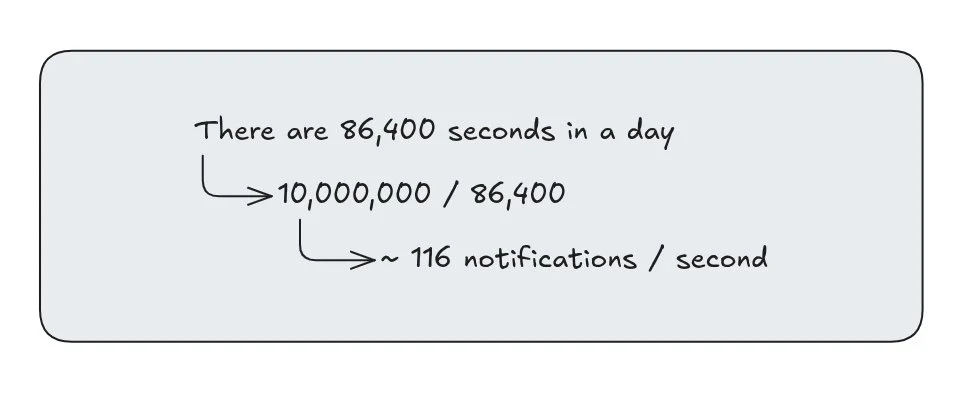
Tốc độ đến trung bình của chúng ta là khoảng 116 thông báo mỗi giây.
Phép tính này hữu ích, nhưng nó không cho chúng ta biết lưu lượng được phân bổ như thế nào.
Giả sử phần lớn thông báo đến trong một khung thời gian hai giờ. Hoặc một sự kiện theo kế hoạch đột ngột tạo ra lượng công việc khổng lồ. Hoặc nhà cung cấp dịch vụ bên ngoài bị sập, sau khi phục hồi thì hệ thống cần xử lý các tác vụ bị tồn đọng.
Trong mỗi trường hợp, tải mà hệ thống có thể cần xử lý tại một thời điểm nhất định sẽ vượt xa mức trung bình hàng ngày.
Hãy ghi lại những gì chúng ta đã biết và chưa biết:
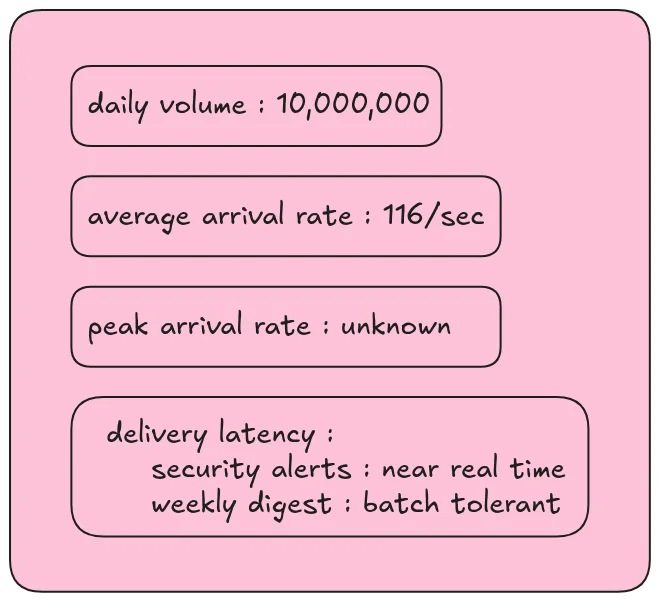
Lưu ý rằng chúng ta không bịa ra một con số đỉnh chỉ để làm cho thiết kế có vẻ hoàn chỉnh.
Chúng ta có một giá trị ước tính, một giả định về hành vi phân phát, và một câu hỏi chưa có lời đáp về lưu lượng đỉnh.
Nếu có thêm thông tin, chúng ta có thể yêu cầu cung cấp. Nếu không, chúng ta có thể đưa ra một giả định, tiếp tục thiết kế và xem xét lại giả định đó nếu nó trở nên quan trọng.
Đây là một thói quen quan trọng: phân biệt giữa sự thật và giả định, thay vì âm thầm coi cả hai đều là yêu cầu.
Bây giờ, hãy xem điều gì sẽ xảy ra khi thử xây dựng hệ thống đơn giản nhất.
Version 1: Just send the notification (Phiên bản 1: Cứ gửi thông báo đi)
Thiết kế đầu tiên của chúng ta có thể rất đơn giản.
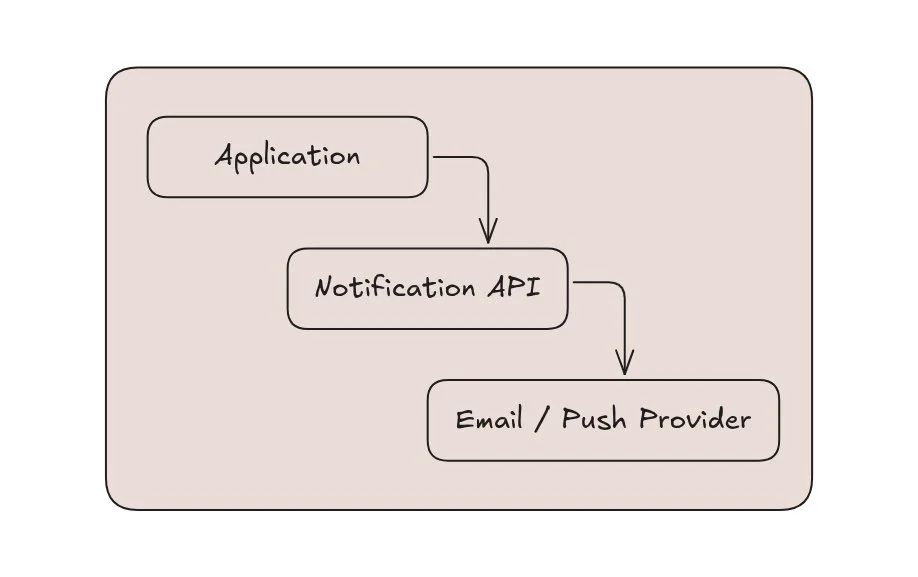
Ứng dụng gọi API thông báo của chúng ta. API xác thực yêu cầu và gọi đến nhà cung cấp bên ngoài thích hợp.
Nhà cung cấp bên ngoài chỉ là một dịch vụ khác thực hiện việc phân phát thực tế. Đối với email, đó có thể là dịch vụ gửi email; đối với thông báo đẩy, đó có thể là dịch vụ thông báo đẩy của nền tảng.
Ứng dụng của chúng ta không cần phải tự mình triển khai toàn bộ hạ tầng phân phát.
Đối với ứng dụng nhỏ có lưu lượng vừa phải, thiết kế này có thể hoàn toàn hợp lý.
Nhưng hãy đưa vào một ràng buộc.
Giả sử nhà cung cấp dịch vụ email mất vài giây mới phản hồi. API thông báo của chúng ta đang chờ phản hồi đó, đồng nghĩa với việc ứng dụng gọi API của chúng ta có thể cũng phải chờ đợi.
Bây giờ hãy tưởng tượng tình huống nhà cung cấp tạm thời không khả dụng.
Các yêu cầu có thể bị dồn ứ, kết nối tiếp tục bị chiếm dụng, và sự cố từ các thành phần phụ thuộc bên ngoài có thể ảnh hưởng trực tiếp đến chính ứng dụng.
Vấn đề không nằm ở chỗ gửi trực tiếp luôn sai. Mà là việc gửi trực tiếp làm gắn kết yêu cầu của ứng dụng với thời gian phản hồi và tính sẵn sàng của nhà cung cấp.
Chúng ta có thể tách biệt hai việc này ra không?
Version 2: Accept the work now, deliver it later (Phiên bản 2: Tiếp nhận công việc trước, phân phát sau)
Hãy tưởng tượng bạn đến một nhà hàng vào một buổi tối bận rộn.
Nhân viên tiếp nhận đơn hàng của bạn, ghi chép lại và chuyển vào bếp. Bạn không cần phải đứng trong bếp chờ món ăn sẵn sàng thì nhà hàng mới xác nhận đơn của bạn.
Đơn hàng đã được tiếp nhận. Quá trình chuẩn bị được thực hiện riêng biệt.
Hệ thống thông báo có thể sử dụng ý tưởng tương tự.
Thay vì gửi thông báo trực tiếp từ API, chúng ta có thể đưa công việc vào hàng đợi.
Hàng đợi là một cấu trúc lưu giữ công việc cho đến khi consumer sẵn sàng xử lý. Một worker process có thể lấy thông báo trong hàng đợi ra và thử phân phát độc lập với yêu cầu API ban đầu.
Hàng đợi bền bỉ tiến thêm một bước: nó giữ lại các tin nhắn đã tiếp nhận trong bộ lưu trữ bền vững, để việc khởi động lại tiến trình hay sự cố máy móc không xóa sạch các công việc đang chờ xử lý. Mức độ đảm bảo cụ thể tùy thuộc vào công nghệ hàng đợi và cấu hình của nó.
Kiến trúc của chúng ta bây giờ trông như thế này:
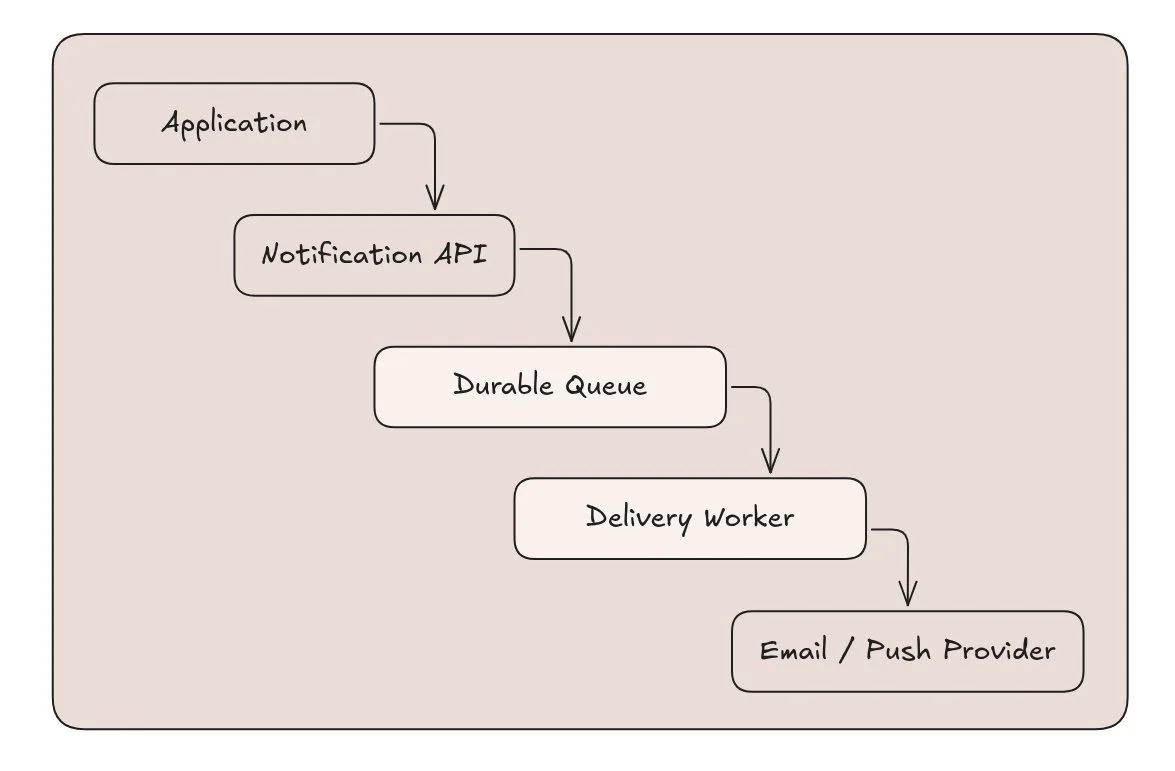
API thông báo xác thực yêu cầu và đưa tin nhắn vào hàng đợi. Một worker process phân phát sẽ đọc tin nhắn và liên hệ với nhà cung cấp.
API không còn cần phải chờ nhà cung cấp hoàn tất việc gửi thông báo nữa.
Chúng ta đã tách biệt hai thao tác:
- Tiếp nhận trách nhiệm xử lý thông báo.
- Cố gắng phân phát thông báo tới người nhận.
Đây chính là xử lý bất đồng bộ. Hệ thống giờ đây tiếp nhận công việc rồi hoàn thành riêng biệt, thay vì bắt bên gọi phải chờ toàn bộ thao tác kết thúc.
Nhưng điều này dẫn đến một câu hỏi quan trọng: Khi API trả về thành công, nó thực sự cam kết điều gì?
Nếu API trả về thành công sau khi thông báo đã được tiếp nhận và lưu trữ bền bỉ, nó có thể báo cho bên gọi rằng hệ thống đã nhận công việc đó.
Nó không thể khẳng định một cách chắc chắn rằng người nhận đã thực sự nhận được thông báo.
Đây là những mức độ đảm bảo khác nhau.
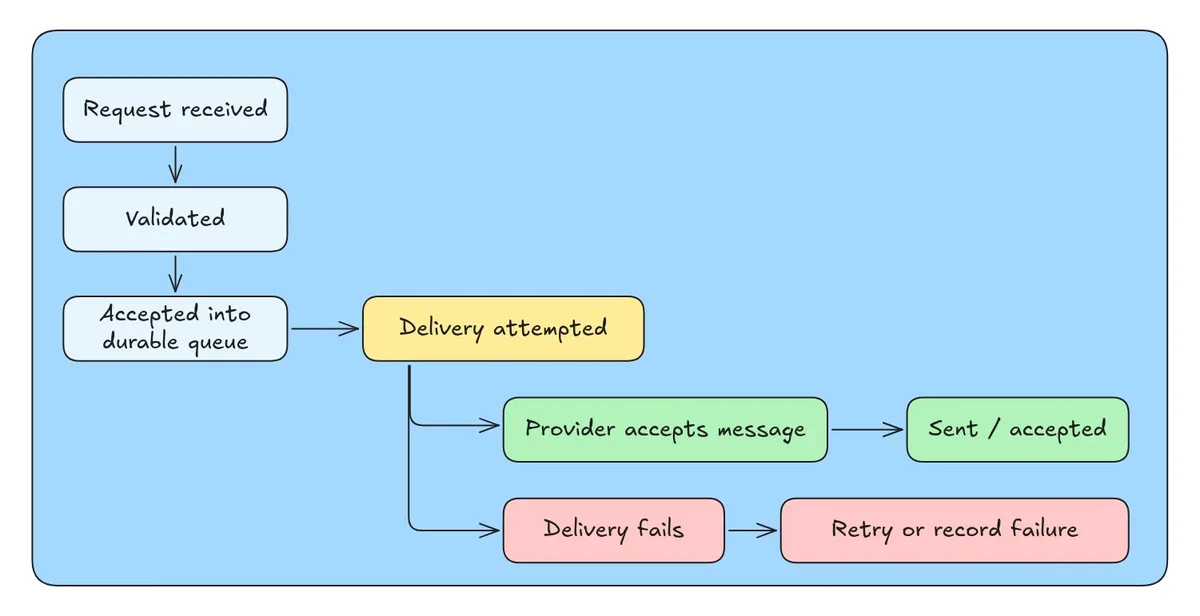
Ngay cả một quy trình đơn giản hóa như thế này cũng buộc chúng ta phải định nghĩa ý nghĩa của từng trạng thái.
Ví dụ: việc nhà cung cấp tiếp nhận một email không nhất thiết có nghĩa là email đó đã tới hộp thư đến của người nhận. Nếu sản phẩm cần phân biệt điều này, mô hình trạng thái của chúng ta bắt buộc phải thể hiện được nó.
Hãy chú ý cách chúng ta đi đến quyết định dùng hàng đợi. Chúng ta thêm nó không phải vì một hệ thống quy mô lớn thì bắt buộc phải có. Chúng ta thêm nó vì muốn tách biệt việc xử lý yêu cầu API khỏi các nhà cung cấp phân phát chậm chạp hoặc không khả dụng.
Đây là một quyết định thiết kế mà chúng ta có thể giải thích được.
Version 3: A queue doesn't magically solve every problem (Phiên bản 3: Hàng đợi không thể giải quyết mọi vấn đề một cách kỳ diệu)
Hàng đợi giúp bảo vệ API khỏi việc phải chờ đợi nhà cung cấp. Khi tốc độ phân phát bị chậm lại, nó cũng có thể giữ lại các công việc đang chờ xử lý.
Tuy nhiên, điều gì sẽ xảy ra khi tốc độ hệ thống tiếp nhận thông báo vượt quá tốc độ xử lý của các worker process?
Hàng đợi sẽ dài ra.
Hàng đợi giúp hấp thụ lưu lượng đột biến, nhưng nó không tạo ra năng lực xử lý vô hạn. Nếu lượng công việc nạp vào liên tục vượt quá năng lực xử lý, lượng tồn đọng sẽ không ngừng tăng lên.
Chúng ta cần hiểu hai khía cạnh của hệ thống.
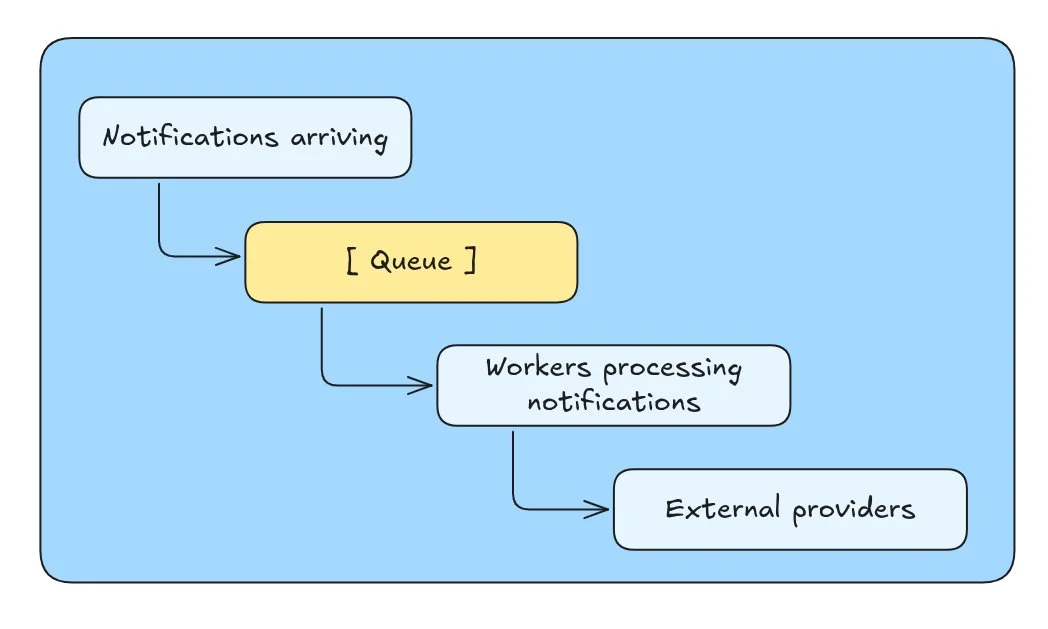
Nếu tốc độ đến tạm thời vượt quá tốc độ xử lý, hàng đợi có thể hấp thụ phần chênh lệch.
Nếu tốc độ đến duy trì ở mức cao trong thời gian dài, hệ thống cuối cùng sẽ cần nhiều dung lượng hơn, giảm bớt lượng công việc nạp vào, hoặc áp dụng một chiến lược xử lý khác.
Chúng ta nên giám sát kích thước và thời gian tồn tại của hàng đợi, chứ không chỉ kiểm tra xem API có trả về phản hồi thành công hay không.
Tại sao lại cần quan tâm đến thời gian chờ của tin nhắn trong hàng đợi?
Bởi vì một hàng đợi chứa một triệu tin nhắn, nếu được phép chờ hàng giờ đồng hồ, thì chưa chắc đã bất thường. Nhưng với một hàng đợi nhỏ hơn, nếu cảnh báo bảo mật phải chờ trong đó tới ba mươi giây thì có thể là một vấn đề nghiêm trọng.
Các chỉ số quan trọng phụ thuộc vào yêu cầu bài toán.
Đối với hệ thống của chúng ta, các chỉ số hữu ích có thể bao gồm:
- Có bao nhiêu thông báo đang chờ xử lý.
- Thông báo cũ nhất đã phải chờ bao lâu.
- Các lần thử gửi mất bao lâu.
- Bao nhiêu lần gửi thất bại.
- Các thông báo có độ ưu tiên cao có đạt được mục tiêu về độ trễ hay không.
Đây chính là lúc các yêu cầu được chuyển hóa thành các chỉ số vận hành.
Chỉ nói "cảnh báo bảo mật cần đến càng sớm càng tốt" là chưa đủ. Chúng ta cần một mục tiêu có thể đo lường được để xác định xem hệ thống có đáp ứng được kỳ vọng đó hay không.
Version 4: What if an important notification is stuck behind millions of emails? (Phiên bản 4: Sẽ ra sao nếu thông báo quan trọng bị nghẽn sau hàng triệu email?)
Hãy quay lại với các loại thông báo mà chúng ta đã xác định trước đó.
Hãy hình dung một chiến dịch marketing lên lịch gửi mười triệu email. Cùng lúc đó, một người dùng kích hoạt cảnh báo bảo mật.
Nếu cả hai tác vụ này dùng chung một hàng đợi và năng lực xử lý, cảnh báo bảo mật có thể sẽ phải xếp sau lượng lưu lượng khổng lồ gửi hàng loạt.
Hàng đợi vẫn đang hoạt động đúng như thiết kế. Vấn đề là ở chỗ, thiết kế này chưa chắc đã bảo vệ được các khối lượng công việc (workload) có độ ưu tiên cao của chúng ta.
Bây giờ chúng ta có một vài lựa chọn.
Chúng ta có thể để các worker ưu tiên xử lý tin nhắn ngay trong hàng đợi dùng chung. Chúng ta cũng có thể tạo các hàng đợi riêng biệt cho từng loại tác vụ. Hoặc chúng ta có thể dành riêng một phần năng lực của worker cho các thông báo ưu tiên cao.
Mỗi lựa chọn đều có sự đánh đổi.
Hàng đợi dùng chung có thể đơn giản hơn trong khâu vận hành, nhưng việc điều phối độ ưu tiên lại phụ thuộc vào khả năng của hàng đợi và thiết kế của consumer.
Các hàng đợi riêng biệt mang lại khả năng cô lập tốt hơn, nhưng lại đòi hỏi cấu hình và sự chú ý vận hành nhiều hơn. Chúng cũng không tự động đảm bảo việc gửi đi nhanh chóng: nếu worker xử lý ưu tiên cao bị quá tải hoặc nhà cung cấp phản hồi chậm, độ trễ vẫn có thể tăng lên.
Giả sử chúng ta quyết định rằng sự cô lập này xứng đáng với độ phức tạp tăng thêm.
Thiết kế của chúng ta có thể tiến hóa thành như sau:
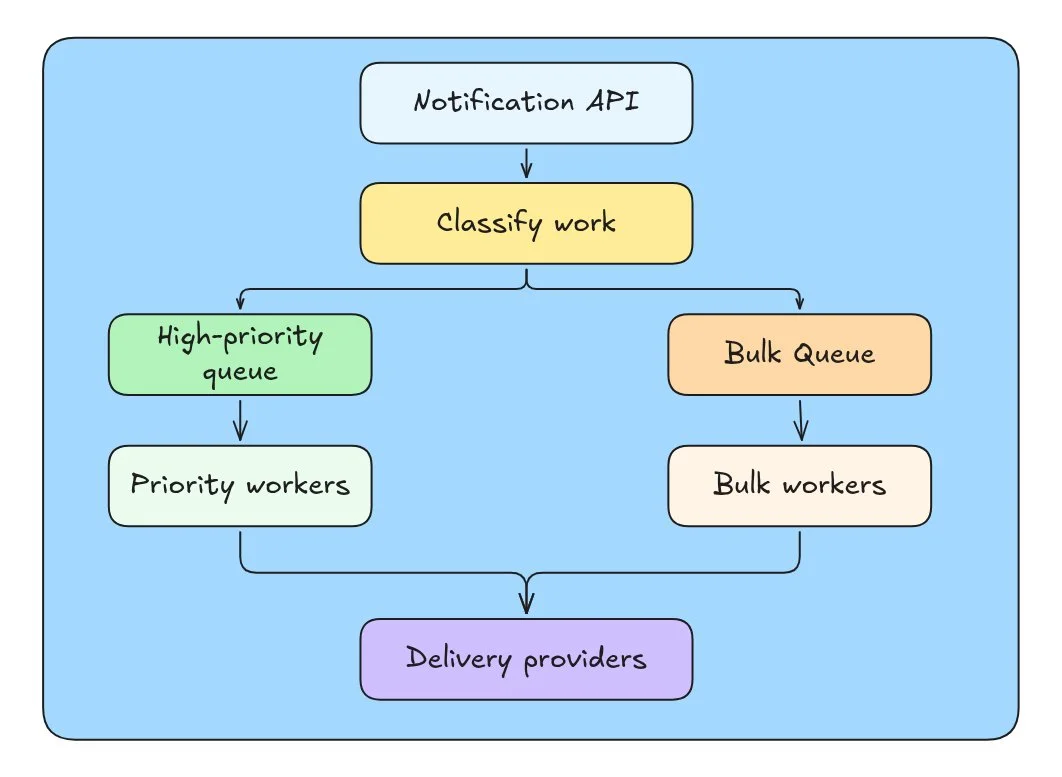
Đây là một thiết kế khả thi, chứ không phải quy tắc bắt buộc rằng mọi hệ thống thông báo đều cần hai hàng đợi.
Quyết định này phụ thuộc vào yêu cầu độ trễ, khối lượng công việc, công nghệ hàng đợi cũng như chi phí vận hành các luồng xử lý riêng biệt.
Quan trọng hơn, chúng ta thấy thiết kế thay đổi đều có lý do: các yêu cầu ban đầu cho thấy không phải mọi thông báo đều có thể chờ đợi trong cùng một khoảng thời gian.
Đó chính là cách mà một kiến trúc nên được tiến hóa.
Now let's talk about failure (Giờ hãy nói về các trường hợp thất bại)
Giả sử một worker gửi một thông báo tới nhà cung cấp bên ngoài.
Nhà cung cấp đã nhận được yêu cầu, nhưng phản hồi không bao giờ quay về được worker. Worker bị quá thời gian chờ (timeout).
Liệu nhà cung cấp đã gửi thông báo đó đi chưa?
Chúng ta không biết.
Worker phải đối mặt với một kết quả mơ hồ: yêu cầu có thể đã thất bại trước khi được gửi tới, hoặc nhà cung cấp đã tiếp nhận yêu cầu nhưng phản hồi bị thất lạc.
Nếu worker thử lại, người nhận có thể nhận được hai thông báo giống hệt nhau. Nếu worker không thử lại, thông báo vốn chưa từng được tiếp nhận có thể sẽ không bao giờ được gửi đi.
Đó là lý do tại sao việc "thử lại khi thất bại" không thể cấu thành một chiến lược về độ tin cậy hoàn chỉnh.
Ở góc độ tổng thể, chúng ta cần cân nhắc:
- Những lỗi nào mang tính tạm thời và đáng để thử lại.
- Được phép thử lại bao nhiêu lần.
- Cần chờ bao lâu giữa các lần thử lại.
- Điều gì sẽ xảy ra khi mọi nỗ lực thử lại đều thất bại.
- Chúng ta theo dõi các lần thử gửi và kết quả như thế nào.
- Nhà cung cấp có hỗ trợ cơ chế idempotent để giảm thiểu ảnh hưởng của việc trùng lặp hay không.
Chiến lược thử lại xác định thời điểm và cách thức thử lại các tác vụ thất bại. Một số hệ thống còn chuyển các tin nhắn thất bại nhiều lần vào hàng đợi thư chết (dead-letter queue - DLQ), một nơi riêng biệt dùng để lưu giữ các tin nhắn cần điều tra thêm hoặc xử lý đặc biệt.
Trong bài thực hành thiết kế sơ bộ này, chúng ta không cần phải hiện thực hóa tất cả những điều đó. Điểm cốt lõi là phải nhận thức được rằng việc khôi phục từ các sự cố tạm thời sẽ kéo theo những trách nhiệm xử lý mới.
Ngay cả một hàng đợi bền vững (persistent queue) cũng không thể giải quyết mọi vấn đề. Nó có thể giữ lại các tác vụ đang chờ xử lý, nhưng không thể đảm bảo nhà cung cấp bên ngoài sẽ gửi thông báo chính xác một lần.
Chúng ta sẽ đi sâu vào cơ chế retry, tính idempotent và chuyển đổi trạng thái đáng tin cậy trong các phần tiếp theo của loạt bài này.
Bây giờ, hãy ghi lại các quyết định thiết kế mà chúng ta đã đưa ra cùng với lý do đằng sau chúng.
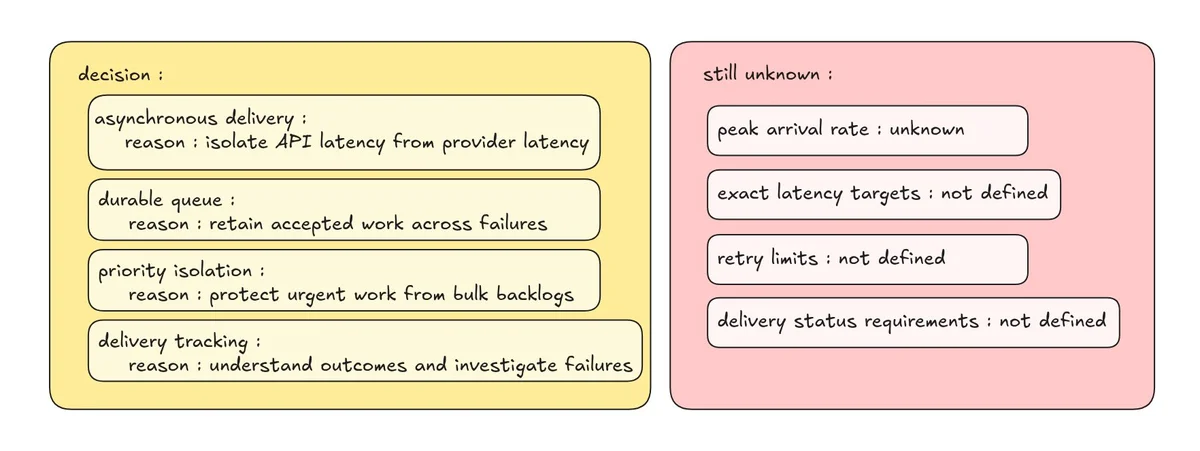
Điều này hữu ích hơn nhiều so với một danh sách các công nghệ đơn thuần.
Nó cho chúng ta biết mình đã chọn gì, tại sao lại chọn, và những thông tin nào vẫn có thể làm thay đổi thiết kế.
So, do we need Kafka and Redis? (Vậy chúng ta có cần Kafka và Redis không?)
Thực ra chúng ta vẫn chưa xác định điều này.
Chúng ta đã xác định rằng mình cần một cách để tiếp nhận các yêu cầu thông báo, xử lý chúng bất đồng bộ, và lưu giữ các tác vụ đang chờ xử lý theo yêu cầu về độ tin cậy của chúng ta.
Hàng đợi bền vững (persistent queue) là một thành phần tiềm năng để cung cấp các khả năng này.
Kafka là một nền tảng phân tán stream sự kiện, có thể lưu trữ các bản ghi và cho phép consumer xử lý chúng một cách độc lập. Khi chúng ta cần thông lượng cao, khả năng replay hoặc có nhiều consumer độc lập, nó có thể là một lựa chọn phù hợp, nhưng nó cũng mang lại những cân nhắc về mặt vận hành và thiết kế.
Một dịch vụ hàng đợi được quản lý (managed queue service) có thể đáp ứng nhu cầu của chúng ta với ít công sức vận hành hơn.
Redis có thể được dùng cho cache, rate limit và một số dạng tác vụ kiểu hàng đợi nhất định, tùy thuộc vào cấu trúc dữ liệu và đảm bảo về tính bền vững (persistence) được áp dụng. Nhưng chúng ta không nên mặc định rằng hàng đợi dựa trên Redis sẽ cung cấp cùng mức độ đảm bảo về tính bền vững và khả năng phân phối như các hệ thống hàng đợi hoặc event streaming chuyên dụng.
Trước khi đưa ra lựa chọn, chúng ta sẽ so sánh các mức độ đảm bảo thực tế, khối lượng công việc, độ phức tạp khi vận hành và chi phí.
Điều này cũng áp dụng tương tự cho cơ sở dữ liệu. Chúng ta có thể cần lưu trữ trạng thái thông báo, tùy chọn của người dùng và các lần thử gửi. Nhưng một mô hình dữ liệu phù hợp sẽ phụ thuộc vào việc chúng ta cần hỗ trợ những câu truy vấn nào, lưu giữ bao nhiêu dữ liệu và sản phẩm đòi hỏi những mức đảm bảo tính nhất quán nào.
Việc lựa chọn công nghệ cần phải bám sát theo các quyết định này.
Nếu chúng ta chọn Kafka chỉ vì trong prompt có nhắc tới từ "hàng triệu", chúng ta đã bỏ qua phần quan trọng nhất của bài thực hành này.
The architecture is still a hypothesis (Kiến trúc vẫn chỉ là một giả thuyết)
Hãy lùi lại một bước để xem chúng ta đang có những gì:
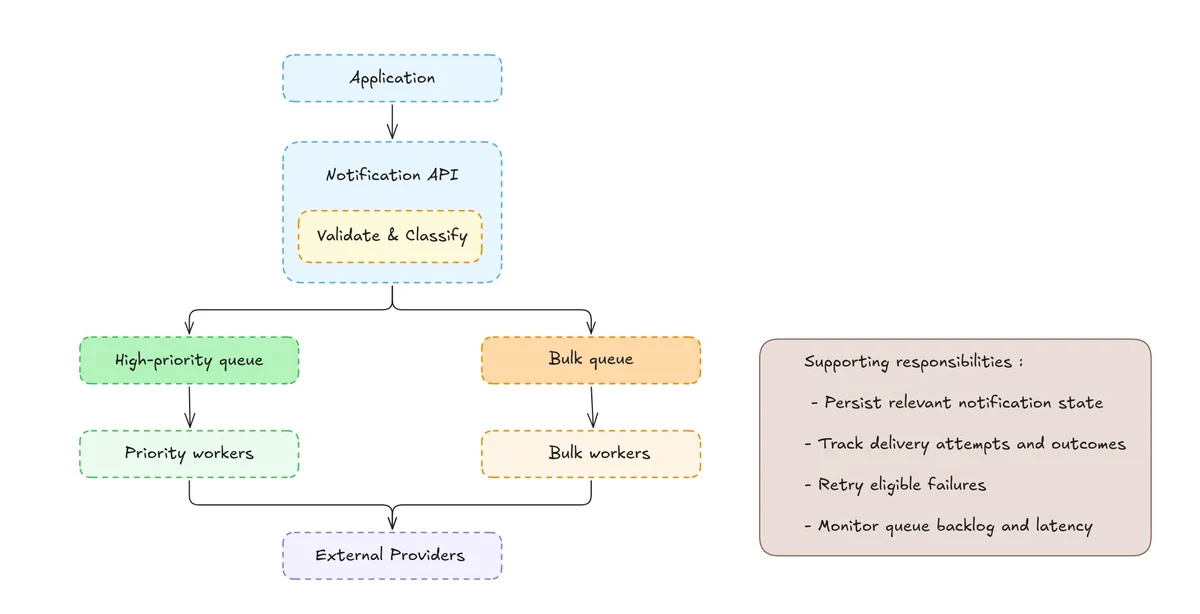
Đây chưa phải là một kiến trúc production hoàn chỉnh. Nó vẫn chưa xác định schema, contract API chính xác, mức độ đồng thời của worker, chính sách lưu trữ (retention policy), chiến lược failover giữa các nhà cung cấp, hay chi tiết xử lý cho từng sự cố.
Điều đó hoàn toàn bình thường.
Hiện tại chúng ta đã có một thiết kế nền tảng (baseline design) dựa trên các yêu cầu đã thảo luận. Chúng ta có thể xác định các vấn đề còn tồn đọng và khảo sát những yếu tố có thể làm thay đổi căn bản các lựa chọn của mình.
Ví dụ: nếu người dùng phải truy vấn trạng thái của từng thông báo, chúng ta sẽ cần xác định cách lưu trữ và truy xuất trạng thái gửi.
Nếu hệ thống phải đáp ứng các mục tiêu khắt khe về độ trễ, chúng ta sẽ cần tính toán dung lượng đỉnh (peak capacity) và kiểm tra xem hàng đợi ảnh hưởng thế nào đến độ trễ end-to-end.
Nếu thông báo phải tuân thủ các tùy chọn luôn thay đổi của người dùng, chúng ta sẽ cần quyết định thời điểm kiểm tra các tùy chọn đó, cũng như cách xử lý các tác vụ đã nằm sẵn trong hàng đợi.
Mỗi ràng buộc mới phát sinh đều có thể dẫn tới một lần tinh chỉnh khác.
Mục tiêu không phải là vẽ ra một kiến trúc phức tạp nhất, mà là đạt được một thiết kế đáp ứng các yêu cầu đã biết, sau đó hiểu rõ hệ thống có thể gặp lỗi ở đâu khi những yêu cầu đó thay đổi.
The habit worth building (Thói quen đáng để rèn luyện)
Khi bạn đối mặt với một hệ thống chưa quen thuộc, đừng bắt đầu bằng việc hỏi nên dùng cơ sở dữ liệu, hàng đợi hay bộ nhớ cache nào.
Hãy bắt đầu bằng việc hiểu hệ thống buộc phải làm những gì.
Hãy tìm hiểu xem ai đang sử dụng nó, những thao tác nào được hỗ trợ, các kỳ vọng then chốt về độ trễ và độ tin cậy là gì, và nó cần phải xử lý khối lượng công việc lớn tới đâu.
Ghi chép lại các yêu cầu và giả định để bạn có thể phân biệt rõ điều gì đã biết chắc chắn, điều gì chỉ là phỏng đoán hợp lý.
Sau đó, hãy xây dựng một thiết kế đơn giản nhất đáp ứng được các điều kiện đó.
Khi các ràng buộc làm lộ ra những hạn chế, hãy tiến hóa thiết kế. Giải thích rõ tại sao sự thay đổi này là cần thiết, nó cải thiện điều gì và nó mang lại những độ phức tạp mới nào.
Trước khi bắt tay vào vẽ bất cứ thứ gì, bạn không cần phải trả lời mọi câu hỏi có thể có. Bạn chỉ cần biết những câu hỏi chưa có lời giải nào có thể khiến thiết kế hiện tại bị vô hiệu hóa.
Đừng đem tên công nghệ ra để giải thích. Nói rằng "chúng tôi sẽ dùng Kafka" không hề giải thích được hệ thống đối phó ra sao với sự cố từ nhà cung cấp, tác vụ được lưu giữ trong bao lâu, hay API cam kết điều gì khi trả về thành công.
Chính những quyết định này mới mang lại ý nghĩa cho kiến trúc.
Một thiết kế hệ thống tốt không phải là sự tập hợp của các thành phần quen thuộc. Nó là một chuỗi các quyết định có thể truy nguyên về yêu cầu, ràng buộc và những sự đánh đổi rõ ràng.
Một khi bạn học được cách tư duy như vậy, sơ đồ sẽ trở thành phương tiện để truyền tải lập luận của bạn, chứ không phải là thứ thay thế cho nó.
Trong bài viết tiếp theo, chúng ta sẽ tìm hiểu điều gì xảy ra sau khi hệ thống tiếp nhận yêu cầu: cách thiết kế API, mô hình hóa dữ liệu và biểu diễn các chuyển đổi trạng thái để hệ thống luôn duy trì hành vi có thể dự đoán được khi quy mô tăng trưởng.