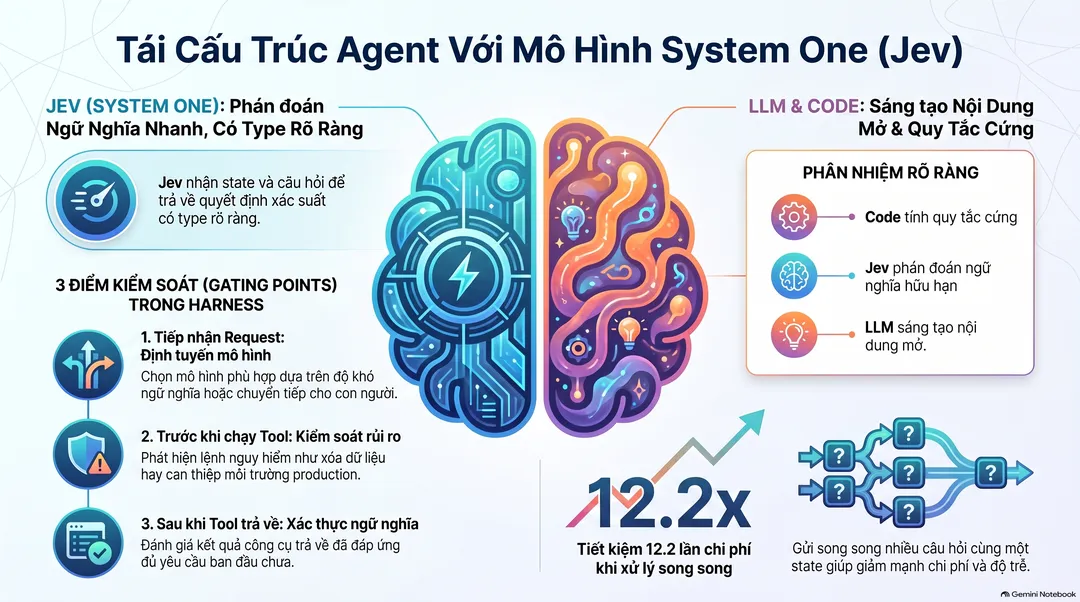
Link bài viết gốc: https://mp.weixin.qq.com/s/BMiC0MoP_6BpL...
Đại Mô Hình Trầm Tư Lục · WeChat Official Account · Đại Mô Hình Trầm Tư Lục · 2026-09-19 20:57
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
Tóm tắt : Jev tách việc định tuyến model, đánh giá rủi ro công cụ và xác thực kết quả ra khỏi vòng lặp chính của LLM tạo sinh, biến chúng thành các quyết định nhanh chóng, có type rõ ràng và kèm xác suất. Bài viết này sử dụng bốn sơ đồ kiến trúc & luồng xử lý cùng hai đoạn code để làm rõ nên đặt nó ở đâu, thiết lập ngưỡng ra sao, và những công việc nào vẫn nên để lại cho code, model mạnh và con người.
Để hoàn thành một nhiệm vụ, một Agent thường phải liên tục trả lời vài dạng câu hỏi: Yêu cầu này nên giao cho model nào? Lệnh tiếp theo có được phép thực thi không? Kết quả công cụ trả về có đáp ứng yêu cầu không? Đã có thể kết thúc chưa?
Không ít hệ thống giao toàn bộ những câu hỏi này cho cùng một mô hình lớn (LLM). Ngay cả khi câu trả lời chỉ là "cho phép" hoặc "từ chối", model vẫn phải đọc context, sinh từng token một, rồi mới để ứng dụng phân tích kết quả. Một lượt gọi đơn lẻ có thể chưa thấy vấn đề, nhưng khi đưa vào vòng lặp, hàng chục phán đoán nhỏ sẽ cùng nhau đẩy độ trễ, chi phí và xác suất thất bại lên cao, đồng thời khiến mỗi nhánh rẽ đều phải phụ thuộc vào một lần sinh văn bản không hoàn toàn ổn định.
Ngày 15 tháng 9 năm 2026, TypeSafe AI đã phát hành model System One đầu tiên mang tên Jev.
System One (Hệ thống 1) ở đây mượn khung nhận thức được phổ biến bởi cuốn sách "Tư duy nhanh và chậm": "Hệ thống 1" nhanh, trực giác, hầu như không cần nỗ lực có ý thức; "Hệ thống 2" chậm hơn, thận trọng hơn, dùng cho các vấn đề đòi hỏi sự tập trung chú ý và phân tích nhiều bước. Cả hai là sự phân chia khái niệm để mô tả cách tư duy, chứ không phải hai hệ thống vật lý độc lập trong não bộ. TypeSafe dùng "Hệ thống 1" để nhấn mạnh định vị phán đoán nhanh của Jev.
Jev không sinh phản hồi, lời giải thích hay code, mà chỉ tiếp nhận một đoạn trạng thái cùng một tập hợp câu hỏi được định nghĩa trước, sau đó trả về câu trả lời có type rõ ràng kèm xác suất.
Jev giống một "bộ phán đoán ngữ nghĩa" có thể lập trình hơn. Code rất giỏi trong việc phán đoán amount > 100 , nhưng lại khó phán đoán trực tiếp "khiếu nại có khẩn cấp không", "lệnh shell có nguy hiểm không". Jev bổ sung loại phán đoán phía sau, còn quyền thực thi cuối cùng vẫn nằm ở code.
Cách sử dụng Jev có giá trị nhất đối với Agent là trở thành lớp kiểm soát xung quanh model tạo sinh: phân luồng trước, kiểm soát cổng trước khi thực thi, và xác thực sau khi thực thi.
1. Trong vòng lặp Agent, nhiều lượt gọi thực chất không cần sinh nội dung
Trước tiên hãy xem một chuỗi thực thi Agent phổ biến:
- Đọc nhiệm vụ của người dùng, chọn model và công cụ;
- Sinh kế hoạch hoặc hành động tiếp theo;
- Đánh giá rủi ro của hành động, quyết định xem có cần phê duyệt không;
- Gọi công cụ, đọc kết quả trả về;
- Đánh giá xem nhiệm vụ đã hoàn thành chưa, hoặc tiếp tục vòng tiếp theo.
Bước thứ hai cần sinh nội dung. Các bước còn lại phần lớn là những phán đoán hữu hạn: chọn model nào, hành động có nguy hiểm không, nhiệm vụ đã hoàn thành chưa. Ngay cả khi yêu cầu LLM chính xuất ra JSON, tầng dưới vẫn phải sinh tự hồi quy, ứng dụng vẫn phải chịu toàn bộ chi phí của một lượt gọi chỉ cho một phán đoán nhỏ.
Quy tắc lựa chọn có thể tóm gọn thành ba câu hỏi: những gì tính toán chính xác được thì giao cho code; những gì đã có dữ liệu hoàn thiện và nhãn cố định thì có thể huấn luyện bộ phân loại truyền thống; còn những gì câu trả lời có thể liệt kê được nhưng lại cần hiểu ngữ nghĩa ngôn ngữ tự nhiên mới chính là phạm vi mục tiêu của Jev. Việc lập kế hoạch, giải thích và sinh nội dung vẫn thuộc về LLM.
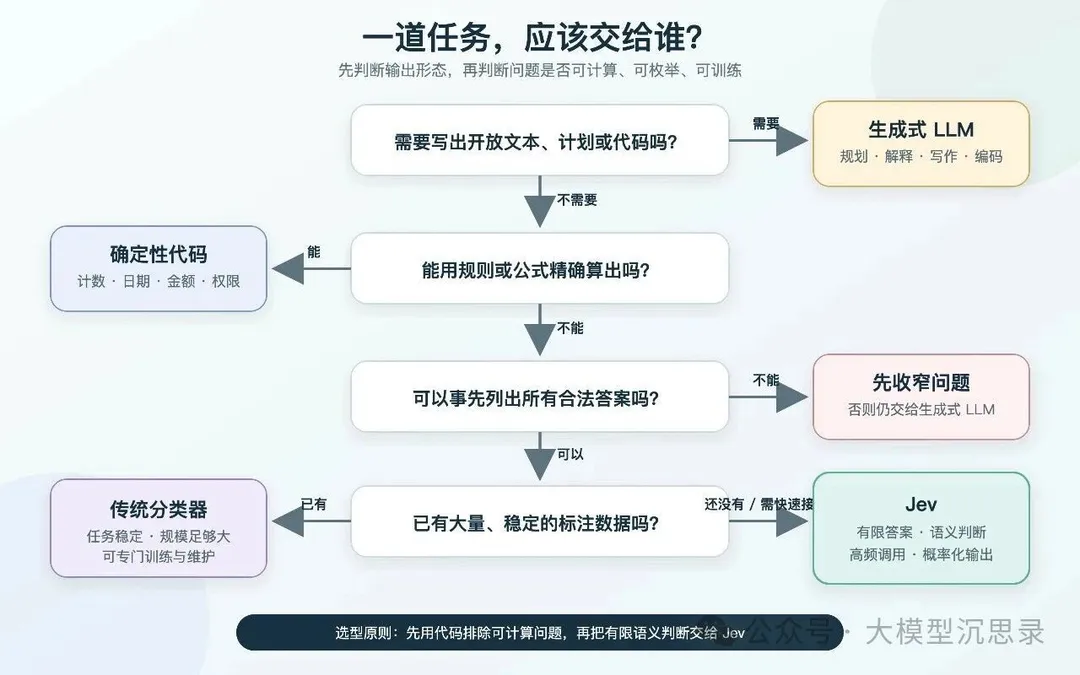
Hình 1 | Trước tiên xem có cần sinh nội dung không, sau đó xem vấn đề có thể tính toán chính xác hay liệt kê câu trả lời được không. Vị trí của Jev là "câu trả lời hữu hạn + phán đoán ngữ nghĩa".
Tiền đề để áp dụng Jev là: Câu trả lời có thể liệt kê trước, nhưng không thể dùng code tất định để tính ra một cách ổn định. Khi cần câu trả lời mở, nhiệm vụ vẫn nên giao cho model tạo sinh.
2. Interface của Jev: Trạng thái vào, quyết định dạng xác suất ra
Khi đưa vào kỹ thuật thực tế, Jev thu hẹp dạng "phán đoán nhanh" này thành một interface rõ ràng:
Trạng thái phi cấu trúc đi vào, quyết định dạng xác suất với type định nghĩa trước đi ra.
Một request bao gồm hai phần:
- state : Tình huống hiện tại, có thể là văn bản, đối tượng JSON hoặc mảng văn bản;
- questions : Phán đoán cần đưa ra đối với đoạn trạng thái này, cùng với những gì mỗi phán đoán được phép trả về.
Ràng buộc này đã được xác định trước khi gọi. Ứng dụng không cần phải trích xuất nhãn từ một đoạn giải thích, cũng không cần xử lý các danh mục mới do model tự tiện đặt ra; sau khi nhận được xác suất, có thể trực tiếp đi vào logic ngưỡng, fallback và kiểm toán.
Jev cung cấp ba loại câu hỏi cơ bản:
| Thể loại | Phù hợp để trả lời | Nội dung trả về |
|---|---|---|
| Choice | "Yêu cầu này thuộc về bộ phận nào?" | Option được chọn, xác suất của từng option, độ tin cậy tổng thể |
| Score | "Mức độ rủi ro của thao tác này cao bao nhiêu?" | Điểm số liên tục, xác suất của từng cấp độ, độ tin cậy tổng thể |
| Noul | "Tin nhắn này có yêu cầu hoàn tiền không?" | Xác suất mệnh đề là đúng, phạm vi từ 0 đến 1 |
Noul là cách TypeSafe đặt tên cho phán đoán đúng/sai, không có trường confidence riêng biệt; còn confidence của Choice và Score được tính toán dựa trên phân phối xác suất hoàn chỉnh. Khi Choice nằm giữa hai option với tỉ lệ xấp xỉ 50-50, độ tin cậy thường sẽ khá thấp.
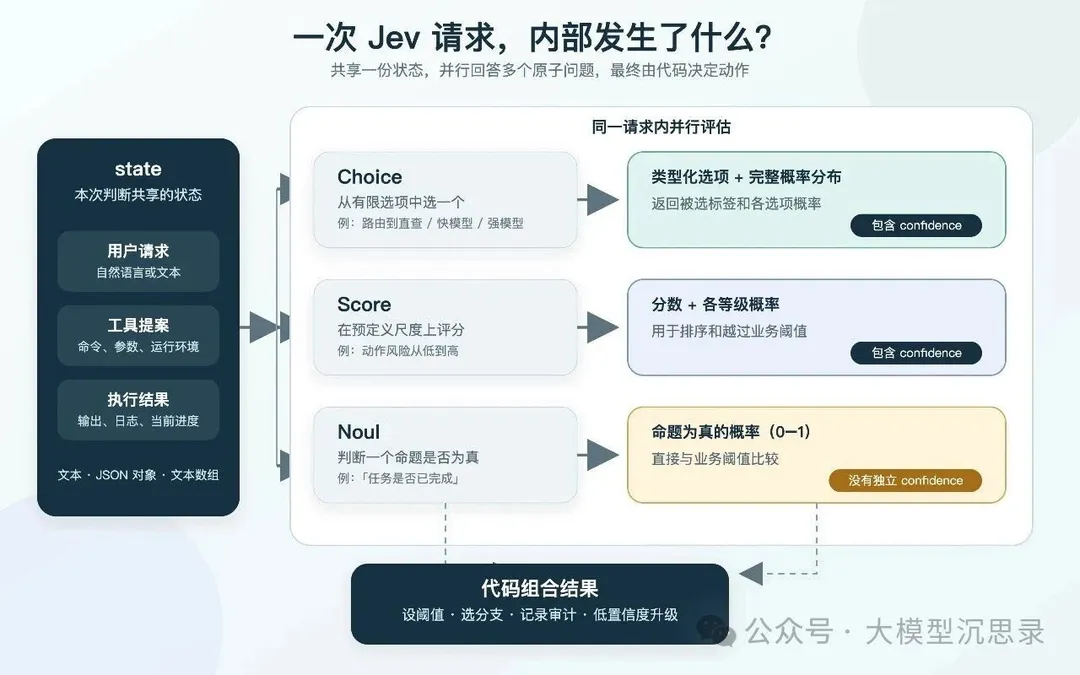
Hình 2 | Một bản state có thể hỗ trợ đánh giá song song nhiều câu hỏi độc lập. Model trả về kết quả dạng xác suất, còn ngưỡng, rẽ nhánh và luồng leo thang vẫn do code quản lý.
LangChain dùng TypeSafeClassifier để đóng gói interface này. Dưới đây là ví dụ đánh giá sự cố online có cần xử lý ngay lập tức hay không:
from langchain_typesafe import Noul, TypeSafeClassifierclassifier = TypeSafeClassifier()response = classifier.invoke( state=( "The deploy failed twice and customers are seeing 500s. " "Can someone look now?" ), questions={ "urgent": Noul( instructions="Does this need attention right now?" ) },)urgent_probability = response.nouls["urgent"].noulif urgent_probability > 0.9: page_on_call_engineer()else: add_to_incident_queue()Model chỉ cung cấp xác suất của tính "khẩn cấp". 0.9 là ngưỡng nghiệp vụ, không phải ranh giới an toàn tích hợp sẵn của Jev, bắt buộc phải được hiệu chuẩn trên tập mẫu sự cố của chính đội ngũ bạn; việc thông báo, leo thang và kiểm toán vẫn do ứng dụng xử lý. Một Agent hoàn chỉnh sẽ hoạt động liên tục xoay quanh các mục tiêu mở, còn Jev mỗi lần chỉ trả lời các câu hỏi hữu hạn rồi dừng lại.
3. Đặt Jev vào ba vị trí trong Harness
Harness (framework vận hành Agent) kết nối model, công cụ, context, quyền hạn và vòng lặp thực thi. Jev phù hợp để nhúng vào ba điểm kiểm soát hẹp nhưng có tần suất cao.
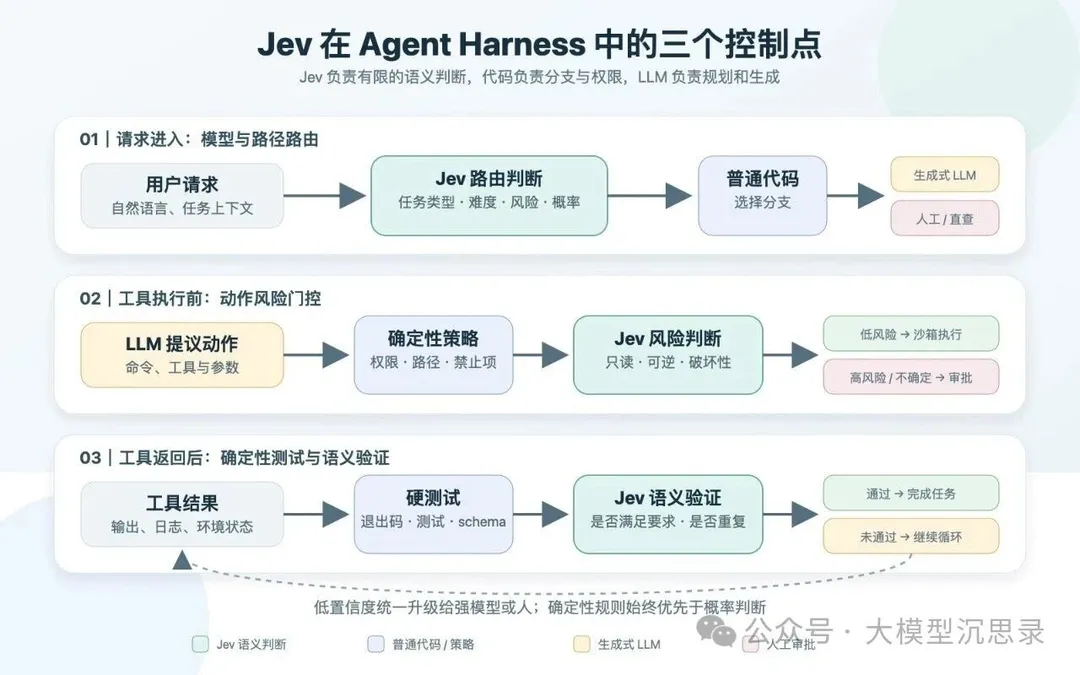
Hình 3 | Jev phụ trách phán đoán ngữ nghĩa; code thông thường phụ trách quy tắc xác định và điều khiển luồng; LLM tạo sinh tiếp tục đảm nhận việc lập kế hoạch và sinh nội dung. Bài viết được tổng hợp và vẽ lại dựa trên tư liệu công khai từ TypeSafe và LangChain.
1. Khi request đi vào: Chọn model và luồng xử lý
Tra cứu đơn hàng có thể truy cập trực tiếp cơ sở dữ liệu, chỉnh sửa cục bộ có thể giao cho model giá rẻ, chỉ khi đánh giá kiến trúc mới cần đến model mạnh. Jev định tuyến dựa trên độ khó ngữ nghĩa, loại nhiệm vụ và rủi ro; các request có độ tin cậy thấp sẽ được leo thang chuyển tiếp cho model mạnh hoặc con người. Bằng cách này, model mạnh chỉ xử lý các request thực sự cần lập kế hoạch và suy luận, đồng thời lỗi định tuyến cũng có đường fallback rõ ràng.
2. Trước khi công cụ thực thi: Đánh giá rủi ro của hành động
Các quy tắc xác định sẽ kiểm tra quyền hạn, đường dẫn và các mục cấm trước, sau đó Jev mới phán đoán xem tổ hợp lệnh có khả năng xóa dữ liệu, sửa lịch sử Git hay đụng chạm đến môi trường production hay không. Bản thử nghiệm của LangChain AutoModeMiddleware sẽ kiểm tra các hành động nguy hiểm ngay trước khi công cụ thực thi. Bạn có thể đặt câu hỏi riêng cho từng rủi ro, rồi để code áp dụng chiến lược "chỉ cần một rủi ro cao là leo thang" hoặc tính theo trọng số. Cổng kiểm soát ngữ nghĩa chỉ là lớp lưới lọc thứ hai, không thể thay thế sandbox và hệ thống phân quyền.
3. Sau khi công cụ trả về: Bổ sung xác thực ngữ nghĩa
Exit code và kết quả test do code phán đoán; còn "câu trả lời có bao quát hết yêu cầu không", "bằng chứng có hỗ trợ kết luận không", "Agent có đang lặp lại hành động không" có thể giao cho Jev. Sau đó Harness sẽ quyết định tiếp tục, đổi model, chuyển người kiểm duyệt thủ công hay kết thúc. Mấu chốt ở đây là tách chữ "hoàn thành" thành các mệnh đề có thể kiểm tra được, thay vì để model đánh giá chung chung chất lượng tổng thể. Jev chỉ bổ sung điều kiện ngữ nghĩa, chứ không ghi đè hay thay thế các bài test cứng.
Khi kết nối ba điểm kiểm soát này lại, một vòng lặp Agent có thể được viết thành mã giả như sau:
route = jev.choose(request, [direct_lookup, fast_model, strong_model, human])if route.confidence < ROUTE_THRESHOLD: return send_to_human(request)proposal = selected_model(route).plan_next_action(request, state)hard_checks = policy_engine.check(proposal)risk = jev.score(proposal, [read_only, reversible, destructive])if hard_checks.denied or risk > ACTION_THRESHOLD: return request_approval(proposal)result = run_tool_in_sandbox(proposal)tests = deterministic_tests(result)semantic_check = jev.verify(result, completion_criteria)return finish() if tests.pass and semantic_check > DONE_THRESHOLD else continue_loop()Jev không nắm quyền hạn tối cao: code quyết định ngưỡng, policy engine có thể trực tiếp từ chối, công cụ vẫn chạy trong sandbox, và các hành động rủi ro cao vẫn cần con người phê duyệt. Ngay cả khi dịch vụ Jev không khả dụng, Harness vẫn phải đi theo phương án fallback an toàn đã định trước, chứ không mặc định cho phép thông qua.
4. Bốn nguyên tắc kỹ thuật, quan trọng hơn cả việc tích hợp SDK
Hỏi hết các câu hỏi độc lập trong một lần
Một request có thể phán đoán song song bộ phận phụ trách ticket, mức độ khẩn cấp, ý định hoàn tiền và độ đầy đủ của thông tin. TypeSafe gọi đây là speculative fan-out (mở rộng suy đoán): đoạn văn bản dài dùng chung chỉ truyền một lần, việc thêm phán đoán mới chủ yếu chỉ làm tăng token của chính câu hỏi đó. Chỉ khi câu hỏi sau phụ thuộc vào câu trả lời trước, bạn mới nên tách thành nhiều request; nếu không, việc gọi tuần tự sẽ chỉ lặp lại việc truyền trạng thái và làm tăng độ trễ tích lũy.
Một câu hỏi chỉ chứa một phán đoán
Câu hỏi "phân tích ticket và quyết định phương thức xử lý tối ưu" đã trộn lẫn cả bộ phận, rủi ro, cảm xúc và quyền hạn, một khi xảy ra lỗi sẽ rất khó định vị. Nên tách bạch các phán đoán ra, rồi để code kết hợp chúng lại theo trọng số nghiệp vụ có thể kiểm tra được. Cách này vừa giúp đánh giá riêng từng câu hỏi, vừa thấy rõ xác suất nào đã dẫn tới nhánh rẽ cuối cùng; khi điều chỉnh trọng số và chạy lại test, bạn không cần phải viết lại cả một đoạn prompt dài.
Ngưỡng thay đổi theo mức độ rủi ro
Độ tin cậy thể hiện việc model có do dự giữa các phương án trả lời hay không, chứ không chứng minh câu trả lời hiện tại là đúng; việc hiệu chuẩn đo lường trên một tập hợp các dự đoán. Thao tác chỉ đọc rủi ro thấp có thể dùng ngưỡng thấp hơn, còn gửi email, sửa database hay xóa file cần ngưỡng cao hơn và phải có bước xác nhận trước khi thực thi. Trong thực tế, bạn có thể thiết lập ba khoảng: "tự động thực thi, leo thang kiểm duyệt, trực tiếp từ chối". Ngưỡng nên được rút ra từ độ chính xác và cái giá phải trả khi xảy ra sai sót trên dữ liệu thực tế, thay vì sao chép máy móc từ ví dụ.
Những gì tính rõ được bằng code, hãy tiếp tục dùng code
Đếm số lượng, số tiền, ngày tháng, whitelist quyền hạn và kết quả test đều nên để code xử lý. Trang tài liệu chính thức về "jaggedness" của Jev 1.13 cũng thừa nhận rằng nó không giỏi về số học, đếm, so sánh ngày tháng và độ chính xác của giá trị số. Viết các quy tắc cứng thành code mới mang lại unit test có thể tái lập, log rõ ràng và hành vi từ chối ổn định. Model phán đoán ý nghĩa, code tính toán sự thật.
5. Hiểu thế nào về "nhanh hơn 200 lần, rẻ hơn 400 lần"
Tính đến ngày 19 tháng 9 năm 2026, phiên bản ổn định được liệt kê trên trang model chính thức của TypeSafe là jev-1.13.0 : 0,042 USD cho mỗi một triệu token đầu vào, token đầu ra miễn phí; tổng ngân sách cho mỗi request là 64k token, đồng thời yêu cầu state cộng với câu hỏi đơn lẻ dài nhất không vượt quá 32k token. Đầu vào hiện chỉ hỗ trợ văn bản.
TypeSafe báo cáo độ trễ end-to-end của họ vào khoảng 70–500 mili-giây. Trong workflow evals tự xây dựng, website chính thức đã sử dụng các con số về ưu thế tốc độ gấp 193,6 lần và chi phí rẻ hơn 444,6 lần. Phía nhà phát triển cũng đồng thời giải thích rằng hai hệ số nhân này nằm ở biên độ cao của lợi ích thực tế, các tác vụ đánh giá cũng do chính các thành viên trong đội ngũ năng lực model của công ty xây dựng nên có thể tồn tại sai lệch.
Những con số này chỉ áp dụng cho các tác vụ workflow có không gian câu trả lời hữu hạn: xác suất tham chiếu đến từ dự đoán trung bình của các model bên ngoài mạnh mẽ, chứ không phải câu trả lời chuẩn duy nhất trong các bài kiểm tra phân loại truyền thống; các tác vụ do chính đội ngũ nhà cung cấp xây dựng, hơn nữa interface đã chủ động lược bỏ suy luận dài và sinh văn bản. Do đó không thể suy rộng ra các tác vụ viết lách, lập trình hay suy luận mở, cũng như không thể xem đây là cam kết chi phí trực tiếp cho một hệ thống production cụ thể nào.
Một ví dụ dễ kiểm chứng hơn đến từ parallel questions cookbook chính thức. Bài test đưa một văn bản GDPR dài 53.777 ký tự cùng 13 câu hỏi cho Jev 1.12 và chạy lặp lại 5 lần:
| Cách | Số lượt gọi | Chi phí trung bình | Tổng thời gian tiêu tốn | Nên hiểu thế nào |
|---|---|---|---|---|
| Gửi cùng lúc 13 câu hỏi trong 1 lần | 1 | 0.000497 USD | 0.27 giây | Tài liệu dài chỉ truyền vào một lần |
| 13 lượt gọi cho từng câu hỏi riêng lẻ | 13 | 0.006090 USD | 2.71 giây | Mỗi lần gọi đều truyền lại tài liệu dài |
Trong nhóm thử nghiệm này, phương thức batch rẻ hơn 12,2 lần và nhanh hơn 10 lần. Nếu thực hiện 13 lượt gọi đồng thời, chênh lệch độ trễ sẽ thu hẹp lại, nhưng chi phí input lặp lại vẫn còn đó. Điều này chứng minh rằng việc xử lý theo batch các câu hỏi độc lập khi chia sẻ chung một state dài sẽ tiết kiệm hơn nhiều, chứ không có nghĩa là mọi workflow đều mặc định mang lại hiệu quả gấp 10 lần.
VI. Type safety không giải quyết được lỗi phán đoán
TypeSafe tuyên bố Jev "không bị ảo giác". Nói một cách chặt chẽ, điều này chỉ có nghĩa là sau khi không gian câu trả lời được xác định, model sẽ không trả về kiểu dữ liệu nằm ngoài schema.
Nếu bộ phận chỉ có billing , technical và sales , Jev sẽ không tạo ra legal hay một đoạn văn xuôi, nhưng hoàn toàn có thể phân loại nhầm sự cố kỹ thuật sang billing .
Type safety đảm bảo hình dạng output, hiệu chuẩn xác suất mô tả một tập hợp dự đoán, còn câu trả lời hiện tại có chính xác hay không vẫn phải dựa vào kiểm thử.
Các điểm yếu đã biết được tài liệu chính thức liệt kê còn bao gồm:
- Nó hiểu câu hỏi theo nghĩa đen, các điều kiện ẩn, phủ định kép và mối quan hệ đa bước (multi-hop) sẽ làm giảm độ chính xác;
- Khi có quá nhiều thông tin không liên quan, state dài sẽ gây nhiễu phán đoán, nên truy xuất và lọc trước;
- Văn bản đối kháng có thể khiến câu trả lời bị lệch hướng, không được mặc định coi state là input đáng tin cậy;
- Score thích hợp để xếp hạng và vượt ngưỡng, không thích hợp để diễn giải 1.4 thành một đại lượng vật lý chính xác;
- Nó không thể tạo sinh, tóm tắt hoặc giải thích một cách đáng tin cậy; khi cần văn bản mở, nên gọi model tạo sinh;
- Tiếng Anh là ngôn ngữ huấn luyện chính; dù các ký tự CJK như tiếng Trung có thể xử lý được, bạn vẫn cần dùng dữ liệu của chính mình để kiểm chứng.
Trong Agent, bạn còn cần phân biệt giữa quy tắc đáng tin cậy và quan sát không đáng tin cậy: chính sách quyền hạn do code lưu trữ, còn trang web, email và giá trị trả về của tool chỉ có thể đóng vai trò như state . Khi cần thiết, hãy truy xuất, cắt ngắn và loại bỏ nội dung không liên quan trước khi để Jev phán đoán, tránh trường hợp văn bản bên ngoài lợi dụng prompt injection làm ảnh hưởng đến kết quả gating.
Jev hiện đang ở giai đoạn early access, trọng số chưa được mở và các nghiên cứu hiệu chuẩn độc lập vẫn còn hạn chế. Trước khi tích hợp, bạn còn cần đánh giá độ ổn định của dịch vụ, ranh giới dữ liệu và sự phụ thuộc vào nhà cung cấp. Đây là một thành phần mới cần được đánh giá tại chỗ, chứ không phải một trọng tài an toàn dùng được ngay khi mở hộp.
VII. Bảy bước tích hợp Jev vào Agent hiện có
Bước 1: Chọn các phán đoán có tần suất cao, phạm vi hữu hạn và rủi ro thấp, chẳng hạn như định tuyến model, phân luồng ticket hoặc kiểm tra tool chỉ đọc.
Bước 2: Viết rõ các mục bao gồm và loại trừ cho từng lựa chọn, đồng thời giữ lại mục "Khác" hoặc "Thông tin chưa đủ".
Bước 3: Xây dựng tập dữ liệu gán nhãn, bao quát các mẫu bình thường, mơ hồ, trường hợp biên, tiếng Trung và mẫu dẫn dụ độc hại.
Bước 4: Chạy shadow mode, chỉ ghi lại câu trả lời, xác suất, độ trễ và kết quả mà không làm thay đổi hành vi thực tế.
Bước 5: Phân tích mối quan hệ giữa độ chính xác với xác suất hoặc độ tin cậy, từ đó phân định các khoảng ngưỡng cho việc tự động thực thi, gọi model mạnh và xử lý thủ công.
Bước 6: Chỉ tự động hóa các nhánh có độ tin cậy cao, chi phí thấp; giữ lại luồng leo thang xử lý cho các kết quả không chắc chắn hoặc có rủi ro cao.
Bước 7: Quản lý phiên bản đồng thời cho model, câu hỏi, criteria (tiêu chí phán đoán lựa chọn), ngưỡng và tập đánh giá; cố định phiên bản trong quy trình production, chạy replay trên cùng một tập dữ liệu trước khi nâng cấp.
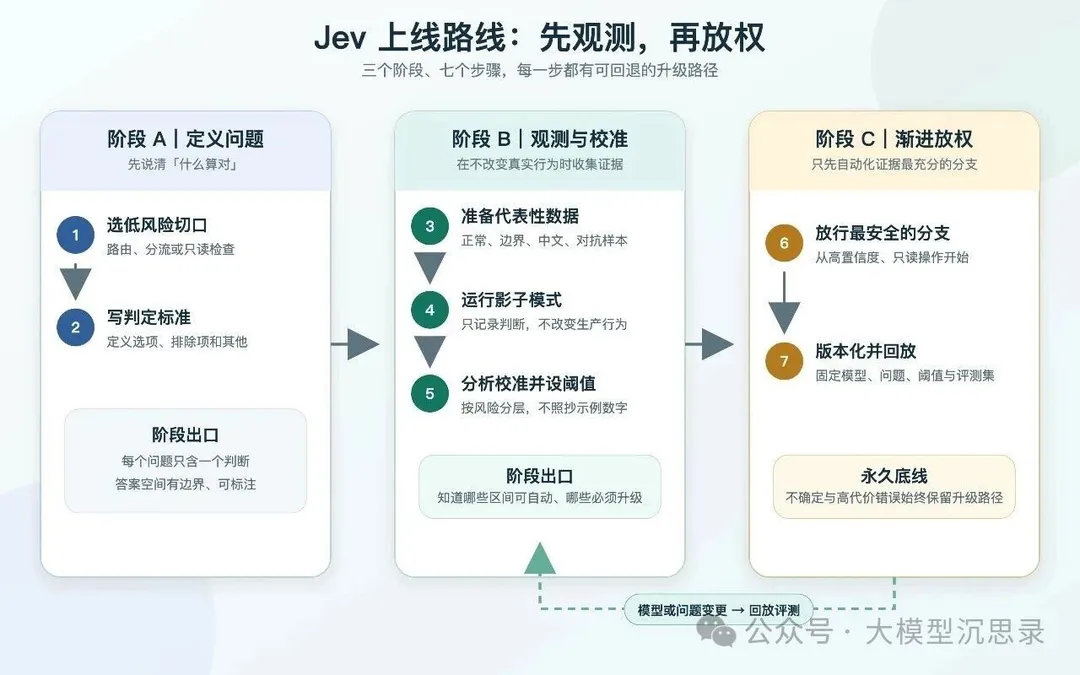
Hình 4 | Triển khai thực tế chia làm ba giai đoạn: "Xác định vấn đề, Quan sát hiệu chuẩn, Trao quyền tuần tự". Khi model, câu hỏi hoặc ngưỡng thay đổi, cần quay lại cùng một tập đánh giá để chạy replay kiểm tra lại.
Sau khi hoàn tất, mỗi phán đoán ngữ nghĩa đều có input rõ ràng, đáp án hữu hạn, ngưỡng kiểm tra được và hướng xử lý khi thất bại. Đội ngũ phát triển cũng có thể trả lời một câu hỏi cốt lõi: Vì sao tự động hóa lại tiếp tục ở bước này nhưng dừng lại ở bước kia. Jev hiếm khi thay đổi "bộ não" của Agent mà chủ yếu tái cấu trúc hệ thống kiểm soát xung quanh nó: khi nào cần gọi model mạnh, hành động nào được phép thông qua, và kết quả nào cần review lại.
Khi code giành lại quyền kiểm soát các nhánh rẽ, quyền hạn và xử lý lỗi, còn model chỉ chịu trách nhiệm cho các phán đoán ngữ nghĩa mà code không thể tính toán rõ ràng, Agent mới có cơ hội đạt được đồng thời cả tốc độ lẫn khả năng kiểm soát.
Tài liệu tham khảo
- TypeSafe AI: Introducing System One Models & Jev[1], 15/09/2026
- TypeSafe AI: System One[2], 09/2026
- TypeSafe AI: Models[3], truy cập ngày 19/09/2026
- TypeSafe AI: Confidence[4], 09/2026
- TypeSafe AI: Jev 1.13 jaggedness[5], 17/09/2026
- TypeSafe AI: Parallel questions[6], 09/2026
- LangChain: Building a Harness with Jev[7], 17/09/2026
- Flavio Copes: A deep dive into Jev, TypeSafe's System One model[8], 18/09/2026
- Akshay Pachaar: Jev Clearly Explained[9], 18/09/2026
Liên kết tham khảo
[1] Introducing System One Models & Jev: https://typesafe.ai/blog/introducing-system-one-models-and-jev
[2] System One: https://docs.typesafe.ai/concepts/system-one
[3] Models: https://docs.typesafe.ai/models
[4] Confidence: https://docs.typesafe.ai/confidence
[5] Jev 1.13 jaggedness: https://docs.typesafe.ai/model-jaggedness/jev-1.13
[6] Parallel questions: https://docs.typesafe.ai/cookbooks/parallel_questions
[7] Building a Harness with Jev: https://www.langchain.com/blog/building-a-harness-with-jev
[8] A deep dive into Jev, TypeSafe's System One model: https://flaviocopes.com/jev/
[9] Jev Clearly Explained: https://x.com/akshay_pachaar/status/2101037514945597645
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác