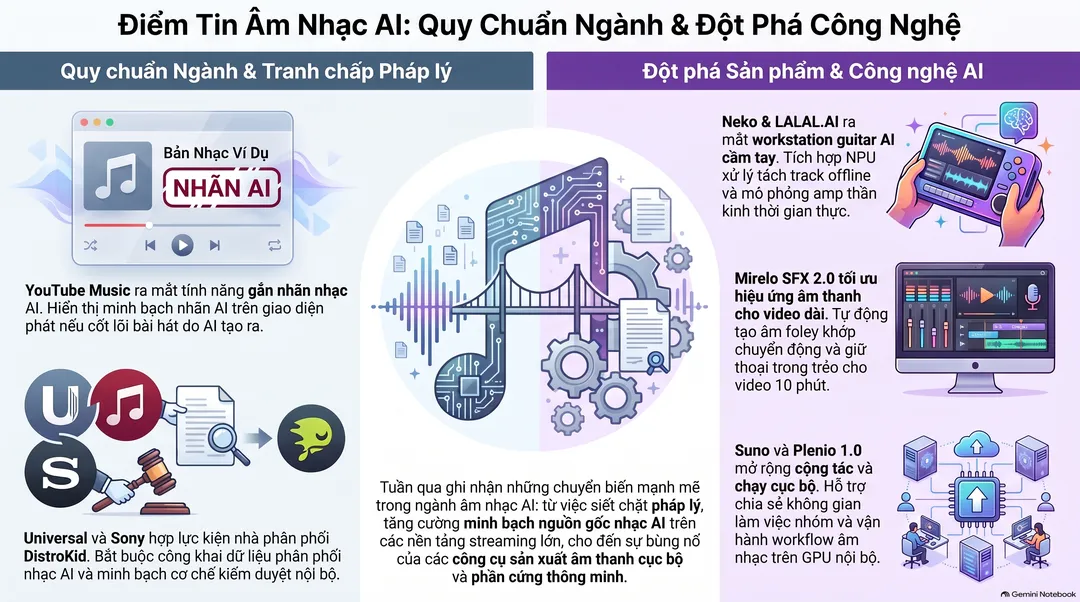
Tác giả: Trí Âm Brook Link bài viết gốc: https://mp.weixin.qq.com/s/ksdy1CRGama0yVvM0wsu4A Lưu ý: Một số thông tin trong bài viết có video minh họa, nếu muốn xem vui lòng truy cập bài viết gốc ở trên
Điểm nhanh tin tức âm nhạc AI tuần này Quy chuẩn ngành YouTube Music ra mắt tính năng gắn nhãn nhạc AI Universal và Sony bắt tay kiện DistroKid: Yêu cầu bắt buộc công khai dữ liệu phân phối và cơ chế nhận diện nhạc AI Sản phẩm & Công nghệ Neko hợp tác cùng LALAL.AI ra mắt workstation guitar AI cầm tay: Tích hợp tách track offline và mô phỏng amp thần kinh Mirelo ra mắt SFX 2.0, hỗ trợ âm thanh liền mạch cho video dài và fine-tune từng track Suno ra mắt không gian làm việc chia sẻ nhóm và tính năng cộng tác model tùy chỉnh Bộ công cụ sản xuất âm nhạc cục bộ mã nguồn mở Plenio 1.0 dựa trên ComfyUI chính thức ra mắt Grok Imagine ra mắt tính năng tạo nhạc Grok Music: Kết nối liền mạch nhạc nền video và chỉnh sửa audio track Nền tảng âm nhạc AI Treblo phát hành nhiều bản cập nhật mới Paper chọn lọc Bài báo khoa học chọn lọc tuần này (5 bài) | Bao gồm không gian tiềm ẩn ngữ nghĩa âm nhạc, chỉnh sửa giọng hát trong môi trường thực tế, clone nhạc cụ từ âm thanh hỗn hợp, giao diện ra quyết định âm thanh hiệu quả cao, tạo nhạc căn chỉnh ký hiệu...
Quy chuẩn ngành
YouTube Music ra mắt tính năng gắn nhãn nhạc AI
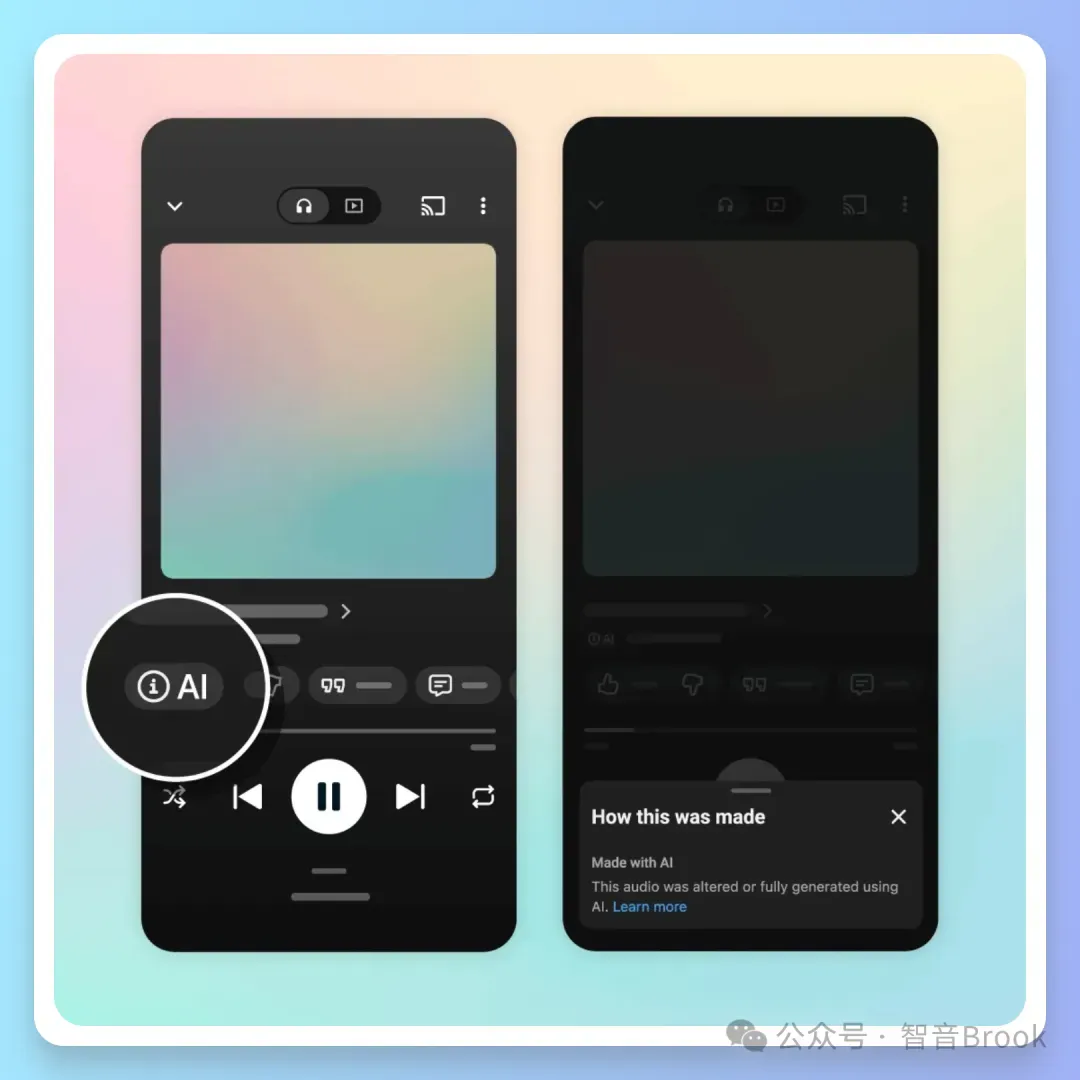
Ngày 14 tháng 10, YouTube Music chính thức ra mắt tính năng gắn nhãn nhạc AI tạo sinh . Theo quy định mới, khi phần cốt lõi của một bài hát (như hòa âm phối khí giai điệu hoặc giọng hát thể hiện) chủ yếu do model AI tạo ra, giao diện trình phát sẽ hiển thị trực tiếp nhãn AI tương ứng. Người nghe khi nhấn vào nhãn này có thể mở rộng để xem thêm thông tin chi tiết và bối cảnh tạo tác phẩm. Tính năng gắn nhãn này sau đó cũng sẽ được đồng bộ triển khai lên ứng dụng chính của YouTube.
Về cơ chế nhận diện và triển khai thực thi, nền tảng áp dụng phương án kép "kiểm tra kỹ thuật và phối hợp ngành": Một mặt sử dụng các công cụ thuật toán âm thanh tự phát triển để chủ động sàng lọc âm thanh nạp vào kho, mặt khác phối hợp với các hãng thu âm và đối tác bản quyền để xác minh, duy trì tính nhất quán với các quy định công khai nội dung AI hiện có của YouTube.
Trước lượng âm thanh tạo sinh ngày càng gia tăng, YouTube đang thông qua cơ chế gắn nhãn này để đưa thuộc tính sản xuất của ca khúc từ khâu kiểm duyệt hậu trường ra công khai phía người dùng, tránh gây nhầm lẫn giữa các bài hát do thuật toán tạo ra với tác phẩm của con người trong quá trình đề xuất và phát nhạc.
Universal và Sony bắt tay kiện DistroKid: Yêu cầu bắt buộc công khai dữ liệu phân phối và cơ chế nhận diện nhạc AI
Ngày 16 tháng 10, Universal Music Group (UMG) và Sony Music đã cùng nộp đơn kiện, yêu cầu tòa án ra lệnh cho nhà phân phối âm nhạc độc lập lớn nhất thế giới DistroKid công khai toàn bộ dữ liệu nội bộ về việc phân phối các ca khúc do AI tạo ra tới các nền tảng streaming. Các gã khổng lồ ngành thu âm cáo buộc DistroKid là kênh then chốt đưa âm thanh tạo sinh vào các nền tảng streaming chính thống, yêu cầu đơn vị này công khai trung thực quy mô phân phối âm thanh tạo sinh từ các nền tảng như Suno, đồng thời giao nộp chi tiết kỹ thuật về cơ chế nhận diện và lọc AI nội bộ chưa từng được công bố trước đây.
Vụ kiện lần này đã chuyển trọng tâm từ việc bảo vệ quyền lợi trực tiếp nhắm vào một nền tảng tạo sinh đơn lẻ trước đây sang chứng cứ thương mại trong toàn bộ "chuỗi phân phối và lan truyền". Các hãng thu âm chỉ ra rằng, DistroKid với tư cách là kênh trung gian chủ chốt đã tiếp tay cho âm thanh tạo sinh chưa được cấp phép xâm nhập vào các nền tảng như Spotify, Apple Music, và việc đơn vị này không công khai tiêu chuẩn kiểm tra khiến quy mô vi phạm bản quyền thực tế rất khó xác minh. Nguyên đơn hy vọng thông qua việc trích xuất dữ liệu cơ sở từ phía nhà phân phối để định lượng thiệt hại kinh tế thực tế mà nội dung do thuật toán tạo ra gây ra cho các nhà sáng tạo con người, qua đó bác bỏ lập luận bào chữa "sử dụng hợp lý" (fair use) mà các nền tảng tạo sinh lâu nay vẫn viện dẫn.
Khi bên nắm giữ bản quyền chuyển áp lực bảo vệ quyền lợi sang các kênh phân phối thượng nguồn, các nhạc sĩ độc lập và đội ngũ sản xuất cũng phải đối mặt với quy trình kiểm duyệt nghiêm ngặt hơn về tính tuân thủ khi phân phối ca khúc:
- Gắn nhãn minh bạch nguồn gốc tạo sinh : Khai báo trung thực trong trang quản trị phân phối về việc có sử dụng model AI hay không cùng tỷ trọng liên quan, tránh nguy cơ bị nền tảng gỡ bài đột ngột do không chủ động công khai.
- Lưu trữ nhật ký gửi phân phối : Lưu giữ log gửi phân phối và báo cáo metadata của ca khúc, giúp nhanh chóng truy xuất kiểm tra khi nền tảng tiến hành rà soát bản quyền ngẫu nhiên.
- Tự kiểm tra và rà soát lỗi âm thanh : Trước khi tải lên, hãy sử dụng các công cụ phân tích âm học chuyên nghiệp để kiểm tra tạp âm tần số cao và các đặc trưng tổng hợp bất thường, tránh bị thuật toán chống gian lận tự động của nền tảng streaming nhận diện nhầm và chặn lại.
- Lưu trữ project sáng tác và chứng cứ quyền sở hữu : Lưu trữ cẩn thận các track thu âm nhạc cụ thật, project MIDI và file project sáng tác lời/nhạc, đảm bảo cung cấp đầy đủ chuỗi bằng chứng sáng tác khi phát sinh tranh chấp về quyền sở hữu.
Tài liệu tòa án cho thấy, chỉ tính riêng từ tháng 3 đến tháng 9 năm 2026, số lượng ca khúc DistroKid phân phối tới một nền tảng streaming duy nhất đã đạt gần 12 triệu bài, vượt qua tổng số lượng của tất cả các kênh phân phối khác cộng lại trong cùng kỳ.
Đáng chú ý, đây là lần đầu tiên Sony Music cùng Universal Music phối hợp hành động pháp lý (trước đó vào giữa tháng 9, vụ kiện nhắm vào DistroKid chỉ do Universal Music đơn phương khởi xướng). Nếu tòa án chấp thuận yêu cầu bắt buộc công khai của nguyên đơn, log kiểm duyệt nội bộ và dữ liệu lọc của nền tảng phân phối sẽ bị buộc phải công bố, từ đó làm rõ hơn trách nhiệm tuân thủ và nghĩa vụ pháp lý của các đơn vị phân phối trung gian trong việc giám sát nội dung AI.
Sản phẩm & Công nghệ
Neko hợp tác cùng LALAL.AI ra mắt workstation guitar AI cầm tay: Tích hợp tách track offline và mô phỏng amp thần kinh
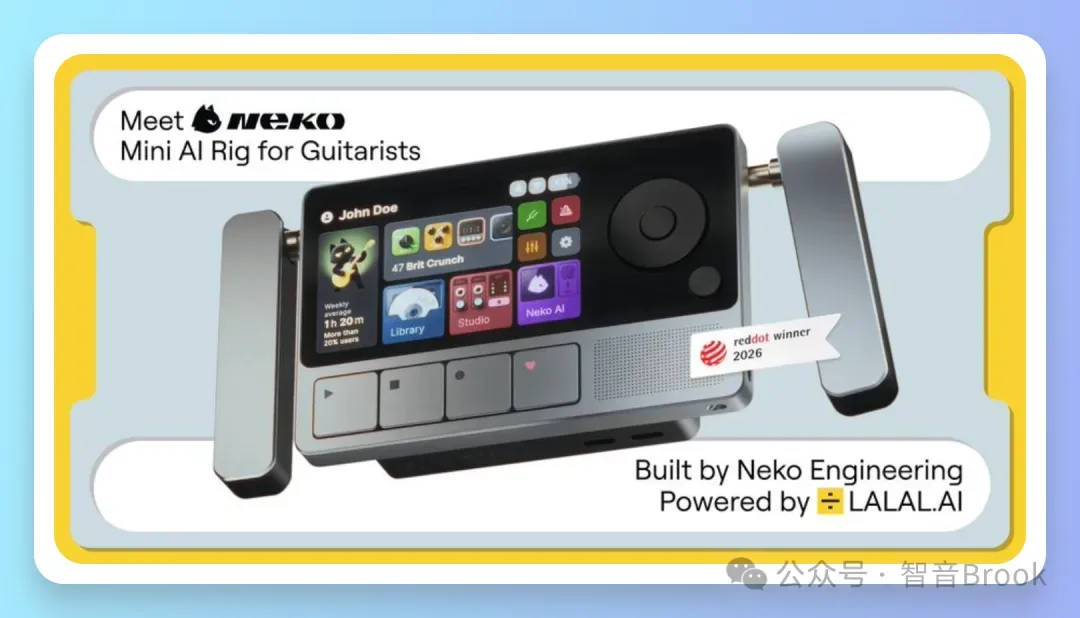
Ngày 13 tháng 10, startup Neko Engineering từ UAE đã hợp tác cùng tổ chức thuật toán âm thanh Thụy Sĩ LALAL.AI chính thức ra mắt workstation guitar không dây di động Neko , thiết bị này đã giành Giải thưởng Red Dot Design Concept năm 2026.
Thiết bị tích hợp NPU chuyên dụng cùng 4GB RAM, trang bị model LALAL.AI gọn nhẹ, tập trung vào khả năng tính toán âm thanh on-device theo thời gian thực không phụ thuộc vào mạng và mô phỏng âm sắc với độ trễ thấp.
Về thông số phần cứng và cổng kết nối, thân máy trang bị màn hình cảm ứng 3.5 inch, loa kiểm âm 3W và cổng USB-C, giữ lại jack cắm nhạc cụ 6.35mm tiêu chuẩn, kèm theo cặp đầu phát không dây cho guitar và ampli/loa. Về thời lượng pin, thân máy hoạt động khoảng 6 giờ, đầu phát không dây dùng được khoảng 3 giờ cho mỗi lần sạc.
Xoay quanh việc luyện tập, bóc tách bản nhạc và sáng tác ngẫu hứng của nhạc công, các tính năng cốt lõi của Neko gồm:
- Tách âm offline cục bộ và chỉnh tốc độ luyện tập : Không cần kết nối mạng vẫn có thể bóc tách các track guitar, bass, trống và vocal trong thời gian thực; hỗ trợ tắt tiếng (mute) guitar hoặc trống của bản nhạc gốc chỉ bằng một chạm, đồng thời tự do điều chỉnh tốc độ phát và đặt lặp đoạn theo điểm chỉ định, tiện lợi cho việc làm chậm để luyện tập theo mục tiêu.
- Mô phỏng amp/cab neural và kho preset khổng lồ : Tích hợp engine mô phỏng Neural Amp Modeler (NAM) cùng công nghệ Impulse Response (IR), tích hợp sẵn nhiều mô phỏng amp head và cabinet neural, đồng thời hỗ trợ kết nối cộng đồng TONE3000 để gọi trực tiếp hơn 250.000 preset âm sắc.
- Tự động chuyển âm thanh thành tab guitar : Có thể tự động suy luận và chuyển đổi track solo hoặc đệm guitar mộc đã bóc tách thành tab guitar trực quan, giảm đáng kể rào cản bóc tách bản nhạc bằng tai.
- Ghi lại đoạn ngẫu hứng và tự động phối khí phần đệm : Tích hợp tính năng Time Machine, tự động ghi lại các đoạn cảm hứng trong lúc chơi đàn, sau đó thuật toán sẽ suy luận để tạo ra phần đệm phối khí cơ bản cho trống và bass.
Hiện Neko đã mở gọi vốn cộng đồng trên Kickstarter, giá bán lẻ chính thức là 599 USD, mức giá gọi vốn Early Bird là 399 USD, mức ưu đãi dành riêng cho cộng đồng LALAL.AI là 349 USD, lô sản phẩm đầu tiên dự kiến sẽ bắt đầu giao hàng vào tháng 4 năm 2027.
Bản demo sản phẩm: https://youtu.be/BIc-Y5iDVeQ?si=ooczG3griFQW2faK
Mirelo ra mắt SFX 2.0, hỗ trợ âm thanh liền mạch cho video dài và fine-tune từng track
Ngày 14 tháng 10, đội ngũ âm thanh tạo sinh Mirelo chính thức phát hành model hiệu ứng âm thanh đa phương thức (multimodal) Mirelo SFX 2.0 . Khắc phục các điểm nghẽn trước đây khi lồng tiếng video như dễ bị lẫn nhạc nền lộn xộn, hay việc sửa âm thanh buộc phải render lại toàn bộ khung hình, model mới đã cải tiến có định hướng ở tính năng “tự động tạo âm foley theo chuyển động hình ảnh” và “giữ lại thoại trong trẻo”.
Trong bài kiểm tra nghe mù đôi dành cho giới chuyên môn, SFX 2.0 đạt tỷ lệ ưa chuộng 81% khi so sánh với Sony Woosh, đồng thời chất lượng âm thanh cũng vượt trội hơn so với âm thanh đầu ra gốc của các model như Veo 3.1 Fast, MiniMax H3 Max và Kling.
Các tính năng cốt lõi cụ thể của phiên bản này bao gồm:
- Giữ lại thoại gốc và né âm động : Tự động lọc bỏ nhạc nền sẵn có và tạp âm nền hỗn loạn trong video, giữ lại trọn vẹn dry vocal của lời thoại; khi nhân vật cất tiếng nói, hệ thống sẽ tự động hạ nhỏ âm thanh nền (Ducking), tránh để âm thanh môi trường lấn át lời thoại.
- Tự động tạo âm foley khớp nhịp chuyển động khung hình : Sau khi tải lên video bản dựng thô, hệ thống có thể tự động suy luận tiếng bước chân, va chạm và âm thanh môi trường, căn chỉnh chính xác đến từng mili-giây theo các điểm chuyển động trên khung hình, giảm đáng kể khối lượng công việc tìm kiếm tư liệu thủ công và ghép âm thanh từng track.
- Trường âm liền mạch xuyên cảnh quay cho video dài : Sở hữu năng lực context memory xuyên storyboard, hỗ trợ xử lý video dài tối đa 10 phút trong một lần chạy, duy trì ổn định không khí của cảnh và âm sắc của chủ thể cụ thể khi chuyển góc máy, tránh hiện tượng đứt gãy âm thanh do nhảy cảnh.
- Tách track và vẽ lại âm thanh cục bộ : Cung cấp chế độ chỉnh sửa tách track và sửa đổi theo văn bản, cho phép thu bổ sung hoặc vẽ lại riêng biệt cho âm thanh của một khung cảnh cụ thể mà không cần phải hủy bỏ toàn bộ track âm thanh để tạo lại.
Về mặt triển khai thực tế, Mirelo SFX 2.0 hiện đã có mặt trên nền tảng Web chính thức, giao diện API và MCP, đồng thời được tích hợp đồng bộ vào Runway và Fal; thời gian tới hãng cũng sẽ ra mắt plugin mở rộng dựng phim tương thích với Premiere Pro và DaVinci Resolve. Model hỗ trợ ba chế độ gọi gồm tạo nhạc trực tiếp từ video, mô tả hoàn toàn bằng văn bản và tách track độc lập; chế độ thông thường hỗ trợ render thành phẩm tối đa 10 phút mỗi lần, còn gói doanh nghiệp cho phép bỏ giới hạn thời lượng.
Đường dẫn trực tiếp: https://mirelo.ai
Chi tiết: https://mirelo.ai/blog/mirelo-sfx-2-0
Suno ra mắt không gian làm việc chia sẻ nhóm và tính năng cộng tác model tùy chỉnh
Ngày 15 tháng 10, nền tảng âm nhạc AI Suno chính thức ra mắt “ Chia sẻ không gian làm việc ” (Shareable Workspaces) và “ Model tùy chỉnh có thể chia sẻ ” (Shareable Custom Models) - hai tính năng cộng tác nhóm lớn.
Các tính năng cốt lõi cụ thể bao gồm:
- Quản lý cộng tác dự án nhóm : Cho phép mời các thành viên trong đội ngũ sản xuất vào không gian làm việc riêng biệt, tập trung lưu trữ các đoạn âm thanh được tạo rải rác, lịch sử prompt và bản thảo lời bài hát, đồng thời hỗ trợ nhiều người cùng nghe thử và chỉnh sửa.
- Chia sẻ model phong cách riêng biệt : Hỗ trợ chia sẻ model phong cách tùy chỉnh đã tinh chỉnh cho người cộng tác chỉ với một cú nhấp chuột, giúp đảm bảo phong cách âm nhạc chủ đạo và chất âm được đồng nhất khi sản xuất toàn bộ album hoặc dự án quy mô lớn.
- Dung lượng tham chiếu fine-tune tăng gấp đôi : Dung lượng đầu vào tham chiếu của model tùy chỉnh được nâng lên gấp 2 lần so với trước đây, hỗ trợ nhập tư liệu tham khảo phong phú hơn để nâng cao độ chính xác khi nắm bắt phong cách và giảm chi phí tinh chỉnh prompt.
- Phân quyền đa cấp và bảo vệ tài sản : Hỗ trợ phân quyền "Chỉ nghe thử/duyệt" hoặc "Toàn quyền chỉnh sửa" theo vai trò của thành viên, đảm bảo tính an toàn cho tài sản âm thanh cốt lõi trước khi chính thức phát hành và bàn giao.
Ngoài ra, hai tính năng cộng tác này hiện áp dụng chính sách gói đăng ký theo cấp bậc: "Không gian làm việc chia sẻ" mở cho người dùng gói Pro và Premier; còn "Chia sẻ model tùy chỉnh" cùng dung lượng fine-tune gấp 2 lần là đặc quyền dành riêng cho người dùng gói Premier cao cấp nhất. Các track âm thanh được tạo ra từ sự cộng tác trong không gian làm việc nhóm hoàn toàn kế thừa quyền cấp phép thương mại tương ứng với cấp độ tài khoản. Hiện tính năng này đã chính thức ra mắt trên phiên bản Suno Web.
Đường dẫn trực tiếp: https://suno.com
Bộ công cụ sản xuất âm nhạc cục bộ mã nguồn mở Plenio 1.0 dựa trên ComfyUI chính thức ra mắt
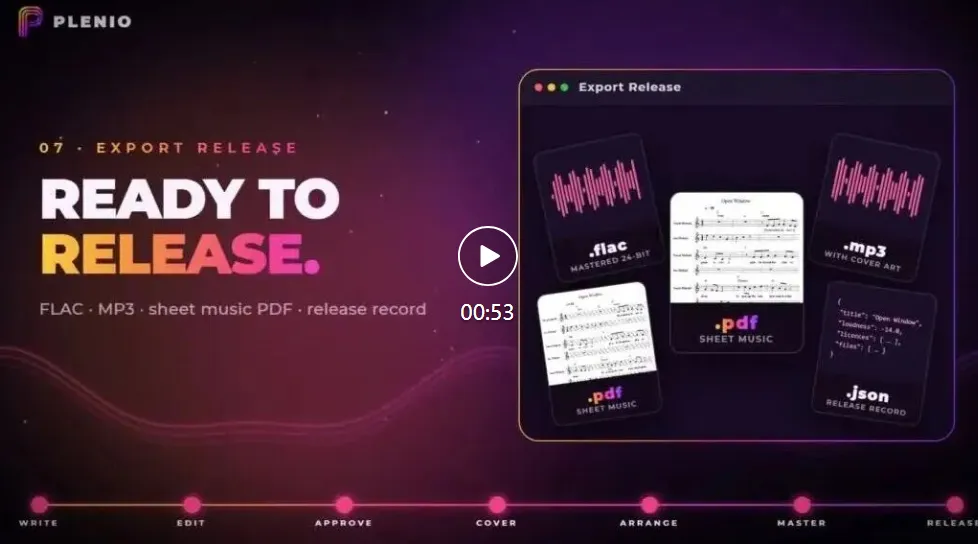
Vào ngày 16 tháng 10, bộ công cụ workflow âm thanh mã nguồn mở Plenio đã chính thức phát hành phiên bản 1.0. Hệ thống này được xây dựng dựa trên các node ComfyUI, không cần phụ thuộc vào sức mạnh tính toán đám mây hay gọi API key trả phí, có thể chạy độc lập trong môi trường GPU cục bộ, tích hợp toàn bộ từ viết lời, sáng tác, xử lý mastering đa track đến phát nhạc trực quan thành một workflow âm nhạc cục bộ hoàn chỉnh.
Về mặt tích hợp tính năng, Plenio 1.0 tập trung kết nối liền mạch toàn bộ quy trình từ khâu tạo model tầng dưới đến xuất bản master cuối cùng, với các tính năng cốt lõi bao gồm:
- Sáng tạo cục bộ end-to-end : Hỗ trợ gọi mô hình ngôn ngữ lớn (LLM) cục bộ (như Gemma hoặc các model GGUF khác nhau) để viết lời và lập kế hoạch sản xuất, sau đó chuyển giao cho YuE2-3B hoặc MiniMax Music 3 để hoàn thiện phần hát và phối khí.
- Tích hợp sẵn mixing và mastering : Tích hợp cân chỉnh đa track, cân bằng EQ và kiểm soát độ lớn âm thanh (tuân thủ tiêu chuẩn ngành -14 LUFS / -1 dBTP), hỗ trợ xuất file âm thanh lossless như FLAC 24-bit, WAV kèm ảnh bìa và metadata, cùng bản phổ nhạc định dạng PDF.
- Trình phát Web độc lập và theo dõi nốt nhạc trên phổ : Bổ sung trình phát chuyên dụng có thể chạy thường trực trên trình duyệt độc lập với ComfyUI, hỗ trợ lọc thư viện bài hát đa chiều, lời bài hát karaoke theo từng chữ, theo dõi nốt nhạc trên khuông nhạc theo thời gian thực và tích hợp 13 hiệu ứng trực quan hóa âm thanh.
- Xuất và chia sẻ nhanh chóng ở nhiều định dạng : Hỗ trợ đóng gói trực tiếp âm thanh, metadata và trình phát tương tác thành một file HTML offline duy nhất, giúp người nhận có thể nhấp đúp để nghe offline ngay lập tức; đồng thời hỗ trợ render và xuất video MP4 4K khung hình ngang hoặc dọc kèm lời bài hát động chỉ với một cú nhấp chuột.
Hiện tại, Plenio 1.0 đã chính thức có mặt trên registry node chính thức của ComfyUI, hoàn toàn miễn phí và tuân thủ giấy phép mã nguồn mở. Hệ thống không yêu cầu cấu hình môi trường bổ sung phức tạp, các card đồ họa tầm trung phổ biến đã có thể vận hành trực tiếp các model tạo sinh cốt lõi trên máy cục bộ một cách mượt mà.
Đường dẫn truy cập: https://comfyui-wiki.com/en/news/2026-10-16-plenio-1-0
Grok Imagine ra mắt tính năng tạo nhạc Grok Music: Kết nối liền mạch nhạc nền video và chỉnh sửa audio track
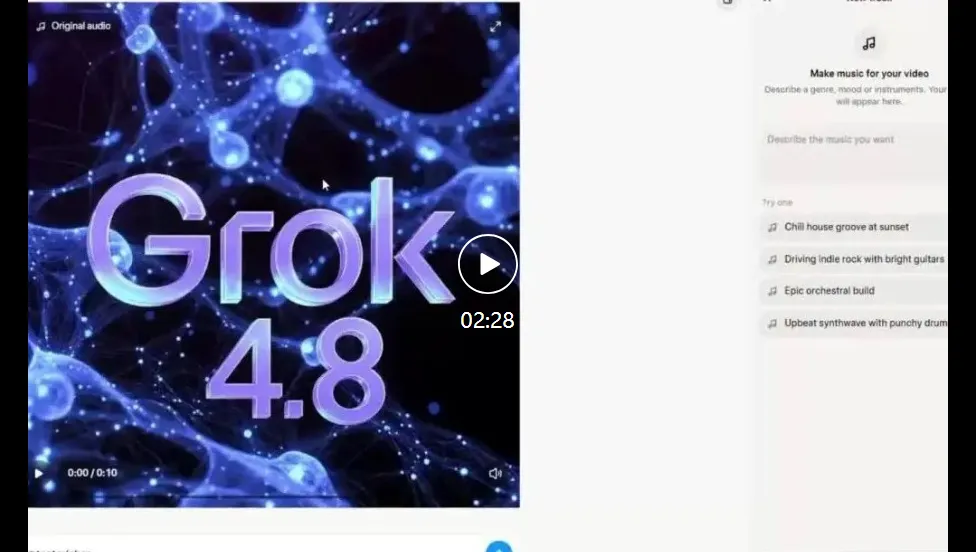
Gần đây, công cụ sáng tạo đa phương thức (multimodal) Grok Imagine thuộc Grok đã chính thức ra mắt tính năng tạo âm nhạc Grok Music , hỗ trợ người dùng tạo và tùy chỉnh trực tiếp nhạc nền phù hợp khi sản xuất video AI.
Các điểm nổi bật cốt lõi của tính năng này bao gồm:
- Được vận hành bởi model Lyria 3 : Tầng dưới tích hợp model âm thanh Lyria 3 của Google, người dùng có thể tự do chỉ định thể loại nhạc, hướng phát triển nhịp điệu và phong cách phối khí thông qua prompt để tạo ra bản nhạc nền hoàn chỉnh khớp với khung hình.
- Đồng bộ âm thanh - hình ảnh và cắt ghép đoạn nhạc : Ngoài việc hỗ trợ thêm nhạc nền chỉ với một cú nhấp chuột cho video mới tạo, tính năng còn cho phép thay thế trực tiếp track âm thanh của video hiện có. Người dùng cũng có thể cắt gọt âm thanh đã tạo ngay trong giao diện để lấy đoạn khớp nhất với nhịp độ khung hình video.
- Tự động lưu trữ và tái sử dụng trong thư viện nhạc : Tất cả các track âm thanh đã tạo đều sẽ tự động lưu vào thư viện cá nhân (Library), thuận tiện cho việc trích xuất, fine-tune lại bất kỳ lúc nào và tái sử dụng cho các project video khác.
Sự xuất hiện của Grok Music giúp các nhà sáng tạo hoàn thành quy trình "tạo hình ảnh, phối nhạc nền và fine-tune cơ bản" ngay trên một nền tảng duy nhất, giảm bớt các thao tác xuất file qua lại giữa nhiều công cụ và căn chỉnh âm thanh - hình ảnh phức tạp.
Đường dẫn truy cập: https://grok.com/imagine
Nền tảng âm nhạc AI Treblo phát hành nhiều bản cập nhật mới
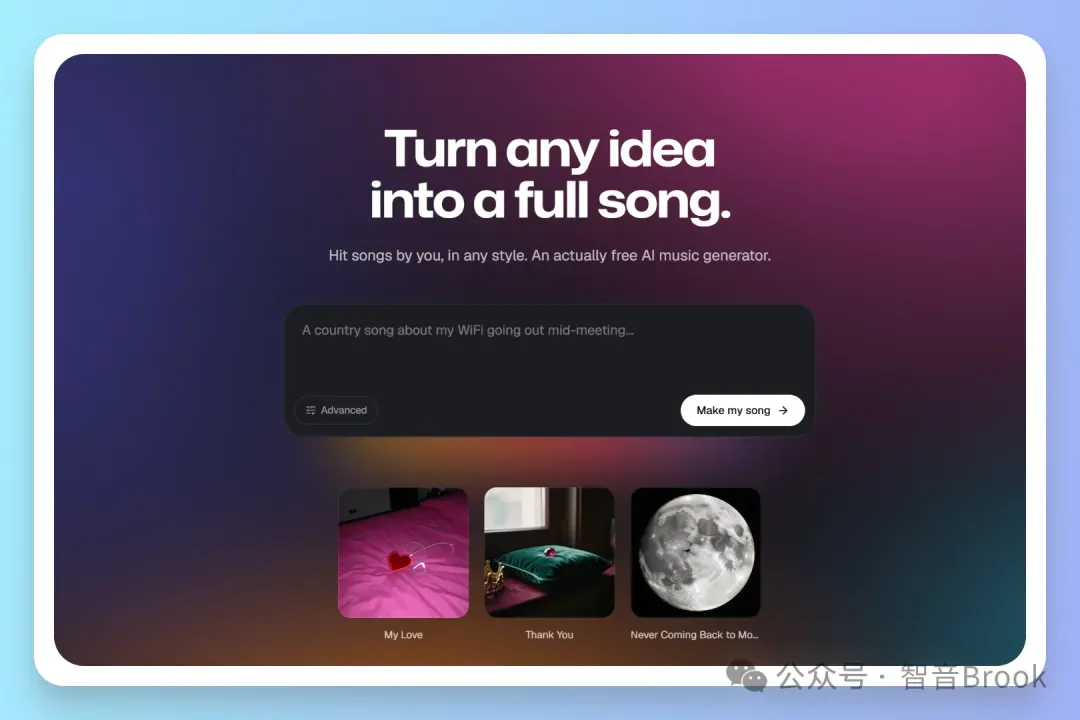
Vào ngày 17 tháng 10, nền tảng âm nhạc AI Treblo đã chính thức ra mắt giao diện tương tác hoàn toàn mới, đồng thời phát hành ứng dụng di động trên cả hai hệ điều hành iOS và Android, cũng như mở đợt thử nghiệm nội bộ cho công cụ tạo lời bài hát thử nghiệm mang mã hiệu "Secret Lyrics Project".
Đồng thời, nền tảng cũng đã hoàn tất quá trình tinh chỉnh âm học cho model chủ lực v3-preview, tập trung khắc phục các sự cố thường gặp trước đây khi tạo nhạc như phát âm không rõ lời, trôi cao độ và giai điệu còn gượng gạo.
Bản cập nhật lần này giải quyết các vấn đề nan giải như ca từ rập khuôn và trải nghiệm tương tác bị phân mảnh, với những cải tiến cốt lõi bao gồm:
- Giảm thiểu sáo rỗng và ca từ rập khuôn : Kích hoạt nền tảng văn bản hoàn toàn mới trong "Secret Lyrics Project", tập trung ức chế các hình tượng trùng lặp tần suất cao, giảm đáng kể các cụm từ công thức như "đèn neon", "bàn ăn trống", từ đó nâng cao tính đa dạng và cách biểu đạt độc đáo của ca từ.
- Tái cấu trúc phong cách và hòa âm phối khí : Bổ sung tính năng chuyển soạn thử nghiệm, hỗ trợ thay thế nhạc cụ phối khí và thể loại phong cách cho các bản nhạc hiện có chỉ với một cú nhấp chuột, giúp nhanh chóng khám phá các cách phối khí phong cách khác nhau.
- Chế độ kiểm âm toàn màn hình trên máy tính : Bổ sung giao diện phát toàn màn hình trên bản desktop, kết hợp với cơ chế phát mượt mà liên tục, giúp các nhà sáng tạo đắm chìm kiểm tra chất lượng âm học và chi tiết bản mix của tác phẩm.
- Lên ý tưởng mọi lúc mọi nơi trên thiết bị di động : Tối ưu hóa việc viết prompt và luồng thao tác trên thiết bị di động, giúp các nhạc sĩ thuận tiện ghi lại cảm hứng mọi lúc mọi nơi và nhanh chóng tạo âm thanh nghe thử.
Hiện tại, cả giao diện Web mới và ứng dụng di động đều đã sẵn sàng để trải nghiệm. Đại diện nền tảng cho biết, "Secret Lyrics Project" vẫn đang trong giai đoạn thử nghiệm công khai, hiện tượng thỉnh thoảng trôi ngôn ngữ hoặc nuốt lời sẽ được khắc phục trong các phiên bản tiếp theo. Sắp tới, nền tảng cũng sẽ lần lượt ra mắt các tính năng nâng cao như clone giọng nói (Voices), chuyển đổi giọng hát thành project full mix (Voice to full mix) và tham chiếu phong cách.
Đường dẫn truy cập: https://treblo.com/
Paper chọn lọc
Dưới đây là 5 bài báo khoa học nổi bật được chọn lọc từ ngày 13 tháng 10 đến ngày 19 tháng 10, mời bạn đón đọc
MSVAE: Đánh giá lại ngữ nghĩa âm nhạc trong không gian tiềm ẩn liên tục
Tác giả : Guobin Ma, Yuepeng Jiang, Dake Guo, Huakang Chen, Yuan Zhou, Lingxin Xiong, Wenkai Cheng, Jingbin Hu, Hanke Xie, Chunbo Hao, Wenhao Li, Ziqian Ning, Jixun Yao, Jian Zhao, Zhonglin Jiang, Yong Chen, Lei Xie, Pengcheng Zh
Tóm tắt : Biểu diễn tiềm ẩn liên tục là nền tảng của các hệ thống chuyển lời bài hát thành bài hát (Lyrics-to-Song) và văn bản thành âm nhạc (Text-to-Music) dựa trên mô hình khuếch tán gần đây. Tuy nhiên, việc căn chỉnh điều kiện lời bài hát với các biểu diễn tiềm ẩn này vẫn còn rất nhiều thách thức: các hệ thống hiện tại thường phải dựa vào những thiết kế phức tạp ở phía generator (chẳng hạn như timestamp cấp câu, mục tiêu căn chỉnh phụ trợ hoặc giải mã bán tự hồi quy), trong khi các đặc trưng tiềm ẩn mà chúng dự đoán vẫn được sinh ra bởi các autoencoder chỉ nhắm thuần túy vào mục tiêu tái tạo. Chúng tôi tiếp cận giải quyết bài toán này từ phía biểu diễn bằng cách đề xuất Variational Autoencoder ngữ nghĩa âm nhạc (MSVAE). Model này xây dựng các đặc trưng tiềm ẩn liên tục xoay quanh hai luồng ngữ nghĩa bổ trợ cho nhau: nội dung sáng tác/phối khí ở cấp độ tác phẩm, và nội dung ngôn ngữ cùng giọng hát ở cấp độ ca từ. Cơ chế căn chỉnh hai luồng phân vùng làm tường minh hóa hai luồng ngữ nghĩa này bằng cách căn chỉnh các không gian con tiềm ẩn rời nhau với lead-sheet và tham chiếu nhận dạng giọng nói tự động (ASR) đã đóng băng; đồng thời, cơ chế hậu nghiệm phần dư có cổng "ưu tiên ngữ nghĩa" lấy encoder học tự giám sát (SSL) âm nhạc đã đóng băng làm nền tảng, và chỉ đưa thông tin âm học vào thông qua hiệu chỉnh có cổng giới hạn. So với các model baseline autoencoder liên tục, MSVAE đạt được hiệu năng tái tạo âm thanh stereo có tính cạnh tranh cao cùng kết quả probe MARBLE mạnh mẽ hơn, đồng thời cải thiện đáng kể hiệu năng của các tác vụ hạ nguồn như Lyrics-to-Song và Text-to-Music. Đáng chú ý là trong điều kiện chỉ cung cấp tiền tố âm vị không có timestamp và không có bất kỳ thông tin thời gian nào của ca từ, MSVAE vẫn đạt được tỷ lệ lỗi âm vị (PER) thấp nhất, trong khi tất cả các biểu diễn baseline đều cần căn chỉnh cấp câu mới có thể tạo ra giọng hát rõ ràng, dễ phân biệt.
bài báo : https://arxiv.org/abs/2610.17187
AnyEdit: Framework thống nhất cho việc chỉnh sửa giọng nói và tiếng hát đảm bảo tính nhất quán của môi trường thực tế
Tác giả : Yunjia Zhang, Junan Zhang, Jing Yang, Xueyao Zhang, Fan Fan, Zhizheng Wu
Tóm tắt : Chúng tôi giới thiệu AnyEdit, một framework thống nhất không cần tách nguồn âm (Separation-Free) để chỉnh sửa giọng nói và tiếng hát, có khả năng giữ nguyên vẹn môi trường âm học trong thế giới thực (bao gồm tiếng ồn, độ vang và nhạc nền). Mặc dù các model tạo sinh thống nhất gần đây đã đạt được kết quả ấn tượng về việc tạo giọng nói và tiếng hát trong môi trường sạch, việc chỉnh sửa giọng hát trong các tình huống phức tạp ở thế giới thực vẫn đầy thách thức, bởi model khi sửa đổi nội dung phải đồng thời duy trì được danh tính người nói/người hát, ngữ điệu cũng như bối cảnh âm học xung quanh. Việc mô hình hóa trực tiếp end-to-end âm thanh có lẫn tạp âm sẽ khiến việc chỉnh sửa ngữ nghĩa bị đan xen với âm học môi trường, từ đó làm suy giảm năng lực tạo giọng hát cốt lõi. Vì vậy, chúng tôi áp dụng thiết kế hai giai đoạn: vừa bảo toàn khả năng chỉnh sửa trong miền âm thanh sạch, vừa trì hoãn quá trình kết xuất âm học sang một giai đoạn độc lập. Đầu tiên, một editor tự hồi quy theo chỉ dẫn sẽ dự đoán token phong cách nội dung và ngữ điệu sạch nhờ sự hỗ trợ của bộ tokenizer ngữ điệu kháng ồn theo kiến trúc giáo viên - học sinh, bộ tokenizer này có thể trích xuất các token ngữ điệu sạch từ các bản thu âm kém chất lượng; tiếp đó, model âm học dựa trên Flow-Matching sẽ lấy context âm học của âm thanh gốc làm điều kiện để render in-context, giúp đoạn âm thanh sau chỉnh sửa thừa hưởng được tiếng ồn, độ vang và nhạc nền xung quanh, đồng thời duy trì âm sắc nhất quán của người phát âm. Để ổn định các vùng không chỉnh sửa, chúng tôi đưa vào cơ chế giám sát nhận biết vùng chưa sửa đổi; sau khi hoàn tất tiền huấn luyện, phương pháp Tối ưu hóa tùy chọn trực tiếp (DPO) tiếp tục được áp dụng trên dataset bài hát thực tế dạng cặp đã thu thập. Ngoài ra, chúng tôi cũng mã nguồn mở AnyEditBench, một benchmark đánh giá bao gồm việc chỉnh sửa giọng nói và tiếng hát trong các điều kiện âm học sạch, mô phỏng và phức tạp trong thực tế. Các thử nghiệm trên dataset giọng nói và tiếng hát tiếng Trung cùng tiếng Anh cho thấy, trong môi trường có tiếng ồn và độ vang, AnyEdit vượt trội rõ rệt so với các baseline mạnh về độ chính xác nội dung, chất lượng cảm thụ chủ quan cũng như tính nhất quán của nền âm thanh.
bài báo : https://arxiv.org/abs/2610.15665
Point-and-Play: Clone âm sắc nhạc cụ trực tiếp từ bản mix âm nhạc
Tác giả : Baotong Tian, Zhiyao Duan
Tóm tắt : Bộ tổng hợp nhạc cụ neural có khả năng clone âm sắc của nhạc cụ độc tấu, cho phép các nhà sản xuất âm nhạc sáng tác bằng những âm thanh mong muốn. Tuy nhiên, nhạc cụ mục tiêu thường bị lẫn vào trong các bản thu âm phức tạp gồm nhiều nhạc cụ đã hoàn thiện sản xuất, vượt quá khả năng xử lý của các phương pháp hiện có. Thực hiện tách nguồn âm trước khi clone âm sắc là một hướng đi, nhưng điều này có thể dẫn đến các dị vật âm thanh (artifacts) do việc phân tách, đồng thời có thể là một con đường vòng không cần thiết cho tác vụ này. Trong công trình này, chúng tôi đề xuất Point-and-Play, một hệ thống có khả năng clone trực tiếp âm sắc của nguồn âm thanh được chỉ định (Cued Source) từ bản mix âm nhạc phức điệu, sau đó dùng âm sắc đó để tổng hợp âm nhạc với cao độ và cường độ hoàn toàn mới. Để đạt được mục tiêu này, chúng tôi đưa vào module pooling thống kê có cổng chỉ định (CGSP) nhằm trích xuất mã hóa âm sắc của nhạc cụ chỉ định từ CLAP embedding của bản nhạc mix đã được điều chỉnh thích ứng. Mã hóa âm sắc được trích xuất này sau đó kết hợp với đầu vào cao độ và cường độ, cùng đóng vai trò làm điều kiện để dẫn hướng cho bộ tổng hợp nốt nhạc được huấn luyện độc lập. Các thử nghiệm cho thấy, về độ trung thực của âm sắc và chất lượng tổng hợp, hệ thống được đề xuất của chúng tôi vượt trội hơn so với phương pháp baseline "tách trước rồi clone sau", đạt hiệu năng tương đương với việc clone từ nhạc cụ độc tấu sạch.
bài báo : https://arxiv.org/abs/2610.19445
Qwen-Audio-Jev: Giao diện thống nhất cho việc ra quyết định dựa trên âm thanh
Tác giả : Ying Fang, Zhifu Gao, Qing Gu, Jiajun He, Kangqi Jing, Xiangang Li, Yu Pu, Wupeng Wang
Tóm tắt : Các mô hình ngôn ngữ âm thanh lớn (LALM) đã đạt được những bước tiến dài trong lĩnh vực hiểu âm thanh. Tuy nhiên, trong các ứng dụng thông lượng cao đòi hỏi phải liên tục đưa ra lựa chọn, phán đoán và chấm điểm, quá trình sinh văn bản tự hồi quy lại tạo ra chi phí tính toán phụ trội và độ trễ phản hồi. Để giải quyết nút thắt này, chúng tôi ra mắt Qwen-Audio-Jev bằng cách bổ sung một decision head Jev chuyên dụng cho Qwen-Audio-3.1-ASR-Flash-Next, hợp nhất các thao tác lựa chọn, phán đoán nhị phân và chấm điểm liên tục thành ba nguyên ngữ quyết định (primitives): CHOICE (trắc nghiệm), NOUL (phán đoán nhị phân) và SCORE (chấm điểm). Với đầu vào gồm âm thanh, câu hỏi bằng ngôn ngữ tự nhiên cùng quy chuẩn câu trả lời rõ ràng, model sẽ trực tiếp xuất ra phân phối xác suất hoặc điểm số định lượng theo điều kiện nhiệm vụ thông qua cơ chế đọc quyết định định kiểu. 18 cấu hình đánh giá bao trùm cả ba nguyên ngữ quyết định này cho thấy: Ở nhiệm vụ CHOICE, Qwen-Audio-Jev đạt độ chính xác lần lượt là 78.70% và 84.06% trên MMAU-mini và MMSU; ở nhiệm vụ NOUL, model đạt tỷ lệ lỗi tương đương (EER) 6.50% trên benchmark xác thực người nói VoxCeleb1-O; ở nhiệm vụ SCORE, sai số tuyệt đối trung bình chuẩn hóa (NMAE) trong đánh giá chất lượng âm thanh tổng thể NISQA xuống thấp tới mức 0.1062, với hệ số tương quan Pearson và Spearman lần lượt đạt 0.8210 và 0.8074. So với Qwen-Audio-3.1-ASR-Flash-Next gốc, Qwen-Audio-Jev đã tăng tốc suy luận khoảng 20 lần, chứng minh tiềm năng to lớn trong các ứng dụng ra quyết định âm thanh thông lượng cao, hiệu năng cao như sàng lọc sơ bộ âm thanh quy mô lớn, xác thực giọng nói và tự động đánh giá chất lượng âm thanh.
bài báo : https://arxiv.org/abs/2610.21614v1
MIDI-REPA: Nâng cao khả năng tạo text-to-music dựa trên căn chỉnh biểu diễn ký hiệu
Tác giả : Song-Ze Yu, Fang-Duo Tsai, Yi-Hsuan Yang
Tóm tắt : Các model text-to-music tiên tiến nhất hiện nay ngày càng phụ thuộc vào việc cộng dồn dung lượng model, quy mô dữ liệu và sức mạnh tính toán, đồng thời vẫn học cấu trúc âm nhạc trực tiếp từ các dạng sóng âm thanh dày đặc. Tuy nhiên, giai điệu, tiết tấu, hòa âm và cấu trúc khúc thức hoàn toàn có thể được biểu diễn dưới dạng ký hiệu cô đọng. Vì vậy, chúng tôi đề xuất MIDI-REPA, một framework căn chỉnh biểu diễn sử dụng tín hiệu giám sát MIDI trích xuất từ phiên âm âm nhạc tự động (AMT) để căn chỉnh các biểu diễn đặc trưng trung gian của Flow-Matching Diffusion Transformer (Flow-Matching DiT). Dựa trên model baseline FluxAudio-S với 122M tham số trong thử thách học thuật text-to-music ICME 2026, chúng tôi đã nghiên cứu một cách có hệ thống về “căn chỉnh cái gì, căn chỉnh ở đâu và căn chỉnh khi nào”. Thực nghiệm phát hiện rằng, trong toàn bộ quỹ đạo dòng (flow trajectory), việc căn chỉnh biểu diễn piano roll từ MuScriptor với các tầng mạng ban đầu của DiT đem lại hiệu quả tốt nhất. Không cần thêm dữ liệu huấn luyện hay các kỹ thuật phức tạp khác, MIDI-REPA vẫn duy trì tính cạnh tranh vượt trội trên các chỉ số khách quan của ATTM, đồng thời chỉ mất khoảng 31 giờ huấn luyện trên một card RTX 3090 duy nhất. Kết quả nghiên cứu của chúng tôi chỉ ra rằng giám sát ký hiệu là một tín hiệu học tập đơn giản, chi phí thấp và hiệu quả, có thể tăng cường đáng kể chất lượng tạo text-to-music.
bài báo : https://arxiv.org/abs/2610.20967
Tài liệu tham khảo
https://blog.youtube/news-and-events/youtube-music-ai-labels/
https://www.digitalmusicnews.com/2026/10/16/sony-music-umg-lawsuit-vs-distrokid-ai-disclosure/
https://x.com/ai_lalal/status/2110028319865680294?s=20
https://guitarradar.news/gear/neko-puts-real-time-stem-separation-amp-modeling-and-recording-in-one-pocket-guitar-rig
https://x.com/MireloAI/status/2110360787780800611?s=20
https://x.com/suno/status/2110758226710978835?s=20
https://discord.com/channels/1069381916492562582/1083140371980234852/1560317907639083101
https://x.com/blankspeaker/status/2110031448279511111?s=20
https://x.com/testerlabor/status/2110018283357220966?s=20
https://discord.com/channels/1139691294176841859/1139691294915051693/1560812813704888370
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác