Link bài viết gốc: Top bài báo AI tiêu biểu trong tuần
DAIR.AI · X · @dair_ai · 2026-10-26 00:17
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
1. Object-Oriented Harness (Harness hướng đối tượng)
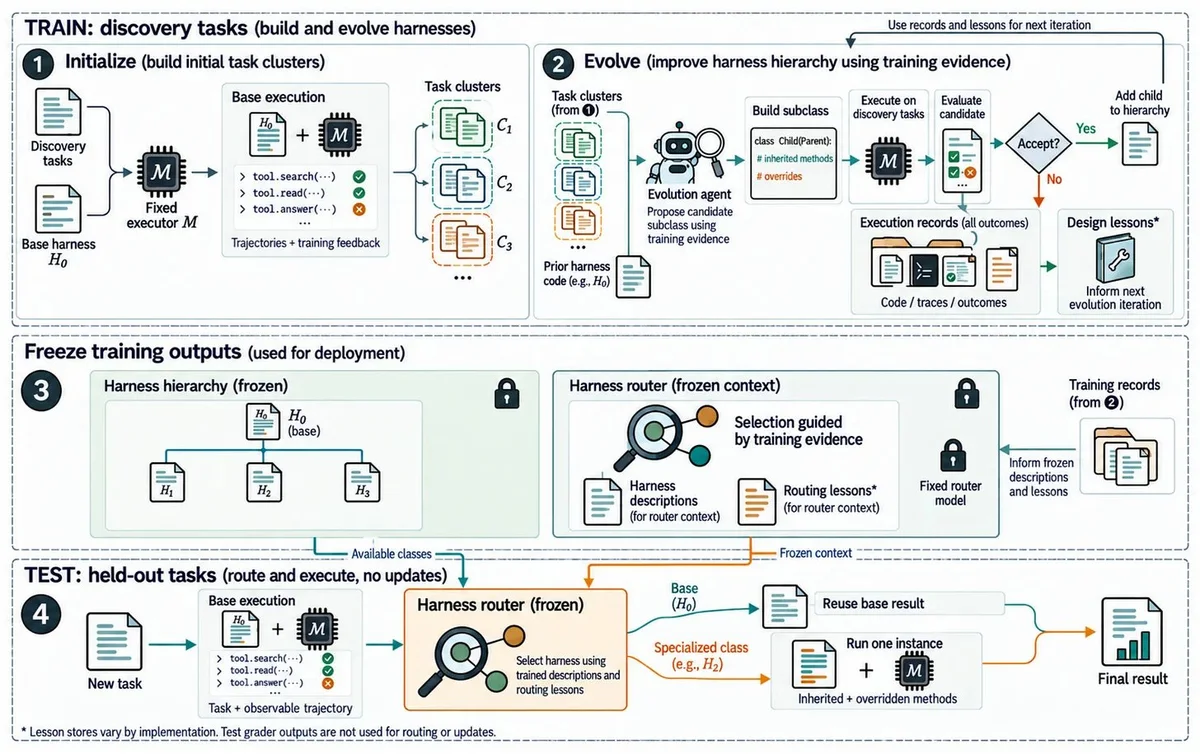
Harness của agent là một đoạn mã thực thi, dùng để thiết lập prompt, công cụ và luồng điều khiển bao quanh model; tuy nhiên, khi các tác vụ đòi hỏi những chiến lược thực thi khác nhau, một harness toàn cục duy nhất sẽ tỏ ra đuối sức. Các nhà nghiên cứu từ Google Cloud AI Research và Đại học Illinois Urbana-Champaign đã đề xuất OO-Harness, tận dụng thiết kế hướng đối tượng nhằm phát triển một hệ thống phân cấp lớp harness chuyên biệt.
- Hệ phân cấp lớp: Trong quá trình huấn luyện, một agent tiến hóa sẽ đọc các bản ghi thực thi để xây dựng nên một họ các harness chuyên biệt. Mỗi harness đều là lớp con của một harness cơ sở hoặc một harness chuyên biệt hiện có, đồng thời chỉ ghi đè những phương thức cần thiết cho cụm tác vụ của nó.
- Kinh nghiệm và định tuyến: Kinh nghiệm thiết kế ghi lại những thay đổi nào hữu ích và thay đổi nào thất bại. Khi kiểm thử, một bộ định tuyến sẽ đọc tác vụ cùng lượt chạy cơ sở, sau đó lựa chọn một lớp con hoặc giữ lại kết quả cơ sở dựa trên kinh nghiệm định tuyến thu thập được trong quá trình huấn luyện.
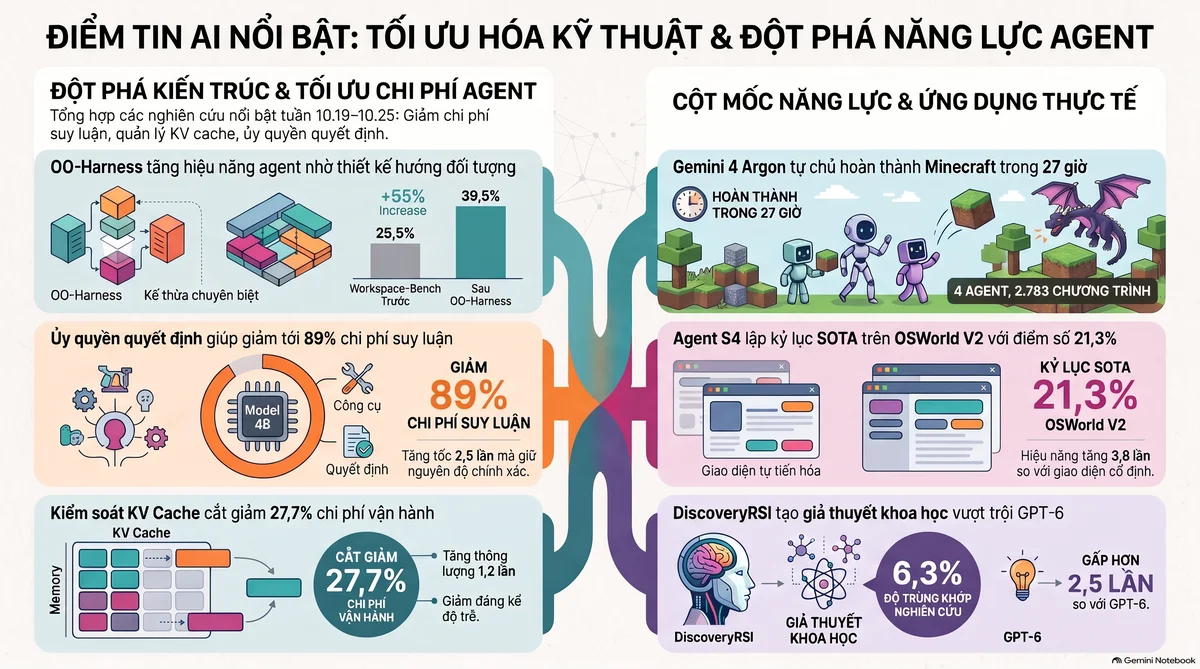
- Kết quả: Sử dụng cùng bộ thực thi Gemini 3.5 Flash, AutomationBench tăng từ 61,6% lên 77,4%, Workspace-Bench tăng từ 25,5% lên 39,5%, và tỷ lệ vượt qua nghiêm ngặt trên Toolathlon-GYM tăng từ 31,2% lên 37,5%. OO-Harness đã đánh bại Meta-Harness trên cả ba benchmark, trong khi việc tiêu tốn thêm suy luận cho lấy mẫu best-of-K hoặc tự tinh chỉnh không mang lại sự cải thiện đáng tin cậy.
- Vì sao điều này quan trọng: Bản thân tính kế thừa đã mang lại giá trị. Trên Workspace-Bench, harness được xây dựng dưới dạng lớp con đạt điểm cao hơn 4,96 điểm so với việc sao chép cùng một đoạn mã tiến hóa vào một lớp phẳng, điều này mang lại cho các đội ngũ xây dựng harness cho khối lượng công việc hỗn hợp một lý do cụ thể để chuyên biệt hóa, thay vì cố mở rộng một harness toàn cục.
bài báo | Bài viết gốc
2. Gemini Agents Beat Minecraft (Agent Gemini đánh bại Minecraft)
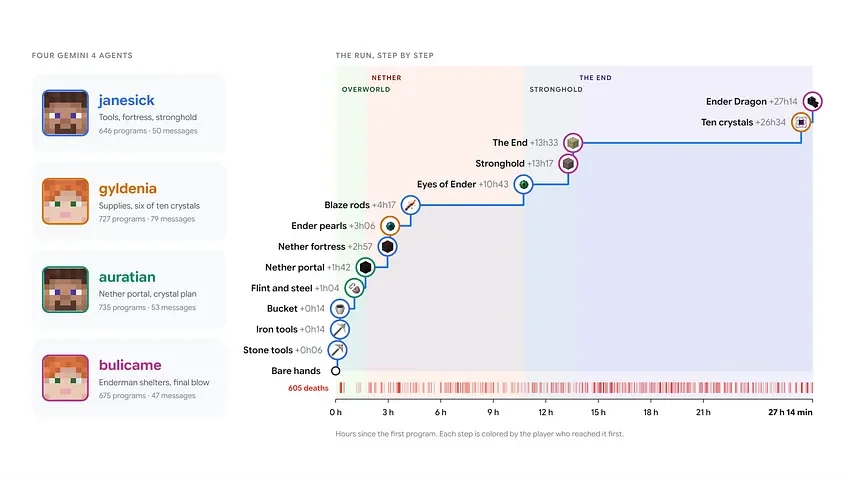
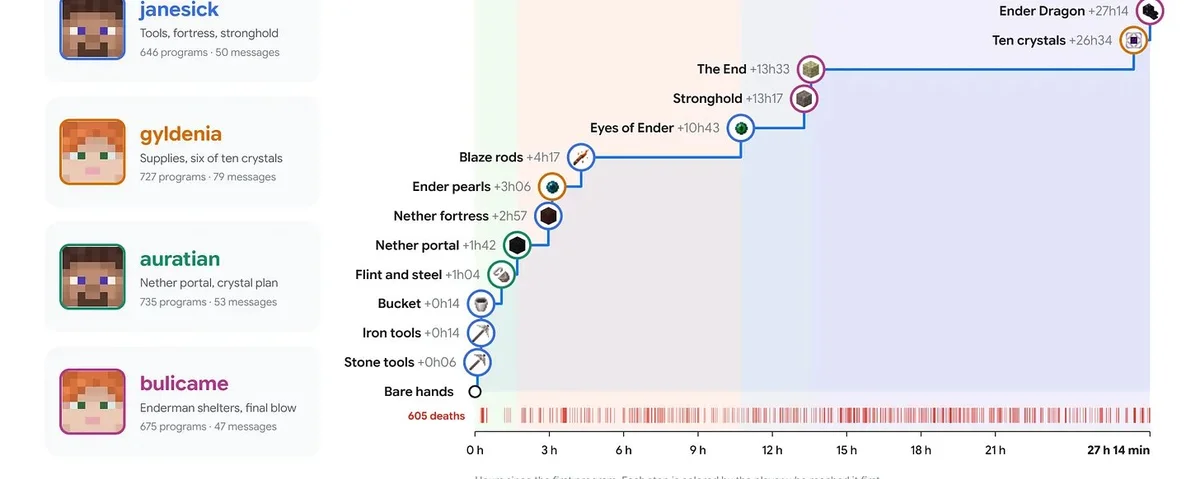
Các nhà nghiên cứu từ Google DeepMind đã đưa bốn agent Gemini 4 Argon vào một thế giới sinh tồn Minecraft được đóng sandbox với mục tiêu duy nhất: tiêu diệt Rồng Ender. Họ báo cáo đây là lần đầu tiên agent AI hoàn thành Minecraft tự chủ từ đầu đến cuối, chỉ sử dụng thư viện Mineflayer tiêu chuẩn mà không cần seed được thăm dò trước hay các công cụ dành riêng cho game do con người viết sẵn.
- Bối cảnh: Mỗi agent điều khiển một người chơi thông qua Mineflayer và phối hợp với đồng đội qua tính năng chat trong game cùng memory dùng chung. Không có con người phân vai hay viết logic game, các agent tự lên kế hoạch, lập trình và debug từng chương trình.
- Quá trình vận hành: Bắt đầu ở độ khó Dễ trong một thế giới ngẫu nhiên, nhóm agent đã viết 2.783 chương trình, chết 605 lần và tiêu diệt được rồng trong 27 giờ 14 phút. Các nhà nghiên cứu theo dõi qua bảng điều khiển thời gian thực và chưa từng phải can thiệp.
- Chiến lược đội nhóm: Các agent phân chia công việc và phối hợp, chia sẻ kiến thức học được và thu hồi vật phẩm giúp đồng đội khi họ chết. Một agent quan sát thứ năm theo dõi toàn bộ phiên chơi để kiểm tra xem có hành vi gian lận hay luồn lách đặc tả hay không, và kết quả là không phát hiện trường hợp nào.
- Vì sao điều này quan trọng: Chiến thắng đòi hỏi phải duy trì một kế hoạch nhất quán qua hàng nghìn bước phụ thuộc lẫn nhau trong suốt hơn một ngày, đây chính là năng lực lập trình và phối hợp dài hạn mà các tác vụ phần mềm thực tế cũng như doanh nghiệp đòi hỏi. Các tác giả cũng chỉ rõ những hạn chế: chỉ thử nghiệm một lượt chạy duy nhất, Mineflayer làm lộ trạng thái game bị ẩn, độ khó ở mức Dễ, và model vốn đã có kiến thức sẵn về Minecraft.
bài báo | Bài viết gốc
3. DiscoveryRSI
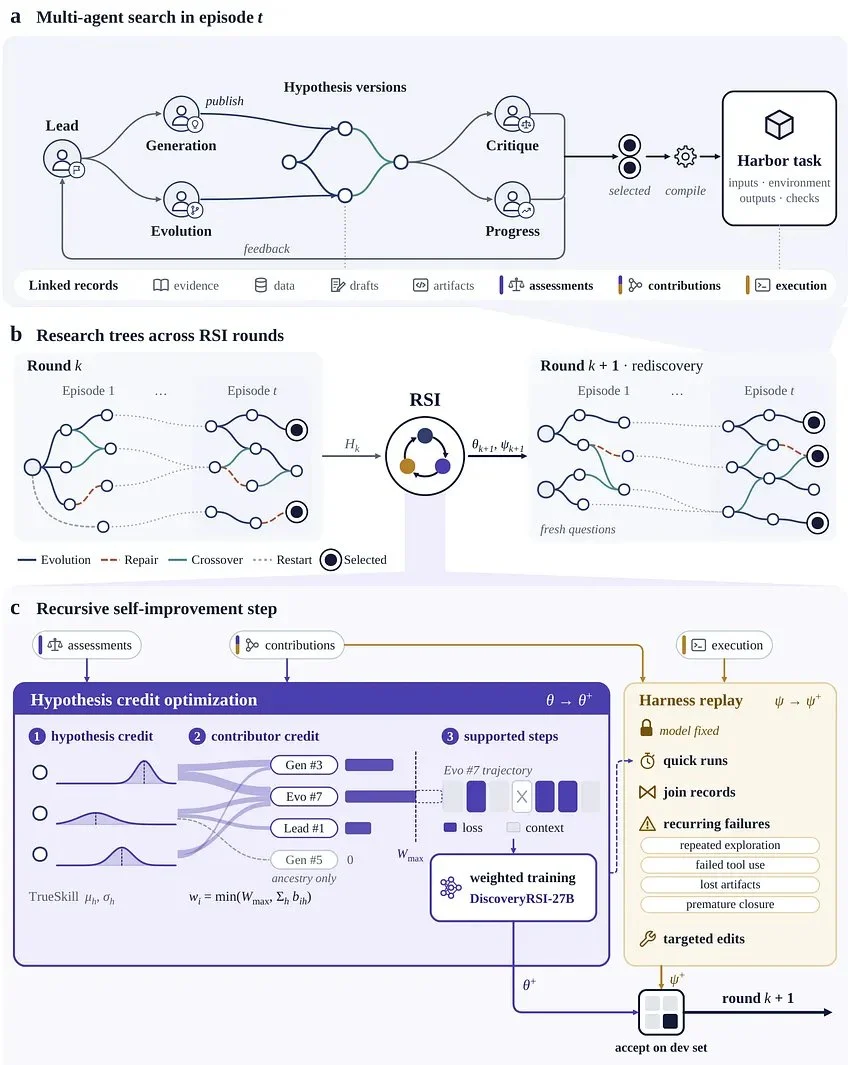
Phát kiến khoa học phụ thuộc vào việc chuyển hóa các giả thuyết có giá trị thành nghiên cứu thực tế, nhưng việc học hỏi từ quy trình nghiên cứu không ngừng tiến hóa này là rất khó khăn. Các nhà nghiên cứu từ PhAI Labs, Đại học Trung văn Hồng Kông, Đại học Stanford, Trường Y Harvard cùng đội ngũ cộng tác đã đề xuất DiscoveryRSI, ứng dụng khả năng tự cải tiến đệ quy vào việc tạo giả thuyết trong bốn lĩnh vực khoa học đời sống.
- Cây giả thuyết: Hệ thống này phát triển cây giả thuyết thông qua tìm kiếm tiến hóa đa agent và biên dịch các nghiên cứu được chọn thành các tác vụ Harbor có thể thực thi. Các tác giả định nghĩa một giả thuyết có giá trị là: một luận điểm có bằng chứng về một sự không chắc chắn quan trọng, đi kèm phương án nghiên cứu khả thi, tiêu chí ra quyết định rõ ràng và các cách giải thích thay thế.
- Ba cơ chế học hỏi: Tối ưu hóa ghi nhận đóng góp của giả thuyết quy kết các đánh giá khoa học cho những đóng góp nghiên cứu đằng sau nó. Harness replay sẽ phát hiện các chiến lược hiệu quả và các lỗi lặp đi lặp lại trong workflow nghiên cứu, còn việc tái phát hiện sẽ áp dụng các cải tiến đã được chấp nhận vào những nghiên cứu mới.
- Kết quả: Chất lượng giả thuyết tự động tăng từ 4,86 của model cơ sở lên 5,39 sau hai vòng tự cải tiến, trong đó cải thiện lớn nhất nằm ở khả năng kiểm chứng bác bỏ và khả năng giải quyết bằng dữ liệu. Tỷ lệ giả thuyết do model 27B tạo ra khớp với các nghiên cứu được công bố sau thời điểm chốt dữ liệu huấn luyện là 6,3%, trong khi GPT-6 là 2,5% và Claude Opus 5 là 2,3%.
- Vì sao điều này quan trọng: Đánh giá sơ bộ của chuyên gia nhận định DiscoveryRSI-27B vượt trội hơn GPT-6 Luna về tầm quan trọng của giả thuyết cũng như mức độ hợp lý và có căn cứ bằng chứng của các luận điểm. Bài báo cũng phát hành DFM-Bench để chấm điểm các giả thuyết, bản sửa đổi và toàn bộ lượt chạy nghiên cứu.
bài báo | Bài viết gốc
4. Cache Engineering for Agents (Kỹ thuật bộ nhớ đệm cho agent)
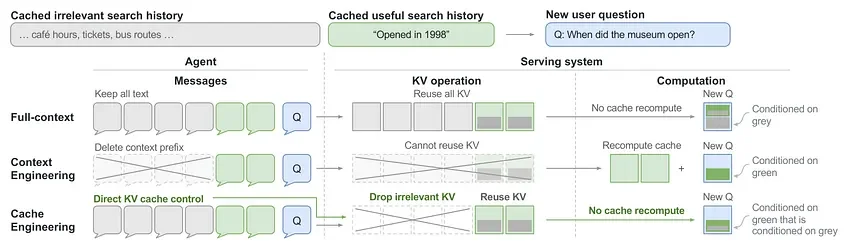
Khi quỹ đạo của agent ngày càng dài, I/O và dung lượng lưu trữ KV cache trở thành chi phí chiếm ưu thế. Context engineering cắt tỉa hoặc tóm tắt lịch sử, nhưng việc thay đổi tiền tố quỹ đạo sẽ làm mất hiệu lực của cache phía sau, và context được giữ lại buộc phải prefill lại. Các nhà nghiên cứu từ Đại học Thanh Hoa và Đại học Trung văn Hồng Kông đã đề xuất kỹ thuật bộ nhớ đệm, cho phép agent kiểm soát trực tiếp KV cache đang hoạt động của nó.
- Hai thao tác cache: Thao tác drop loại trừ các mục cache được chọn khỏi cơ chế attention trong tương lai, còn thao tác repos điều chỉnh mã hóa vị trí của các key còn lại. Văn bản quỹ đạo vẫn giữ nguyên, do đó chúng ta không cần phải prefill lại bất kỳ nội dung nào.
- Engine serving AKV: Cùng một chuỗi token dưới các chuỗi thao tác khác nhau có thể tạo ra các trạng thái cache khác nhau, vì vậy chỉ khớp tiền tố là không đủ để tái sử dụng cache một cách chính xác. AKV cung cấp một giao diện không trạng thái tương thích với các serving API hiện có, đồng thời quản lý có trạng thái việc tái sử dụng, loại bỏ và phục hồi ở bên trong.
- Kết quả: Việc loại bỏ lũy tiến các phản hồi cũ của công cụ giúp điểm trung bình cao hơn 1,7 điểm, và chi phí thấp hơn 27,7% so với việc tóm tắt kích hoạt theo ngưỡng. Sử dụng AKV, thông lượng đầu ra có thể đạt gấp 1,2 lần và độ trễ P95 nhanh hơn 1,5 lần.
- Vì sao điều này quan trọng: Việc tự cải tiến đệ quy chiến lược cache giúp giảm thêm 7,1% chi phí so với thiết kế của chuyên gia. Kiểm soát chi phí cho các agent chạy dài hạn có thể được thực hiện ngay tại tầng cache bên dưới prompt, và mã nguồn đã được mở.
bài báo | Bài viết gốc
5. JevAgentHarness
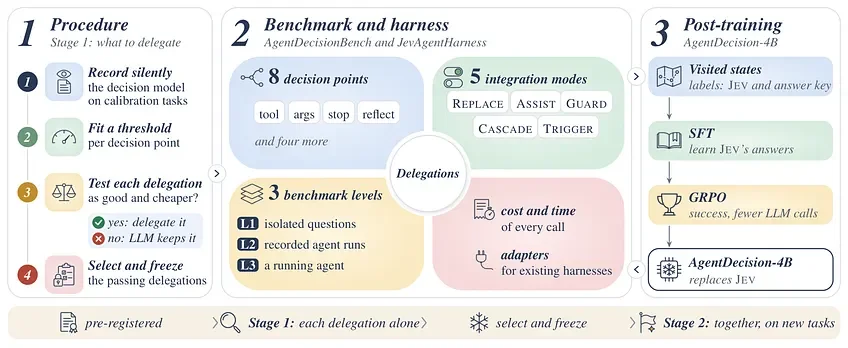
Harness của agent gọi LLM lớn ở mỗi bước khiến các tác vụ dài vừa chậm vừa tốn kém, tuy nhiên hầu hết các lệnh gọi này rốt cuộc chỉ nhằm đưa ra một quyết định trắc nghiệm nhiều lựa chọn, chẳng hạn như nên gọi công cụ nào tiếp theo. Các nhà nghiên cứu từ UIUC, Princeton và Google đã nghiên cứu cách thức harness có thể ủy quyền các lựa chọn này cho một model ra quyết định như Jev với mức giảm tỷ lệ thành công rất nhỏ.
- AgentDecisionBench: Benchmark này kiểm thử các model ra quyết định từ các câu hỏi độc lập cho đến việc kiểm soát agent đang chạy. Model chính xác nhất trên các câu hỏi độc lập chỉ giải quyết được 69,5% tác vụ agent, trong khi việc ủy quyền lựa chọn công cụ mà không fit ngưỡng độ tin cậy đã làm giảm tỷ lệ thành công tới 19,0 điểm phần trăm.
- Fit ngưỡng: JevAgentHarness gửi mỗi lựa chọn thông thường tới model ra quyết định, và chỉ sử dụng câu trả lời của nó khi độ tin cậy vượt qua ngưỡng được fit trên chính quỹ đạo của agent. Khi dưới ngưỡng, quyết định sẽ do LLM đưa ra. Sau khi áp dụng ngưỡng đã fit, cơ chế phân tầng công cụ và tham số đã giúp giảm 14,2% chi phí mà không làm thay đổi kết quả của bất kỳ tác vụ nào trong số 500 tác vụ.
- AgentDecision-4B: Các model ra quyết định hiện có chưa từng nhìn thấy các trạng thái mà agent rơi vào sau khi tự mắc lỗi, do đó các tác giả đã huấn luyện một model 4B mã nguồn mở trên các trạng thái này với câu trả lời của Jev đóng vai trò làm nhãn. Trên các tác vụ khác biệt với dữ liệu huấn luyện của nó, agent đã giải quyết được 91,5% bài toán khi dùng AgentDecision-4B, so với 82,0% khi dùng Jev.
- Vì sao điều này quan trọng: Trên các tác vụ tương đồng với dữ liệu huấn luyện, model 4B được huấn luyện theo phương pháp này đã giúp giảm chi phí của agent từ 81,1% đến 89,0%, tốc độ tăng tới 2,5 lần, trong khi tỷ lệ thành công của tác vụ vẫn duy trì trong biên độ chênh lệch dưới 3 điểm phần trăm.
bài báo | Bài viết gốc
6. Evolving Agent Interfaces (Giao diện agent tiến hóa)
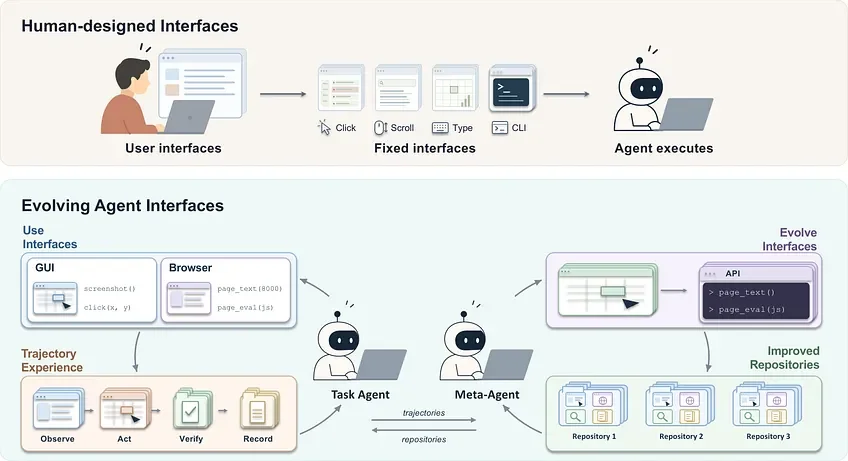
Các computer-use agent hoạt động thông qua các giao diện do con người thiết kế thủ công, do đó một agent có thể phải nhập liệu vào bảng tính từng ô một, trong khi chỉ cần một dòng code là hoàn thành. Các nhà nghiên cứu từ Simular đã đề xuất Agent S4, một nhà khoa học computer-use tự chủ có khả năng tự xây dựng giao diện từ chính kinh nghiệm thực hiện tác vụ của mình.
- Meta-agent: Một meta-agent kiểm tra quỹ đạo của agent tác vụ trên các tác vụ huấn luyện tổng hợp (không có nhãn thành công), đồng thời xây dựng và chỉnh sửa các giao diện kèm theo hướng dẫn về thời điểm nên sử dụng từng giao diện. Cả hai đều được lưu trữ trong một repository mà agent tác vụ gọi đến.
- Sàng lọc dựa trên quần thể: Quá trình tiến hóa giữ lại những repository thể hiện tốt nhất trên các tác vụ xác thực mà meta-agent chưa từng thấy, điều này có lợi cho các cải tiến có khả năng chuyển giao sang những tác vụ mới.
- Kết quả: Sử dụng Qwen3.8-27B cùng các giao diện đã tiến hóa, Agent S4 đạt 21,3% trên OSWorld V2, gấp 3,8 lần so với chính model đó khi dùng giao diện cố định, thiết lập mức SOTA mới cho các computer-use agent mã nguồn mở. Kết quả này cao hơn mức 13,0% của GPT-5.5 và 20,6% của Claude Opus 4.8, trong khi chi phí chỉ lần lượt bằng khoảng 4,3% và 1,5%.
- Vì sao điều này quan trọng: Trên ScienceBoard, các giao diện tiến hóa đã nâng tỷ lệ thành công từ 41,4% lên 58,6% với cùng một model. Các tác giả cho rằng thiết kế giao diện nên trở thành một năng lực của agent, một nguồn cải tiến bổ trợ cho model và harness tốt hơn, đồng thời mã nguồn đã được mở.
bài báo | Bài viết gốc
7. Self-Evolving Continual Learners (Hệ thống học liên tục tự tiến hóa)
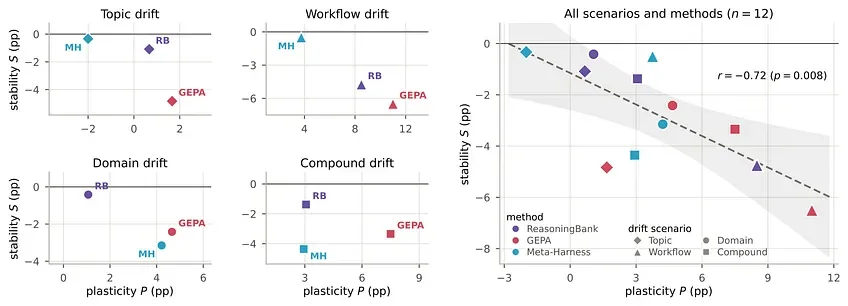
Các agent đã triển khai phải đối mặt với dòng chảy liên tục của kiến thức mới, công cụ mới và workflow mới, đồng thời chúng cần học các tác vụ mới mà không làm mai một tác vụ cũ. Các nhà nghiên cứu từ Google DeepMind, Mila và nhóm cộng sự đã tìm hiểu xem liệu các agent tự tiến hóa phi tham số — tức là giữ nguyên trọng số và tự viết lại prompt, memory cùng kỹ năng của mình — có phải là những người học liên tục hiệu quả hay không.
- Dòng trôi dạt: Nghiên cứu này xây dựng bốn dòng tác vụ từ BIRD, BFCL và ScienceWorld với sự thay đổi về chủ đề, workflow hoặc lĩnh vực. Nghiên cứu đã đánh giá ReasoningBank, GEPA và Meta-Harness, bao gồm cả truy xuất kinh nghiệm lẫn tự sửa đổi.
- Tính dẻo phải trả giá bằng tính ổn định: Khả năng tự tiến hóa đã cải thiện hiệu năng tổng thể trên hầu hết các dòng tác vụ, nhưng tính dẻo cao hơn luôn đi kèm với sự lãng quên nhiều hơn. Trong tất cả 12 tổ hợp phương pháp và kịch bản, hệ số tương quan giữa tính dẻo và tính ổn định là r = -0,72.
- Hai cơ chế thất bại: Phương pháp tự sửa đổi thực hiện các chỉnh sửa toàn cục đối với prompt dùng chung hoặc workspace, điều này gây nhiễu cho các tác vụ chưa từng thấy và ghi đè kiến thức cũ khi chuyển đổi dòng tác vụ. Truy xuất memory dựa trên độ tương đồng giúp các cập nhật mang tính cục bộ hơn, nhưng vẫn truy xuất nhầm memory từ các lĩnh vực khác, và xảy ra xung đột khi các truy vấn tương tự đòi hỏi những workflow mâu thuẫn nhau.
- Tầm quan trọng: Các tác giả kết luận rằng các agent tự tiến hóa hiện nay vẫn là những người học liên tục chưa hoàn chỉnh. Các benchmark tĩnh đã che lấp hai vấn đề này, vì vậy những đội ngũ phát triển agent tự cải tiến nên thử nghiệm chúng trên các dòng tác vụ thay đổi theo thời gian.
bài báo | Bài viết gốc
8. Terminal-RSI
Các nhà nghiên cứu tại Tencent xuất phát từ Qwen3.8-27B đã huấn luyện agent dòng lệnh qua 5 giai đoạn xen kẽ hai pha: fine-tune trên các phiên bản viết lại của quỹ đạo đã xác thực, sau đó chạy PPO với critic kế thừa từ giai đoạn trước. Điểm trung bình của bốn bộ Terminal-Bench tăng từ 20,68% lên 50,58%, trong đó Terminal-Bench 2.1 đạt 86,52% và Terminal-Bench Hard đạt 79,00%. Kiểm tra phần thưởng phát hiện ra rằng dưới cơ chế thưởng tiến độ dày đặc, các lượt chạy thất bại vẫn thu được 50,09% phần thưởng, nhưng khi tách biệt thành công nghiêm ngặt với điểm thành phần, tỷ lệ này giảm xuống còn 28,72%.
bài báo | Bài viết gốc
9. Transcoder Features Are Neurons (Đặc trưng Transcoder chính là nơ-ron)
Các nhà nghiên cứu từ Anthropic và Georgia Tech phát hiện ra rằng trong 13 transcoder mã nguồn mở, nhiều đặc trưng transcoder hoạt động ở các tầng sau là bản sao gần đúng của các nơ-ron MLP đơn lẻ. Các đặc trưng căn chỉnh theo nơ-ron này là những đặc trưng duy nhất có mối liên hệ ổn định với MLP bên dưới, trong khi các đặc trưng khác biến thiên nhiều hơn giữa các lượt huấn luyện, không khớp với ma trận Jacobian của MLP và dịch chuyển ít hơn so với điểm khởi tạo ngẫu nhiên ban đầu của chúng. Các tác giả kết luận rằng các nơ-ron MLP đóng vai trò là nền tảng cho tính khả giải thích mạnh mẽ hơn so với giả định thông thường, còn các đặc trưng không phải nơ-ron cần được kiểm chứng kỹ lưỡng hơn trước khi dùng để giải thích hành vi của model.
bài báo | Bài viết gốc
10. MemoryTax
Nghiên cứu ngắn này đã chạy một cuộc hội thoại LoCoMo gồm 419 lượt trên ba model, đánh giá bốn phương pháp memory (context đầy đủ, BM25, Mem0, Zep) cùng ba coding agent (Pi, Codex, Claude Code), đồng thời ghi nhận chi phí cho mỗi lần rollback. Mem0 chỉ vượt qua context đầy đủ trên GPT-4o-mini, và chi phí xây dựng memory của nó còn vượt quá toàn bộ chi phí rollback bằng context đầy đủ, trong khi với Claude Opus 5.5, coding agent Pi tìm kiếm lịch sử gốc đã đạt được 99% điểm số với chi phí chưa bằng một nửa context đầy đủ. Memory cũng có một giới hạn trần do chính model ghi vào nó thiết lập, bởi một reader mạnh hơn không thể khôi phục lại những nội dung mà một writer yếu hơn đã bỏ sót.
bài báo | Bài viết gốc
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác