Link bài viết gốc: https://mp.weixin.qq.com/s/pbL3p6rBsm3hQ...
Kim Sắc Truyền Thuyết Đại Thông Minh · WeChat Official Account · Tái Bác Thiền Tâm · 2026-10-20 17:51
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
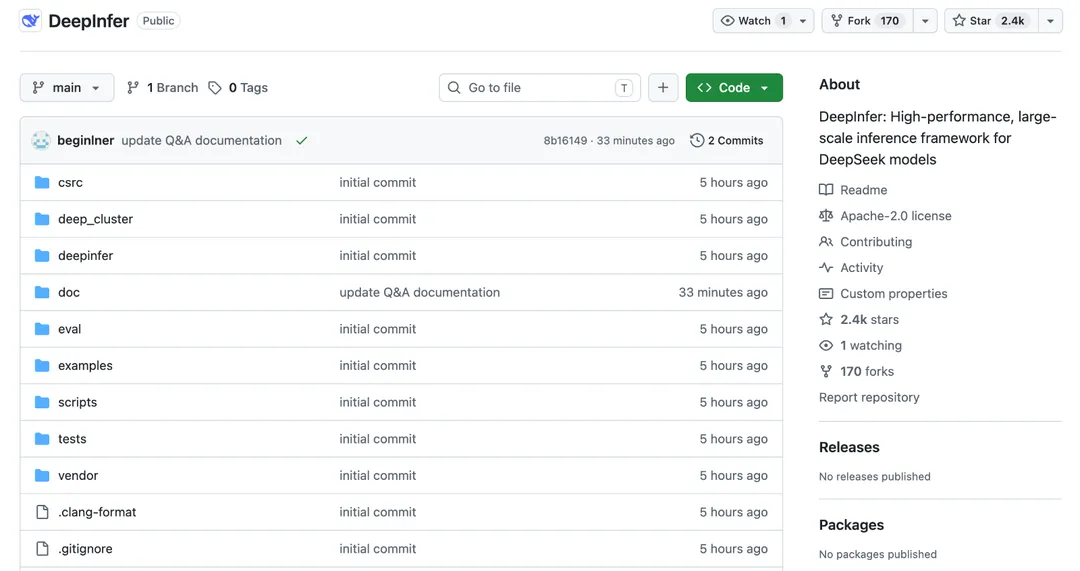
Mới đây, DeepSeek vừa mở mã nguồn framework suy luận của riêng mình DeepInfer , cũng chính là framework suy luận hiện đang được V4.1 Flash sử dụng; cùng thời điểm này, họ cũng mở mã nguồn component mã hóa và giải mã deepseek-recipe
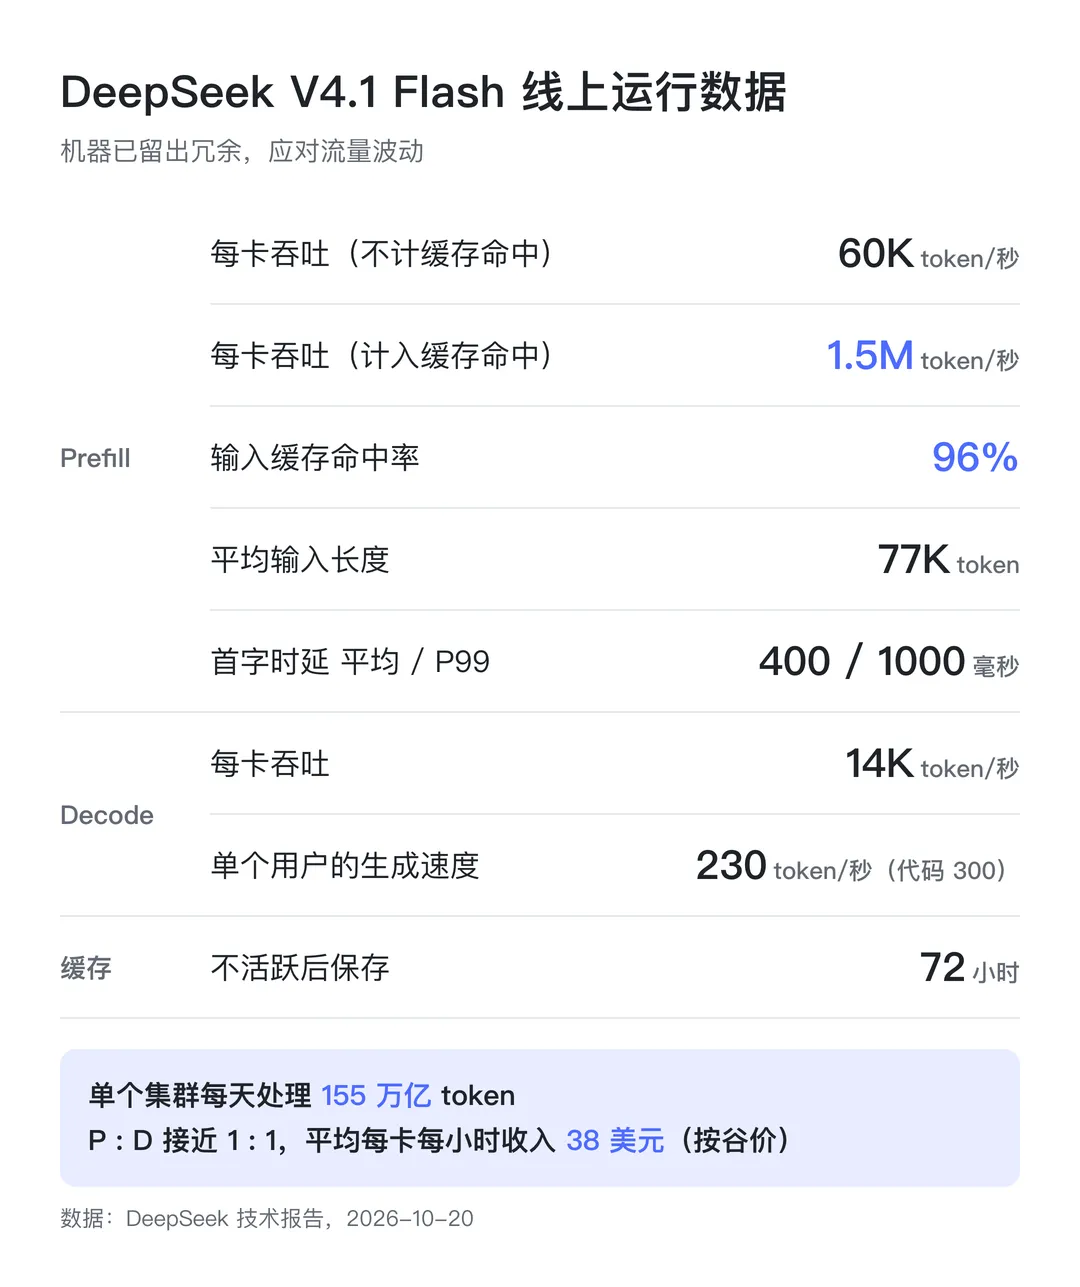
Để bạn dễ hình dung bối cảnh, dưới đây là một số dữ liệu thực tế trên môi trường production:
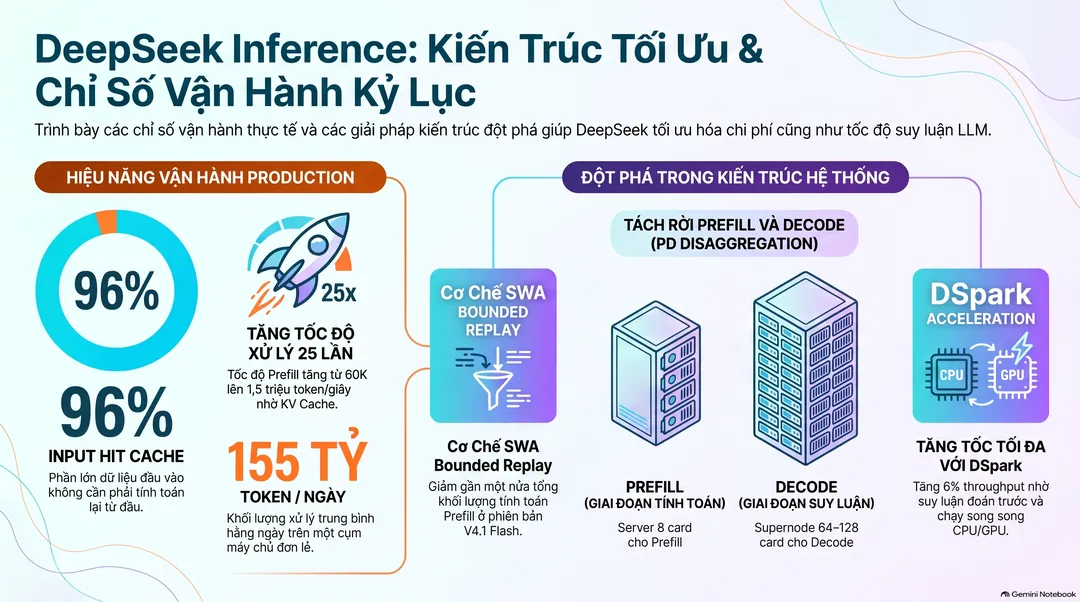
- Một cụm đơn lẻ xử lý mỗi ngày 155 nghìn tỷ token
- Mỗi request trung bình có input 77K token, trong đó 96% hit cache, không cần tính toán lại
- Doanh thu trung bình mỗi card mỗi giờ là 38 USD (tính theo giá giờ thấp điểm)
Bài viết này dưới góc độ nguyên lý, kết hợp báo cáo kỹ thuật này cùng tài liệu Q&A triển khai đi kèm trong repo, sẽ giải thích cho bạn: sau khi một request được gửi đến DeepSeek, hệ thống suy luận sẽ từng bước tính toán xong và trả về kết quả như thế nào, cũng như ở mỗi bước, DeepSeek đã tiết kiệm sức mạnh tính toán ra sao
Một request phải trải qua những giai đoạn nào?
Khi model xử lý một request, quá trình tính toán được chia làm hai giai đoạn:
Prefill (Tiền điền đầy) Model đọc toàn bộ input bạn gửi tới, bao gồm system prompt, lịch sử hội thoại, tệp tin và câu hỏi. Trong quá trình đọc, mỗi token tại từng tầng của model đều sẽ tính ra một tập kết quả trung gian, đó chính là KV cache
Decode (Giải mã) Model bắt đầu sinh câu trả lời, mỗi lần xuất ra một token. Mỗi khi xuất một token, đều phải dùng đến toàn bộ KV cache ở phía trước
Yêu cầu phần cứng của hai giai đoạn này hoàn toàn khác nhau. Prefill xử lý hàng chục nghìn token mỗi lần, tiêu tốn chủ yếu là năng lực tính toán; còn Decode mỗi lần chỉ sinh một token, phần lớn thời gian dành cho việc đọc tham số và cache từ VRAM
Vì vậy, DeepSeek triển khai hai giai đoạn này trên các máy chủ khác nhau ( đây chính là điều thường gọi là tách rời PD ): Prefill sử dụng server 8 card phổ biến, còn Decode sử dụng supernode từ 64 đến 128 card. Nếu request có kèm theo hình ảnh, trước tiên nó sẽ được chuyển tới dịch vụ mã hóa hình ảnh được triển khai riêng biệt để xử lý
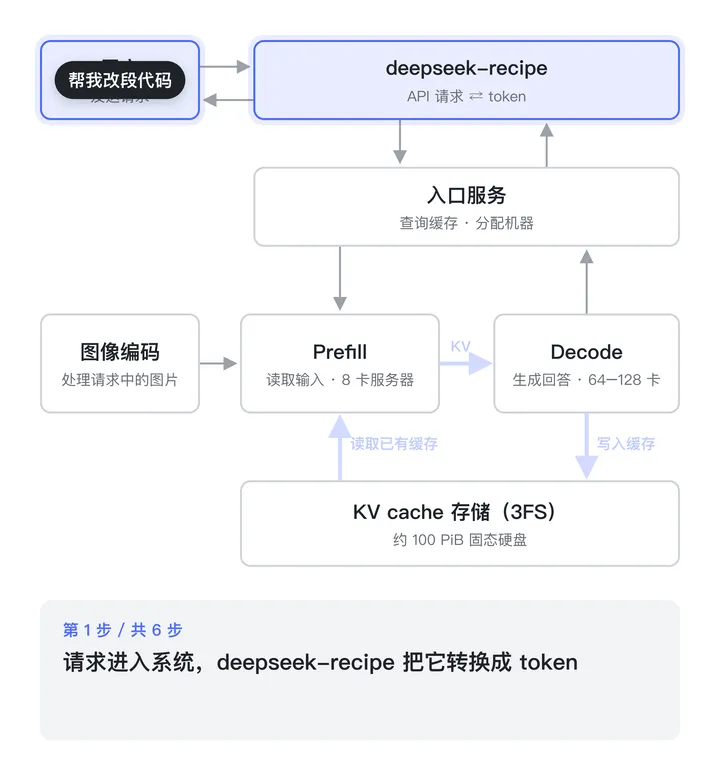
Trong triển khai thực tế, tỷ lệ số card giữa hai loại máy là gần 1:1. Hệ thống có thể chạy tối thiểu với một cụm Prefill kết hợp một cụm Decode, nhưng để đạt hiệu suất cao hơn, quy mô khởi điểm phải là 64 card Prefill kết hợp với 64 card Decode
Request được chuyển thành token như thế nào
Sau khi request đi vào hệ thống, trước tiên nó sẽ được xử lý bởi deepseek-recipe — thành phần cũng vừa được mở mã nguồn lần này
Hiện nay có ba định dạng API phổ biến:
- Chat Completions API của OpenAI
- Responses API của OpenAI
- Messages API của Anthropic
deepseek-recipe sẽ chuyển đổi đồng nhất ba loại request này thành cùng một định dạng hội thoại, sau đó ghép thành prompt theo phiên bản model và mã hóa thành token; các token do model sinh ra cũng được nó chuyển đổi ngược lại thành định dạng tương ứng để trả về dưới dạng streaming
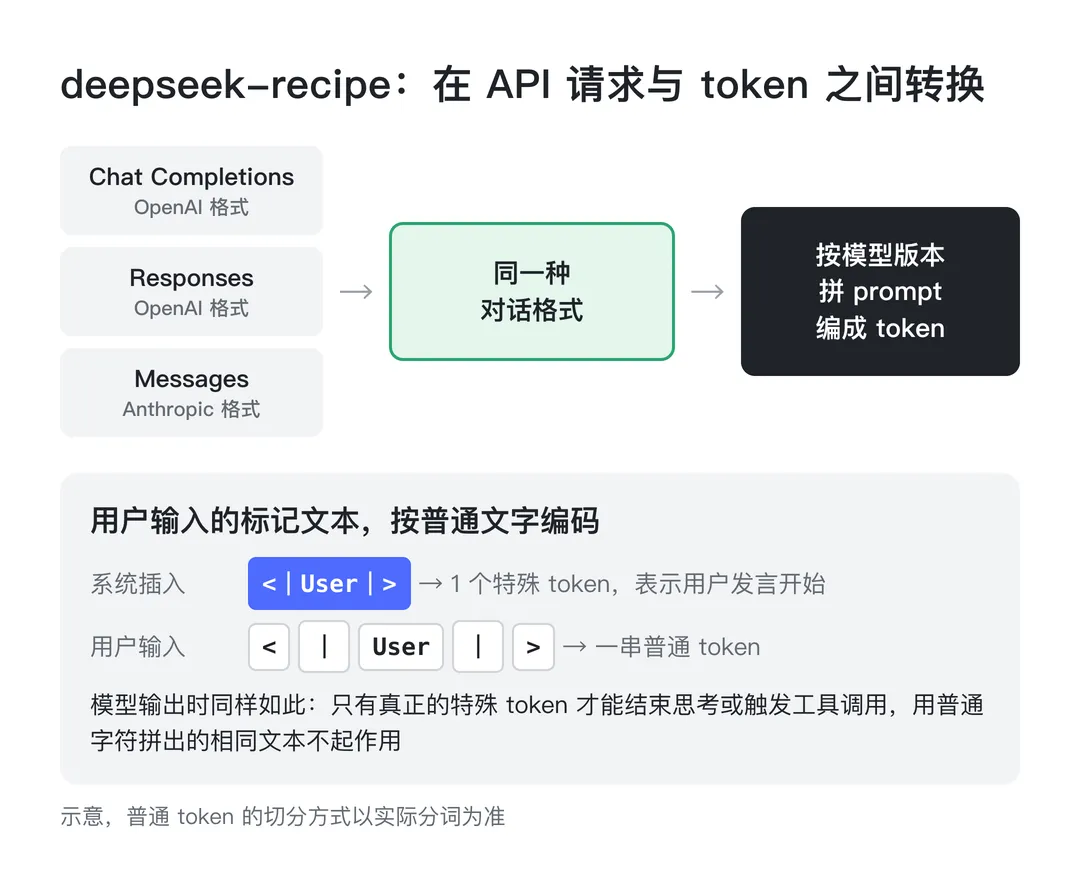
Trong quá trình này, nó còn giải quyết hai vấn đề:
- Chống injection: Model của DeepSeek dùng một số token đặc biệt để đánh dấu cấu trúc hội thoại, chẳng hạn như bắt đầu lượt nói của user, kết thúc suy nghĩ, bắt đầu gọi tool. Nếu user tự nhập trong input chuỗi ký tự như , deepseek-recipe sẽ mã hóa nó như văn bản thông thường, model sẽ không nhận diện nó là thẻ đánh dấu cấu trúc
- Tăng tốc mã hóa: Vị trí của các token đặc biệt đã được xác định từ lúc ghép prompt, các đoạn văn bản thường xen giữa chúng có thể được mã hóa song song độc lập, nhờ đó rút ngắn thời gian tokenization cho các request có context dài
Khi trả về kết quả cũng có xử lý tương tự. Ví dụ một chữ Hán trong UTF-8 chiếm 3 byte, có thể bị tách vào hai token liền kề nhau, deepseek-recipe sẽ tạm lưu vào buffer, đợi đến khi ký tự hoàn chỉnh mới xuất ra; tham số gọi tool cũng được vừa sinh vừa trả về, không cần đợi sinh xong toàn bộ
Do logic xử lý của deepseek-recipe khớp hoàn toàn với API chính thức của DeepSeek, nên khi người khác tự triển khai model DeepSeek, họ cũng sẽ đạt được hiệu năng giao diện và hành vi nhất quán với bản chính thức
Cơ chế cache được thực hiện như thế nào
Trong các kịch bản Agent, mỗi lần gọi tool, client đều phải gửi lại toàn bộ lịch sử cho model, bao gồm system prompt, hướng dẫn sử dụng tool, cũng như phản hồi và kết quả tool của từng vòng trước đó. Trong khi phần lớn nội dung đó đã được tính toán ở request của vòng trước
Cách làm của DeepSeek là lưu lại KV cache đã tính toán, request ở vòng tiếp theo sẽ chỉ cần tính phần mới thêm vào
Cần lưu ý rằng chỉ những nội dung có cùng prefix (đồng nhất tính từ token đầu tiên) mới có thể hit cache, còn nội dung lặp lại bắt đầu từ đoạn giữa thì không thể tái sử dụng
Từ dữ liệu production thực tế, trên cùng một card khi chạy Prefill, nếu không tính cache hit, mỗi giây xử lý 60 nghìn token; sau khi tính cả hit cache, mỗi giây xử lý 1,5 triệu token, chênh lệch tới 25 lần
Những cache này được lưu trữ trong một cụm storage độc lập, sử dụng hệ thống tệp phân tán 3FS mà DeepSeek từng mở mã nguồn trước đó, dung lượng khoảng 100 PiB , toàn bộ đều là ổ SSD. KV cache được ghi theo từng block 128 token, cache từ lưu lượng Agent được lưu giữ trong 3 ngày, còn lưu lượng chat được lưu giữ 7 ngày
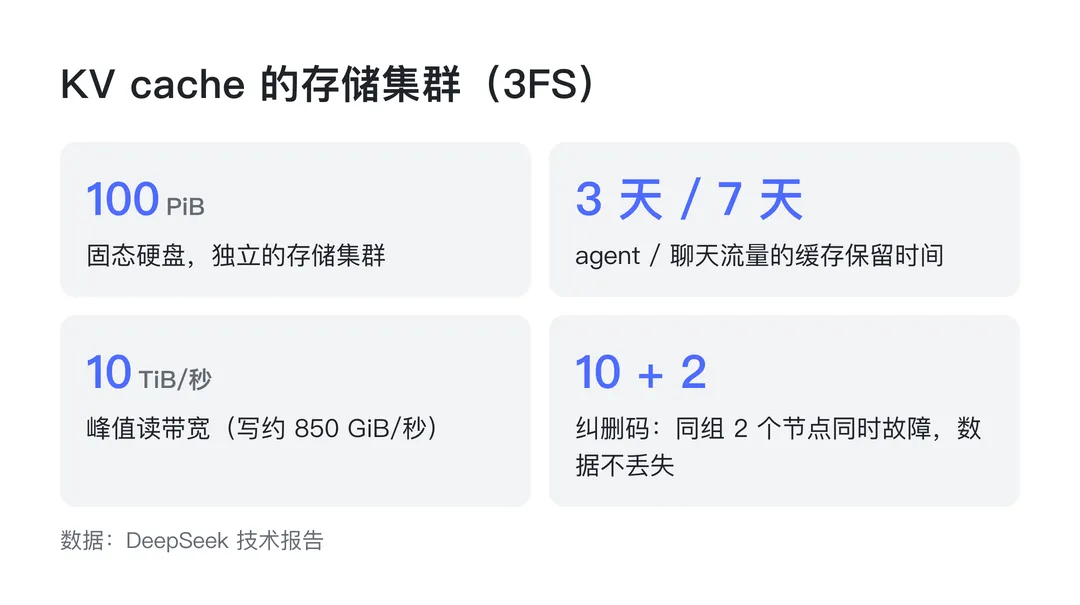
Lưu lượng chat được giữ lâu hơn là vì trong đó có một lượng nhỏ cache được đọc đi đọc lại nhiều lần, một khi bị mất sẽ ảnh hưởng rất lớn đến tỷ lệ cache hit tổng thể. Nếu chỉ giữ 3 ngày, tỷ lệ hit của lưu lượng chat sẽ giảm từ 0,5% đến 1%
Sở dĩ sử dụng cụm storage độc lập thay vì lưu trực tiếp trong RAM của chính các máy tính toán là do hai lý do chính sau:
- Bất kỳ máy Prefill nào cũng có thể đọc bất kỳ đoạn cache nào, nên khi phân bổ request, không cần phải gắn cố định user vào máy chủ của lần trước
- Tỷ lệ xảy ra sự cố của máy tính toán cao hơn máy storage từ một bậc độ lớn trở lên. Lưu cache trong cụm storage thì ngay cả khi máy tính toán gặp sự cố, cache cũng không bị mất
Quá trình đọc cache cũng không được làm tăng độ trễ tạo chữ đầu tiên (TTFT). Service ở cổng vào chỉ truy vấn metadata để xác định độ dài prefix hit cache; việc đọc dữ liệu từ ổ cứng vào RAM rồi nạp sang VRAM đều được thực hiện ngầm dưới nền song song với quá trình tính toán. Hiện tại trên production, trung bình mỗi lần input là 77K token, độ trễ tạo chữ đầu tiên đạt mức trung bình 400 mili-giây
Xử lý cache miss như thế nào
Trong model V4.1 Flash, có một phần các layer sử dụng Sliding Window Attention (SWA), mỗi token chỉ chú ý tới 128 token gần nó nhất. Phần KV cache này được lưu trữ riêng: không ghi vào ổ cứng mà giữ lại trong RAM của chính cỗ máy đã tính ra nó, sau khoảng 3 phút sẽ bị xóa, với tỷ lệ hit đạt trên 98%
Nếu xảy ra cache miss, cách xử lý của V4 là tính toán lại chính xác (exact recompute), tức là khôi phục trạng thái cửa sổ từng layer một, đòi hỏi phải tính lại số lượng token bằng "số layer × độ dài cửa sổ". Để giảm thiểu tình trạng này, V4 đã ghi cả phần cache này vào ổ cứng, dẫn đến việc chiếm dụng gần một nửa dung lượng cache của ổ cứng
Thế nhưng phần cache này chỉ có ích trong vài phút khi cuộc hội thoại đang diễn ra, dùng ổ cứng lưu trữ nhiều ngày để chứa nó là điều không kinh tế
V4.1 đã chuyển sang dùng SWA Bounded Replay: chỉ tính toán lại 128 token cuối cùng, và khi tính toán cơ chế attention chỉ áp dụng trong phạm vi 128 token này, từ đó thu được một bản cache cửa sổ xấp xỉ. Nhờ vậy, chi phí tính toán lại là cố định, hoàn toàn không phụ thuộc vào độ dài context hay số tầng của model
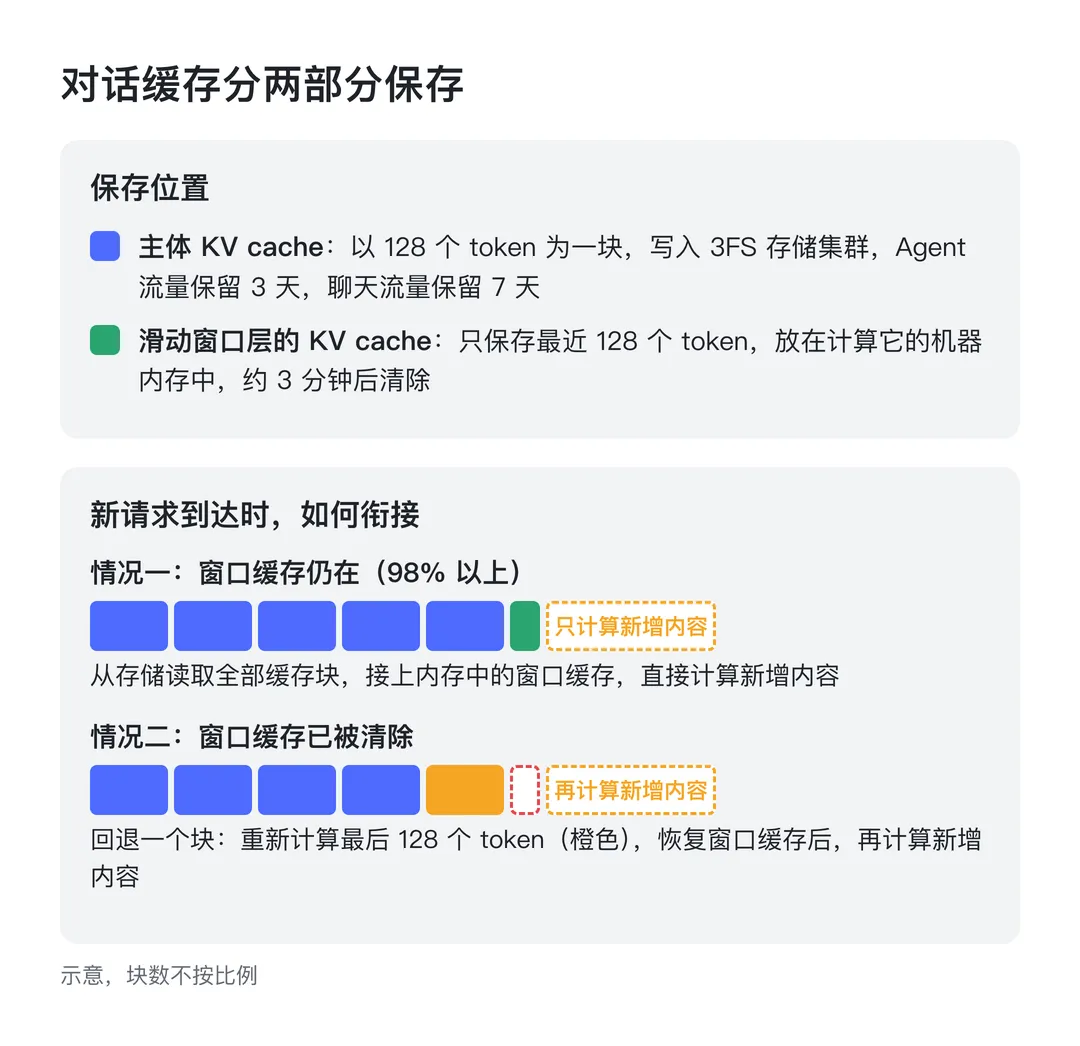
Phương pháp tương tự cũng được áp dụng cho 20 layer khác của model. Cache cửa sổ của 20 layer này vốn phải tính lại ở mỗi lượt Prefill, trước đây phải xử lý 2.560 token cuối, nay chỉ cần xử lý 128 token cuối, nhờ đó tổng khối lượng tính toán của Prefill giảm đi gần một nửa
Làm thế nào để tăng tốc độ sinh nội dung
Khi bước vào giai đoạn Decode, mỗi bước tính toán của model chỉ có thể sinh ra một token
Ý tưởng của speculative decoding là: đầu tiên để một module draft gọn nhẹ liên tục đoán trước 5 token, sau đó để mô hình lớn (LLM) xác thực cả 5 token này trong một lần. Phần đoán đúng sẽ được chấp nhận ngay lập tức, còn tại vị trí đầu tiên đoán sai, mô hình lớn (LLM) sẽ đưa ra kết quả chính xác. Nhờ đó, chỉ trong một bước tính toán đã có thể thu được nhiều hơn một token
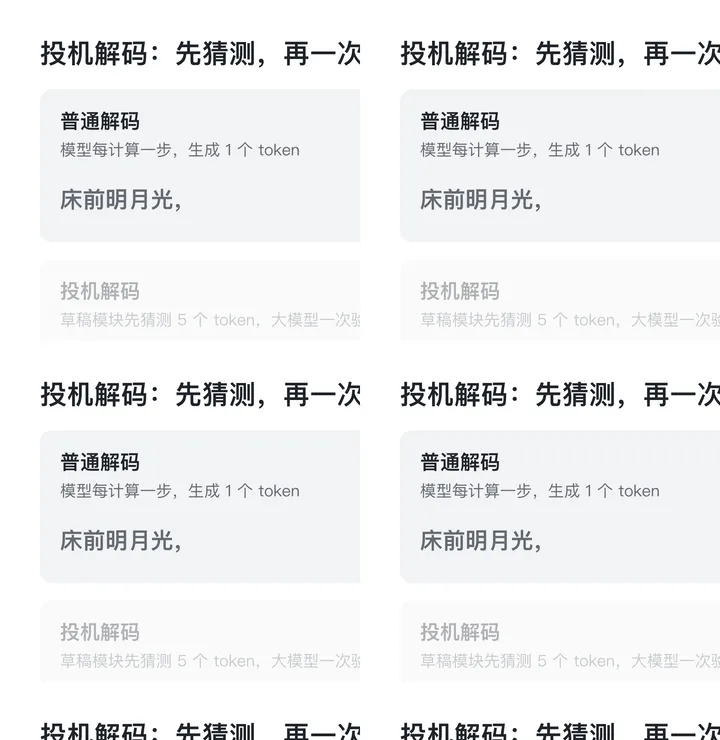
Phương pháp speculative decoding do DeepSeek tự phát triển có tên là DSpark, trên cơ sở đó đã bổ sung thêm một bước: ước tính trước xác suất được chấp nhận của mỗi dự đoán, những dự đoán có xác suất thấp sẽ không đưa vào xác thực nữa, nhường sức mạnh tính toán xác thực cho các request khác. So với việc cố định xác thực 5 token, throughput trên production đã tăng thêm 6%
Ngoài ra, giữa mỗi hai bước tính toán, CPU cần sắp xếp request tiếp theo và xử lý kết quả của bước trước, khoảng thời gian này GPU vốn phải ở trạng thái chờ. DeepInfer cho phép cả hai hoạt động gối đầu: khi GPU đang tính toán bước thứ N thì CPU đã bắt đầu sắp xếp bước thứ N+1
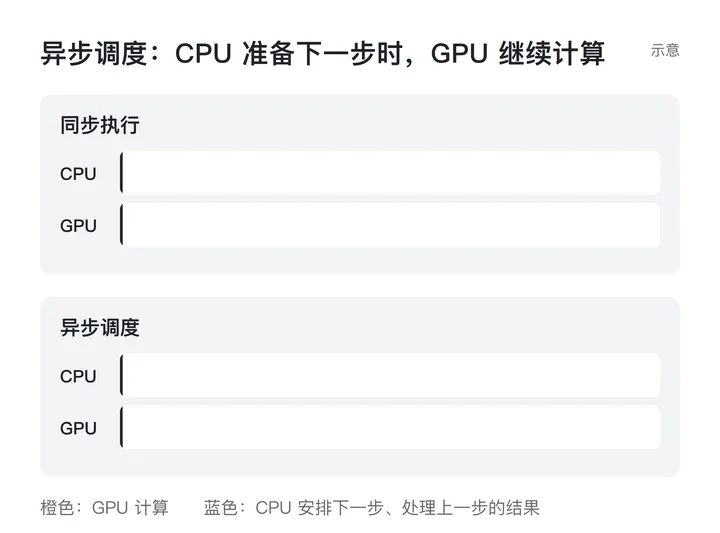
Hiện tại ở giai đoạn Decode trên production, mỗi card mỗi giây sinh ra 14K token, tốc độ sinh của một user đơn lẻ đạt 230 token mỗi giây, trong kịch bản code đạt 300 token
Cân bằng tải được thực hiện như thế nào
V4.1 Flash là một model MoE, trong model có nhiều nhóm tham số "chuyên gia" (expert), mỗi token chỉ kích hoạt vài nhóm trong số đó. Trong đó, có tổng cộng 384 routed expert
Ở giai đoạn Decode, DeepSeek phân bổ các expert này lên 64 card, mỗi card lưu 6 expert, cộng thêm 1 bản sao của expert được truy cập nhiều (hot expert), tổng cộng là 7. Số lượng expert trên mỗi card càng ít thì lượng tham số cần đọc từ VRAM trong mỗi bước càng giảm, nhờ đó cùng một số lượng card có thể phục vụ được nhiều request hơn
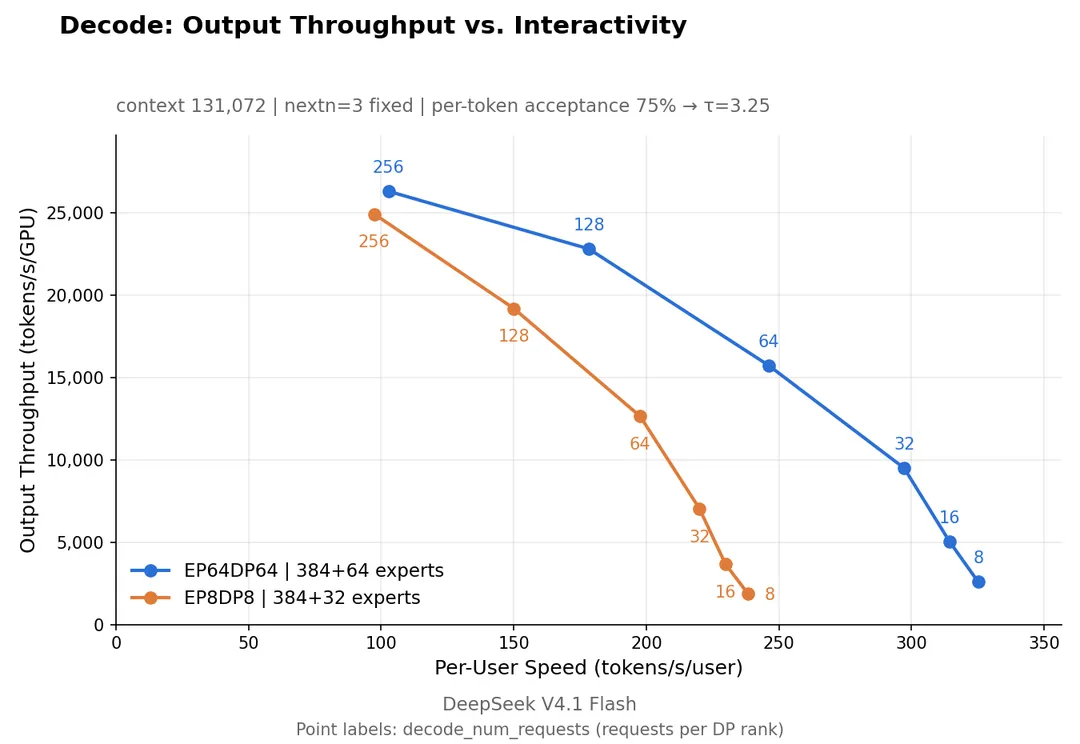
Thử nghiệm offline chính thức: nhóm 64 card (xanh lam) và nhóm 8 card (cam)
Bản sao của các hot expert cũng được điều chỉnh động: mỗi 1.000 bước sẽ thống kê tải của từng expert một lần, mỗi 10.000 bước sẽ tái phân bổ một lần. Đo đạc thực tế trên production, card có tải cao nhất chỉ chênh 9% so với mức trung bình
Các request cũng cần được phân bổ đồng đều:
- Prefill được chia làm 4 mức theo độ dài input (dưới 16K, từ 16K đến 64K, từ 64K đến 256K, trên 256K), số lượng máy phân bổ cho mỗi mức sẽ được điều chỉnh động dựa trên nhu cầu của vòng trước
- Decode đồng thời cân nhắc hai yếu tố: số lượng request trên mỗi card và tổng độ dài cache của các request đó. Request ngắn được điều phối tới card ít request nhưng có cache dài hơn, còn request dài được phân tới card có cache ngắn hơn
Nhờ các cơ chế điều phối này, toàn bộ hệ thống có thể đạt khoảng 80% trạng thái cân bằng tuyệt đối như trong thử nghiệm offline
Số lượng máy cũng tự động tăng giảm theo lưu lượng: Prefill dựa vào số lượng token bị cache miss để đánh giá, Decode dựa vào số lượng request đang xử lý để quyết định. Nếu một card trong instance Decode gặp sự cố, toàn bộ instance sẽ cần khởi động lại, sau khi khởi động lại sẽ dùng các card bình thường còn lại để tái tổ hợp thành instance mới
Còn về việc có thể triển khai liên phòng máy hay không, câu trả lời của DeepSeek là về mặt kỹ thuật thì khả thi, mỗi 8 card cần được trang bị băng thông kết nối khoảng 400Gbps, nhưng "có thể làm giảm độ tin cậy, vì cáp quang nối giữa các phòng máy rất dễ bị đào đứt".
Bản thân các node suy luận của DeepSeek được triển khai tại các phòng máy khác nhau nhưng nằm liền kề nhau.
Cuối cùng
Trên đây chính là toàn bộ quy trình hệ thống suy luận của DeepSeek xử lý một request:
- Chuyển đổi request API thành token
- Prefill đọc input, phần cache có thể tái sử dụng sẽ được đọc trực tiếp từ bộ lưu trữ
- Decode sinh từng token một, được tăng tốc nhờ speculative decoding và điều phối bất đồng bộ
- Phân bổ đồng đều các expert và request lên từng card
Lần này có hai dự án mã nguồn mở: DeepInfer (giấy phép Apache 2.0) và deepseek-recipe (giấy phép MIT). DeepInfer hiện hỗ trợ DeepSeek-V4.1-Flash, có thể chạy trên GPU NVIDIA SM100 và Huawei Ascend 950, phiên bản mã nguồn mở cung cấp khả năng suy luận offline.
Hệ thống lưu trữ cache, việc triển khai tách biệt Prefill và Decode, cùng với cơ chế cân bằng tải giữa nhiều replica được nhắc đến ở trên, do gắn kết sâu với cơ sở hạ tầng nội bộ nên tạm thời chưa được mở mã nguồn. Nếu muốn xây dựng một dịch vụ online hoàn chỉnh, bạn sẽ cần phải tự triển khai các phần này.
DeepInfer ban đầu chủ yếu được xây dựng dựa trên vLLM, đồng thời cũng tham khảo SGLang và TensorRT-LLM. Sau này, code suy luận cho các model mới của DeepSeek cũng sẽ tiếp tục được cập nhật trong repository này.
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác