Link bài viết gốc: https://x.com/antiAIvo/status/2112187842...
Nano AI · X · @antiAIvo · 2026-10-19 22:23
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
Rất nhiều người muốn học mô hình lớn (LLM), nhưng lại kẹt ngay ở bước đầu tiên: Không biết nên bắt đầu từ đâu.
Mở tài liệu trên mạng ra, có chỗ nói về Transformer, chỗ giảng về RAG, chỗ đề cập đến agent, chỗ dạy fine-tune, chỗ lại hướng dẫn về vLLM. Mảnh ghép nào trông cũng rất quan trọng, nhưng ghép lại thì chẳng ra nổi một bức tranh hoàn chỉnh.
Thế là tình trạng phổ biến là: lưu về hàng chục bài hướng dẫn, đọc vài bài giải thích kiến thức, dường như cái gì cũng hiểu một chút, nhưng khi thật sự bị hỏi "LLaMA và GPT-2 rốt cuộc khác nhau ở điểm nào" thì lại không nói rõ được.
Vấn đề không nằm ở chỗ bạn chưa đủ nỗ lực, mà là thiếu một tấm bản đồ.
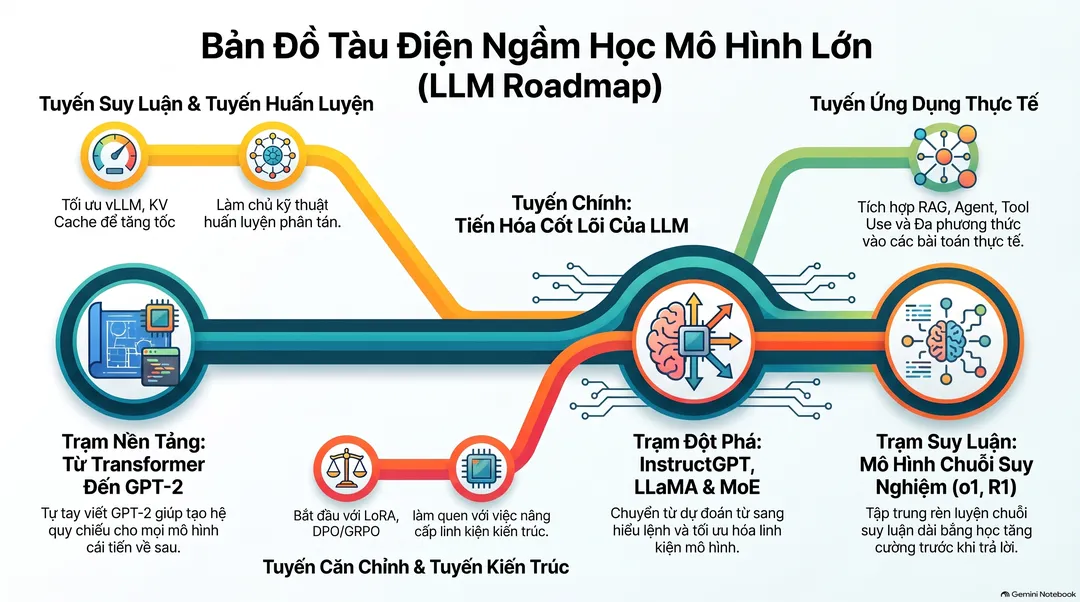
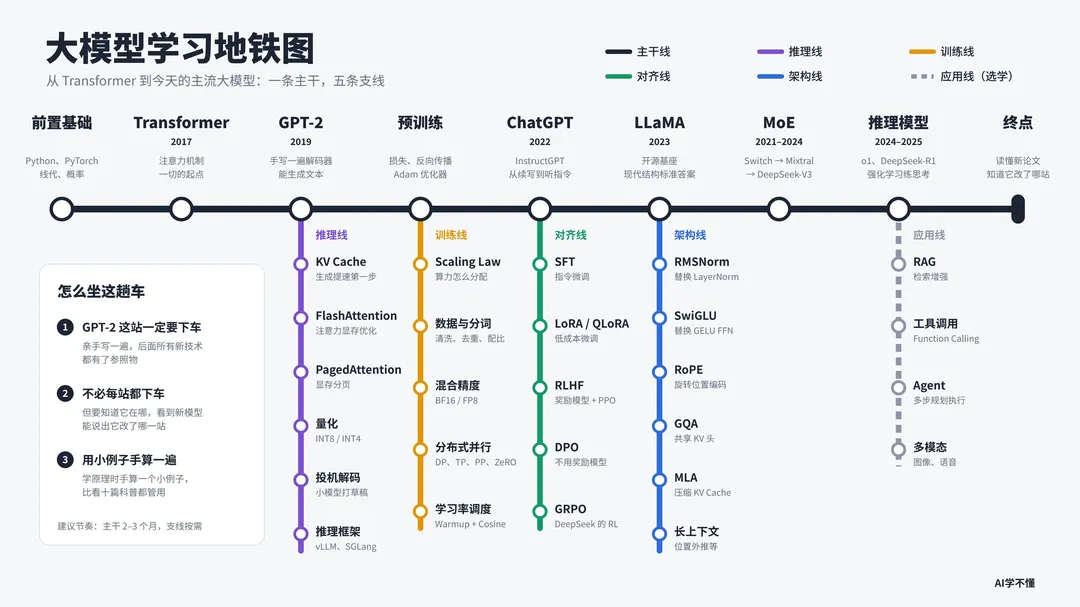
Vì vậy, tôi đã vẽ hệ thống tri thức về mô hình lớn (LLM) thành một tấm bản đồ tàu điện ngầm: Một tuyến chính, năm tuyến nhánh.
Tuyến chính là tuyến ai cũng phải đi hết, nó chính là trình tự tiến hóa thực tế của mô hình lớn (LLM) trong những năm qua.
Các tuyến nhánh thì chuyển tuyến tùy theo sở thích, không nhất thiết ai cũng phải đi qua toàn bộ.
Dưới đây sẽ đi qua từng trạm một.
1. Tuyến chính: Tuyến đường mà ai cũng phải đi tới cùng
Trạm 0: Nền tảng tiền đề
Những thứ cần chuẩn bị không nhiều: Python, PyTorch, đại số tuyến tính, và một chút xác suất.
Đại số tuyến tính không cần phải học đến trình độ của khoa toán, chỉ cần hiểu được phép nhân ma trận, tích vô hướng của vector, biết hình dạng (shape) của tensor thay đổi ra sao qua từng bước là đủ dùng.
Với PyTorch, bạn chỉ cần biết dựng một mạng nơ-ron đơn giản, hiểu tensor, nn.Module, lan truyền xuôi (forward pass) có nghĩa là gì.
Cái bẫy phổ biến nhất ở trạm này là mãi dậm chân tại chỗ: muốn bổ sung hết sạch kiến thức toán học rồi mới chịu xuất phát. Thật ra không cần thiết. Vừa học vừa bù đắp kiến thức là cách đạt hiệu quả cao nhất.
Trạm 1: Transformer (2017)
Paper nền tảng là "Attention Is All You Need". Hầu như tất cả các mô hình lớn (LLM) phổ biến ngày nay đều phát triển từ paper này.
Trạm này cần làm rõ vài điều: self-attention tính toán cái gì, Q, K, V lần lượt đóng vai trò gì; tại sao cần multi-head; kết nối tàn dư (residual connection) và LayerNorm giải quyết vấn đề gì; FFN làm gì trong mỗi layer; bản thân model không biết thứ tự của từ nên cần đến mã hóa vị trí.
Nên xem trước các bài viết hoặc video dạng minh họa trực quan để hình thành trực giác, sau đó mới quay lại đọc paper gốc. Paper gốc được viết rất cô đọng, đọc trực tiếp ngay từ đầu rất dễ nản lòng.
Trạm 2: GPT-2 (2019)
Đây là trạm then chốt nhất của toàn bộ lộ trình, nhất định phải dừng chân.
Transformer nguyên bản gồm encoder kết hợp với decoder, dùng để làm nhiệm vụ dịch thuật. Dòng GPT chỉ giữ lại decoder, và nhiệm vụ cũng trở nên rất đơn giản: Dựa vào các từ phía trước để dự đoán từ tiếp theo.
Mục tiêu của trạm này là tự tay viết một GPT-2 : từ tokenization, embedding, đến attention, Transformer Block, xếp chồng nhiều layer, cuối cùng nạp trọng số pre-train chính thức để nó thực sự tạo ra văn bản.
Tại sao lại nhấn mạnh "tự tay viết"?
Bởi vì hầu như tất cả các "công nghệ mới" sau này, tuyệt đại đa số đều dựa trên cấu trúc của GPT-2 để thay linh kiện . Khi trong đầu bạn đã có một GPT-2 chạy được, sau này nhìn thấy bất kỳ model mới nào, bạn đều có thể lấy nó ra đối chiếu: model đó đã sửa đổi chỗ nào, và tại sao lại sửa.
Nếu không có vật quy chiếu này, những kiến thức phía sau bạn chỉ có thể học vẹt.
Trạm 3: Pre-train
Trạm 2 nạp các trọng số do người khác huấn luyện sẵn. Trạm này bạn phải hiểu rõ những trọng số đó đến từ đâu.
Cốt lõi gồm bốn việc: **hàm mất mát (cross-entropy), lan truyền ngược, hạ độ dốc, bộ tối ưu Adam.** Dùng những thứ này để huấn luyện một model được khởi tạo ngẫu nhiên cho đến khi nó biết "nói chuyện".
Bạn không cần phải chi hàng triệu đô la để huấn luyện một mô hình lớn (LLM). Chỉ cần huấn luyện một GPT nhỏ từ đầu trên một dataset nhỏ, nhìn loss giảm dần từng chút một, là nguyên lý sẽ thông suốt.
Trạm 4: Khoảnh khắc ChatGPT (2022)
Model sau khi pre-train chỉ biết viết tiếp. Bạn hỏi nó một câu, có khi nó lại bịa tiếp ra ba câu hỏi tương tự chứ không trả lời bạn.
Paper InstructGPT giải quyết chính xác vấn đề này: **giúp model chuyển từ "biết viết tiếp" thành "nghe hiểu chỉ lệnh".** Phương pháp gồm ba bước: đầu tiên dùng dữ liệu hỏi-đáp do con người viết để fine-tune có giám sát, sau đó huấn luyện một reward model để chấm điểm câu trả lời, cuối cùng dùng học tăng cường để điều chỉnh model theo hướng đạt điểm cao.
ChatGPT chính là sản phẩm của lộ trình này. Trạm này bạn chỉ cần hiểu quy trình tổng thể, chi tiết sẽ dành cho tuyến căn chỉnh (alignment).
Trạm 5: LLaMA (2023)
LLaMA là bước ngoặt của mô hình lớn (LLM) mã nguồn mở. Sau nó, cấu trúc cơ bản của phần lớn model mã nguồn mở gần như đã định hình.
So sánh LLaMA với GPT-2, phần thân chính vẫn là Transformer decoder đó, nhưng vài linh kiện đã được thay thế: LayerNorm đổi thành RMSNorm, hàm kích hoạt của FFN đổi thành SwiGLU, mã hóa vị trí tuyệt đối đổi thành RoPE , các phiên bản sau còn dùng GQA để nhiều attention head dùng chung KV, giúp tiết kiệm VRAM.
Đây chính là điều đã nhắc ở trước: "thay linh kiện". Trên tuyến chính bạn chỉ cần biết đã thay những gì, chi tiết từng linh kiện sẽ được triển khai ở tuyến kiến trúc.
Trạm 6: MoE chuyên gia thưa (2021 đến 2024)
Model càng lớn thì càng mạnh, nhưng khối lượng tính toán cũng càng khổng lồ. Tư duy của MoE là: Làm số lượng tham số thật nhiều, nhưng mỗi token chỉ kích hoạt một phần nhỏ trong đó.
FFN được chia nhỏ thành nhiều "chuyên gia", cộng thêm một bộ định tuyến để quyết định mỗi token sẽ do những chuyên gia nào xử lý. Tổng lượng tham số có thể rất lớn, nhưng khối lượng tính toán mỗi lượt lại không nhiều.
Trên tuyến này có ba cột mốc đáng xem: Switch Transformer của Google, đơn giản hóa việc định tuyến sao cho mỗi token chỉ chọn một chuyên gia; Mixtral , đưa MoE vào cộng đồng mã nguồn mở; DeepSeek-V3 , tổng tham số 671 tỷ, nhưng mỗi token chỉ kích hoạt khoảng 37 tỷ.
Nếu muốn đọc hiểu paper của DeepSeek thì không thể bỏ qua trạm này.
Trạm 7: Model suy luận (2024 đến 2025)
o1 của OpenAI và DeepSeek-R1 đại diện cho sự thay đổi mô thức lớn gần đây nhất: Để model suy nghĩ trước rồi mới trả lời.
Model sẽ tạo ra một chuỗi suy luận dài trước khi đưa ra câu trả lời. Năng lực này chủ yếu được tôi luyện nhờ học tăng cường, đặc biệt là trong các tác vụ có thể tự động kiểm chứng kết quả như toán học và lập trình.
Paper của DeepSeek-R1 đã công khai rất nhiều chi tiết, là điểm khởi đầu tốt nhất cho trạm này.
Đích đến: Tự mình đọc hiểu các paper mới
Đi hết tuyến chính không có nghĩa là cái gì bạn cũng biết tuốt, nhưng bạn sẽ có được một năng lực: Khi thấy một model mới ra mắt, bạn có thể nói rõ nó đã thay đổi ở trạm nào, tại sao lại đổi như vậy và giải quyết vấn đề gì.
Các model mới ra mắt năm 2026 về cơ bản cũng tiếp tục cải tiến dựa trên một vài trạm trong bản đồ này. Khi đã quen thuộc với bản đồ, bạn sẽ nắm bắt những thứ mới nhanh hơn rất nhiều.
Làm được điều này nghĩa là bạn đã thực sự nhập môn.
2. Năm tuyến nhánh: Chuyển tuyến theo sở thích
Tuyến suy luận: Phù hợp với người quan tâm đến tốc độ và chi phí
Model huấn luyện xong rồi, làm thế nào để nó chạy nhanh và tiết kiệm tài nguyên? Tuyến này là hướng đi mà kỹ sư dễ bắt tay vào nhất và cũng dễ tìm việc nhất.
KV Cache , lưu trữ các K và V đã tính toán để tránh việc mỗi lần tạo ra một từ lại phải tính lại từ đầu.
FlashAttention , sắp xếp lại thứ tự tính toán attention để giảm thiểu việc đọc ghi VRAM.
PagedAttention , mượn tư tưởng phân trang của hệ điều hành để quản lý VRAM cho KV Cache, là hạt nhân cốt lõi của vLLM.
định lượng , nén trọng số model từ 16-bit xuống 8-bit hoặc thậm chí 4-bit.
Speculative decoding , để một model nhỏ viết nháp trước, model lớn sẽ xác thực hàng loạt.
Framework suy luận , chẳng hạn như vLLM và SGLang, tích hợp toàn bộ các kỹ thuật kể trên lại với nhau.
Điểm khởi đầu nên bắt đầu từ KV Cache. Nó là kỹ thuật đơn giản nhất và cũng là nền tảng cho mọi tối ưu hóa phía sau.
Tuyến huấn luyện: Phù hợp với những ai muốn hiểu tại sao mô hình lớn (LLM) lại đắt đến thế
Scaling Law , với một mức sức mạnh tính toán nhất định, phân bổ số lượng tham số và lượng dữ liệu thế nào cho tối ưu nhất.
Dữ liệu và tokenization , làm sạch, lọc trùng lặp và căn chỉnh tỷ lệ dữ liệu; phần này thường ảnh hưởng tới hiệu quả còn lớn hơn cả việc thay đổi kiến trúc.
Độ chính xác hỗn hợp (Mixed precision) , huấn luyện bằng BF16 thậm chí FP8, vừa tiết kiệm VRAM vừa tăng tốc độ.
Song song hóa phân tán , khi một GPU không chứa vừa thì song song dữ liệu, song song tensor, song song pipeline và ZeRO sẽ chia nhỏ thế nào.
Lập lịch learning rate , Warmup kết hợp suy giảm cosine, kỹ năng nền tảng cho sự ổn định khi huấn luyện mô hình lớn (LLM).
Tuyến này có ngưỡng thực hành cao nhất, phần lớn mọi người chỉ cần hiểu nguyên lý là đủ.
Tuyến căn chỉnh: Phù hợp với những ai muốn fine-tune, muốn đọc hiểu R1
SFT , fine-tune có giám sát, dùng dữ liệu hỏi đáp để dạy model làm theo chỉ thị.
LoRA và QLoRA , chỉ huấn luyện một phần nhỏ tham số bổ sung, một card đồ họa phổ thông cũng có thể fine-tune.
RLHF , Reward Model kết hợp PPO, chính là phương pháp của InstructGPT.
DPO , bỏ qua Reward Model, huấn luyện trực tiếp bằng dữ liệu thị hiếu gồm “câu trả lời tốt và câu trả lời kém”.
GRPO , phương pháp học tăng cường do DeepSeek đề xuất, không cần Value Model riêng biệt, quá trình huấn luyện của R1 đã sử dụng phương pháp này.
Nếu muốn bắt tay vào làm, LoRA là điểm xuất phát tối ưu chi phí nhất.
Tuyến kiến trúc: Phù hợp với những ai muốn đọc hiểu báo cáo kỹ thuật của các model mới
Tuyến này chính là phần mở rộng của trạm thứ 5 “thay linh kiện”.
RMSNorm thay thế LayerNorm.
SwiGLU thay thế hàm kích hoạt FFN ban đầu.
RoPE thay thế mã hóa vị trí tuyệt đối.
GQA cho phép nhiều head chia sẻ KV.
MLA là phương pháp do DeepSeek đề xuất, nén KV xuống số chiều thấp hơn để tiết kiệm VRAM hơn nữa.
Ngữ cảnh dài , cách model xử lý hàng trăm nghìn, thậm chí hàng triệu token.
Phương pháp học rất đơn giản: lấy từng linh kiện đối chiếu với GPT-2 và tự hỏi ba câu hỏi. Ban đầu trông như thế nào? Bây giờ thay bằng cái gì? Giải quyết vấn đề gì?
Tuyến ứng dụng: Tự chọn, nhưng gần với triển khai thực tế nhất
RAG , tăng cường truy xuất, giúp model tra cứu tài liệu trước khi trả lời.
Gọi công cụ , cho phép model gọi hàm bên ngoài và API.
Tác nhân , cho phép model tự lập kế hoạch nhiều bước, gọi công cụ và hoàn thành nhiệm vụ.
Đa phương thức , cho phép model xử lý hình ảnh và giọng nói.
Tôi đánh dấu tuyến này bằng nét đứt không phải vì nó không quan trọng, mà vì mối quan hệ của nó với trục chính là khác biệt. Trục chính và bốn tuyến nhánh khác nói về bản thân model hoạt động như thế nào , còn tuyến ứng dụng nói về cách sử dụng model .
Nếu mục tiêu của bạn là làm sản phẩm, bạn có thể chuyển sang tuyến này sớm hơn. Nhưng khuyên bạn nên đi ít nhất đến trạm thứ 4 rồi hãy qua, nếu không khi gặp vấn đề, bạn sẽ rất khó phân biệt đâu là giới hạn năng lực của model, đâu là do cách dùng của chính mình.
3. Làm sao để đi chuyến tàu này
Cuối cùng là ba lời khuyên.
Thứ nhất, trạm GPT-2 nhất định phải xuống xe.
Đây là điểm neo của toàn bộ bản đồ. Hãy tự tay viết code lại một lần, dẫu code có vụng về thì toàn bộ nội dung phía sau cũng đã có hệ quy chiếu.
Thứ hai, không cần trạm nào cũng phải xuống xe, nhưng phải biết mỗi trạm nằm ở đâu.
Học sâu toàn bộ cả năm tuyến nhánh là sự tích lũy của các chuyên gia ở nhiều hướng khác nhau. Người học thông thường chỉ cần đi hết trục chính, rồi chọn thêm một đến hai nhánh để đào sâu là đã hiểu rõ hơn phần lớn mọi người rồi.
Thứ ba, khi học nguyên lý, hãy lấy một ví dụ nhỏ để tính tay lại một lần.
Chẳng hạn một câu gồm ba từ, vector bốn chiều, hãy tính toán attention từ đầu đến cuối một lượt. Tính một lần trên giấy còn hiệu quả hơn đọc mười bài viết đại chúng.
Về mặt thời gian, nếu đã có nền tảng lập trình, việc học nghiêm túc trục chính mất khoảng hai đến ba tháng. Các tuyến nhánh thì tùy theo nhu cầu, không có điểm dừng, vì lĩnh vực này mỗi tháng lại mọc thêm những trạm mới.
Bản đồ đầy đủ được đặt ở bên dưới, bạn nên lưu lại. Học đến trạm nào, hãy quay lại đối chiếu xem vị trí của mình đang ở đâu.
Ghi chú: Bài viết này được hỗ trợ biên soạn bởi Claude Opus 5.5.
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác