Link bài viết gốc: https://mp.weixin.qq.com/s/DriDFYCPaFkIP...
Tư Biện view · Tài khoản WeChat · kate người khá tốt · 2026-10-19 08:39
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
Chào mọi người, tuần mới bắt đầu với bản tin AI đáng chú ý hôm nay.
01|Cách dùng Grok Bot: Kết nối công cụ trước, dùng trơn tru một bot rồi mới thêm
Người dùng X lauren (@poteto) ghi trong phần giới thiệu rằng cô đang phát triển Grok Bot, và cô đã chia sẻ một lời khuyên rất thực tế dành cho người mới bắt đầu.
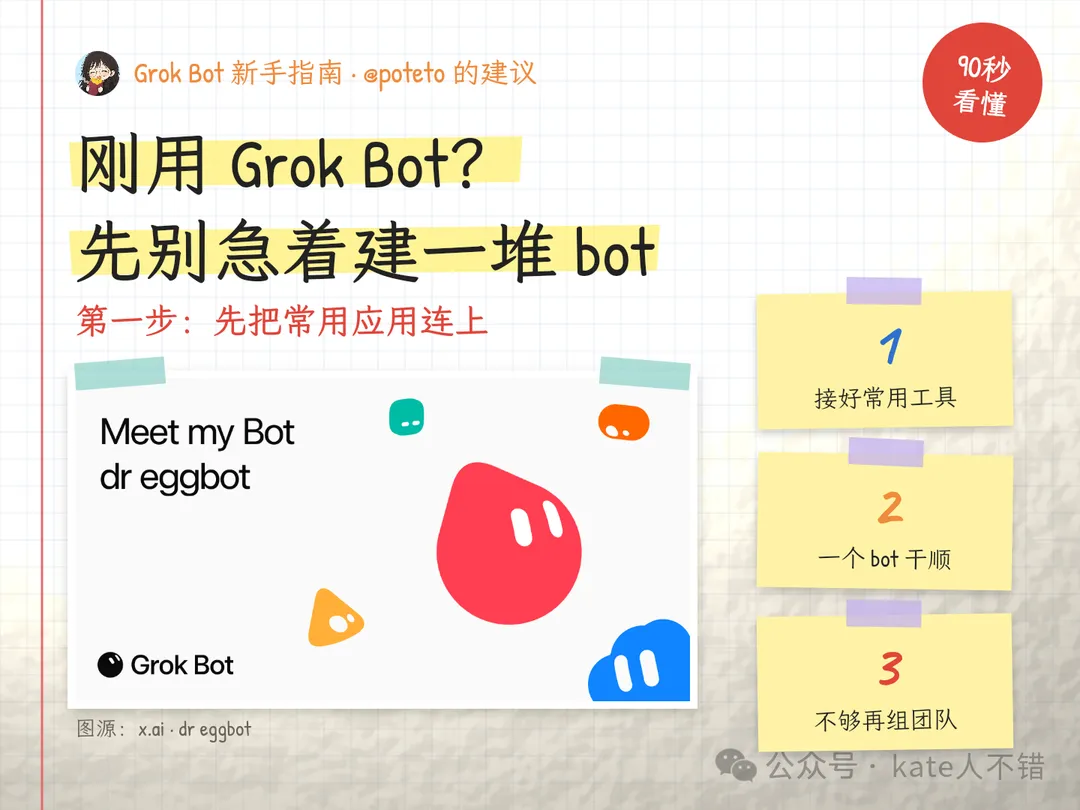
Bước đầu tiên, hãy kết nối các ứng dụng bạn dùng hàng ngày: Lịch, Slack, issue tracker, CRM, Google Drive. Như vậy bot mới hiểu bạn đang làm gì và có đủ công cụ cần thiết để làm việc.
Bước thứ hai, đừng vội tạo nhiều bot. Cô cho biết chỉ riêng bot chính hoạt động độc lập đã rất hiệu quả, khuyên bạn nên giao mọi việc cho một bot trước, đến khi việc quản lý trở nên phức tạp rồi mới tách thêm bot mới.
Khi nào thì nên thêm? Lý do cô đưa ra là sự phân công chuyên môn và phân loại công việc: một bot giống như một trợ thủ, còn nhiều bot lại giống một đội ngũ hơn. Ví dụ, người làm GTM có thể để một bot chuyên phụ trách một khách hàng, hoặc thiết lập bot chuyên trách, chẳng hạn như Outreach bot chuyên lo việc liên hệ đối ngoại.
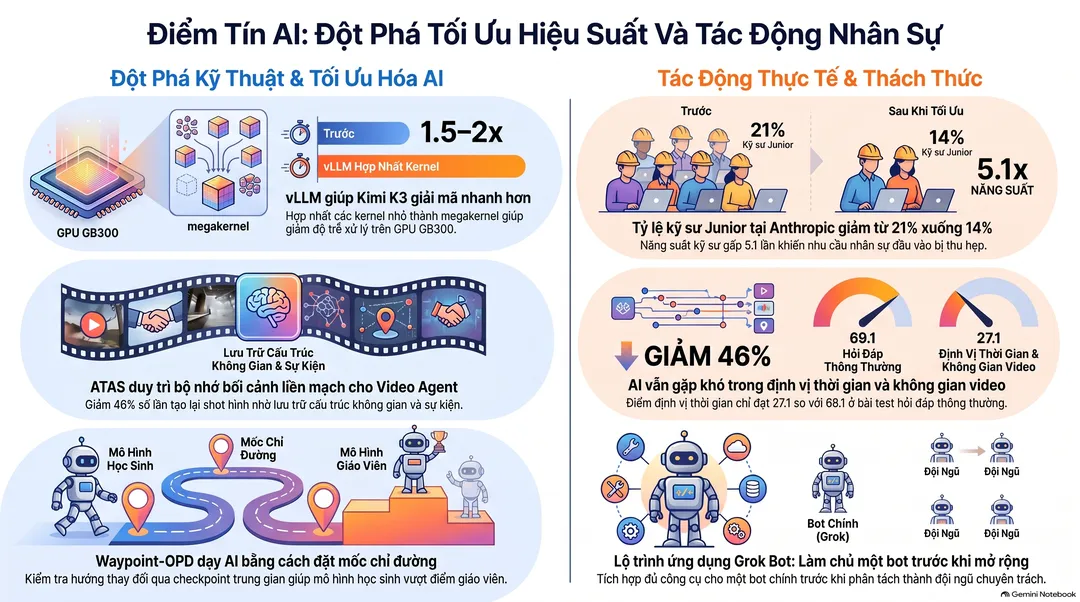
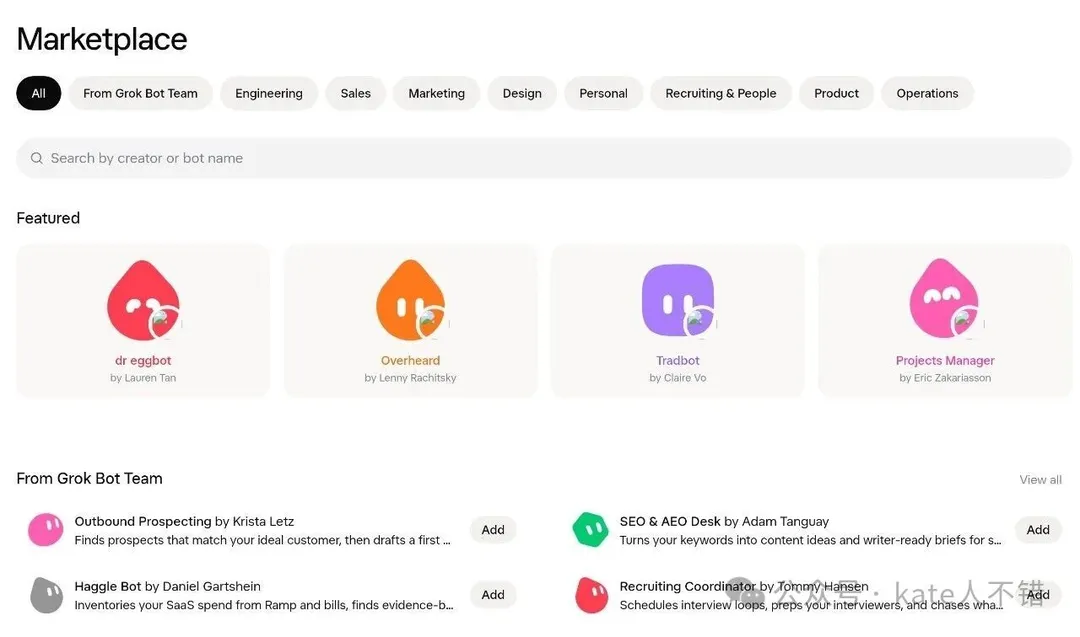
Khi thực sự muốn mở rộng, bạn có thể vào bot marketplace để chọn những bot có sẵn, hoặc thử dùng dr eggbot – công cụ thiết kế bot do cô phát triển. Nó sẽ hỏi trước vài câu về sở thích và nhu cầu, sau đó giúp bạn thiết kế rồi tạo bot mới.
02|ATAS: Lập một "cuốn sổ cái thế giới" cho video agent
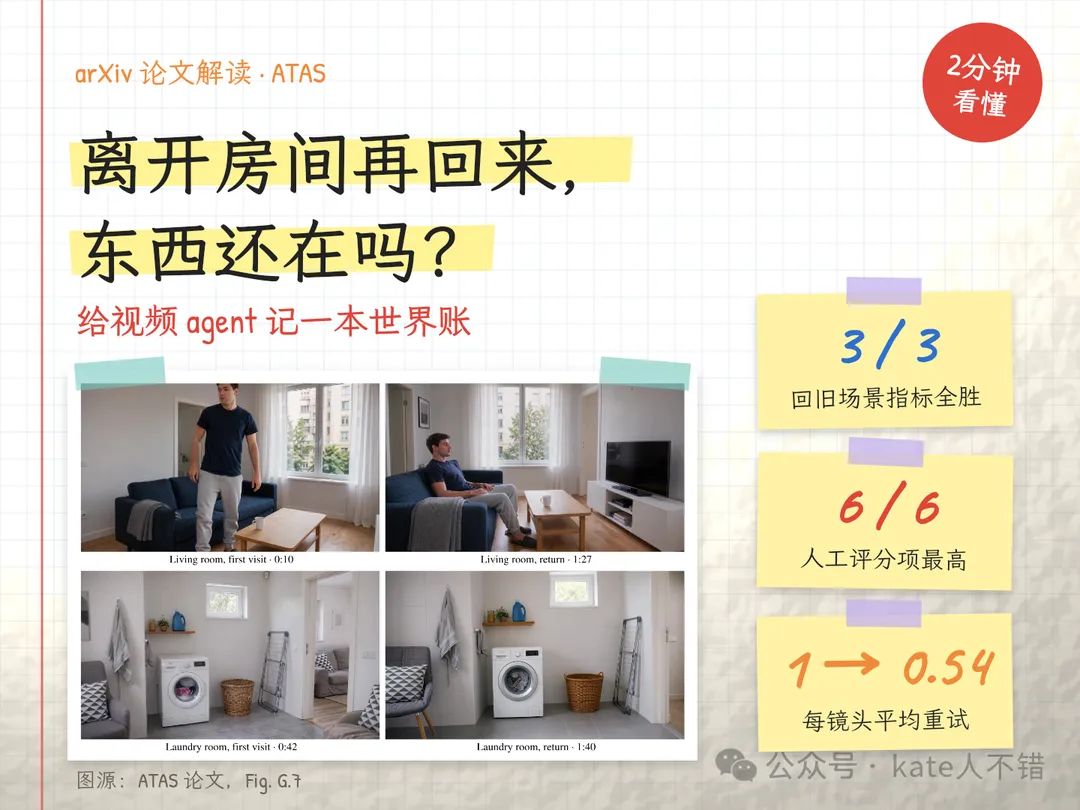
Để AI quay một phim ngắn đa góc máy, việc từng shot hình đẹp mắt giờ không còn khó, điều khó là khi quay lại bối cảnh cũ, đồ vật trên bàn có còn ở nguyên vị trí hay không. Các hệ thống video agent hiện nay phần lớn dựa vào vài frame gần nhất, tóm tắt văn bản hoặc ảnh tham chiếu để duy trì tính liền mạch. Các shot liền kề thì còn ổn, nhưng khi quay lại một bối cảnh từ rất sớm hoặc đổi góc máy để diễn lại một sự việc thì rất dễ bị đứt đoạn.
Bài báo nghiên cứu ATAS (Any Time, Any Space) duy trì một trạng thái thế giới liên tục cho toàn bộ bộ phim: scene memory dùng point cloud để lưu cấu trúc không gian tĩnh, còn event memory lưu các đoạn hành động động theo trục thời gian. Mỗi shot trước tiên được chia nhỏ thành các request, mô tả rõ bối cảnh, góc máy, thời gian và sự kiện, sau đó lấy tham chiếu từ cả hai phần memory này rồi chuyển cho model sinh video. Bước then chốt là không tin tưởng trực tiếp vào đoạn video được tạo ra: chỉ khi vượt qua các bước kiểm duyệt shot, tái dựng và căn chỉnh khớp với tọa độ bối cảnh thì mới được ghi ngược lại vào memory.
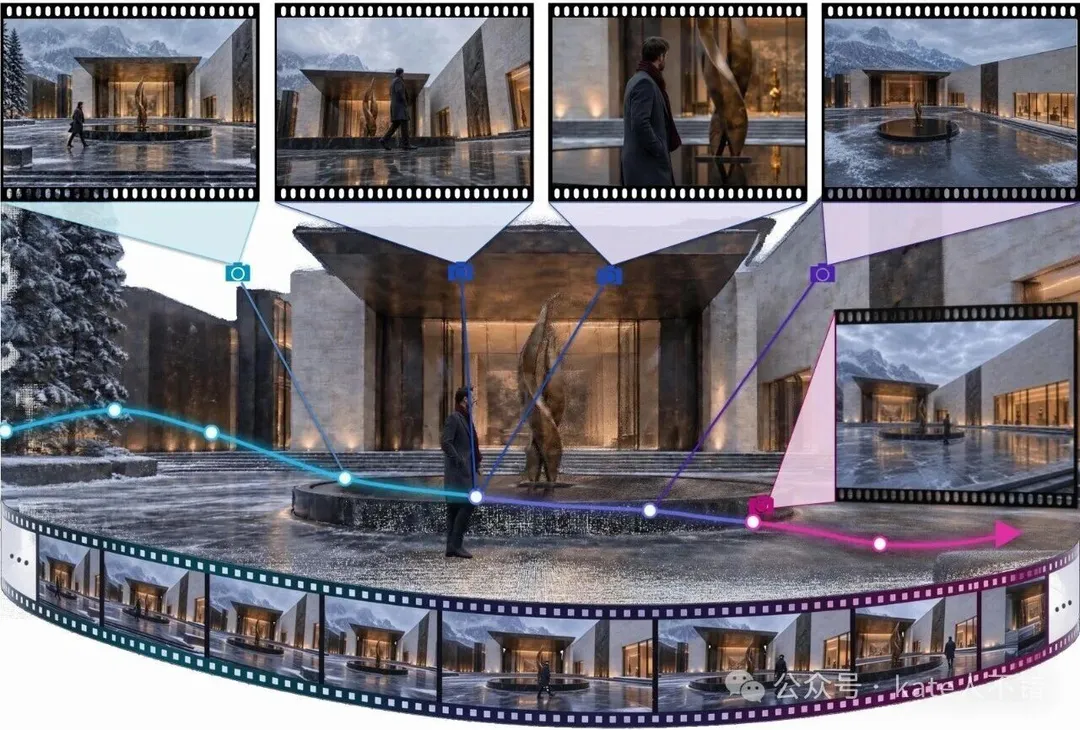
Kết quả: So sánh giữa 4 model sinh video và 5 phương pháp agent, ATAS đều đạt điểm tổng hợp cao nhất ở mỗi nhóm, nhưng riêng hạng mục VBench trên Wan 2.7 lại thua ReCA (0.846 so với 0.854); khi quay lại bối cảnh cũ, cả 3 chỉ số PSNR, SSIM, LPIPS đều tốt nhất; điểm đánh giá thủ công của con người đạt cao nhất ở cả 6 tiêu chí. Cái giá phải trả là số lần thử lại trung bình mỗi shot giảm từ 1.00 xuống 0.54 lần, nhưng tổng thời gian cho mỗi câu chuyện lại tăng từ 51.9 phút lên 64.9 phút.
Điểm đáng chú ý: Tính liền mạch ổn định hơn được đánh đổi bằng nhiều sức mạnh tính toán hơn.
03|OmniCompass: AI biết trả lời câu hỏi, nhưng lại không xác định chuẩn thời gian và địa điểm
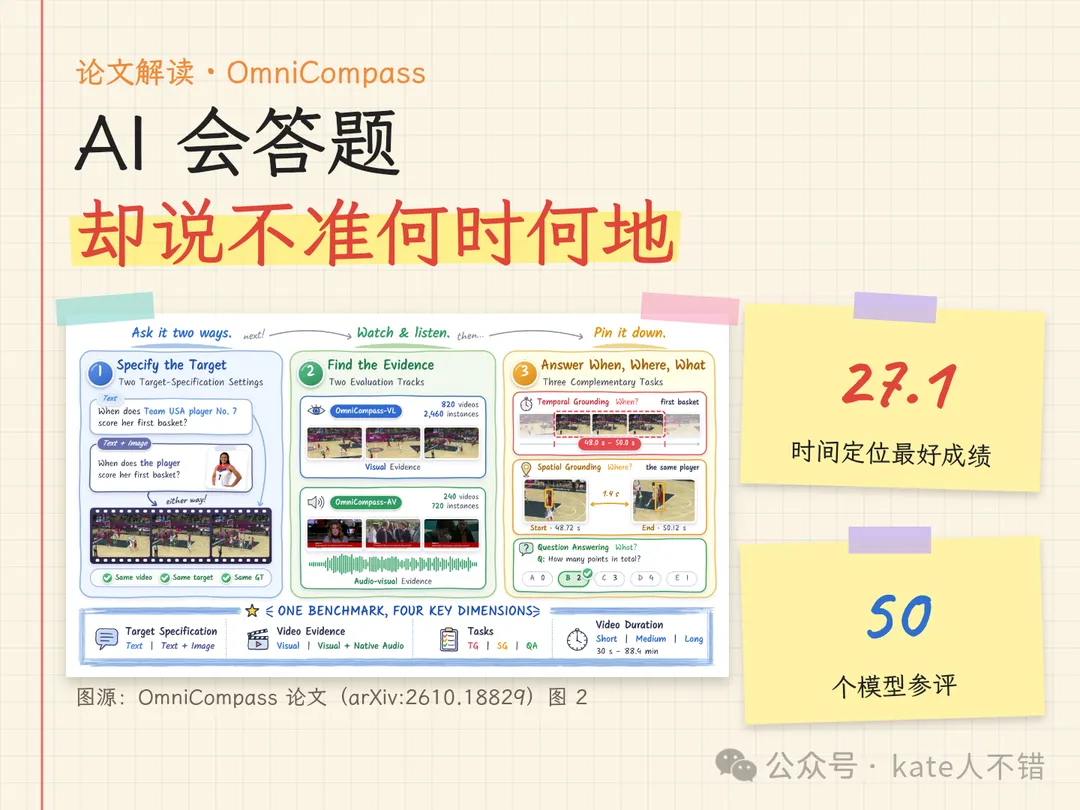
Cho AI xem video rồi hỏi chuyện gì đã xảy ra, nó trả lời khá tốt; nhưng khi yêu cầu nó chỉ ra chính xác ở giây thứ mấy, tại vị trí nào trên khung hình thì lộ ngay điểm yếu.
Benchmark mới OmniCompass từ nhóm nghiên cứu Đại học Bách khoa Hồng Kông cùng các đơn vị khác đặt ra 3 câu hỏi liên tiếp trên cùng một video: Khi nào (định vị thời gian), Ở đâu (định vị không gian), Chuyện gì đã xảy ra (hỏi đáp). Cùng một mục tiêu còn có hai cách hỏi: chỉ dùng văn bản, hoặc văn bản kèm ảnh tham chiếu. Mảng VL chỉ nhìn hình ảnh, còn mảng AV phải nghe cả âm thanh. Tổng cộng có 820 video, 2.460 câu hỏi cho mảng VL, toàn bộ được gán nhãn thủ công với khoảng 1.800 giờ công.
Bài báo đã thử nghiệm 50 model. Đứng đầu tổng hợp mảng VL là Gemini-3.8-Flash với 42.8 điểm, đứng đầu mã nguồn mở là Kimi-K3 với 39.6 điểm. Khi yêu cầu phải trả lời đúng ở cả hai cách hỏi, điểm hỏi đáp tốt nhất đạt 69.1, trong khi định vị thời gian tốt nhất chỉ đạt 27.1. Khi thêm âm thanh, khoảng cách càng nới rộng, mảng AV là 57.4 so với 24.6. Ảnh tham chiếu cũng chưa chắc đã hữu ích, trong 36 model chỉ có 11 model cải thiện điểm trung bình; khi gắn timestamp cho từng frame, điểm định vị thời gian của cả hai model đều tăng khoảng 18 điểm.
04|Dữ liệu nhân sự nội bộ của Anthropic: agent càng giỏi việc, các vị trí junior càng giảm trước
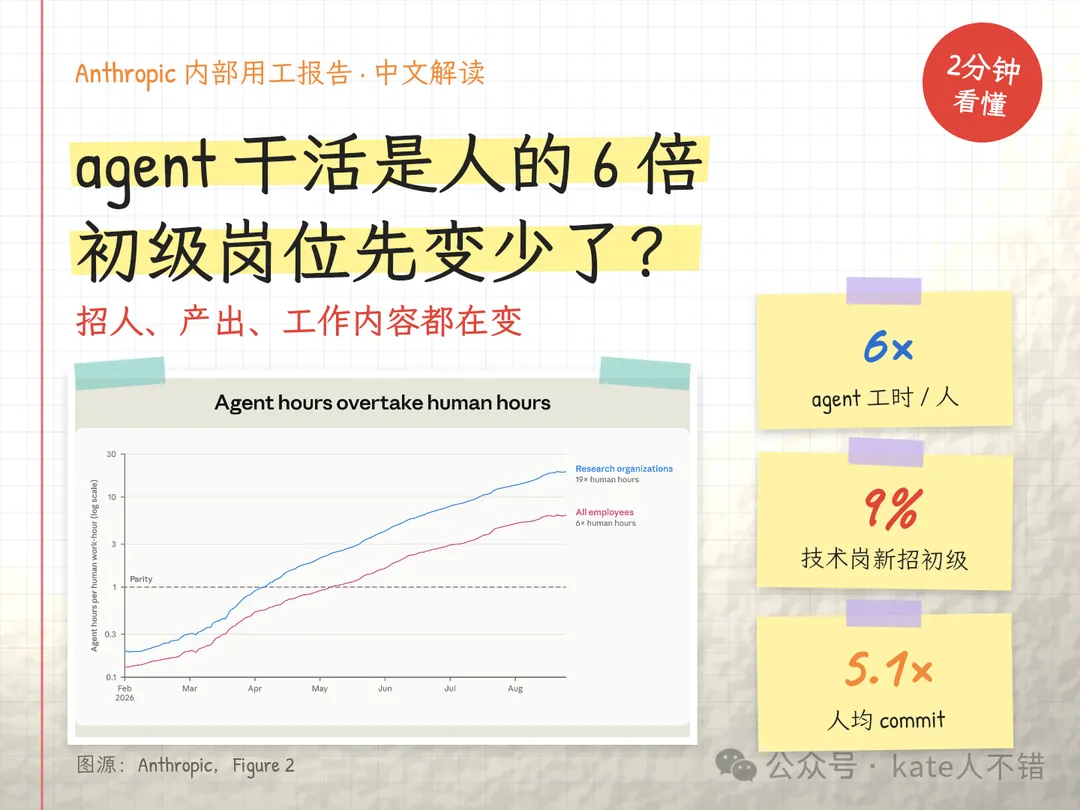
Anthropic vừa công bố một báo cáo nghiên cứu về chính công ty mình, sử dụng dữ liệu nội bộ về việc làm, mức độ sử dụng AI, hiệu suất đầu ra, lịch làm việc và tuyển dụng, đồng thời phỏng vấn 17 nhân viên.
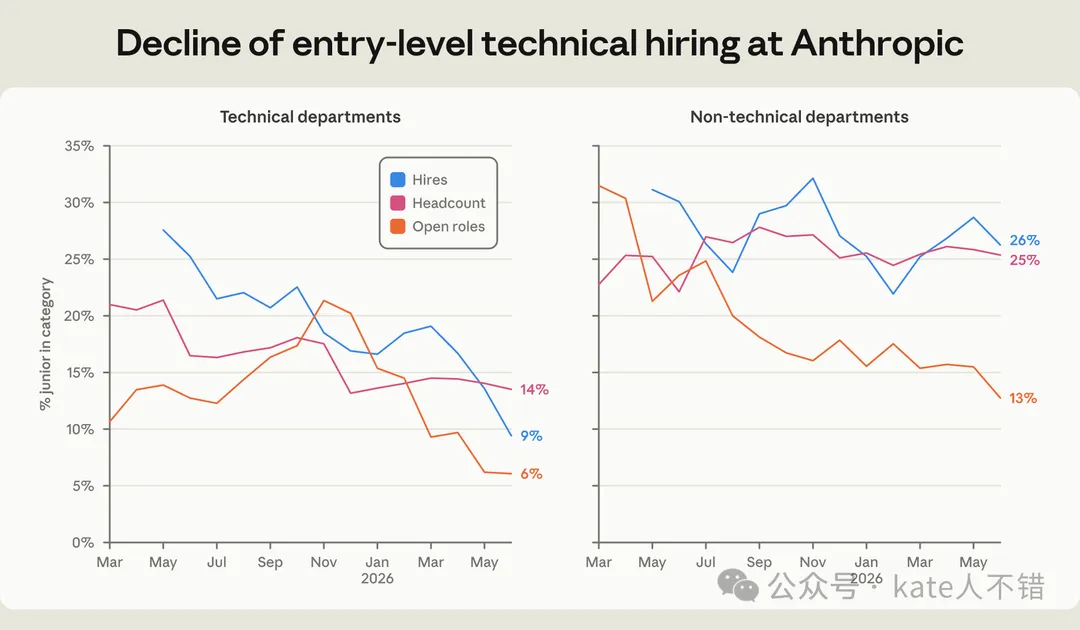
Trước hết là về tuyển dụng: Tỷ lệ nhân viên junior tại vị ở bộ phận kỹ thuật giảm từ 21% xuống 14%, tỷ lệ junior trong số nhân sự mới tuyển giảm từ 27% xuống 9%; các bộ phận phi kỹ thuật nhìn chung giữ mức ổn định. Số giờ làm việc của các interactive agent do nhân viên gọi đã gấp 6 lần giờ làm của nhân viên, riêng bộ phận nghiên cứu lên tới 19 lần.
Về mặt hiệu suất đầu ra, số lượng commit trung bình mỗi kỹ sư gấp 5.1 lần trước đây, nhưng trong cùng giai đoạn kinh doanh cũng bùng nổ nên không thể quy hết công lao cho AI. Nút thắt mới giờ đây lại chính là con người: khoảng 80% thời gian trong các phiên hội thoại tương tác là Claude phải chờ người dùng phản hồi; các loại meta work như dựng công cụ, viết quy chuẩn, giám sát pipeline của agent đã tăng tỷ lệ trong phiên hội thoại từ 10% lên 22%. Tỷ lệ nhận xét phỏng vấn nhắc đến khả năng sử dụng công cụ AI ở các vị trí kỹ thuật đã tăng khoảng 3 lần.
Giải pháp ứng phó của công ty là cho nhân viên sở hữu cổ phần rộng rãi, cảnh báo rủi ro vị trí công việc, ưu tiên luân chuyển nội bộ, nhưng tác giả cũng thừa nhận rằng những điều này không giúp ích được gì cho những người ngay từ đầu đã không được tuyển dụng.
Điểm đáng chú ý: Con người ngày càng giống như người quản lý của agent, trong khi các vị trí junior lại bị thu hẹp đầu tiên.
05|Waypoint-OPD: Đặt mốc chỉ đường ở giữa chặng huấn luyện teacher, student học hiệu quả hơn
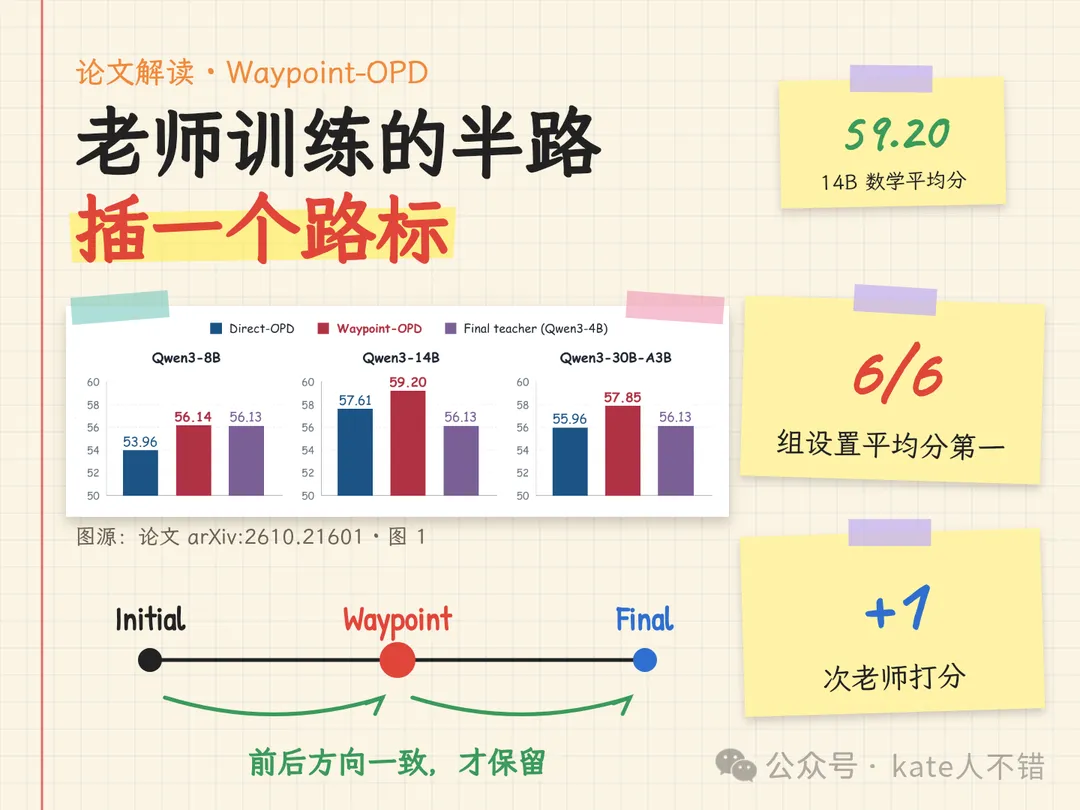
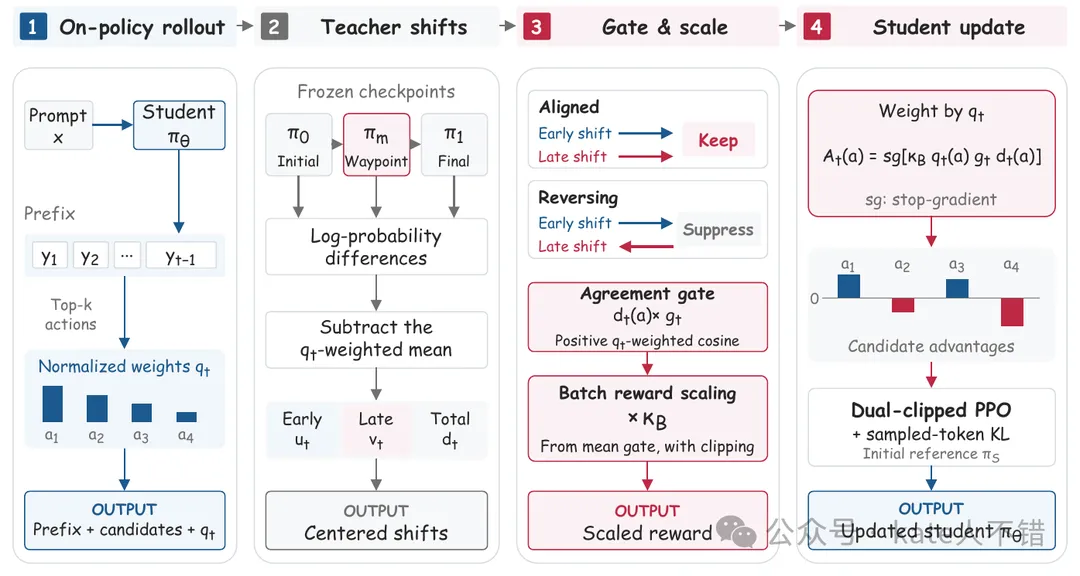
Kỹ năng được rèn luyện từ học tăng cường liệu có thể dạy trực tiếp cho model khác không? Phương pháp cũ Direct-OPD chỉ nhìn vào mức độ thay đổi xác suất của mỗi từ trước và sau khi teacher được huấn luyện, rồi lấy sự thay đổi đó làm reward để dạy cho student. Vấn đề là với cùng một mức thay đổi ở điểm kết thúc, quá trình có thể luôn cùng hướng, hoặc cũng có thể lao quá đà rồi mới quay ngược trở lại, nếu chỉ nhìn vào hai đầu mút thì không thể phân biệt được.
Waypoint-OPD của đội ngũ Alibaba Cloud lưu thêm một checkpoint chỉ đường ở giữa chặng của cùng một phiên huấn luyện RL (bước thứ 600), để 3 frozen teacher gồm Initial, Waypoint, Final cùng chấm điểm, sau đó so sánh hướng thay đổi của hai giai đoạn trước và sau: nếu nhất quán thì giữ lại, nếu ngược hướng thì nén bớt. Chi phí bỏ ra chỉ là thêm một lần chấm điểm từ frozen teacher.
Dùng teacher Qwen3-4B dạy cho 3 student gồm 8B, 14B và 30B-A3B, điểm trung bình ở cả 6 thiết lập toán học và lập trình đều đứng thứ nhất; student 14B đạt điểm toán trung bình 59.20, cao hơn mức 56.13 của teacher. Tuy nhiên không phải hạng mục nào cũng đứng đầu: trong 21 bài test toán có 2 bài thấp hơn một chút so với Direct-OPD, còn ở mảng code thì OPD2 có 3 hạng mục riêng lẻ đạt điểm cao hơn.
Tóm lại một câu: Không chỉ nhìn vào đích đến, mà còn xem hướng đi dọc đường có đúng hay không.
06|vLLM chạy Kimi K3: Hợp nhất kernel, giải mã nhanh hơn 1.5–2 lần
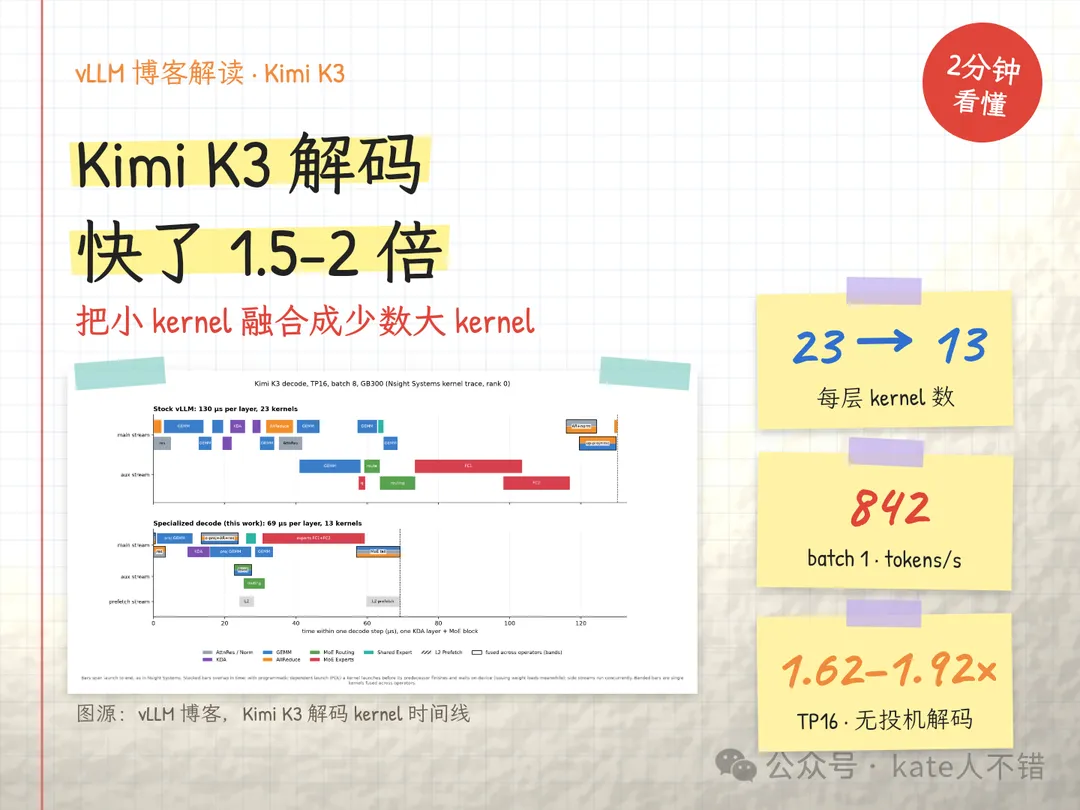
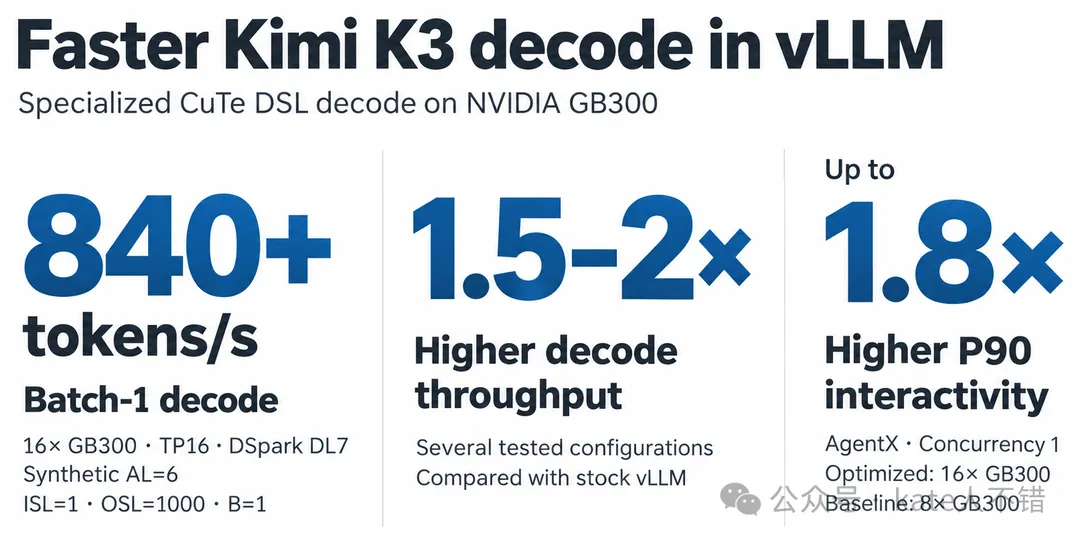
Một bài viết của kỹ sư NVIDIA trên blog vLLM chia sẻ cách họ tận dụng coding agent và CuTe DSL để viết một đường dẫn giải mã chuyên biệt cho Kimi K3. URL gọi đây là megakernel, thực chất là việc hợp nhất nhiều kernel nhỏ vốn được khởi chạy tuần tự trong mỗi bước giải mã thành số lượng ít hơn các kernel lớn hơn: theo timeline trên Nsight, mỗi layer giảm từ 23 kernel xuống còn 13 kernel, thời gian giảm từ 130 µs xuống 69 µs. Ngoài ra còn có vài chiêu thức khác như xử lý chồng lấn giữa truyền thông và tính toán, phân bổ MoE routing đều sang các card, và prefetch trọng số trong khoảng thời gian truyền thông rảnh rỗi.
Kết quả đều được ghi nhận trên GB300: cấu hình 16 card, batch 1, khi bật speculative decoding đạt 842 token/s, bản gốc là 488 token/s, nhanh gấp 1.73 lần (độ dài chấp nhận tổng hợp là 6); khi không dùng speculative decoding, TP16 nhanh hơn 1.62–1.92 lần, TP8 nhanh hơn 1.31–1.58 lần. Giới hạn cũng được nêu rất rõ: cần bật thủ công, chỉ hỗ trợ giải mã, giai đoạn prefill và mixed batch sẽ quay về bản gốc.
Điểm đáng chú ý: Giảm bớt số lần khởi chạy kernel giúp GPU ít bị trễ nhịp hơn.
Liên kết tham khảo
- Grok Bot marketplace: https://x.ai/bot/marketplace
- Bài báo nghiên cứu ATAS: https://arxiv.org/abs/2610.20571
- Bài báo nghiên cứu OmniCompass: https://arxiv.org/abs/2610.18829
- Báo cáo của Anthropic "How employment is changing at Anthropic": https://www.anthropic.com/research/employment-at-anthropic
- Bài báo nghiên cứu Waypoint-OPD: https://arxiv.org/abs/2610.21601
- Blog vLLM: https://vllm.ai/blog/2026-10-16-kimi-k3-megakernel
- vLLM PR #61867: https://github.com/vllm-project/vllm/pull/61867
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác