Link bài viết gốc: https://mp.weixin.qq.com/s/5ej9Jipiibz10...
PaperAgent · WeChat Official Account · PaperAgent · 2026-10-25 10:29
Bài viết này được chia sẻ lại, bản quyền thuộc về tác giả gốc, toàn văn căn cứ theo link bài gốc
Xin chào mọi người, tôi là PaperAgent, không phải Agent!
Anthropic Trang web chính thức vừa đăng một bài blog rất hay về thực hành kỹ thuật Agent, chủ đề chỉ có một: subagent không phải càng nhiều càng tốt . Điểm cuối của memory trong Agent hóa ra lại là RAG
Trong các so sánh giữa nhiều đợt triển khai thực tế cấp doanh nghiệp, " một Agent Loop chính + skills và tools được tiết lộ lũy tiến " về mặt chất lượng đã vượt qua cả hai kiểu thiết kế: "một prompt cân cả thế giới" và "điều phối đa subagent", hơn nữa chi phí và độ trễ thường thấp hơn .
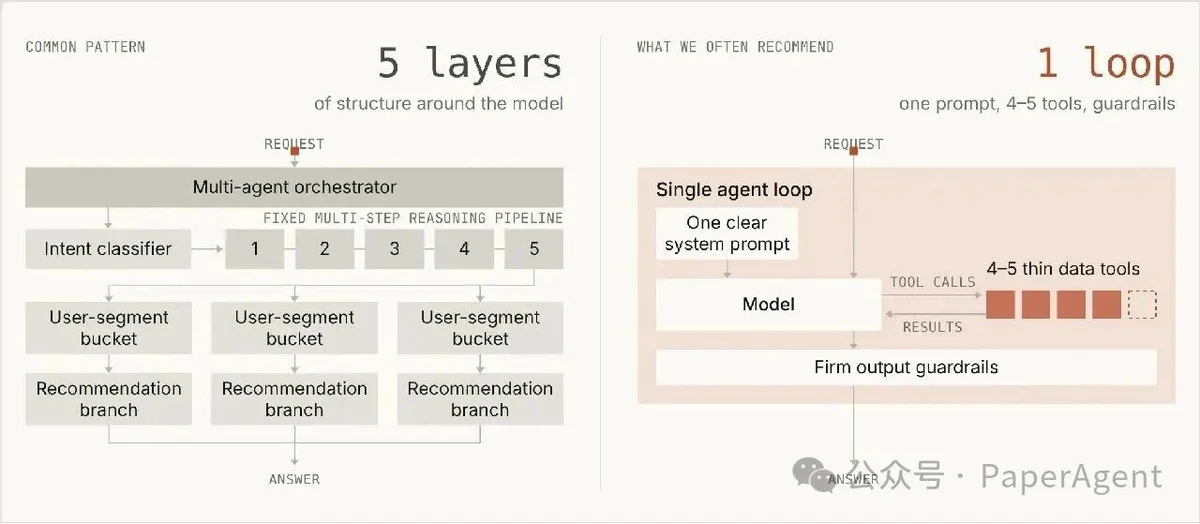
Sơ đồ so sánh giữa kiến trúc đa subagent và đơn Loop
Một công ty thậm chí phát hiện ra rằng, hơn chục subagent chuyên trách trong agent chăm sóc khách hàng của họ khiến trải nghiệm thương hiệu thống nhất gần như không thể duy trì, độ trễ còn gây tổn hại đến trải nghiệm người dùng.
1. Kiến trúc agent biến thành bản sao sơ đồ cơ cấu tổ chức
Bài viết trước hết review lại lộ trình kinh điển khi các tổ chức lớn xây dựng agent: mỗi team tự làm một agent, rồi team nền tảng trung tâm phủ lên trên một orchestrator. Nhìn qua thì có vẻ đỡ tốn công nhất, nhưng thực tế lại kéo theo hàng tá rắc rối ngay lập tức:
- Quản lý ngữ cảnh : truyền tin qua lại giữa các agent, chi tiết bị thất lạc trong quá trình bàn giao;
- subagent tràn lan : mỗi team đều phát hành subagent riêng của mình, cuối cùng hàng trăm cái chồng chéo nhau, không có tiêu chuẩn, không ai chịu trách nhiệm;
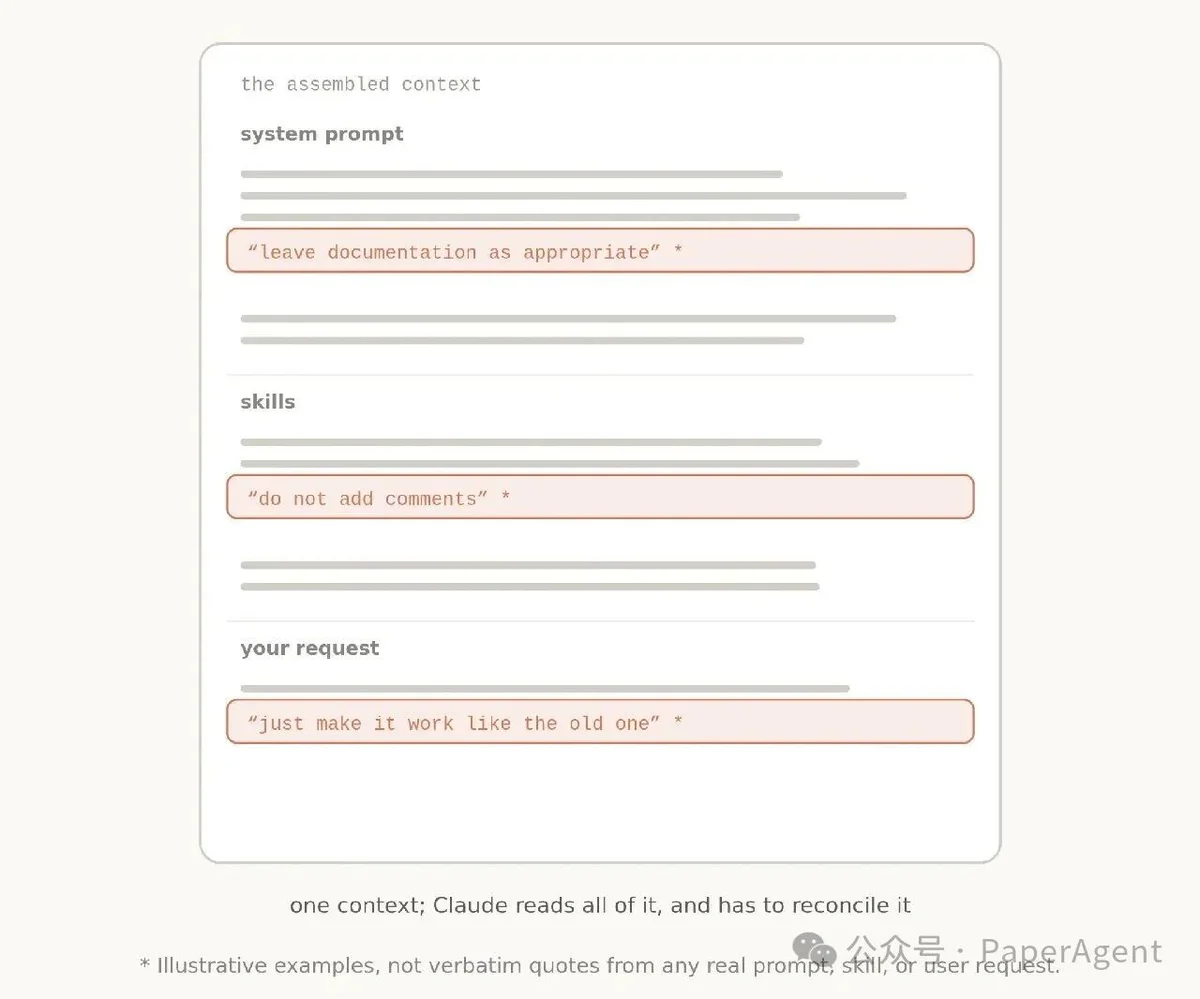
- Frankenprompt : mỗi team chèn thêm một câu vào system prompt, các quy tắc xung đột lẫn nhau, giọng điệu trước sau bất nhất;
- đánh giá mạnh ai nấy làm : mỗi team chỉ tối ưu subtask của riêng mình, không ai chịu trách nhiệm về chất lượng tổng thể, ban lãnh đạo chỉ thấy điểm số bị pha loãng;
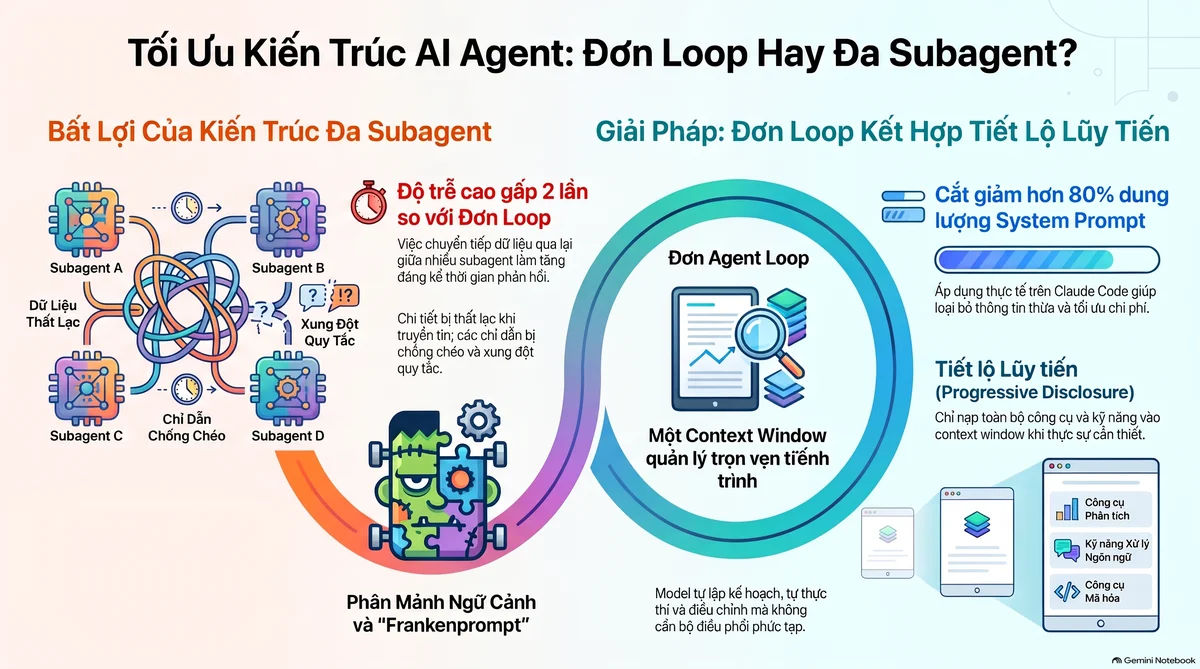
- Độ trễ : có khách hàng đã đem framework đa agent và agent loop đơn ra đo đạc thực tế, kết quả là cái sau có tốc độ chạy nhanh hơn khoảng 2 lần .
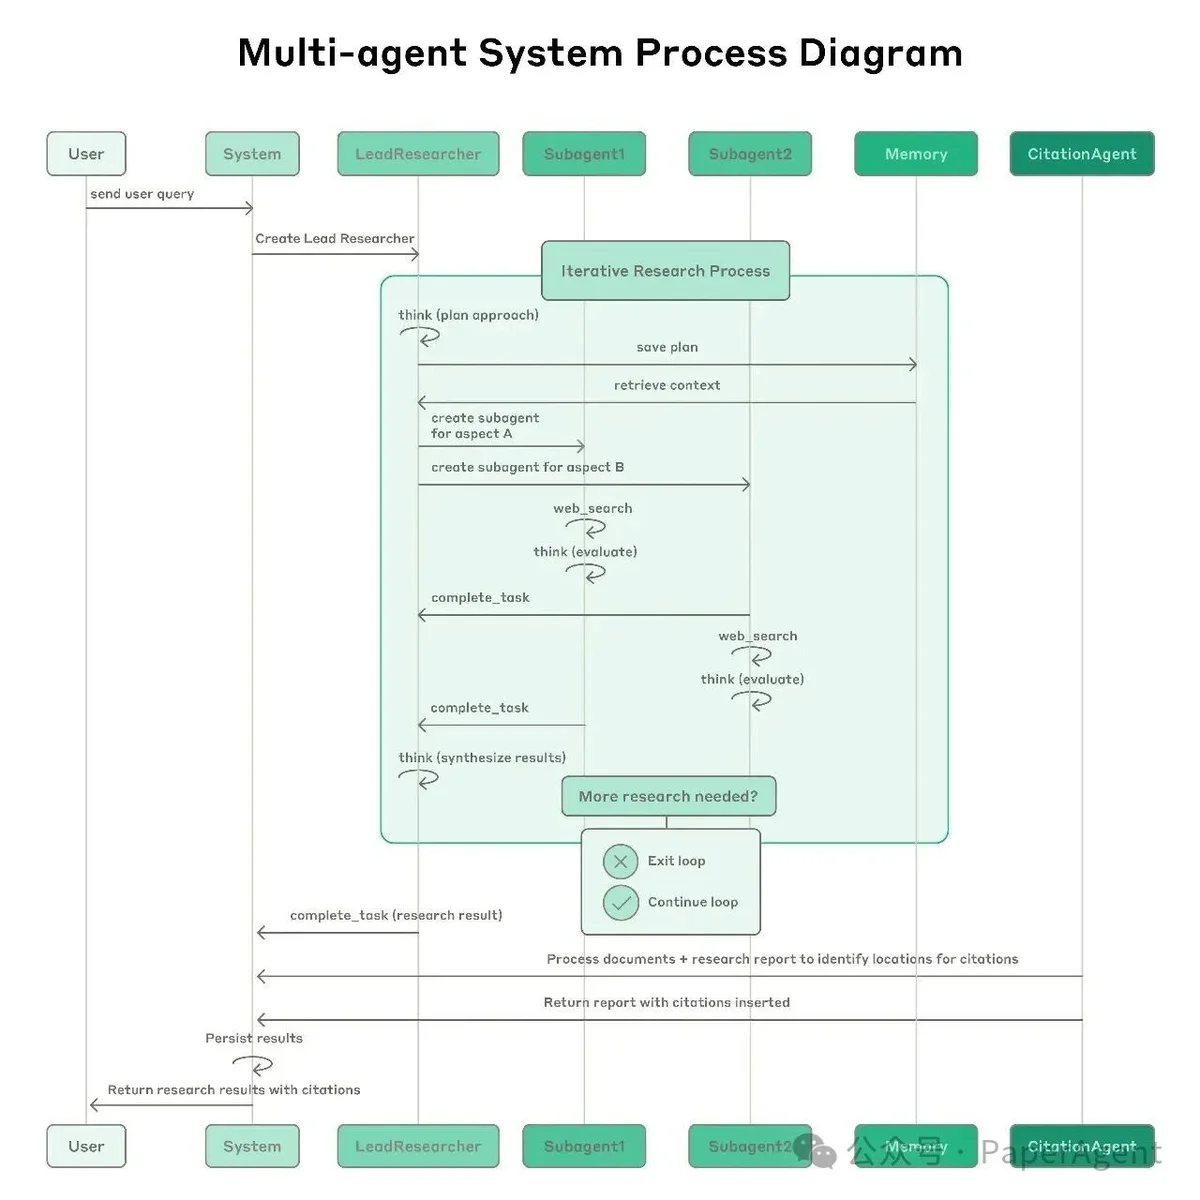
Anthropic quy hiện tượng này về sự tái hiện của Định luật Conway trong lĩnh vực agent: kiến trúc agent biến thành bản photocopy sơ đồ tổ chức . Bản thảo thiết kế thường thấy hơn là bộ công thức quen thuộc — bộ phân loại ý định, pipeline suy luận đa bước cố định, phân khúc người dùng, nhánh đề xuất độc lập, rồi chồng thêm một bộ điều phối đa agent.
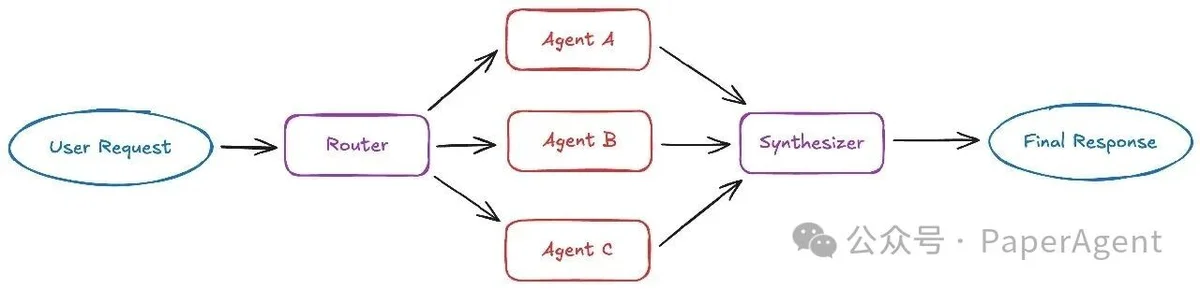
Nhưng phản hồi nhận lại thường là: phần lớn công việc mà các cấu trúc này thực hiện thì model đã không còn cần ai làm thay nữa, chỉ một system prompt rõ ràng, 4 đến 5 công cụ dữ liệu mỏng nhẹ, cùng các rào chắn đầu ra nghiêm ngặt là đã có thể bao quát phần lớn các kịch bản.
2. Giải pháp: Đơn Agent Loop kết hợp tiết lộ lũy tiến
Vậy cách tiếp cận đúng đắn là gì? Câu trả lời của bài viết là Tiết lộ dần dần : context được tải lũy tiến qua skills, công cụ được tải lũy tiến qua tool search — agent bình thường chỉ nhìn thấy mô tả ngắn gọn, khi thực sự cần mới nạp toàn bộ.
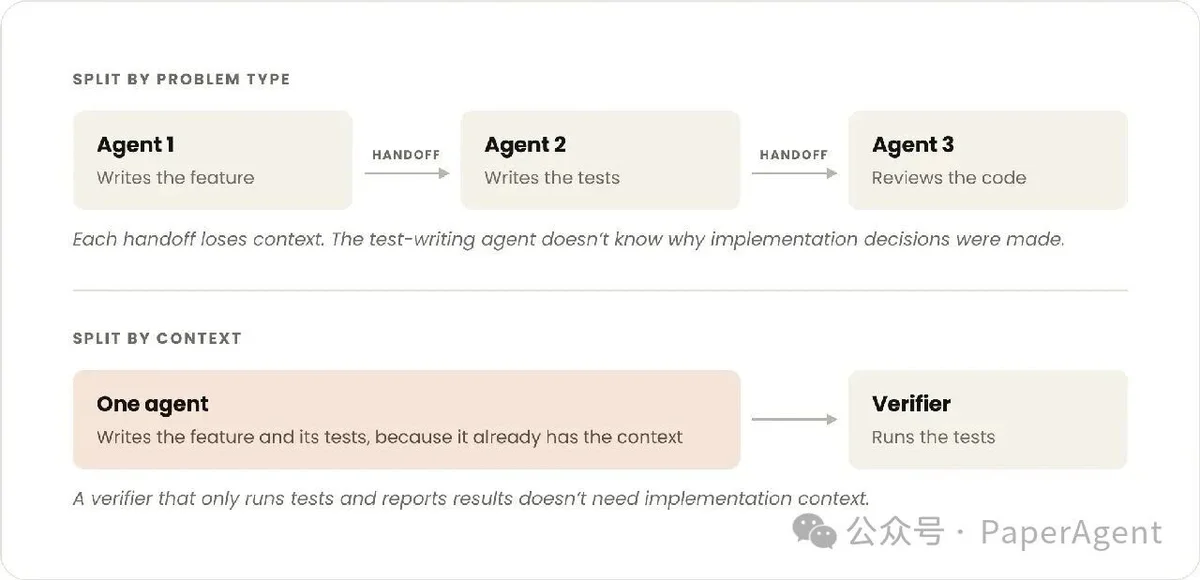
Chia nhỏ agent theo loại vấn đề sẽ rơi vào "trò chơi tam sao thất bản", mỗi lần bàn giao đều làm hao hụt độ chân thực của thông tin
Có ba lý do củng cố cho phương án này:
- Chia sẻ context tạo ra câu trả lời tốt hơn : agent chạy dài hạn (long-running) đặt context của nhiều tác vụ vào cùng một cửa sổ, model có thể thấy kết quả của từng bước để xâu chuỗi chúng lại, phong phú hơn nhiều so với một đống tóm tắt do subagent gửi về;
- Tiết lộ lũy tiến giải quyết vấn đề phình to context : không cần phải nhồi nhét mọi thứ vào một system prompt siêu dài, lý do chính để phân chia subagent trước đây cũng biến mất — Anthropic tiết lộ rằng system prompt của Claude Code dành cho các model mạnh hơn đã **cắt giảm hơn 80%**, bao gồm cả việc cải tiến theo hướng tiết lộ lũy tiến skills và tools;
- Bản thân model đã mạnh hơn : kể từ Opus 4.5, những việc mà một Loop đơn có thể đảm nhiệm đã vượt xa kỳ vọng của đa số các team; cơ chế suy nghĩ của Opus 5.5 và Fable 5.1 không thể tắt đi, thế hệ model mới vừa làm vừa tự thuật tiến độ, vừa tự kiểm tra, khiến không ít thành phần trong framework trở nên thừa thãi.
Hình thái cụ thể của đơn Loop cũng rất rõ ràng: một model, một context window, chạy tool loop mở , harness chỉ quản lý ngân sách — giới hạn số lượt, giới hạn chi phí, kiểm soát thao tác ghi.
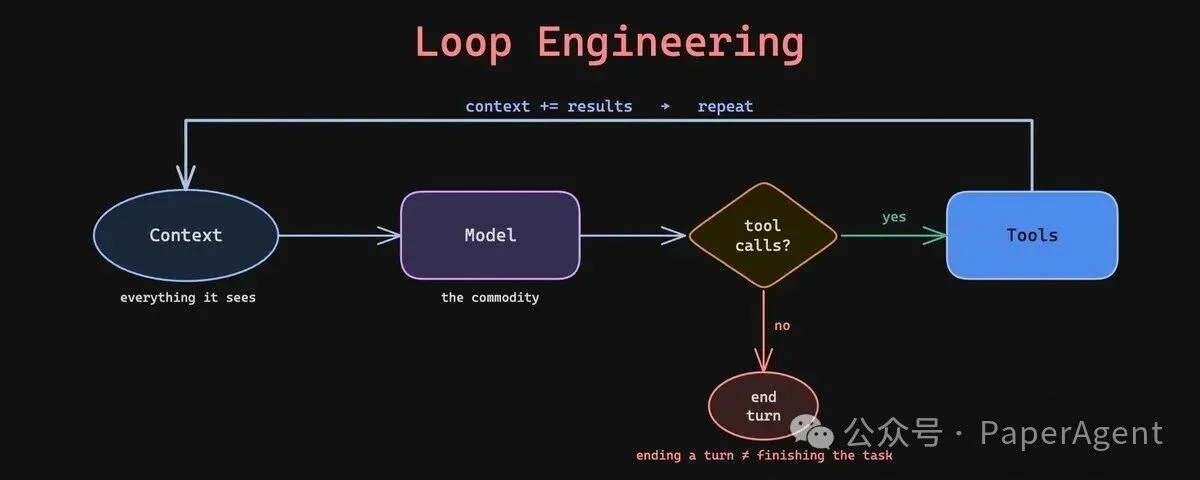
Trong mỗi lượt, model phát ra hàng loạt tool call, harness thực thi song song rồi trả kết quả gốc về cho chính model đó để nó quyết định bước tiếp theo: chạy tiếp một đợt nữa, hỏi người dùng, hay đưa ra câu trả lời. Kế hoạch được model ghi vào context ngay từ lượt đầu tiên và được chỉnh sửa bất cứ lúc nào tùy theo kết quả — model lập kế hoạch cũng chính là model thực thi kế hoạch , đây là điểm khác biệt cốt lõi nhất so với phương án orchestrator.
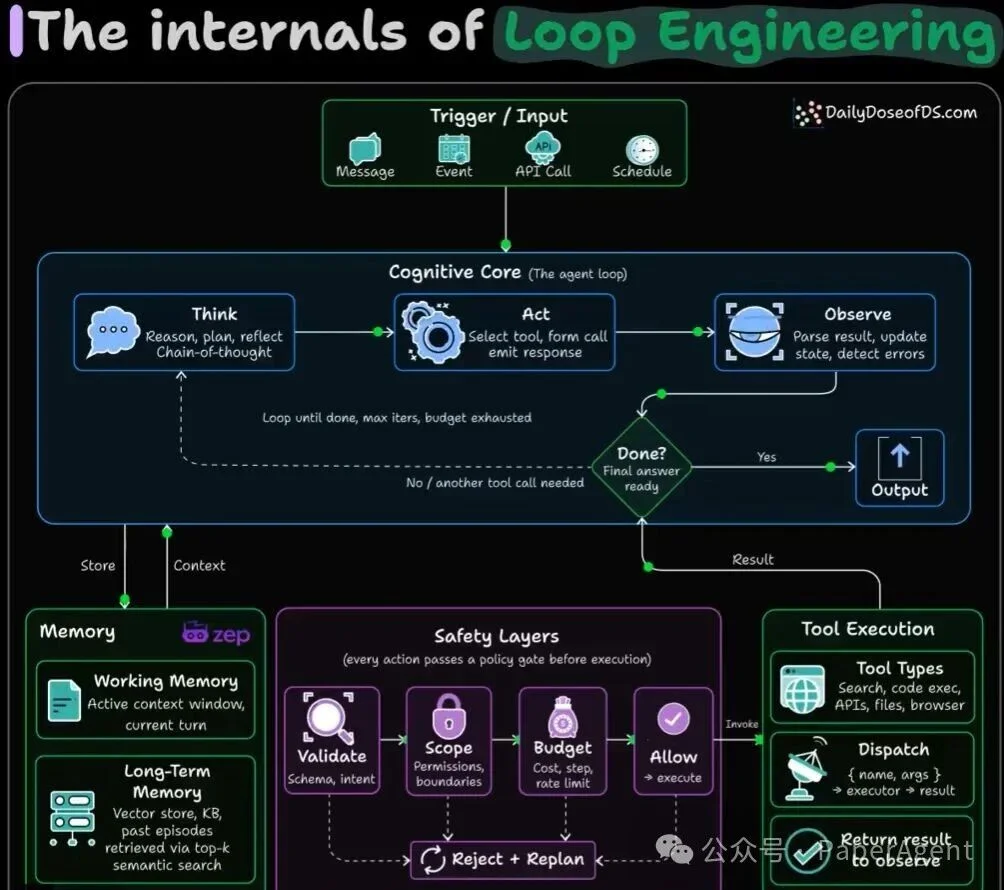
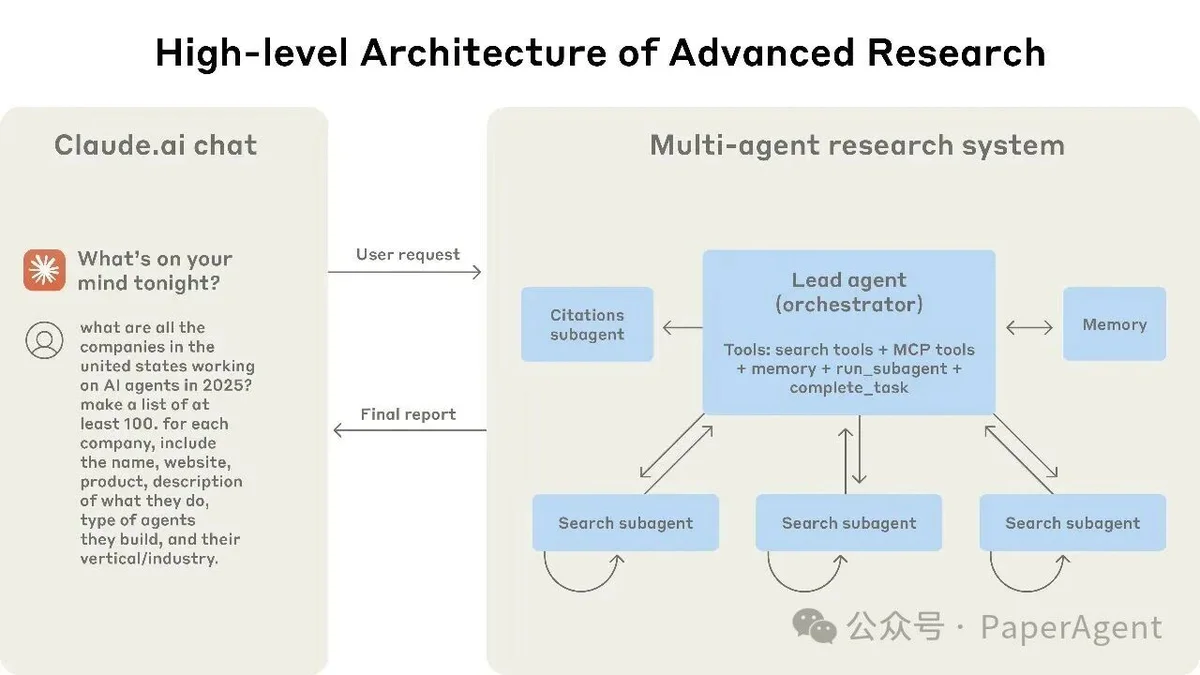
Tất nhiên, subagent không phải hoàn toàn vô dụng. Bài viết đưa ra ba tình huống nên giữ lại: Loop đơn bị suy giảm hiệu năng đo lường được do context phình to ; Nhiều tác vụ cần context sạch, chạy song song và dùng xong bỏ ngay ; Một agent đơn lẻ chọn sai công cụ hoặc các chỉ dẫn trong system prompt xung đột lẫn nhau . Các kịch bản nghiên cứu tiên phong cũng áp dụng tương tự.
3. Triển khai thực tế: Đánh giá đi trước, mỗi lần chỉ gộp một subagent
Nếu đã có một đống subagent đang chạy trên production thì phải làm sao? Lộ trình di chuyển mà bài viết đưa ra làm nổi bật chữ "chắc".
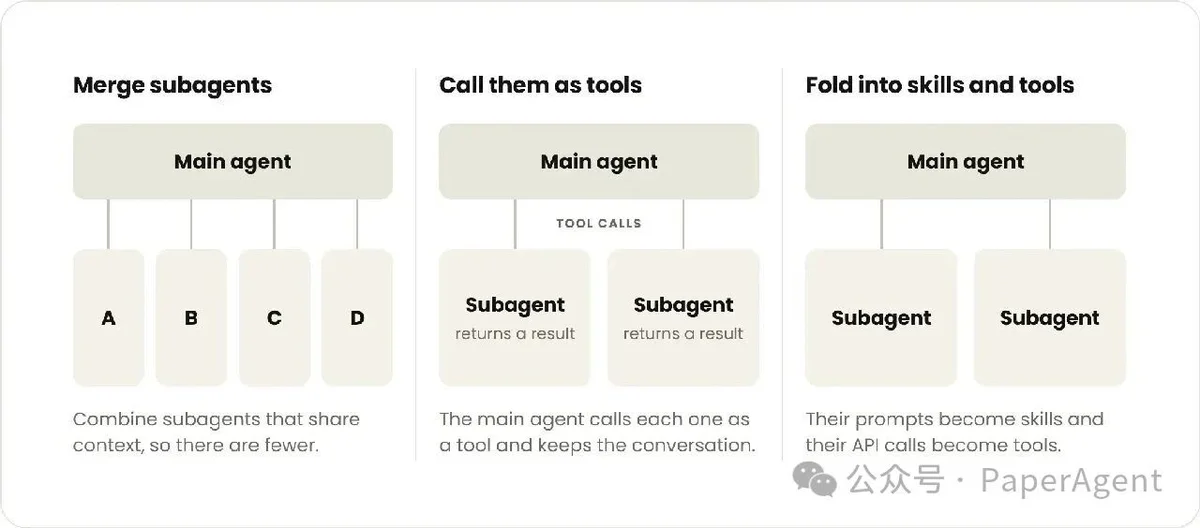
Quá trình từng bước gộp subagent thành tools và skills
Bước đầu tiên luôn là xây dựng bộ đánh giá. Một bộ eval end-to-end do team trung tâm nắm giữ, cộng thêm tập đánh giá nhỏ đi kèm mỗi skill, dù chỉ có 10 mẫu vàng cũng đủ để bắt đầu. Khi còn dùng orchestrator thì theo dõi độ chính xác định tuyến; sau khi gộp lại, chuyển sang xem agent có tải đúng skill và gọi đúng công cụ hay không.
Tiếp theo là ba cách gộp, tịnh tiến theo mức độ can thiệp : trước tiên, gộp các domain agent có độ gắn kết chặt chẽ — các agent chuyên trách được gọi tuần tự, thao tác trên cùng một tệp dữ liệu, thường xuyên được gọi cùng lúc, hãy gộp lại làm một; sau đó coi các subagent được giữ lại như tool để gọi, agent chính luôn nắm quyền điều khiển cuộc hội thoại với người dùng; cuối cùng chuyển đổi triệt để prompt thành skill, chuyển các lệnh gọi API thành MCP tool.
Về nhịp độ, mỗi lần chỉ gộp một subagent, gộp xong thì so sánh đối chiếu. Bài viết nêu ra một ví dụ phản diện rất thực tế: trên một mẫu agent chăm sóc khách hàng, việc gộp đúng là đã giảm độ trễ, nhưng lại làm hỏng một quy trình vốn dĩ chạy trơn tru — agent chính cầm công cụ tra cứu đơn hàng đã tự biên tự diễn ra câu trả lời mà không hề hỏi chuyên viên logistics để xác nhận ngày giao hàng. Rắc rối hơn nữa là, vấn đề này chạy hai lần chỉ xuất hiện một lần , vì vậy mỗi tác vụ đánh giá đều phải chạy lặp lại nhiều lần.
Mô hình hợp tác giữa nhiều team cũng theo đó mà thay đổi: quyền sở hữu của các team dịch chuyển từ agent sang skills và tools , một team nhỏ ở trung tâm sẽ nắm giữ system prompt và chất lượng end-to-end. Công cụ cần được nhóm theo ý định của người dùng chứ không phải mỗi API là một tool, bởi một khi định nghĩa công cụ trong system prompt vượt quá 30 đến 50 cái , độ chuẩn xác khi lựa chọn công cụ sẽ bắt đầu suy giảm. Đi kèm với đó là một chuỗi toolchain dùng được ngay: migration kit kết nối việc đánh giá và di chuyển thành một workflow có hướng dẫn, **/claude-api build-eval** để xây dựng tập eval, prompt-audit để tìm ra các chỉ dẫn lỗi thời viết cho model cũ, hillclimb để lặp đi lặp lại cải tiến dựa trên eval, cost-optimize để tối ưu chi phí từng hạng mục.
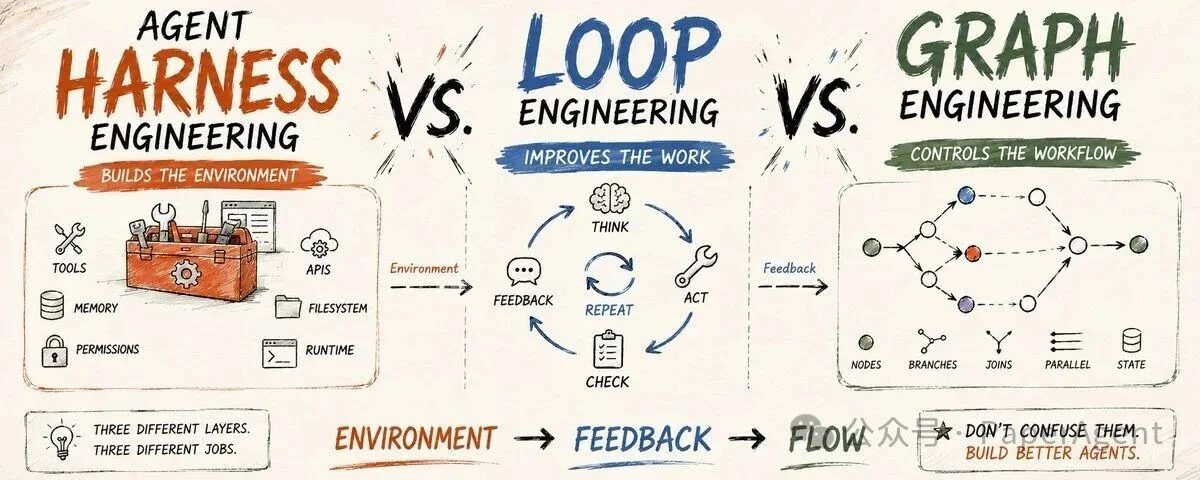
Cuối cùng
So với bất kỳ kiến trúc nào, điều quan trọng hơn chính là nguyên tắc đằng sau kiến trúc đó — đo lường, mỗi lần chỉ thay đổi một chỗ, và giữ lại những gì vượt qua được kiểm chứng. Cùng với việc model ngày càng mạnh hơn, agent chạy được ngày càng dài hơn, ngày càng nhiều subagent có thể biến thành skills và tools, nhưng việc này không nhất thiết phải làm xong ngay lập tức: hãy dựng một bài đánh giá nhỏ, gộp thử một subagent, nếu điểm số giảm sút thì giữ lại để nó tiếp tục làm subagent, rồi cứ thế lặp đi lặp lại.
Học tương tác với AI (NotebookLM)
Ngoài đọc , bạn có thể nghe , xem và xem hoạ thông tin ở đầu bài. Bài này còn có bộ công cụ tương tác do AI tạo: Bài kiểm tra trắc nghiệm, Thẻ ghi nhớ, Sơ đồ tư duy, Bản trình bày và Báo cáo chuyên sâu.
Mở không gian học tương tác