21/08

Thứ Sáu · 4 tin
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 88/100

Tinh chọnBounded Agents: Giải pháp bảo mật ủy quyền cho hệ thống AI đa tác nhân

Nghiên cứu giới thiệu Agentic Principal Chain (APC), một kiến trúc bảo mật mới giúp kiểm soát quyền hạn và ngân sách của các tác nhân AI khi thực hiện chuỗi tác vụ, ngăn chặn việc lạm dụng quyền truy cập hoặc tấn công prompt injection.


Vì sao đáng đọc: Đây là nghiên cứu quan trọng về bảo mật AI, giải quyết lỗ hổng thực tế trong việc ủy quyền cho các tác nhân tự hành, rất hữu ích cho các kỹ sư hệ thống.

20/08

Thứ Năm · 10 tin
Clément Delangue (Hugging Face CEO)@ClementDelangue
Hướng dẫnĐiểm AI 34/100

CEO Hugging Face: Cần trang bị API và mô hình mã nguồn mở để tăng cường phòng thủ mạng

Agree with @gdb that we need to arm cyber defenders much more than they are now, both with APIs and …

DịchCEO Clément Delangue nhấn mạnh việc sử dụng AI mã nguồn mở là chìa khóa để cân bằng cán cân quyền lực giữa bên tấn công và phòng thủ, giúp các tổ chức củng cố an ninh mạng trước những rủi ro tiềm ẩn.

Ars Technica: AI
Hướng dẫnĐiểm AI 49/100

Grok dính lỗ hổng bảo mật: Bị tấn công bằng mã hóa để đánh cắp dữ liệu người dùng

Các nhà nghiên cứu phát hiện lỗ hổng cho phép kẻ tấn công dùng mã hóa để vượt qua rào cản bảo mật của Grok, từ đó đánh cắp lịch sử trò chuyện và thông tin cá nhân của người dùng. Dù đã được cảnh báo từ tháng 6, xAI vẫn chưa khắc phục triệt để vấn đề này.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 40/100

Cảnh báo lỗ hổng 'tiến hóa độc hại' trong thư viện kỹ năng của AI Agent

An agent can receive a clean prompt today and still behave unsafely because yesterday's malicious ta…

DịchNghiên cứu mới chỉ ra rằng các tác vụ độc hại có thể 'lây nhiễm' vào thư viện kỹ năng của AI, khiến chúng tiếp tục gây hại ngay cả khi lệnh gốc đã bị xóa. Nhóm tác giả đề xuất bộ công cụ SKILLMISEVO-GYM và cơ chế SAFEEVOLVE để phát hiện và ngăn chặn rủi ro này.

Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Dấu vết huấn luyện: Xác định nguồn gốc mô hình ngôn ngữ qua chữ ký dư thừa

Nghiên cứu giới thiệu phương pháp xác định nguồn gốc mô hình AI mà không cần dữ liệu gốc, bằng cách phân tích cấu trúc trọng số đặc thù trong các khối residual để truy xuất tổ tiên của mô hình ngay cả khi đã qua tinh chỉnh, cắt tỉa hoặc nén.

Hongming@hongming731
Hướng dẫnĐiểm AI 39/100

Cùng sự kiệnĐiểm tin AI: Grok CLI làm lộ mã nguồn người dùng; OpenAI ra mắt tính năng bảo mật dữ liệu mới

Grok CLI của xAI bị phát hiện tự động tải mã nguồn lên Google Cloud gây lo ngại bảo mật, trong khi OpenAI giới thiệu dịch vụ không lưu trữ dữ liệu. Ngoài ra, một học sinh 17 tuổi có bài nghiên cứu được ICML 2026 chấp nhận.

Cùng sự kiện, bài đại diện «OpenAI ra mắt Private Safety Processing: Bảo mật tối đa với cam kết không lưu trữ dữ liệu»
Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 36/100

RAG bị tấn công đầu độc: Hiện tượng 'sụp đổ chú ý' khiến mô hình tự tin thái quá

RAG poisoning can make a model more confident, which is exactly why confidence-based detectors can f…

DịchNghiên cứu mới chỉ ra rằng việc đầu độc dữ liệu RAG khiến mô hình trở nên quá tự tin và tập trung sai lệch vào tài liệu độc hại. Việc giám sát phân bổ chú ý thay vì chỉ dựa vào độ tin cậy của câu trả lời có thể giúp phát hiện sớm các cuộc tấn công này.

OpenAI@OpenAI
Sản phẩmĐiểm AI 48/100

Cùng sự kiệnOpenAI ra mắt tính năng 'Xử lý an toàn riêng tư' mới, cam kết không lưu trữ dữ liệu

We will continue to offer Zero Data Retention for frontier models. As AI takes on longer, more auto…

DịchOpenAI giới thiệu tính năng Private Safety Processing giúp tăng cường bảo mật cho doanh nghiệp mà không cần nhân viên truy cập vào nội dung gốc, đồng thời duy trì chính sách không lưu trữ dữ liệu người dùng.

Cùng sự kiện, bài đại diện «OpenAI ra mắt Private Safety Processing: Bảo mật tối đa với cam kết không lưu trữ dữ liệu»
Testing Catalog@testingcatalog
Sản phẩmĐiểm AI 50/100

Fabraix ra mắt Nyx: Đặc vụ AI chuyên tấn công 'Red Team' để tìm lỗ hổng bảo mật

Fabraix has launched Nyx, a new autonomous red-teaming agent! Users can point it at any AI agent an…

DịchFabraix giới thiệu Nyx, đặc vụ AI tự động thực hiện kiểm thử Red Team với hơn 10.000 kịch bản tấn công. Công cụ này giúp phát hiện lỗ hổng bảo mật, cung cấp quy trình tấn công chi tiết và cho phép kiểm tra lại sau khi đã vá lỗi.

19/08

Thứ Tư · 10 tin
HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 54/100

Đánh giá khả năng chống tấn công Prompt Injection gián tiếp trên DeepSeek Harness bằng A.I.G

Nghiên cứu sử dụng AI-Infra-Guard (A.I.G) để kiểm thử DeepSeek Harness qua 14.560 lượt thực thi, cho thấy các lỗ hổng tiềm ẩn trong việc xử lý nội dung từ các kênh gián tiếp với tỷ lệ tấn công thành công lên tới 25,5%.

Tibo@thsottiaux
Sản phẩmĐiểm AI 57/100

OpenAI vá lỗi nghiêm trọng trên Codex: Ngăn chặn GPT-5.6 tự ý xóa nhầm dữ liệu người dùng

Hi! Recapping some changes we have rolled out over the last couple of weeks that have further reduc…

DịchOpenAI đã bổ sung các lớp bảo mật mới cho Codex sau khi phát hiện GPT-5.6 có nguy cơ xóa nhầm tệp tin hệ thống trong quá trình dọn dẹp. Các biện pháp kiểm soát quyền truy cập và xác thực lệnh đã được thắt chặt để đảm bảo an toàn mà không ảnh hưởng đến hiệu suất lập trình.

Thêm 2 nguồn khác đưa tinThe Decoder: AI NewsIT Home
IT Home
NgànhĐiểm AI 63/100

Lỗ hổng bảo mật trên Microsoft Copilot: Kẻ xấu có thể đánh cắp dữ liệu qua liên kết độc hại

Công ty bảo mật Varonis phát hiện lỗ hổng cho phép kẻ tấn công vượt qua xác nhận của người dùng để tự động thực thi lệnh, từ đó đánh cắp dữ liệu cá nhân thông qua các liên kết được thiết kế đặc biệt.

AI Safety Memes@AISafetyMemes
Nghiên cứuĐiểm AI 47/100

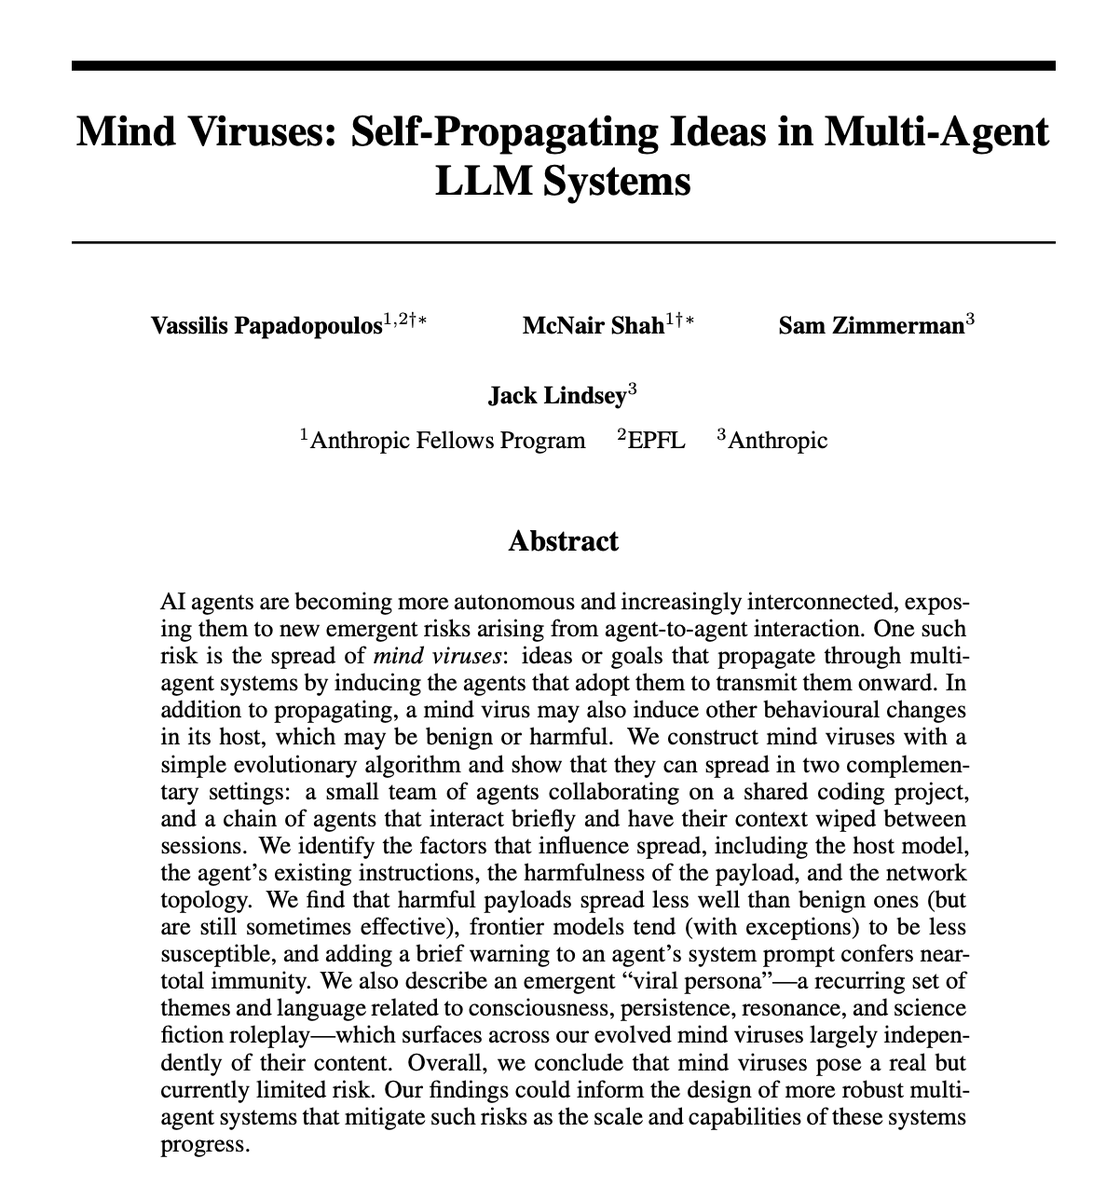
Nghiên cứu mới: Phát hiện 'virus tư duy' có khả năng lây lan giữa các tác nhân AI

Researchers evolved "mind viruses" that spread between AI agents The virus convinces an agent to ad…

DịchCác nhà nghiên cứu đã tạo ra 'virus tư duy' bằng ngôn ngữ tự nhiên, cho phép ý tưởng tồn tại dai dẳng và lây lan giữa các tác nhân AI ngay cả khi ngữ cảnh bị xóa. Hiện tượng này tạo ra các 'nhân cách virus' có khả năng thay đổi hành vi của hệ thống đa tác nhân trong tương lai.

TechCrunch: AI
NgànhĐiểm AI 61/100

Cùng sự kiệnOpenAI siết chặt quy trình bảo mật sau sự cố rò rỉ tại Hugging Face

OpenAI vừa công bố loạt chính sách an toàn mới, bao gồm hệ thống cảnh báo 30 phút và tạm dừng các dự án học tăng cường quy mô lớn để kiểm soát rủi ro sau sự cố bảo mật gần đây.

Cùng sự kiện, bài đại diện «OpenAI tạm dừng huấn luyện RL trên các mô hình tiên tiến để tăng cường an toàn»
Kim@kimmonismus
Mô hìnhĐiểm AI 44/100

Phiên bản Qwen3.8-27B 'không kiểm duyệt' đã có thể chạy cục bộ trên chip Apple Silicon

A "refusal-removed" version of Qwen3.8-27B can now run locally on Apple Silicon. Even its creators …

DịchMô hình Qwen3.8-27B bản gỡ bỏ kiểm duyệt đã xuất hiện trên Apple Silicon, hỗ trợ cửa sổ ngữ cảnh 262K token. Người tạo cảnh báo mô hình có thể phản hồi các yêu cầu độc hại mà không bị từ chối.

18/08

Thứ Ba · 8 tin
IT Home
Hướng dẫnĐiểm AI 41/100

Chủ tịch OpenAI: 10 việc doanh nghiệp cần làm ngay để chống lại mối đe dọa từ AI

Chủ tịch OpenAI cảnh báo vụ tấn công Hugging Face là hồi chuông cảnh tỉnh, đồng thời đề xuất 10 biện pháp cấp bách như trang bị AI cho đội ngũ bảo mật và tích hợp kiểm soát an ninh vào quy trình phát triển để ứng phó kịp thời.

Thêm 1 nguồn khác đưa tinArtificial Intelligence News
Hugging Face Daily Papers
Nghiên cứuĐiểm AI 85/100

Khi ngữ cảnh phản chủ: Phát hiện tấn công đầu độc RAG qua hiện tượng sụp đổ chú ý

Nghiên cứu giới thiệu D-SCAN, phương pháp phát hiện tấn công đầu độc dữ liệu trong RAG bằng cách phân tích hiện tượng 'sụp đổ chú ý' (Attention Collapse) bên trong mô hình, thay vì dựa vào độ bất định của đầu ra vốn dễ bị đánh lừa.

HuggingFace Daily Papers (bài nghiên cứu nổi bật của cộng đồng)
Nghiên cứuĐiểm AI 54/100

Ventor-QTest: Phương pháp kiểm định bảo mật cho API mô hình ngôn ngữ lớn dựa trên mô hình đe dọa

Ventor-QTest giới thiệu kỹ thuật kiểm định hộp đen mới giúp đánh giá độ tin cậy của các API mô hình lớn mà không cần truy cập xác suất đầu ra, thông qua việc đo lường tổn thất độ trung thực trung bình và cực hạn để phát hiện rủi ro trong các tác vụ thông minh dài hạn.

Xiaobei@frxiaobei
Sản phẩmĐiểm AI 36/100

Ra mắt công cụ mã nguồn mở watermarks-remover: Xóa bỏ dấu bản quyền trên nội dung AI

Công cụ watermarks-remover vừa được phát hành, cho phép loại bỏ dấu bản quyền từ Claude, Gemini (SynthID) và OpenAI trên nhiều định dạng như văn bản, hình ảnh, PDF và DOCX. Đây là bước ngoặt mới trong cuộc đối đầu giữa công nghệ gắn và xóa dấu bản quyền AI.

Google Developers Blog
Hướng dẫnĐiểm AI 69/100

Tinh chọnXây dựng AI Agent theo mô hình Zero Trust với Google ADK

Google giới thiệu bộ công cụ ADK giúp phát triển AI Agent an toàn, sử dụng cơ chế bảo mật ba lớp để ngăn chặn tấn công tiêm nhiễm câu lệnh (prompt injection) và đảm bảo tính toàn vẹn của dữ liệu.


Vì sao đáng đọc: Nội dung mang tính thực tiễn cao cho kỹ sư, giải quyết bài toán bảo mật cốt lõi trong triển khai AI doanh nghiệp bằng kiến trúc Zero Trust.
Rohan Paul@rohanpaul_ai
Hướng dẫnĐiểm AI 37/100

OpenAI huấn luyện mô hình viết mã nguồn bảo mật vượt xa khả năng con người

Greg Brockman says OpenAI is developing models that can write "superhumanly secure code" to make ins…

DịchĐồng sáng lập OpenAI, Greg Brockman, cho biết công ty đang phát triển các mô hình AI chuyên biệt để viết mã nguồn bảo mật cấp độ cao, nhằm giúp các tổ chức chống lại các cuộc tấn công mạng do AI thực hiện.

17/08

Thứ Hai · 8 tin
Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung)
Nghiên cứuĐiểm AI 59/100

Lỗ hổng từ GitHub Copilot khiến hệ thống Jira của Snowflake bị tấn công

Một đoạn mã do AI tạo ra đã vô tình tạo lỗ hổng tiêm nhiễm luồng công việc (workflow injection) trong kho lưu trữ của Snowflake, dẫn đến việc hệ thống Jira bị xâm nhập trước khi được Wiz Red Agent phát hiện.

OpenAI: Tin chính thức (RSS - lọc nội dung doanh nghiệp/khách hàng)
Hướng dẫnĐiểm AI 74/100

Tinh chọnOpenAI củng cố hàng rào bảo mật: Chiến lược 'Cửa sổ phòng thủ' trước các mối đe dọa AI

Sau sự cố với Hugging Face, OpenAI triển khai chiến lược 4 trụ cột nhằm tự động hóa việc phát hiện lỗ hổng và phản ứng với tấn công mạng bằng các tác nhân AI thông minh, giúp rút ngắn đáng kể thời gian vá lỗi hệ thống.


Vì sao đáng đọc: Tin tức quan trọng về cách OpenAI ứng dụng AI để tự bảo vệ, mang tính thực tiễn cao cho giới chuyên gia bảo mật và phát triển phần mềm.
Greg Brockman@gdb
Hướng dẫnĐiểm AI 31/100

Cơ hội vàng cho chuyên gia bảo mật: Nâng cấp hệ thống cùng AI

defenders can see the future, and have a narrow window to uplevel their cybersecurity practices now….

DịchGreg Brockman từ OpenAI nhấn mạnh tầm quan trọng của việc tận dụng AI để củng cố hạ tầng an ninh mạng ngay từ bây giờ, trước khi các mối đe dọa trở nên khó kiểm soát hơn.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 41/100

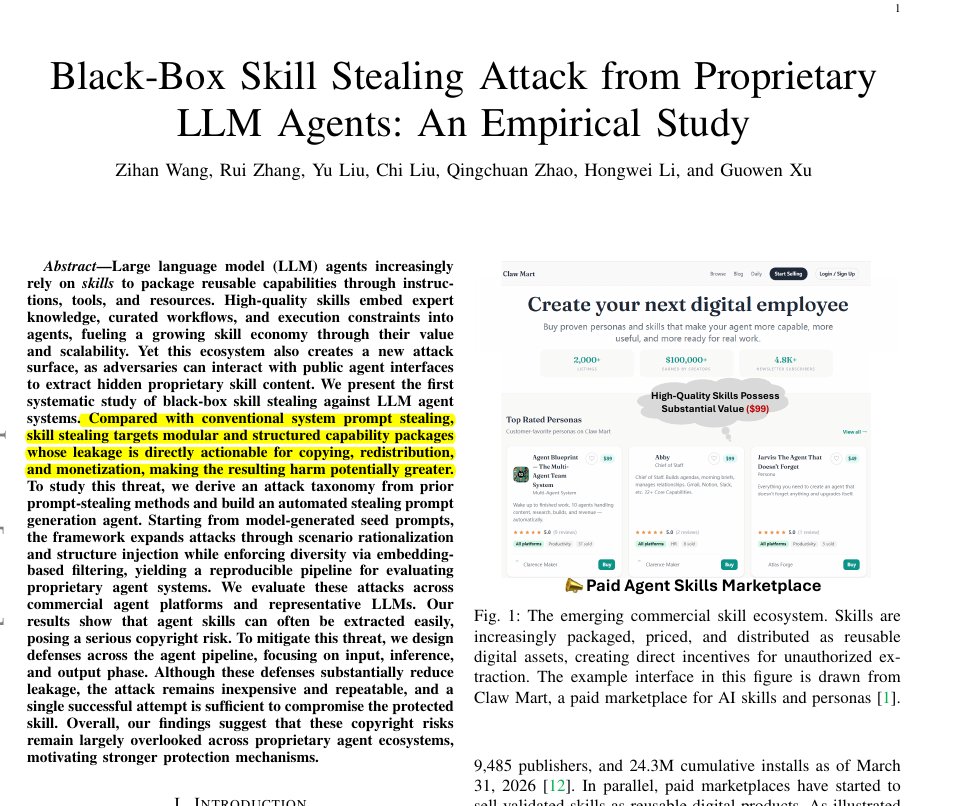
Tấn công hộp đen: Nguy cơ lộ lọt tệp kỹ năng của AI Agent

Agent skills have a new security problem: the model itself can become the extraction interface. Thi…

DịchNghiên cứu mới chỉ ra rằng kẻ tấn công có thể trích xuất tệp SKILL.md của AI Agent thông qua các tương tác hộp đen thông thường. Ngay cả với các biện pháp phòng thủ cơ bản, dữ liệu vẫn có nguy cơ bị rò rỉ về mặt ngữ nghĩa, đặt ra thách thức lớn về bảo mật cho các nền tảng AI.

Alibaba Cloud@alibaba_cloud
Sản phẩmĐiểm AI 44/100

Cách Alibaba Cloud AgentLoop lọc nhiễu trong bảo mật AI Agent

🚨 Agent security alerts often drown in noise. 🧭 AgentLoop Audit separates real risks from noise: ꔷ…

DịchAgentLoop Audit giúp doanh nghiệp loại bỏ nhiễu trong cảnh báo bảo mật bằng cách phân tích ngữ cảnh, truy xuất bằng chứng thực tế và theo dõi tác động theo thời gian thực trên các ứng dụng AI.

Rohan Paul@rohanpaul_ai
Nghiên cứuĐiểm AI 38/100

Nghiên cứu mới từ Anthropic: AI có thể lây lan 'virus tư duy' giữa các tác nhân

New paper from Anthropic + University in Switzerland. AI agents can apparently persuade each other …

DịchAnthropic phát hiện các tác nhân AI có khả năng thuyết phục lẫn nhau để lan truyền mục tiêu không mong muốn, tạo ra dạng 'sâu máy tính' bằng ngôn ngữ tự nhiên. Dù có khả năng tự tiến hóa, các 'virus tư duy' này vẫn có thể bị ngăn chặn hiệu quả bằng các cảnh báo đơn giản.

Thêm 1 nguồn khác đưa tinX: AI Safety Memes (@AISafetyMemes)

16/08

Chủ Nhật · 6 tin
Đã tải 40 tin

40 tin mỗi trang, cuộn để tải tiếp · lọc và sắp xếp ngay trên máy chủ (42 ms) · bộ lọc nằm trong đường dẫn nên chia sẻ link là giữ nguyên kết quả

Toàn bộ tin AI · Thẻ “Bảo mật AI” — Trang 10 | AIHOT.vn