Tin ngành
Tối ưu hiệu năng triển khai Qwen3.8-2.4T trên cụm GB300 NVL72 với vLLM
(giờ Việt Nam)
Tóm tắt AI
Bài viết chia sẻ kinh nghiệm triển khai tách biệt PD cho mô hình Qwen3.8-2.4T trên cụm GB300 NVL72, đạt thông lượng 5000 token/GPU và độ trễ tối ưu cho người dùng.
Bản dịch AI
TL;DR (Tóm tắt)
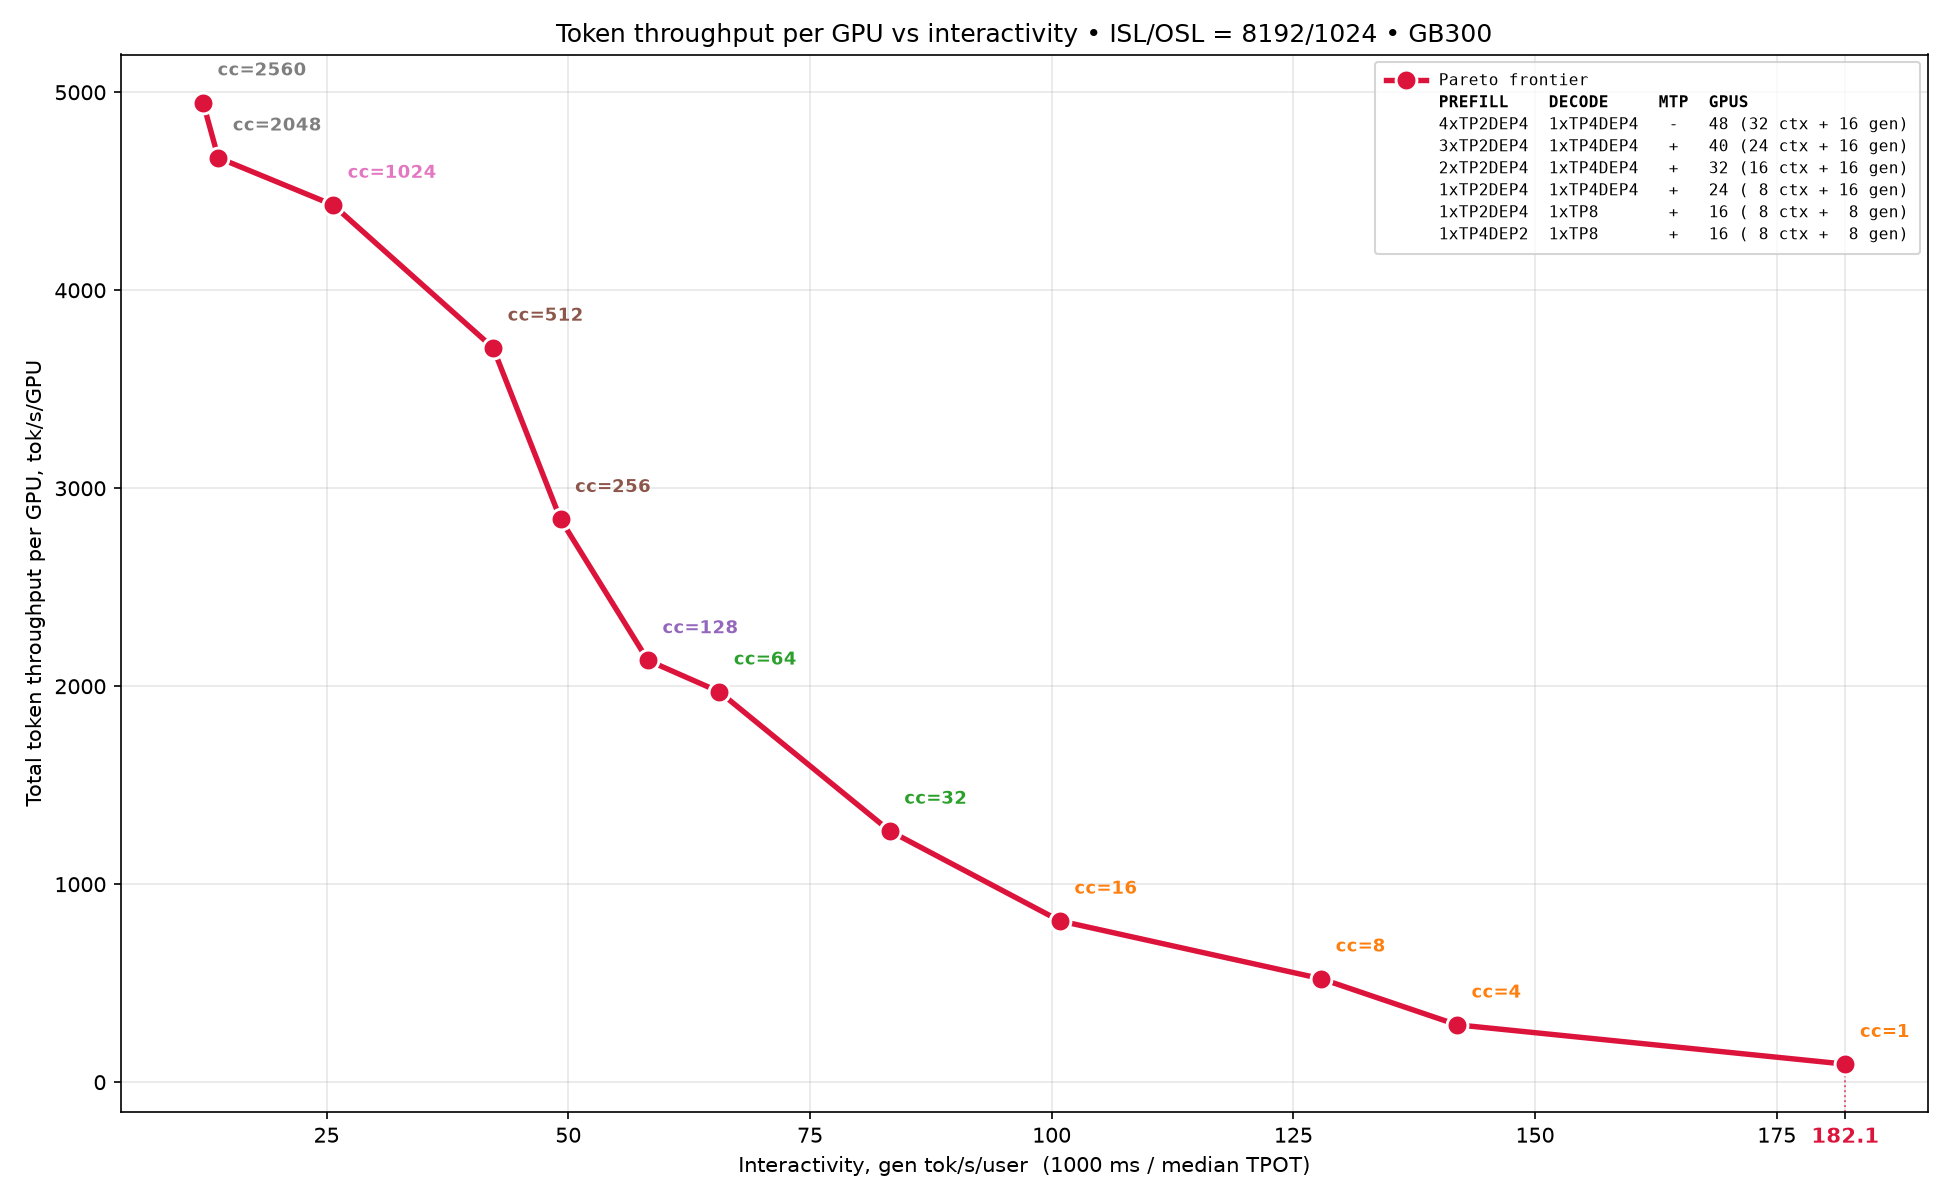
Trong bài viết này, chúng tôi trình bày các kết quả hiệu năng mới nhất về phục vụ PD (Disaggregated Serving) cho mô hình Qwen3.8-2.4T, sử dụng vLLM trên cụm GB300 NVL72 với khối lượng công việc 8K/1K. Trong kịch bản thông lượng cao, vLLM đạt 5000 token/giây trên mỗi GPU, và 180 token được tạo ra mỗi người dùng trong kịch bản độ trễ thấp — cả hai đều được thể hiện trên đường biên Pareto bên dưới. Chúng tôi giải thích chi tiết cách đạt được các kết quả này và cung cấp các công thức srt-slurm chính xác để bất kỳ ai cũng có thể xác minh và tái lập chúng bằng cách phục vụ cục bộ. Quan trọng hơn, chúng tôi mô tả quy trình ra quyết định đã sử dụng để tạo ra các công thức này. Điều này thậm chí còn quan trọng hơn cả kết quả hiệu năng thực tế, vì nó cho phép bạn tối ưu hóa hiệu năng phục vụ PD trên vLLM cho bất kỳ mô hình nào bạn muốn.
Giới thiệu
Gần đây, chúng tôi đã trình bày kết quả phục vụ PD cho Qwen3.5 và cho thấy vLLM có thể đạt 25K TPS/GPU (tổng token mỗi giây trên mỗi GPU). Ngay sau đó, một mô hình tiên phong mới thuộc dòng Qwen đã được phát hành: Qwen3.8-2.4T. Trong bài viết này, chúng tôi chuyển sang phục vụ PD cho Qwen3.8-2.4T và trình bày toàn bộ đường biên Pareto.
Trong nghiên cứu về Qwen3.5 trước đây, chúng tôi tập trung chủ yếu vào phần bên trái của đường cong Pareto, nơi mục tiêu là tối đa hóa tổng TPS/GPU. Lần này, chúng tôi tiến xa hơn và xây dựng đường biên Pareto hoàn chỉnh, bao phủ cả phần bên trái (thông lượng cao) và bên phải (độ trễ thấp). Nói cách khác, ngoài các cấu hình hướng tới thông lượng, chúng tôi cũng xác định các công thức PD tối ưu để tối đa hóa tính tương tác, tức là Gen TPS (số token tạo ra mỗi giây) trên mỗi người dùng.
Quan trọng không kém, bài viết này không chỉ nói về các con số cuối cùng. Chúng tôi cũng phân tích quy trình tinh chỉnh từng bước: cách chúng tôi chọn những gì cần đo lường, cách xác định các điểm nghẽn và cách chúng tôi lặp lại để đạt được các cấu hình PD tốt hơn. Mục tiêu của chúng tôi là làm cho quy trình này trở nên dễ hiểu và có thể tái sử dụng cho bất kỳ ai đang cố gắng tinh chỉnh hiệu năng phục vụ cho một mô hình khác.
Tối đa hóa thông lượng
Chỉ số đầu tiên chúng tôi nhắm đến để tối đa hóa là tổng thông lượng token trên mỗi GPU. Chỉ số này phụ thuộc vào tính đồng thời: càng nhiều yêu cầu mà một công cụ giải mã (decode engine) phục vụ cùng lúc, thông lượng chúng ta nhận được càng cao. Điều giới hạn tính đồng thời là dung lượng KV cache, vì mỗi yêu cầu đang hoạt động đều chiếm một phần của nó. Do đó, kích thước KV cache là câu hỏi đầu tiên cần trả lời cho bất kỳ cấu trúc liên kết nào, và nó được chia làm hai phần: một yêu cầu đơn lẻ tiêu tốn bao nhiêu cache, và còn lại bao nhiêu trên GPU sau khi trọng số mô hình được tải và máy chủ vLLM đã phân bổ không gian cho công việc của riêng nó. Phần còn lại của chương này sẽ giải quyết cả hai khía cạnh và đi đến mức đồng thời tối đa có thể đạt được về mặt lý thuyết cho Qwen3.8-2.4T trên một GB300 đơn lẻ.
Ước tính KV cache cho một yêu cầu đơn lẻ
Qwen3.8-2.4T có 92 lớp: 69 lớp GDN và 23 lớp Full-Attn, với một khối MoE trong mỗi lớp (92 × 512 chuyên gia). GDN và Full-Attn ở định dạng BF16, MoE ở định dạng NVFP4. Các trọng số được phân loại như sau:
Vì Qwen3.8-2.4T là một mô hình lai, trạng thái của nó gồm hai phần được tính toán rất khác nhau: trạng thái Full-Attn tăng theo từng token, trong khi trạng thái GDN được lưu trữ theo từng yêu cầu.
Trạng thái Full-Attn được lưu trữ theo từng token. Một token cần 2 KiB cho mỗi lớp:
Trạng thái GDN được lưu trữ theo từng yêu cầu chứ không phải theo từng token, điều này rất quan trọng. Nó bao gồm hai phần.
Tổng kết lại, trạng thái GDN cần 4 MiB + 120 KiB = 4216 KiB.
vLLM phân bổ KV cache theo các khối (block), và khối này phải đủ lớn để chứa một trạng thái GDN đơn lẻ hoặc một số lượng trạng thái Full-Attn. Đối với Qwen3.8-2.4T, trạng thái GDN chiếm ưu thế hơn trạng thái Full-Attn gấp 4216 KiB / 2 KiB = 2108 lần. Kích thước khối sau đó được xác định bởi trạng thái GDN và căn chỉnh theo 16 byte, vì vậy align(2108, 16) = 132 * 16 = 2112 token vừa vặn trong một khối, làm cho khối có kích thước 2112 × 2 KiB = 4.125 MiB.
Một điều cần lưu ý đối với phục vụ phân tách (disaggregated serving): prefill và decode tính toán kích thước khối của chúng một cách độc lập, nhưng việc truyền KV cache yêu cầu cả hai phải khớp nhau. Nếu không, hãy đặt --block-size theo cách thủ công thành một giá trị đủ lớn để chứa trạng thái GDN ở cả hai phía, với cái giá là một phần không gian KV cache bị lãng phí.
Bây giờ chúng ta đã tính toán kích thước của một khối đơn lẻ, chúng ta có thể tìm ra dung lượng KV cache mà một yêu cầu đầy đủ chiếm dụng, và từ đó ước tính mức đồng thời tối đa mà chúng ta có thể mong đợi trong các phép đo của mình. Phép tính này cần một ước tính về khối lượng công việc. Chúng tôi đã cố định ISL=8192 và OSL=1024 — cái gọi là kịch bản kiểm tra long-ISL, decode-bound.
Một yêu cầu bao gồm ISL, OSL và một phần dự trữ nhỏ cho mẫu trò chuyện (chat template) được sử dụng bởi các yêu cầu OpenAI API. Với 2112 token mỗi khối, 23 lớp Full-Attn và 69 lớp GDN, chi phí trên mỗi yêu cầu có thể được tính theo cách này:
Trạng thái Full-Attn tăng theo số lượng token, vì vậy nó cần một khối cho mỗi 2112 token trong mỗi lớp trong số 23 lớp. Trạng thái GDN được cố định theo yêu cầu, vì vậy nó cần chính xác một khối trong mỗi lớp trong số 69 lớp. Chia tổng số giữa hai phần:
KV cache sử dụng bộ nhớ GPU còn lại sau khi tải mô hình và tất cả các dự trữ khác, vì vậy bước đầu tiên là xác định mọi thành phần tiêu thụ bộ nhớ có phân bổ bộ nhớ.
Dung lượng KV cache
GB300 cung cấp cho chúng ta 279 GB để bắt đầu. Ban đầu, chi phí trình điều khiển (driver overhead) chiếm 2.28 GiB. Vì vậy, vLLM khi khởi động có tổng cộng 276.62 GiB. Trước khi máy chủ vLLM khởi động, khoảng 3.13 GiB đã bị chiếm dụng bởi ngữ cảnh CUDA. Đây là bộ nhớ mà chúng ta hoàn toàn không có quyền kiểm soát và không có cách nào để điều chỉnh.
Ngoài ra, theo mặc định, vLLM dự trữ 8% trong số 276.62 GiB cơ sở cho bất cứ thứ gì không thể dự đoán trước — đỉnh bộ nhớ kích hoạt (activation memory peak) và các hiệu ứng tương tự. Đây là những gì cài đặt gpu_memory_utilization kiểm soát. Điều đó để lại cho chúng ta ~254 GiB.
2.90 GiB khác đi vào các bộ đệm NCCL, bộ phân bổ và các thứ không liên quan đến PyTorch khác. Vì vậy, trước khi tải trọng số, chúng ta có 276.62 × 0.92 − 3.13 − 2.90 = 248 GiB.
Đỉnh kích hoạt (Peak activations)
Sau khi tải trọng số, vLLM đo lường xem một bước mô hình tiêu tốn bao nhiêu bộ nhớ ở chế độ eager, tức là không có đồ thị CUDA (CUDA graphs). Điều này là cần thiết vì bản thân các đồ thị CUDA bị giới hạn ở một kích thước tối đa nhất định, và trong quá trình suy luận, kích thước lô (batch size) có thể vượt quá giới hạn đó — chúng ta vẫn phải chạy quá trình này bằng cách nào đó, và đó là lúc chúng ta cần sử dụng chế độ eager. Những trường hợp như vậy tất nhiên cần tránh càng nhiều càng tốt vì sự suy giảm hiệu năng, nhưng trên thực tế, không có cách nào để đảm bảo chúng không bao giờ xảy ra trong thời gian chạy. Quá trình ở chế độ eager được chạy với max_num_batched_tokens token, để đỉnh kích hoạt được đo trong kịch bản xấu nhất.
Cách dễ nhất để bạn ước tính mức tiêu thụ bộ nhớ là thực hiện một vài lần chạy thử nghiệm các cấu trúc liên kết decode mà bạn quan tâm bằng cách sử dụng chế độ tổng hợp (aggregated mode). Đối với các cấu trúc liên kết được đề cập trong bài viết này, chúng tôi đã có các đỉnh kích hoạt sau cho mỗi công cụ:
Đồ thị CUDA (CUDA graphs)
Sau đó, vLLM nắm bắt các đồ thị CUDA. Bộ nhớ cho đồ thị phải được phân bổ trước tại các địa chỉ tĩnh, nghĩa là bộ nhớ mà đồ thị cần phải được ước tính trước khi đồ thị được nắm bắt.
Cho đến ngày nay, vLLM thực hiện điều này theo cách sau. Đầu tiên, chúng tôi liệt kê mọi kích thước đồ thị có sẵn cho cấu hình máy chủ. Chỉ một đồ thị có thể được phát lại tại một thời điểm, và đồ thị càng lớn, nó càng tiêu tốn nhiều bộ nhớ ở mức đỉnh — vì vậy ít nhất chúng ta phải có chỗ cho đồ thị lớn nhất. Câu hỏi tiếp theo là phần còn lại cần bao nhiêu bộ nhớ bổ sung, và ở đây bức tranh khác với lần chạy eager: một khi đồ thị đã được nắm bắt, việc phát lại nó sẽ sử dụng lại chính xác các địa chỉ đó. Hãy nắm bắt cả đồ thị lớn thứ hai và bạn sẽ thấy rằng nó tốn thêm một chút bộ nhớ ngoài bộ nhớ mà đồ thị đầu tiên đã sử dụng.
Để tiết kiệm thời gian khởi động (warmup time), vLLM sau đó đưa ra giả định sau: cùng một lượng bộ nhớ đó được thêm vào bởi mọi đồ thị tiếp theo. Bộ nhớ cần thiết cho các đồ thị CUDA được tính là, trong đó là bộ nhớ của đồ thị lớn nhất và là tổng số đồ thị. Và vì các đồ thị sử dụng địa chỉ tĩnh, và vì chúng ta không thể nắm bắt tất cả chúng khi khởi động, chúng ta buộc phải sử dụng ước tính đó để yêu cầu toàn bộ số lượng trước.
Trên thực tế, ước tính thường vượt quá bộ nhớ mà các đồ thị thực sự cần một khoảng cách lớn. Để tự mình đo lường, hãy thực hiện các lần chạy thử nghiệm cho các cấu trúc liên kết decode ở chế độ tổng hợp với compilation-config: '{"cudagraph_mode": "FULL_DECODE_ONLY"}' với max-cudagraph-capture-size.
Đối với các cấu trúc liên kết được đề cập trong bài viết này, chúng tôi đã có mức tiêu thụ bộ nhớ sau ở chế độ FULL cho mỗi công cụ:
Bảng này cũng làm rõ lý do tại sao dự trữ gpu_memory_utilization tồn tại ngay từ đầu. Trong một số lần chạy này, các đồ thị bộ nhớ sử dụng nhiều bộ nhớ hơn ước tính ban đầu, và phần dự trữ bổ sung đó chính xác là thứ ngăn trường hợp như vậy biến thành OOM (hết bộ nhớ).
Điều quan trọng cần lưu ý là không gian bộ nhớ còn lại cho KV cache được điều khiển bởi ước tính đồ thị CUDA, không phải bởi những gì đồ thị thực sự sử dụng trong thời gian chạy, vì vậy kích thước KV cache phụ thuộc trực tiếp vào mức độ chính xác của ước tính đó. Trong trường hợp của chúng tôi, đó là một ước tính tốt, nhưng nếu bạn muốn tối ưu hóa các tỷ lệ phần trăm cuối cùng, bạn có lẽ nên tự ước tính kích thước đồ thị. Cơ chế ước tính đồ thị trong vLLM chắc chắn xứng đáng được nghiên cứu và cải thiện thêm, bởi vì với sự xuất hiện của các mô hình tiên phong trên nghìn tỷ tham số như Qwen3.8, Kimi-K3 và DSV4, câu hỏi này trở nên cấp bách.
Mức đồng thời tối đa mỗi công cụ
Bây giờ là lúc tổng hợp tất cả các kết quả trước đó và tính toán xem vLLM có thể xử lý bao nhiêu yêu cầu mỗi công cụ cho mô hình của chúng tôi. Như đã nói trước đó, GB300 cung cấp cho chúng ta 276.62 GiB. Một phần bộ nhớ của nó được dự trữ bởi gpu_memory_utilization. Trong trường hợp của chúng tôi, chúng tôi đã sử dụng giá trị mặc định gpu_memory_utilization=0.92. Vì vậy, bộ nhớ khả dụng ban đầu cho mỗi công cụ là 276.62 GiB × 0.92 = 254.5 GiB.
Mọi cột trong bảng dưới đây ngoại trừ cột cuối cùng đều được đo lường: đây là những con số mà máy chủ vLLM báo cáo khi khởi động. Cột cuối cùng được suy ra từ chúng — chúng tôi chia kích thước KV cache cho 759 MiB mà một yêu cầu đơn lẻ cần, như đã tính toán trong phần Ước tính KV cache cho một yêu cầu đơn lẻ ở trên:
Đây là phép chia đơn thuần và nó cố tình bỏ qua các khe KV bổ sung mà MTP dự trữ cho các token suy đoán (speculative tokens), vì vậy đối với các hàng MTP, hãy coi đó là giới hạn trên thay vì mức đồng thời thực sự có thể đạt được.
Bài viết được AI dịch và tổng hợp tự động từ vLLM Blog. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.