Thủ thuật
Tài liệu mật vụ kiện NYT: Microsoft và OpenAI thừa nhận AI 'đánh cắp' dữ liệu và tạo ra vòng lặp hủy diệt
(giờ Việt Nam)
Tóm tắt AI
Tài liệu tòa án mới hé lộ nội bộ Microsoft và OpenAI thừa nhận các mô hình ngôn ngữ lớn được xây dựng dựa trên việc 'đánh cắp' dữ liệu quy mô lớn, gây sụt giảm nghiêm trọng lưu lượng truy cập của các trang tin và đe dọa sự tồn vong của báo chí trực tuyến.
Bản dịch AI
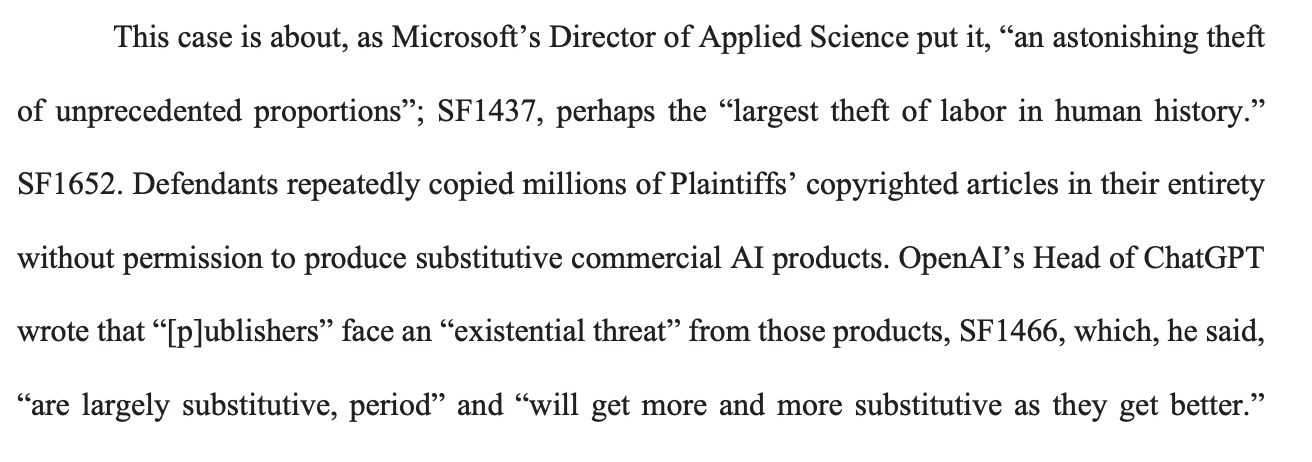
Các giám đốc điều hành làm việc trong lĩnh vực AI tại Microsoft và OpenAI đã thừa nhận điều mà những người chỉ trích họ vẫn luôn nói: Các mô hình ngôn ngữ lớn (LLM) là những công nghệ mang tính chiếm đoạt, được xây dựng dựa trên cái mà một giám đốc điều hành Microsoft gọi là “một vụ trộm đáng kinh ngạc với quy mô chưa từng có” và là “vụ trộm sức lao động lớn nhất trong lịch sử nhân loại”. Một tài liệu nội bộ của Microsoft cho biết các sản phẩm AI tạo sinh đã tạo ra một “vòng lặp diệt vong” (doom loop) đang giết chết “toàn bộ web”.
Những tuyên bố đó cùng hàng loạt khoảnh khắc “lộ mặt” khác xuất hiện dày đặc trong một hồ sơ tòa án không bị che thông tin, được công bố vào thứ Năm trong vụ kiện bản quyền đình đám giữa New York Times và OpenAI, vốn đã kéo dài nhiều năm qua trong hệ thống tòa án. Trong hồ sơ yêu cầu phán quyết tóm tắt (về cơ bản là yêu cầu tòa án đưa ra phán quyết), các luật sư của New York Times đã trình bày hàng loạt lời thừa nhận từ các giám đốc điều hành của Microsoft và OpenAI trong các tài liệu và lời khai mà cho đến nay vẫn được giữ kín hoặc che thông tin theo yêu cầu của Microsoft và OpenAI.
Dễ hiểu tại sao các công ty AI lại muốn giấu kín điều này trước công chúng. Những tuyên bố này, khi đặt cạnh nhau, là một trong những bản cáo trạng nặng nề nhất về cách thức các LLM được huấn luyện, cách chúng vận hành và mối đe dọa trực tiếp mà chúng gây ra đối với sức lao động của con người. Đây là lời nhắc nhở rằng ngay cả khi AI trở nên mạnh mẽ hơn và các công ty cố gắng chuyển hướng dư luận sang rủi ro hiện hữu giả định của AI “siêu thông minh”, thì những công cụ mà họ đã xây dựng lại được tạo ra bằng cách đánh cắp sự sáng tạo và sức lao động của con người, và theo định nghĩa, chúng là những mối đe dọa hiện hữu đối với thị trường lao động con người.
“Hàng triệu người trên thế giới sẽ sớm coi việc các mô hình lớn ‘hút sạch’ toàn bộ công sức của họ là một vụ trộm đáng kinh ngạc với quy mô chưa từng có,” một tài liệu nội bộ của Microsoft được trích dẫn trong vụ kiện viết, đồng thời nói thêm rằng “hầu như không ai có ý định để nội dung họ tạo ra bị sử dụng theo cách này, cũng như họ không được đền bù cho việc sử dụng đó.”
Hồ sơ này do các luật sư của New York Times soạn thảo nhưng phần lớn bao gồm các tuyên bố và phỏng vấn với các giám đốc điều hành công nghệ lớn, thừa nhận rằng các LLM chủ yếu được huấn luyện trên nội dung bị đánh cắp, rằng chúng đại diện cho một rủi ro hiện hữu đối với các nhà văn, nghệ sĩ và công ty truyền thông mà chúng đã lấy cắp dữ liệu, và rằng các sản phẩm của họ đã khởi đầu một “vòng lặp diệt vong” đang ăn mòn web và phá hủy chính các doanh nghiệp mà các công ty này đã lấy cắp dữ liệu từ đó.
Hồ sơ không bị che thông tin này được tìm thấy bởi Jason Kint, CEO của Digital Content Next, một tổ chức thương mại đại diện cho các công ty truyền thông kỹ thuật số. Kint đã theo dõi sát sao và đăng tải thông tin về các vụ kiện bản quyền AI quy mô lớn.
Hồ sơ tòa án trích dẫn một tài liệu nội bộ của Microsoft cho thấy các sản phẩm AI đánh cắp nội dung từ những người sáng tạo nội dung, sau đó “ăn thịt” (cannibalize) lượng truy cập từ chính những người và trang web mà chúng đã lấy cắp, từ đó phá hủy mô hình kinh doanh của họ.
“Chiến lược nội dung AI của chúng tôi đã khởi đầu một ‘vòng lặp diệt vong’ gây tổn hại đến hiệu suất của các mô hình của chúng tôi và toàn bộ web cùng một lúc: Thật bất thường khi một sản phẩm cuối cùng lại đe dọa nền tảng kinh tế của các nhà cung cấp thiết yếu của chính nó, nhưng đó là tình thế mà chúng tôi đã tạo ra cho mảng kinh doanh LLM của mình đối với ‘chuỗi cung ứng nội dung’,” tài liệu cho biết.
Các giám đốc điều hành của Microsoft, bao gồm cả CEO Satya Nadella, đã làm chứng dưới tuyên thệ rằng sau khi lấy nội dung từ New York Times và các trang tin tức khác, lượng truy cập vào các trang tin tức đó đã sụt giảm hoàn toàn, giảm hơn 90% trên Bing.
Các tài liệu thu thập được trong quá trình tố tụng cho thấy OpenAI đã tạo ra “một thủ thuật để vượt qua tường phí (paywall) của nytimes”, mà đồng sáng lập OpenAI Greg Brockman đã phản hồi là “à, hay đấy”. Giám đốc điều hành Microsoft, Brent Hecht, đã viết rằng các LLM đánh cắp nội dung “mà không có cách nào phân phối giá trị kinh tế xuống chuỗi cung ứng, [điều này] tất yếu đe dọa sự ổn định kinh tế của những người tạo ra nội dung đó.”
Giám đốc chính sách của OpenAI, Jack Clark, đã viết rằng công ty đang “tạo ra các hệ thống thay thế cho sức lao động của những người định hình ‘văn hóa’ của xã hội” và Microsoft, trong một tài liệu chính sách, đã viết rằng AI tạo sinh có thể “gây gián đoạn đáng kể đến việc làm của chính những người đã tạo ra dữ liệu mà mô hình nền tảng được huấn luyện […] LLM là một sản phẩm phá hủy chuỗi cung ứng của chính nó.” OpenAI tự gọi mình là một “mối đe dọa hiện hữu” đối với các nhà xuất bản tin tức, và một kỹ sư phần mềm của OpenAI đã làm chứng rằng “dù chúng tôi hiển thị các liên kết nổi bật đến đâu, người dùng cũng sẽ không nhấp vào.”
Không điều nào trong số này gây ngạc nhiên cho bất kỳ ai đã chú ý đến sự phát triển của trí tuệ nhân tạo tạo sinh, nhưng tài liệu này, khi nhìn tổng thể, là một tình huống “họ đã thừa nhận”. Các luật sư của OpenAI và Microsoft đã cố gắng lập luận rằng việc huấn luyện mô hình của họ là sử dụng hợp lý (fair use) và có tính chuyển đổi theo luật bản quyền, và rằng họ đang xây dựng một thứ gì đó khác biệt về cơ bản so với sức lao động của con người mà nó được huấn luyện dựa trên đó. Nhưng về mặt nội bộ, các giám đốc điều hành này biết rằng những gì họ đã xây dựng được tạo ra dựa trên nội dung bị đánh cắp và các sản phẩm họ tạo ra đang “ăn thịt” các nguồn mà họ đã lấy cắp và phá hủy internet như chúng ta biết.
Về tác giả
Jason là đồng sáng lập của 404 Media. Trước đây, ông là tổng biên tập của Motherboard. Ông yêu thích Đạo luật Tự do Thông tin và môn lướt sóng.
Bài viết được AI dịch và tổng hợp tự động từ 404 Media. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.