Mô hình
Claude Sonnet 5.5 vươn lên vị trí thứ 2 trên bảng xếp hạng Artificial Analysis
(giờ Việt Nam)
Tóm tắt AI
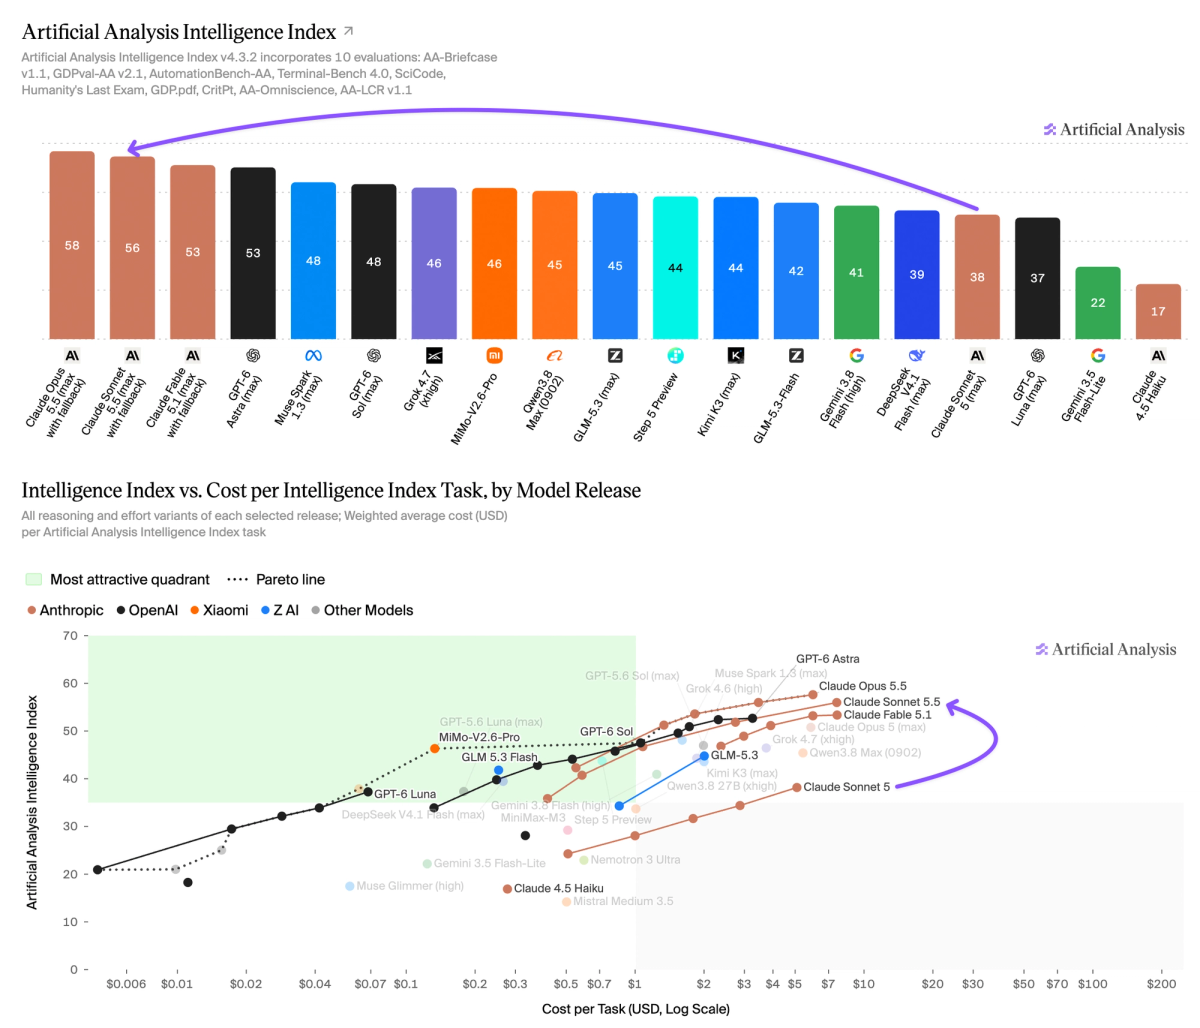
Artificial Analysis đánh giá Claude Sonnet 5.5 đạt 56 điểm chỉ số thông minh, tăng 18 điểm so với Sonnet 5 và chỉ xếp sau Opus 5.5 (max).
Chính văn · Bản dịch AI
Anthropic đã ra mắt Claude Sonnet 5.5: mô hình đạt 56 điểm trên Artificial Analysis Intelligence Index, chỉ kém Opus 5.5 (max) 2 điểm, nhưng sở hữu số lượng Output Tokens per Task cao nhất mà chúng tôi từng ghi nhận.
Xem trang mô hình
Với nỗ lực tối đa (max effort), Sonnet 5.5 tăng 18 điểm so với Sonnet 5 và vươn lên vị trí thứ 2 trên Intelligence Index, chỉ đứng sau Opus 5.5 (max). Anthropic giữ nguyên giá của Sonnet 5.5 so với Sonnet 5 ở mức $0.2/$2/$10 cho mỗi 1 triệu token cache input/input/output. Tuy nhiên, mô hình xuất ra số lượng Output Tokens per Task cao hơn và có chi phí $7.60 mỗi tác vụ (~cao hơn khoảng 50% so với Cost per Task của Sonnet 5).
Các điểm chính:
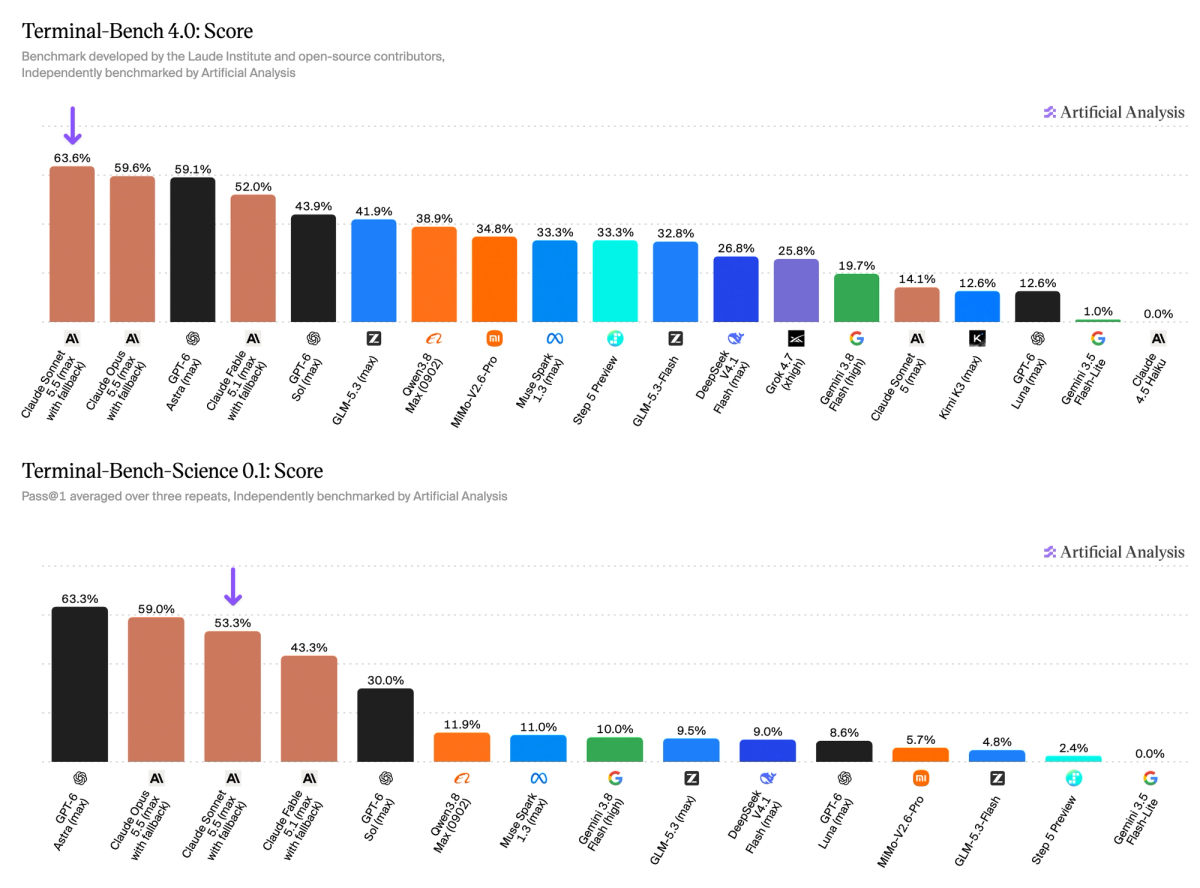
➤ Bắt kịp các mô hình hàng đầu về sử dụng terminal tác tử (agentic) và công việc tri thức: Trong Terminal-Bench 4.0, Claude Sonnet 5.5 đạt 64% so với 60% của Opus 5.5 và GPT-6 Astra. Trên các bài kiểm tra AA-Briefcase (1811 so với 1822 Elo), GDPval-AA (1844 so với 1846 Elo) và AutomationBench-AA (điểm tiêu đề 71% so với 70%), Sonnet 5.5 đạt mức ngang bằng với Opus 5.5, mặc dù phải sử dụng lượng token đáng kể hơn để đạt được kết quả đó.
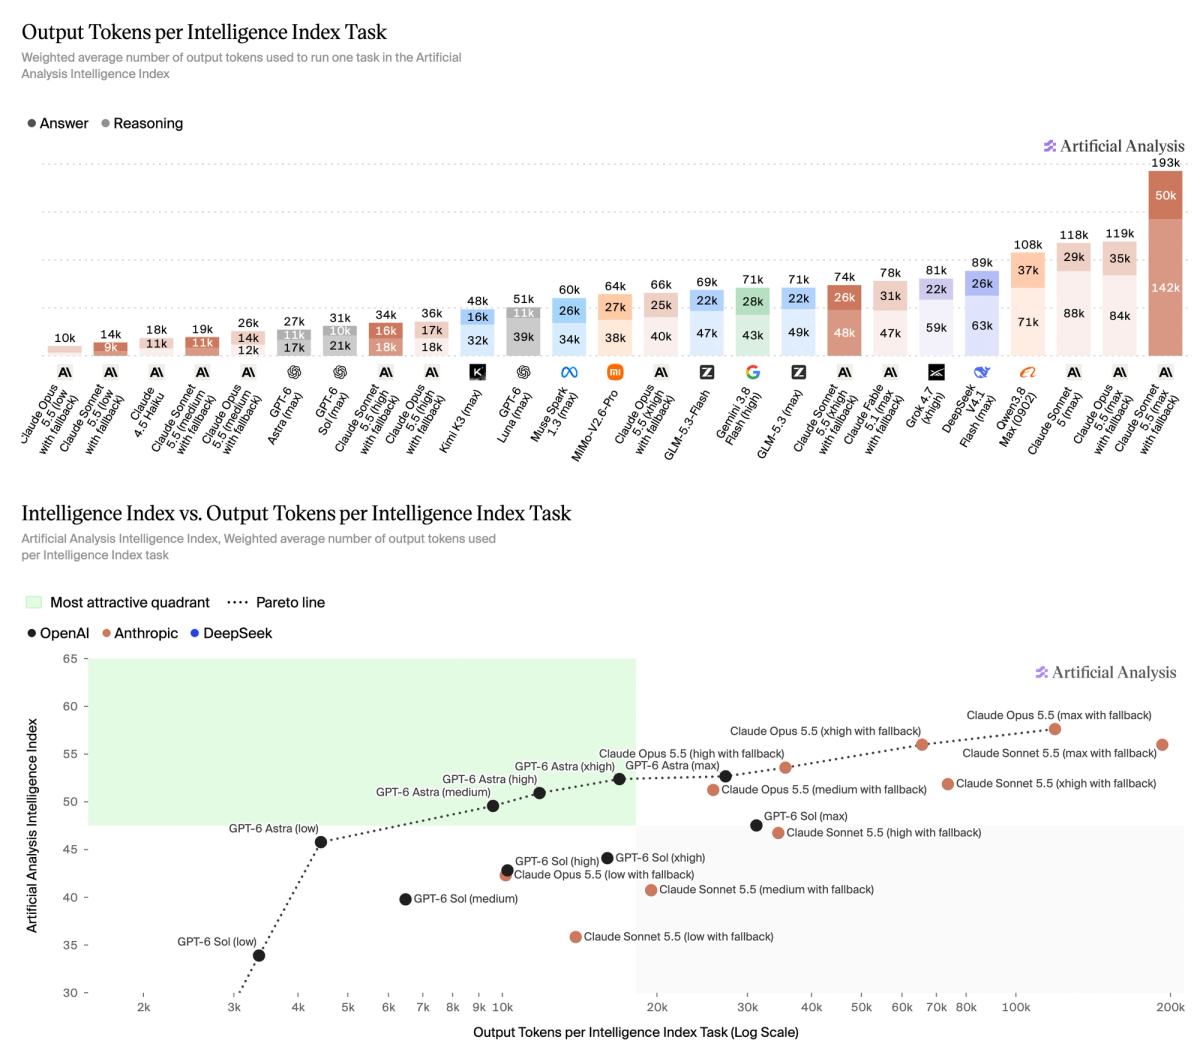
➤ Mức sử dụng token cao nhất mà chúng tôi từng đo lường: Ở mức nỗ lực tối đa, nơi mô hình đạt hiệu suất gần bằng Opus 5.5, Claude Sonnet 5.5 đã sử dụng ~193k Output Tokens cho mỗi tác vụ Intelligence Index. Đây là mức sử dụng token cao nhất mà chúng tôi từng đo lường, cao hơn khoảng 60% so với Opus 5.5 (max) hoặc Sonnet 5 (max) và gấp khoảng 7 lần GPT-6 Astra (max).
➤ Giá vẫn giữ ở mức $2/$10 cho mỗi triệu token input/output, tương đương với GPT-6 Sol: Với mức giá này, Claude Sonnet 5.5 nằm ngoài đường biên Pareto về Intelligence so với Cost per Task. Ở các mức nỗ lực cao, nó đứng sau Opus 5.5, trong khi các mức nỗ lực thấp hơn có các cấu hình GPT-6 Astra hoặc Sol mang lại hiệu suất tương đương với chi phí thấp hơn. Thiết lập nỗ lực cao là cấu hình cạnh tranh nhất dựa trên tiêu chí này, đứng rất sát sau GPT-6 Sol về Intelligence với Cost per Task gần như tương đương.
➤ Đứng sau Opus 5.5 về kiến thức thực tế và suy luận khoa học: Là một mô hình thuộc phân khúc nhỏ hơn, Sonnet 5.5 vẫn tụt hậu về kiến thức thực tế trong AA-Omniscience so với Opus 5.5. Mô hình đạt 54% so với 66% về độ chính xác thực tế, mặc dù có tỷ lệ ảo tưởng (hallucination) thấp hơn (47% so với 59%). Nó cũng thấp hơn khoảng 6 điểm trong các bài kiểm tra Humanity's Last Exam và SciCode so với Opus.
Các đánh giá này được thực hiện trên phiên bản tiền phát hành của Claude Sonnet 5.5, phiên bản mà Anthropic phát hiện có một lỗi có thể làm giảm chất lượng phản hồi đối với các yêu cầu sử dụng đầu ra có cấu trúc (structured outputs). Lỗi này đã được khắc phục cho bản phát hành công khai và Anthropic dự đoán sẽ có rất ít thay đổi hoặc hiệu suất có thể bị đánh giá thấp hơn một chút, nhưng chúng tôi sẽ sớm chạy lại các đánh giá liên quan.
Các chi tiết khác về mô hình:
➤ Cửa sổ ngữ cảnh (Context window): 1 triệu token với đầu vào hình ảnh và văn bản, không thay đổi so với Sonnet 5.
➤ Giá cả: Không thay đổi so với mức $2/$10 mới nhất của Sonnet 5 cho mỗi 1 triệu token input/output; ghi cache ở mức $2.5, đọc cache ở mức $0.2.
➤ Các thiết lập nỗ lực (Effort settings): Năm mức (thấp, trung bình, cao, xhigh, max). Các đánh giá Intelligence Index được thực hiện ở cả năm mức với tính năng dự phòng mặc định của Anthropic được bật. Chúng tôi thấy Sonnet 5.5 chuyển sang chế độ dự phòng trong khoảng 0.1% các tác vụ trên Intelligence Index, chủ yếu trong Terminal-Bench 4.0, và trong mọi trường hợp đều chuyển sang Sonnet 5.
Claude Sonnet 5.5 (max) đạt những bước tiến lớn trên Terminal-Bench, nằm trong số các mô hình hàng đầu cho cả Terminal-Bench 4.0 và Terminal-Bench-Science. Trong Terminal-Bench 4.0, mô hình đạt 64%, tăng 50 điểm so với Claude Sonnet 5 (max) và cao hơn một chút so với mức 60% của Opus 5.5 và GPT-6 Astra (xhigh).
Trên bảng xếp hạng Terminal-Bench-Science của chúng tôi, một tiêu chuẩn đánh giá việc sử dụng terminal tác tử để hoàn thành các quy trình nghiên cứu khoa học thực tế trên nhiều lĩnh vực, mô hình đạt 53% và chỉ đứng sau GPT-6 Astra và Opus 5.5. Terminal-Bench-Science hiện chưa được đưa vào Artificial Analysis Intelligence Index.
Để đạt được hiệu suất vượt trội, Claude Sonnet 5.5 (max) sử dụng ~193k output tokens cho mỗi tác vụ Intelligence Index, mức cao nhất chúng tôi từng đo lường và gấp khoảng 7 lần so với GPT-6 Astra (max).
Tuy nhiên, các thiết lập nỗ lực thấp hơn của mô hình bao phủ phạm vi rộng hơn về sự đánh đổi giữa Intelligence và Output Tokens per Task, với các thiết lập nỗ lực thấp, trung bình và cao đứng sau các mức nỗ lực cao, xhigh và max của GPT-6 Sol. Trong phạm vi này, Sol cung cấp hiệu suất cao hơn với ít output tokens hơn.
Bảng phân tích đầy đủ các đánh giá riêng lẻ trong Artificial Analysis Intelligence Index cho Claude Sonnet 5.5 trên tất cả các mức nỗ lực suy luận:
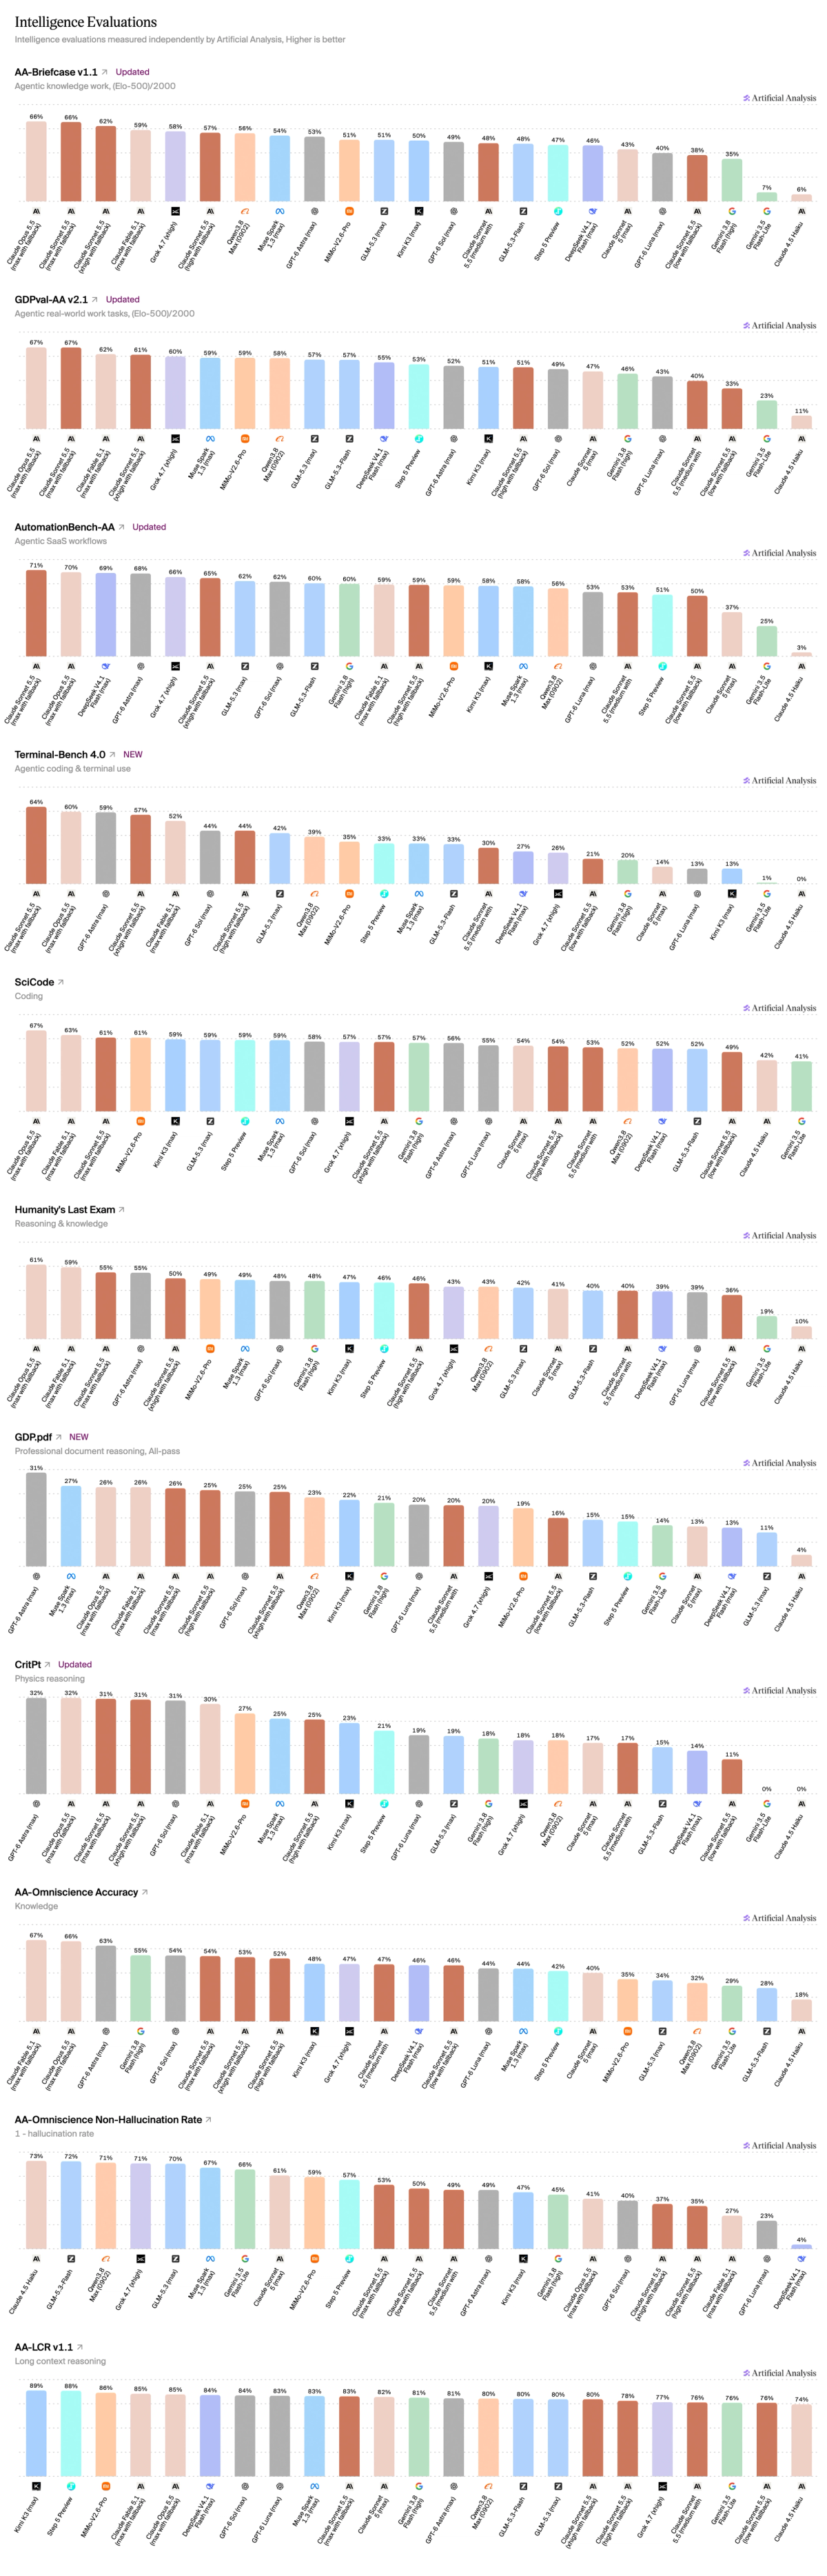
So sánh Claude Sonnet 5.5 với các mô hình hàng đầu khác tại: So sánh Claude Sonnet 5.5 với các mô hình hàng đầu khác
Bài viết được AI dịch và tổng hợp tự động từ Artificial Analysis bài đầy đủ (Web). Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.