Quan điểm
Sáng kiến 'Đánh giá viên nội bộ': Bước đi mới của Anthropic trong kiểm soát AI
(giờ Việt Nam)
Tóm tắt AI
Dario Amodei cam kết đưa các chuyên gia độc lập vào làm việc trực tiếp tại Anthropic với quyền truy cập nội bộ, nhằm giám sát quá trình phát triển AI một cách minh bạch và khách quan hơn.
Chính văn · Bản dịch AI
Bài luận Chúng ta phải tạo nhịp độ cho các mô hình tiên phong của Dario Amodei đã cam kết Anthropic sẽ sử dụng các đánh giá viên nội bộ (embedded evaluators). Những người này sẽ được đặt bên trong Anthropic và được cấp quyền truy cập ngang hàng với nhân viên, để họ có thể đưa ra góc nhìn khách quan cũng như các báo cáo về những gì đang diễn ra.
Chỉ có một vấn đề duy nhất. Ai sẽ là những đánh giá viên đó?
OpenAI cũng làm theo khi cam kết sử dụng các đánh giá viên, đồng thời đưa ra một lời kêu gọi tuy nhạt nhòa nhưng đáng hoan nghênh về việc phối hợp quốc tế. Tôi cũng sẽ đề cập đến vấn đề đó ở đây.
Điều tôi sẽ không đề cập hôm nay, nhưng hy vọng sẽ làm vào ngày mai, là chuỗi sự cố hack AI mới nhất vừa được đưa ra ánh sáng vào cuối tuần qua. Điều này làm nổi bật thực tế rằng chúng ta rất cần ít nhất là các đánh giá viên nội bộ, và có lẽ là cả những biện pháp nghiêm ngặt hơn nhiều.
Hiện tại, bạn cần biết rằng có nhiều sự cố hơn mà OpenAI đã không tiết lộ, cùng với một sự cố mới vừa xảy ra tại OpenAI buộc họ phải tạm dừng mô hình tiên tiến nhất của mình một lần nữa. Tôi sẽ sớm làm rõ tất cả những điều đó.
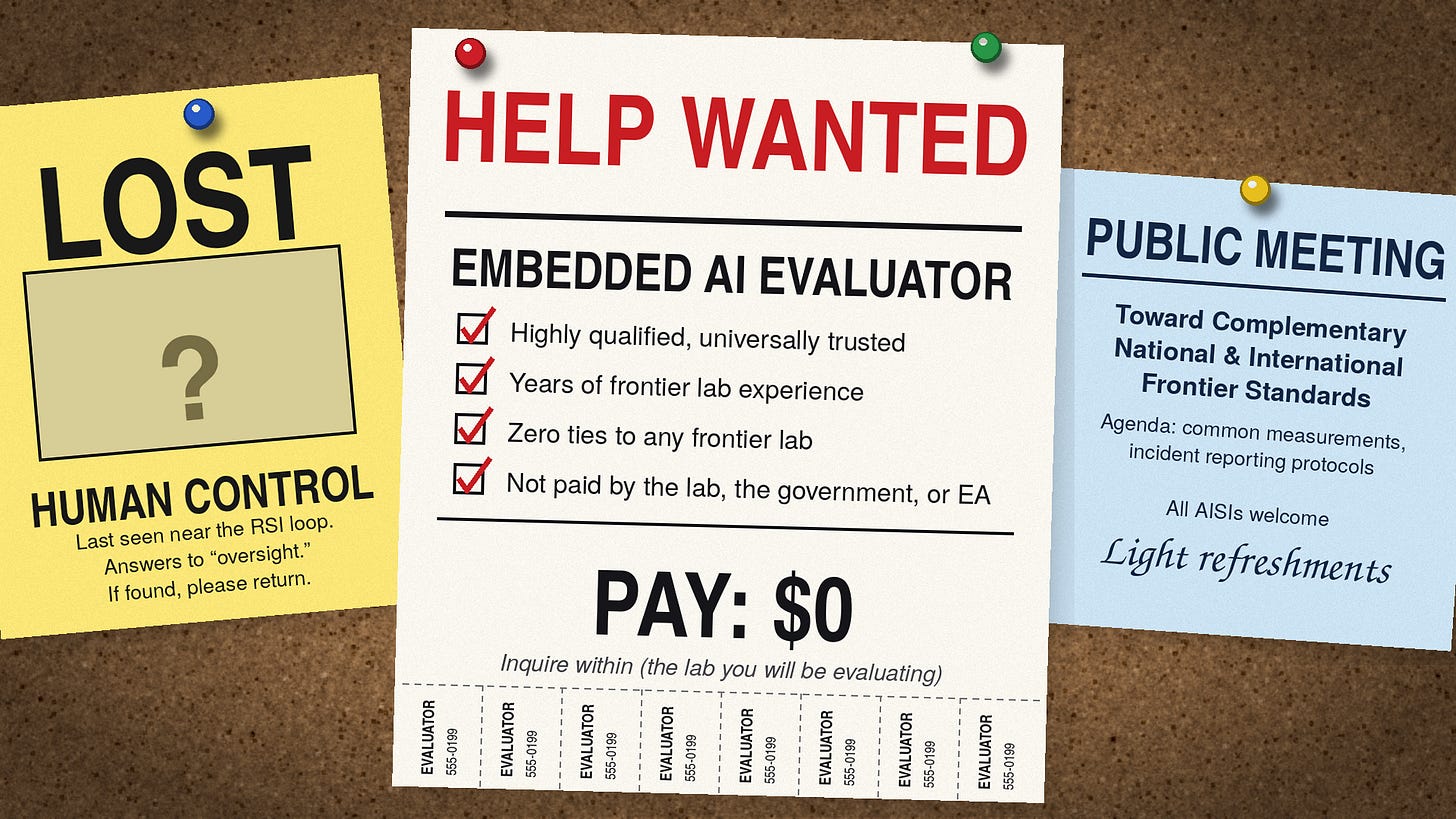
- Này, tất cả những gì tôi yêu cầu là bạn hãy tìm một nguồn đánh giá viên nội bộ có trình độ cao, giàu kinh nghiệm, đáng tin cậy, không có xung đột lợi ích, làm việc hoàn toàn miễn phí, không cần sự hỗ trợ của chính phủ hoặc tiền từ các nguồn EA không do chính phòng thí nghiệm đó lựa chọn.
- Anthropic hợp tác với Accenture để thực hiện đánh giá nội bộ, cũng có kế hoạch đưa METR vào tham gia.
- Đọc về METR.
- OpenAI đề xuất thực hiện những việc tối thiểu nhất có thể.
Tại sao bạn lại nói với tôi rằng việc này khó?
Rõ ràng tất cả các yêu cầu trong tiêu đề phần trên đều đáng mong đợi, dù xét riêng lẻ hay tổng thể. Chúng đều là những thứ "có thì tốt". Vấn đề là, trong điều kiện hiện tại, bạn rõ ràng không thể đạt được tất cả những điều đó cùng một lúc.
- Ai đó, ở đâu đó, phải thuê nhân sự và chi trả hóa đơn.
- Những người có trình độ, kinh nghiệm và đáng tin cậy cần phải tích lũy được kinh nghiệm và sự tin tưởng đó theo một cách nào đó, và điều này chắc chắn sẽ liên quan đến các phòng thí nghiệm hàng đầu.
Tôi không nói rằng những lời phàn nàn là không hợp lệ, nhưng ngay cả các chương trình kiểm toán uy tín, lâu đời cũng hầu như thiếu các giải pháp tốt. Vấn đề "cửa xoay" (revolving door) và nguồn tài trợ là những bài toán khó. Dù vậy, bạn vẫn cần phải kiểm toán.
Một nhóm do Geoffrey Hinton, Stuart Russell và Arvind Narayanan dẫn đầu đã đưa ra các tiêu chuẩn tối thiểu của họ cho các đánh giá viên nội bộ đáng tin cậy trong một bức thư công khai:
- Các công ty AI tiên phong nên dựa vào những đánh giá viên có tính độc lập thực sự.
- – Các khoản thanh toán không được phụ thuộc vào kết quả đánh giá, không được có quan hệ sở hữu, quản trị hoặc bất kỳ mối quan hệ thương mại nào khác, và không được có quyền kiểm soát biên tập. Mọi xung đột lợi ích cần phải được công khai.
- Các công ty AI tiên phong nên kết hợp các quan điểm và lĩnh vực chuyên môn khác nhau.
- Các đánh giá viên nội bộ nên minh bạch.
- Các đánh giá viên nội bộ nên được bảo vệ khỏi sự trả đũa từ các công ty mà họ đang làm việc cùng.
- Các công ty AI tiên phong nên cấp cho các đánh giá viên nội bộ quyền truy cập tương đương với các nhân viên có đặc quyền cao của chính họ, ngoại trừ các trường hợp cần bảo vệ dữ liệu.
Tôi đồng ý. Đó có vẻ là một danh sách tốt.
Gabriel Weil đã chỉ ra vào tháng 7 rằng bạn không muốn để nhà phát triển AI tự thuê trọng tài cho chính mình. Nhưng nếu chính phủ không muốn dính dáng đến việc chi trả, và nếu mọi thứ đang có vẻ khá thù địch với toàn bộ quy trình này, thì ai sẽ là người chọn và thuê họ?
Chúng ta đang sống trong một thời đại ngớ ngẩn. Weil lo ngại rằng chính phủ sẽ gặp khó khăn trong việc giám sát các IVO (tổ chức đánh giá độc lập) thực hiện kiểm toán. Ông ấy đã không tính đến việc Nhà Trắng có thể chủ động tức giận với các cuộc kiểm toán vì lý do nguyên tắc. Đề xuất của Weil là bảo hiểm trách nhiệm bắt buộc; đây là một ý tưởng hay, mặc dù phiên bản thực hiện đầy đủ chức năng thì không thể mua được, còn phiên bản được bán ra trên thị trường lại không bao gồm các loại sự kiện mà chúng ta lo ngại nhất.
Nếu Anthropic trị giá 2,2 nghìn tỷ USD và chúng ta lo ngại họ có thể "miễn nhiễm với phán quyết" (judgment-proof), vậy thì chính xác ai mới là người không bị như vậy?
Tôi hoàn toàn ủng hộ việc yêu cầu bảo hiểm thông thường (hoặc cơ bản) cho các mô hình AI vượt ngưỡng năng lực nhất định, bao gồm cả trước khi triển khai nội bộ hoặc phát hành trọng số, chứ không chỉ là triển khai bên ngoài khép kín. Nó sẽ hữu ích ở một mức độ nào đó. Điều nó không làm được là giải quyết trực tiếp các vấn đề quan trọng nhất.
Một khả năng là bạn yêu cầu mua, giả sử là 100 tỷ hoặc 1 nghìn tỷ USD bảo hiểm, không phải vì điều đó sửa chữa các động cơ thúc đẩy, mà vì khi đó chúng ta có thể yêu cầu họ công bố chính xác chi phí bảo hiểm đó là bao nhiêu, và yêu cầu công ty bảo hiểm tiết lộ các yếu tố rủi ro liên quan mà họ đã sử dụng để định giá.
Họ đã công bố quan hệ đối tác với Accenture.
Anthropic: Quan hệ đối tác này sẽ được dẫn dắt bởi Faculty, bộ phận kinh doanh AI chuyên biệt của Accenture, và sẽ bao gồm việc đánh giá và thử nghiệm tấn công (red-teaming) các mô hình, thực hiện đánh giá sự liên kết (alignment assessments) và kiểm tra các biện pháp bảo vệ mô hình. Accenture giúp các doanh nghiệp và chính phủ triển khai AI trên nhiều ngành công nghiệp. Sự hiểu biết của họ về cách các doanh nghiệp sử dụng AI trong thực tế sẽ cung cấp thông tin cho phương pháp tiếp cận an toàn của họ, và họ sẽ mang góc nhìn đó vào việc đánh giá các mô hình của chúng tôi. Anthropic và Accenture dự kiến mỗi bên sẽ đầu tư ít nhất 1 tỷ USD để xây dựng năng lực trong lĩnh vực này trong năm năm tới. … Với tầm quan trọng và tính cấp bách của công việc này, Anthropic sẽ tài trợ trực tiếp cho công việc của Accenture. Chúng tôi cũng đang đối thoại với METR và các tổ chức đánh giá phi lợi nhuận khác để thí điểm các yếu tố của đánh giá nội bộ bằng nguồn tài trợ của chính họ. Cuối cùng, chúng tôi tin rằng AI tiên phong cần một hệ sinh thái các đánh giá viên hoạt động với các tiêu chuẩn chung. Chúng tôi kỳ vọng các phòng thí nghiệm tiên phong sẽ làm việc với nhiều tổ chức cùng một lúc. Quan hệ đối tác của chúng tôi không độc quyền; Anthropic sẽ làm việc với các đánh giá viên khác sẽ được công bố trong những tuần tới, và Accenture sẽ làm việc với các nhà phát triển AI khác với năng lực tương tự. Charles: Có vẻ hoàn toàn ổn khi để Accenture làm việc này nhằm thỏa mãn những lo ngại về tính trung lập của METR, miễn là họ cũng để METR thực hiện điều đó.
Từ các cuộc thảo luận nền tảng và thông tin khác, cộng với cách đọc hiểu đơn giản ở đây, tôi hiểu rằng Anthropic có kế hoạch sử dụng kết hợp cả hai phương pháp.
- Các tổ chức phi lợi nhuận đi kèm với nguồn tài trợ và chuyên môn riêng, có thể cung cấp cái nhìn sâu sắc từ bên trong kết hợp với sự tập trung vào các mối lo ngại về an toàn.
- Cách tiếp cận doanh nghiệp lớn, chính thức, dễ hiểu, mang tính chất nhìn từ bên ngoài giống như cách bạn làm nếu bạn là một thẩm phán.
Drake Thomas lập luận cho một logic tương tự:
Drake Thomas (Anthropic): Việc các công ty AI chịu sự giám sát từ những đội ngũ chuyên gia xuất sắc, có kinh nghiệm hàng đầu thế giới trong việc nghiên cứu các vấn đề căn chỉnh (alignment) tiên phong là điều tốt. Việc các công ty AI chịu sự giám sát từ các nguồn độc lập, nhàm chán một cách hoàn hảo mà ngay cả những kẻ có ý đồ xấu cũng khó lòng tìm ra điểm để phàn nàn cũng là điều tốt. Tính đến tháng 9 năm 2026, bạn chưa thể đạt được mức tối đa của cả hai trục này trong cùng một nguồn, nhưng không gì ngăn cản bạn có nhiều nguồn đánh giá độc lập! Tôi nghĩ Accenture và METR đều nằm trên đường biên Pareto của các lựa chọn. Rõ ràng, bất kỳ công ty AI tiên phong nào không lồng ghép sâu sắc các tổ chức kiểu METR/Apollo vào việc đánh giá thực tiễn của họ đều đang thất bại trong việc giải trình với công chúng (ít nhất là cho đến khi có thêm nhiều đơn vị tư vấn thông thường với đội ngũ chuyên gia kiểm toán AI chuyên sâu, điều mà tôi hy vọng sẽ sớm xảy ra). Và tôi thực sự nghiêm túc về khái niệm đường biên Pareto, tôi nghĩ nhiều người đang đánh giá thấp Accenture? Kiểu như, hãy lướt qua tài khoản Twitter của CTO Accenture và CEO Faculty @MarcWarner10, đây không phải là những người chưa từng nghe nói về an toàn AI! Sau khi suy ngẫm, tôi nghĩ [điều trên] hơi phiến diện và muốn bổ sung hai lưu ý: (1) Việc cung cấp tài trợ rõ ràng tạo ra xung đột lợi ích (COI) ở đây, điều mà ví dụ như với METR thì không có. (2) Theo một số cách, nhiều nguồn giám sát hơn mang tính cộng hưởng - có thêm cơ hội để phát hiện và minh bạch về các vấn đề là rất tốt - nhưng có một cái giá phải trả là các phòng thí nghiệm có thể nhấn mạnh vào các đánh giá thân thiện nhất hoặc sử dụng chúng như một lá chắn chống lại các đánh giá bên ngoài mang tính phê phán hơn. Tôi có chút lo ngại rằng ngay cả với một nhóm nhân tài rất giỏi thực hiện công việc, sẽ khó hơn để đưa ra những nhận xét phê phán thẳng thắn/kỳ lạ như "công ty này đang gánh chịu nhiều rủi ro hiện hữu và nên dừng lại ngay lập tức" từ bên trong một công ty "bình thường" lớn. Scott Alexander: Là một người tin vào thuyết định mệnh tên gọi, tôi ủng hộ việc bạn chọn một người có họ là "Warner" cho công việc này.
Những vấn đề rõ ràng khi sử dụng Accenture bao gồm việc Accenture và Anthropic trước đây đã hợp tác, và việc Anthropic sẽ tài trợ cho hoạt động này. Cả hai đều không lý tưởng, nhưng một lần nữa, đâu là giải pháp thay thế? Đây đáng lẽ phải là công việc của bộ phận Faculty, nếu họ giữ vững văn hóa và duy trì sự độc lập thì đây là một lựa chọn hợp lý. Họ có nhiều khía cạnh dễ hiểu và đáng tin cậy, đồng thời họ cũng có bề dày thành tích.
Leo Gao (OpenAI): ôi trời tôi chắc chắn rằng accenture sẽ có rất nhiều chuyên môn trong việc, ừm, *kiểm tra ghi chú* redteaming các mô hình, đánh giá sự căn chỉnh và kiểm tra các biện pháp bảo vệ. xét cho cùng, trang web của họ nói về việc nắm bắt sức mạnh của sự thay đổi để tạo ra giá trị 360° và thành công chung cho khách hàng, con người, cổ Sy: công bằng mà nói, Faculty thực sự có chuyên môn đáng kể trong các công việc đánh giá mà họ đang làm. Họ làm việc với hầu hết tất cả các khách hàng quan trọng. Anka Reuel: Sẽ rất hữu ích nếu @Accenture chia sẻ một ví dụ về báo cáo đánh giá một mô hình tiên phong. Nhiều đồng nghiệp của tôi, bao gồm cả tôi, lo ngại về việc liệu họ có đủ chuyên môn hay không vì chúng tôi chưa thấy các ví dụ công khai chứng minh điều đó. @MarcWarner10 @AnthropicAI
Luke Muehlhauser lạc quan và chỉ ra một số người giỏi có liên quan. Oliver Habryka và Dave Kasten thì hoài nghi.
Nếu phải chọn một đơn vị đánh giá để nhúng vào, tôi sẽ chọn METR.
Nếu phải chọn hai đơn vị đánh giá để nhúng vào, tôi sẽ chọn METR, và sau đó tôi sẽ chọn một đơn vị nào đó dễ hiểu và nhàm chán hơn. Các lựa chọn không mấy khả quan.
Về lý thuyết, lựa chọn đầu tiên của tôi cho vị trí dễ hiểu sẽ là UK AISI, nhưng có những lý do rõ ràng khiến điều đó có lẽ sẽ không phù hợp với Nhà Trắng. CAISI sẽ rất tuyệt về mặt lý thuyết nếu Nhà Trắng đồng ý và muốn tài trợ cho việc đó. Sau đó, bạn nhìn vào bốn công ty kiểm toán lớn (Big Four), nhưng không công ty nào có chuyên môn và ba trong số đó là các cửa hàng sử dụng Claude giống như Accenture. Có lẽ là MITRE hoặc RAND, nhưng tình hình tài trợ ở đó lại có những vấn đề riêng. Không có lựa chọn nào thực sự tốt.
Bạn có thể giúp giải quyết vấn đề này bằng cách tự thành lập công ty kiểm toán của riêng mình ngay hôm nay.
Drake Thomas xếp hạng các quan điểm về đơn vị đánh giá bên thứ ba được nhúng từ tệ nhất đến tốt nhất. Hệ thống phân loại này và thứ tự của nó có vẻ đúng với tôi.
Phần lớn các quan điểm như vậy theo số lượng đều thấp hơn điểm không, và không có quan điểm nào đưa ra lập luận thực tế cho việc 'không, chúng ta không nên có các đơn vị đánh giá được nhúng'.
Dưới đây là bảng xếp hạng các quan điểm về đánh giá của bên thứ ba được nhúng (embedded third party evaluation) trong tuần qua, từ tệ nhất đến tốt nhất: [chế giễu vô căn cứ nhắm vào nhóm đối lập] METR tệ vì [biểu đồ Sankey khổng lồ]. kiểm chứng thực tế ư? các mốc thời gian về đầu tư tương đối tạo ra ý nghĩa nhân quả ư? xác định con số nào là phân số lớn hay nhỏ của các con số khác ư? nghe giống mấy thứ nhảm nhí kiểu EA với tôi quá. cứ nhìn vào biểu đồ với những đường cong đó đi, bạn CÓ THỂ thấy cả một ổ rắn. METR tệ vì [một chuỗi các tác nhân cụ thể có mối quan hệ cặp đôi với nhau, dẫn đến một người mà việc họ có xung đột lợi ích (COI) mạnh mẽ với người đó là điều không tốt, ví dụ: “METR từng nhận tài trợ từ một tổ chức từng nhận tài trợ từ một người từng tài trợ cho một công ty AI tiên phong hiện nay”]. Thật hạ thấp phẩm giá của tôi khi phải giải thích điều này thực sự ảnh hưởng thế nào đến việc ra quyết định của METR; bạn chỉ nên mơ hồ thực hiện một sự liên kết cảm xúc rồi lướt tiếp đi. Đừng suy nghĩ quá nhiều. này các bạn, các bạn PHẢI nhúng công ty/tổ chức của tôi vào các phòng thí nghiệm. Tôi đã là người ủng hộ kiên định cho các kiểm toán viên bên thứ ba được nhúng kể từ 7 phút trước khi tôi thấy bài luận này trở nên phổ biến. Hãy nhìn vào thứ mà chúng tôi từng xuất bản, trông cũng giống như an toàn AI nếu bạn nheo mắt lại! Đừng sợ, tôi có thể đảm bảo với bạn rằng tôi chưa bao giờ làm bất cứ điều gì vị tha trong đời và nếu có, tôi cũng sẽ làm không hiệu quả. Tôi quan sát thấy [tác nhân chính trị hóa] đã có [quan điểm tồi]. Hãy để tôi sử dụng quan sát đúng đắn này để ghi điểm cho phe mình và chính trị hóa tình hình hơn nữa. === điểm không: các quan điểm vượt qua dòng này tốt hơn là việc thoát ứng dụng === Gửi [người có quan điểm điên rồ], đây là lời giải thích chân thành về lý do tại sao bạn sai. METR tệ/có vấn đề vì [một mối quan ngại thực sự hợp lý, như việc có sự chồng chéo văn hóa lớn hơn với Anthropic so với OAI hoặc áp lực buộc nhân viên cá nhân phải giữ mối quan hệ đủ tốt với các phòng thí nghiệm để sau này có thể được tuyển dụng], mà không có thêm đề xuất nào về việc phải làm gì với vấn đề này. Các dòng tweet đồng thời thừa nhận rằng (1) sự độc lập xã hội nhiều hơn khỏi các phòng thí nghiệm là tốt và (2) hầu hết mọi người có năng lực đều có kết nối xã hội với các phòng thí nghiệm, ngay cả khi họ không đề xuất giải pháp. [bất kỳ quan điểm nào tham gia vào đánh giá cấp độ đối tượng về các công ty AI được thực hiện bởi một tổ chức bên thứ ba như METR, SecureBio, Guidelight, Redwood, Nightingale, Apollo, v.v.] === biên giới thảo luận hiện tại: các quan điểm vượt qua dòng này tốt hơn bất kỳ quan điểm nào từng được đăng tải === Tôi có [mối quan ngại thực sự hợp lý] với METR/Redwood/v.v. Để giải quyết mối quan ngại này, chúng ta nên thực hiện [đề xuất cụ thể có ý nghĩa và sẽ giải quyết được vấn đề]. Tôi đang thành lập một tổ chức đánh giá bên thứ ba mới / chuyển hướng tổ chức hiện tại của mình để thực hiện nhiều đánh giá bên thứ ba hơn. Chúng tôi đang thực hiện [việc vừa (1) không giống hệt METR (2) hữu ích cho việc đánh giá các công ty AI]. Công việc ban đầu của chúng tôi sẽ tập trung vào [việc cụ thể, hữu hình có thể giúp ích]. METR có vấn đề X. Thay vào đó, chúng ta nên sử dụng tổ chức Y đã có từ trước, tổ chức không có vấn đề X và có chuyên môn tương đương trong việc đánh giá rủi ro mất kiểm soát và các sự cố sai lệch bên trong các công ty AI, ví dụ như [công việc tương tự mà họ đã từng thực hiện]. (đây sẽ là một quan điểm tuyệt vời nhưng không thể đăng tải vì không có tổ chức nào như vậy tồn tại)
OpenAI đã đưa ra một bài luận mới về chủ đề này, Xây dựng các tiêu chuẩn cho giai đoạn tiếp theo của AI. Họ nhấn mạnh rằng mục tiêu của họ vẫn là một nhà nghiên cứu AI tự động, sau đó sẽ được yêu cầu thực hiện các bài tập về sự liên kết (alignment) của chúng ta, nhưng chỉ khi điều đó có thể được thực hiện một cách an toàn.
OpenAI: RSI hoàn toàn tự chủ chưa xảy ra hôm nay, và chúng ta không nên theo đuổi nó trừ khi và cho đến khi nó có thể được thực hiện một cách an toàn. Việc có nên tiếp tục hay không và làm như thế nào phải phụ thuộc vào khả năng duy trì quyền kiểm soát của con người và vào các lựa chọn dân chủ có hiểu biết về lợi ích và rủi ro. Nếu thực hiện mà không có sự cẩn trọng và thận trọng thích hợp, RSI có thể dẫn đến việc con người mất quyền kiểm soát thực tế đối với sự phát triển AI, không thể giám sát các quy trình nghiên cứu mà họ không còn hiểu rõ. Từ đây, AI có thể trở nên nguy hiểm hơn, ít liên kết hơn và nhìn chung là một mối nguy hiểm đối với con người.
Chúng ta đang ở thời điểm mà OpenAI nói rằng họ sẽ ‘tìm cách giữ con người trong vòng lặp’ của sự cải tiến, vì nếu không thì điều đó sẽ không xảy ra.
Tiếp theo, họ cảnh báo rằng các tiêu chuẩn quốc tế bị phân mảnh, hoặc thiếu hành động tập thể, có thể dẫn đến những kết quả tồi tệ. Đúng vậy.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Don't Worry About the Vase (Zvi). Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.