Ngành
Google TPU chạy Kimi nhanh hơn 57% so với GPU NVIDIA nhờ khung suy luận DeepSeek
(giờ Việt Nam)
Tóm tắt AI
Đội ngũ đứng sau vLLM vừa công bố bước đột phá khi tối ưu hóa khung suy luận DeepSeek, giúp Google TPU vượt mặt GPU NVIDIA với hiệu suất tăng 57% khi vận hành mô hình Kimi.
Chính văn · Bản dịch AI
< img id="wx_img" src="https://www.qbitai.com/wp-content/uploads/imgs/qbitai-logo-1.png" width="400" height="400">
26-09-2026 15:11:55 Nguồn: QbitAI
Sản phẩm từ đội ngũ startup vLLM
Kexie, đưa tin từ Aofeisi, QbitAI | Tài khoản chính thức QbitAI
16 chip Google TPU v7 chạy Kimi K3 đạt tốc độ 709 token/giây, nhanh hơn 57% so với GB200 của "lão Hoàng" (NVIDIA).
Đạt được thành tích này không phải là Moonshot AI (đơn vị tạo ra Kimi) hay Google (đơn vị tạo ra TPU), mà là một startup về suy luận (inference) có tên là Inferact.

Đội ngũ sáng lập Inferact chính là những nhân sự chủ chốt của vLLM, năm nay đã huy động được 150 triệu USD vòng hạt giống do a16z dẫn đầu, với định giá 800 triệu USD.
Họ đã viết một nhân (kernel) suy luận gọi là megakernel cho TPU, giúp hợp nhất hàng trăm chương trình nhỏ vốn cần lập lịch khi suy luận mô hình thành một chương trình lớn duy nhất.

Kết hợp với kiến trúc bộ nhớ trên chip độc đáo của TPU, megakernel đã đẩy hiệu suất sử dụng băng thông bộ nhớ lên gần mức giới hạn lý thuyết của phần cứng.
Với sự hỗ trợ của khung tăng tốc DSpark do DeepSeek đề xuất, K3 đã đạt được thành tích 709 token/giây trên TPU như đã đề cập ở trên.
Bộ mã này hiện đã được mã nguồn mở.
Cùng 16 chip, TPU nhanh hơn 57%
Inferact đã thực hiện một vòng benchmark so sánh TPU và GPU NVIDIA trong điều kiện hoàn toàn giống nhau, và TPU đã giành chiến thắng.
Thử nghiệm sử dụng 16 chip TPU v7 Ironwood đối đầu với 16 chip NVIDIA GB200, cả hai đều chạy Kimi K3 và sử dụng công cụ suy luận vLLM, biến số duy nhất là chip và việc triển khai kernel ở tầng dưới.
Kết quả cuối cùng, TPU đạt 709 token/giây, GB200 đạt 452 token/giây, tốc độ của TPU nhanh hơn 57%.

Tốc độ này có sự đóng góp của kỹ thuật giải mã suy đoán (speculative decoding) DSpark.
DSpark là khung tăng tốc suy luận do DeepSeek đề xuất, nguyên lý là để một mô hình nhỏ dự đoán nhanh một chuỗi token ứng viên, sau đó mô hình lớn sẽ xác thực hàng loạt chuỗi token này; nếu đoán đúng sẽ bỏ qua, nếu sai sẽ quay lại thực hiện lại.
Inferact đã chạy thành công quy trình này trên TPU, với độ dài chấp nhận (acceptance length) đạt 6, nghĩa là trong mỗi vòng dự đoán, trung bình có 6 token có thể được xác thực trực tiếp bởi mô hình lớn, thời gian cho mỗi bước giải mã (decode) khoảng 8,5 mili giây.
Khi tắt giải mã suy đoán để xem tốc độ gốc, khoảng cách vẫn rất lớn.
Với batch size bằng 1, TPU có thể chạy 249 token/giây, trong khi GB200 chỉ đạt 127, chênh lệch gần gấp đôi.
Khi tăng batch size lên 8, TPU đạt 865 token/giây, còn GB200 chỉ đạt 636.

Ngoài ra, trên Qwen, khoảng cách giữa hai loại chip còn lớn hơn.
Inferact sử dụng 4 chip TPU v7 để chạy Qwen 3.8 27B, đạt 1515 token/giây, trong khi cấu hình tương tự trên GB200 chỉ đạt 695.
Hơn nữa, việc tăng tốc này không gây mất mát độ chính xác. Inferact đã xác thực bằng greedy decoding, điểm số GPQA-Diamond của Kimi K3 trên TPU là 94,4%, GSM8K là 97,2%, hoàn toàn nhất quán với kết quả trên GPU.
Cùng công cụ suy luận, cùng mô hình, chỉ cần thay đổi chip, tốc độ đã chênh lệch tới 57%.
Mức chênh lệch này theo lý thuyết lẽ ra phải tìm thấy lời giải thích trên bảng thông số kỹ thuật phần cứng, nhưng thực tế lại hoàn toàn ngược lại.
Sức mạnh tính toán của hai loại chip nằm ở cùng một cấp độ, băng thông HBM của TPU v7 là 7380 GB/s, trong khi băng thông HBM của GB200 thậm chí còn cao hơn, đạt 8000 GB/s. Chip có băng thông lớn hơn lại cho tốc độ thấp hơn.
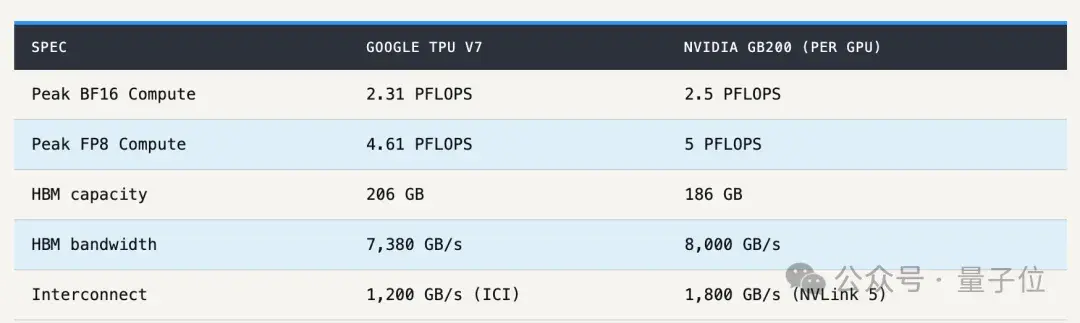
Sự chênh lệch tốc độ này thực chất bắt nguồn từ lớp phần mềm chạy trên chip.
Hợp nhất hàng trăm kernel nhỏ thành một chương trình lớn
Inferact đã giải quyết vấn đề hiệu suất suy luận trên TPU bằng giải pháp mang tên megakernel. Ý tưởng cốt lõi là hợp nhất hàng trăm chương trình nhỏ độc lập vốn cần lập lịch khi suy luận mô hình thành một chương trình lớn, từ đó loại bỏ sự lãng phí băng thông khi chuyển đổi giữa các chương trình.
Nút thắt cổ chai của tốc độ suy luận mô hình lớn không nằm ở tính toán, mà ở việc di chuyển dữ liệu.
Mỗi khi tạo ra một token, toàn bộ trọng số của mô hình phải được di chuyển từ bộ nhớ chính HBM vào bộ nhớ đệm tốc độ cao bên trong chip để tính toán, sau khi tính xong vòng này, token tiếp theo lại phải di chuyển lại từ đầu.
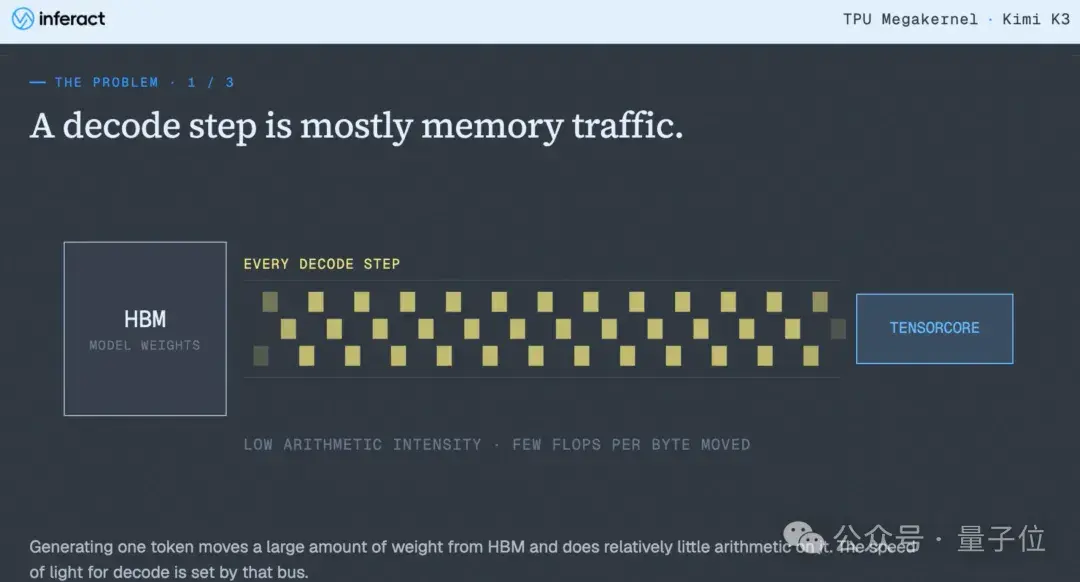
Cách tiếp cận truyền thống là chia một lần suy luận thành hàng trăm kernel độc lập, mỗi kernel chịu trách nhiệm cho một phần tính toán nhỏ.
Các kernel này xếp hàng thực hiện lần lượt, nhưng vấn đề vẫn nằm ở khoảng nghỉ giữa các lần chuyển giao.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ QbitAI. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.