Mô hình
Alibaba ra mắt Qwen3.8-LiveTranslate: Phiên dịch thời gian thực với độ trễ chỉ 2,3 giây
(giờ Việt Nam)
Tóm tắt AI
Đội ngũ Qwen của Alibaba vừa giới thiệu mô hình Qwen3.8-LiveTranslate với kiến trúc Interleave mới, giúp giảm độ trễ phiên dịch xuống còn 2,3 giây và hỗ trợ lên đến 60 ngôn ngữ.
Bản dịch AI
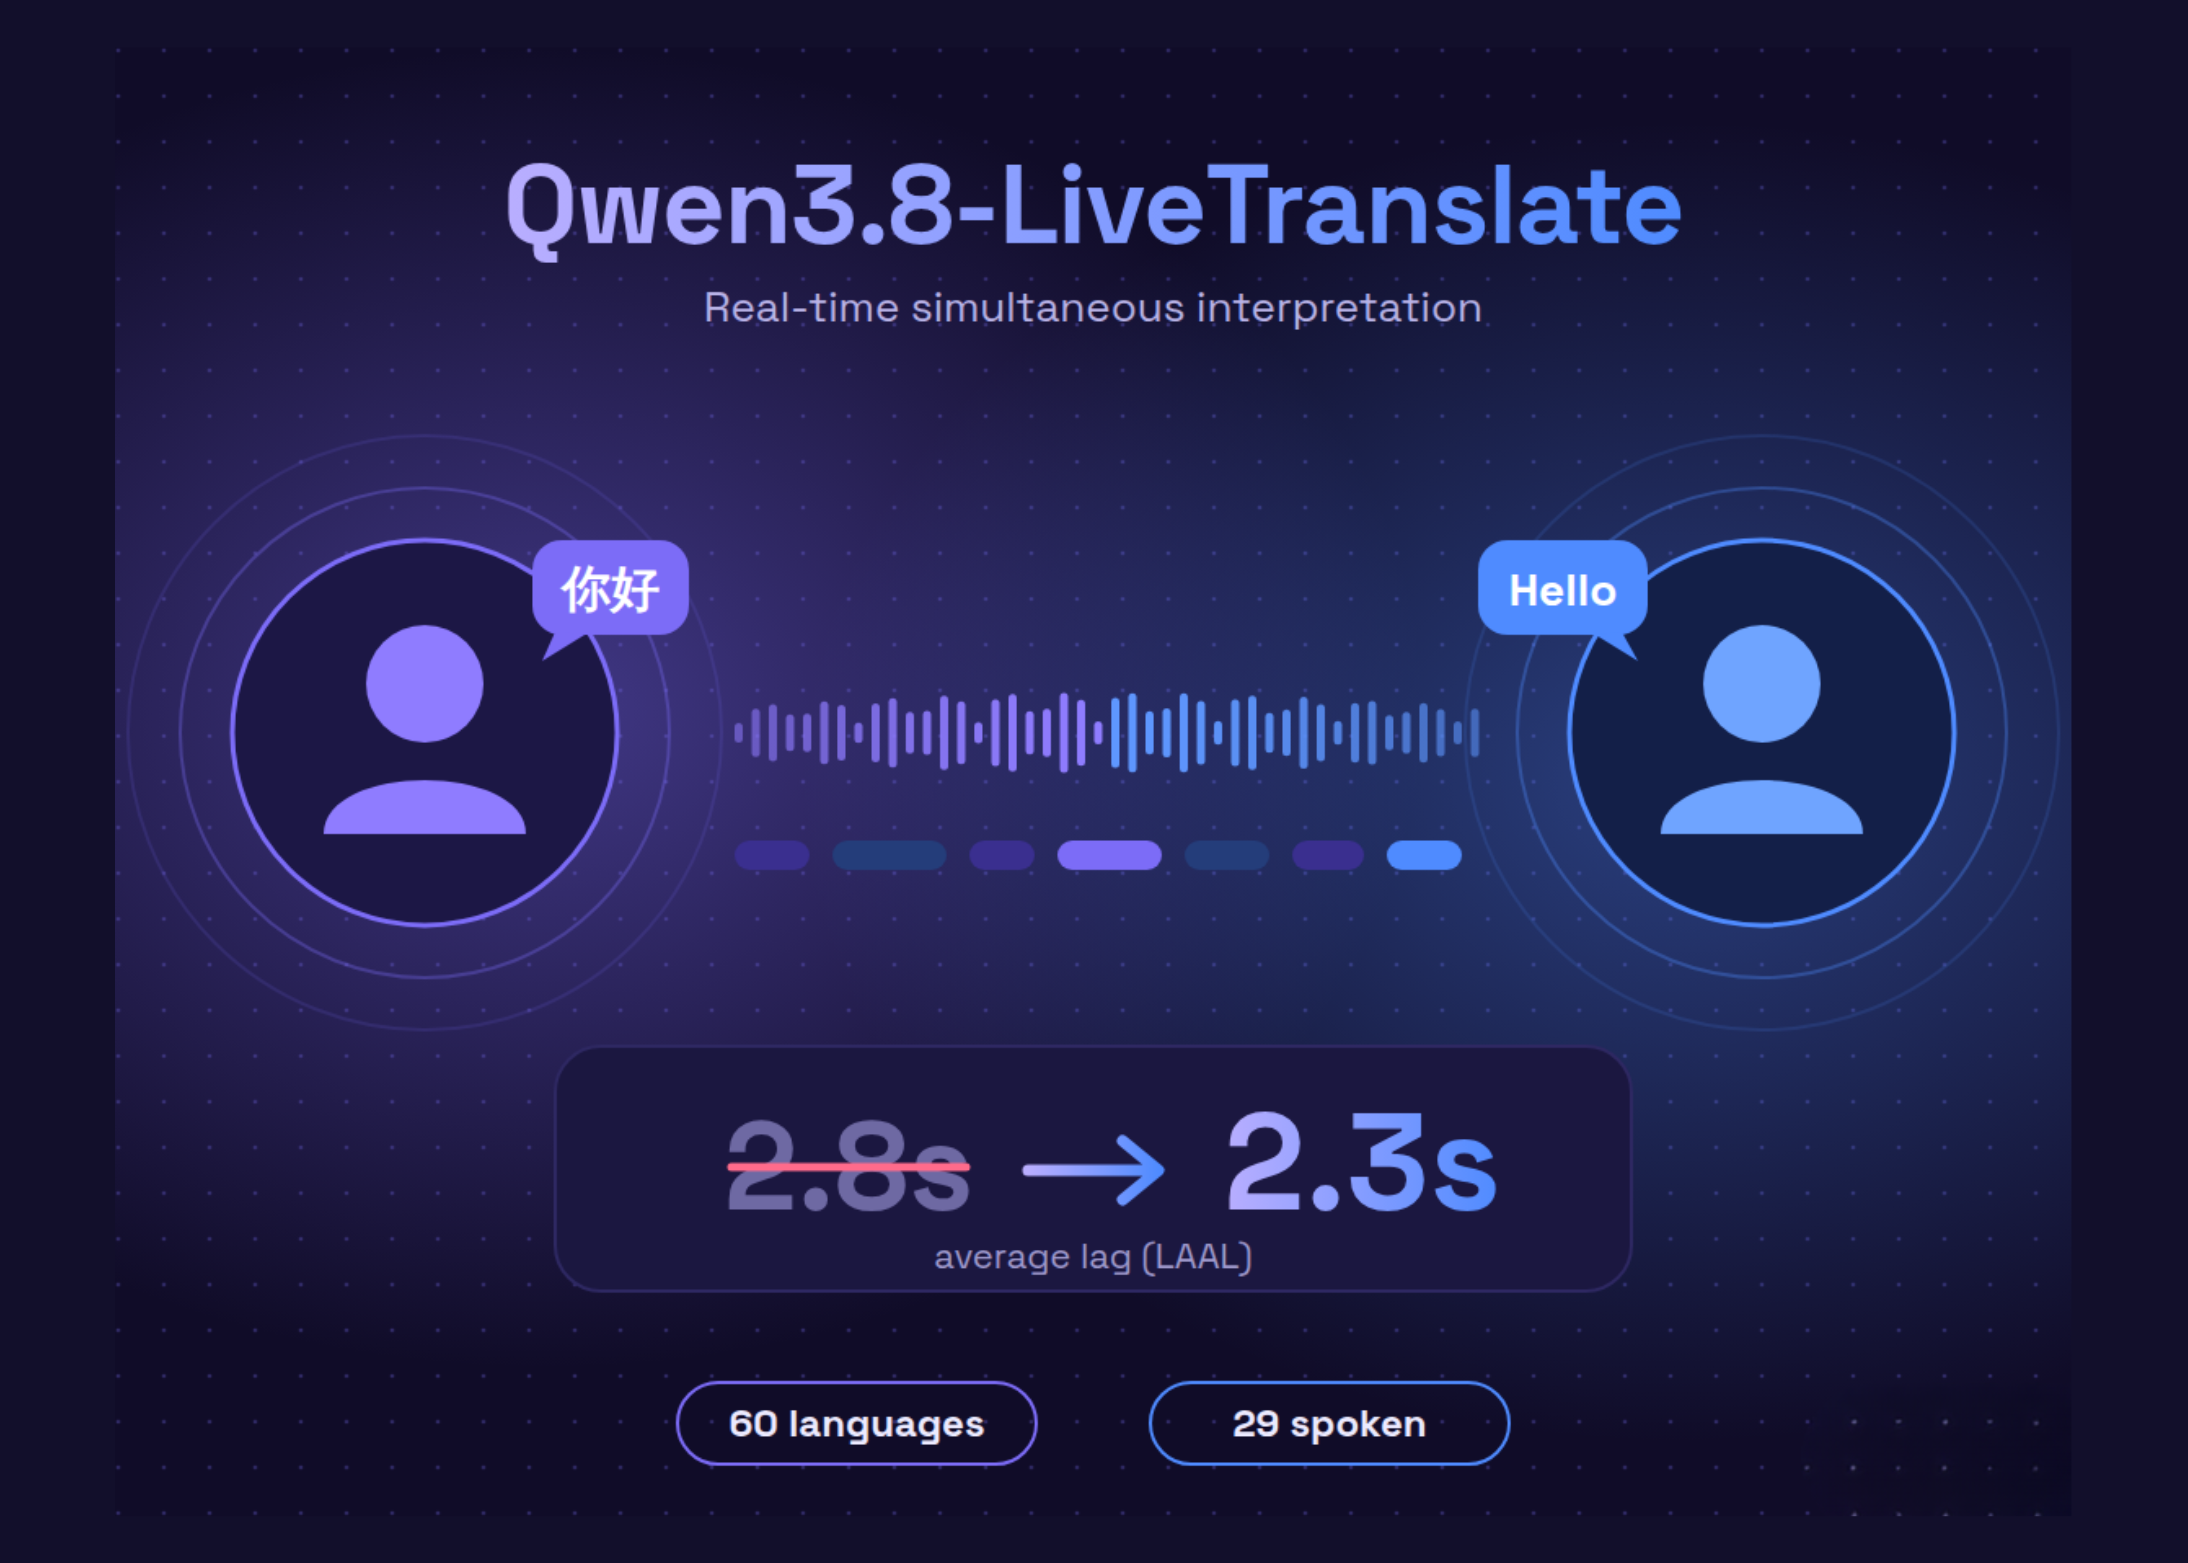
Qwen vừa ra mắt Qwen3.8-LiveTranslate, mô hình thông dịch đồng thời thời gian thực thế hệ tiếp theo của họ. Mô hình này lắng nghe giọng nói trực tiếp, có thể kết hợp thêm các khung hình video, và trả về văn bản cũng như âm thanh đã dịch ngay khi người nói vẫn đang tiếp tục phát biểu. Thay đổi cốt lõi nằm ở kiến trúc Interleave mới. Qwen báo cáo những cải thiện về độ trung thực, độ trôi chảy và tính súc tích, với độ trễ trung bình (LAAL) giảm từ 2,8 giây xuống còn 2,3 giây. Bản phát hành này cũng bổ sung tính năng phân đoạn người nói (speaker diarization) thời gian thực, hiển thị song ngữ đồng bộ và khử nhiễu ngữ cảnh dài.
Có thể triển khai được không? Có, dưới dạng API được lưu trữ (hosted API). Mô hình hiện đã hoạt động trên Alibaba Cloud Model Studio và QwenCloud thông qua WebSocket với tên gọi qwen3.8-livetranslate-flash-realtime.
Những thay đổi bên trong
Thông dịch đồng thời là một sự đánh đổi. Chờ đợi lâu hơn sẽ giúp mô hình có nhiều ngữ cảnh hơn. Nói sớm hơn sẽ giảm độ trễ cho người nghe. Qwen3.8-LiveTranslate xây dựng lại vòng lặp này với kiến trúc Interleave.
Chỉ số độ trễ ở đây là LAAL, hay Length-Adaptive Average Lagging (Độ trễ trung bình thích ứng theo độ dài). Chỉ số này đo lường mức độ chậm trễ trung bình của bản dịch so với bài phát biểu gốc. Nó cũng tránh việc ưu tiên các hệ thống tạo ra quá nhiều đầu ra không cần thiết. Mức giảm từ 2,8 giây xuống 2,3 giây tương đương với việc cắt giảm khoảng 18% độ trễ trung bình.
Đội ngũ QwenCloud mô tả đây là phiên bản thời gian thực của Qwen3.8-LiveTranslate-Flash. Nó được xây dựng trên nền tảng Qwen-Omni, dữ liệu đa phương thức quy mô lớn, sự căn chỉnh đa ngôn ngữ và đa phương thức, cùng khả năng tăng cường thị giác. Phiên bản Flash cũng hỗ trợ dịch âm thanh và video ngoại tuyến.
Ba khả năng mới
Hãy thử xem phần giải thích bên dưới. Nó sẽ hướng dẫn bạn qua luồng xen kẽ (interleaved stream), gắn thẻ người nói, khử nhiễu ngữ cảnh, phạm vi ngôn ngữ và chi phí phiên làm việc.
Ngôn ngữ, Đầu vào và Thị giác
Mô hình hiểu được 60 ngôn ngữ. Nó có thể nói được 29 ngôn ngữ trong số đó, trả về cả âm thanh và văn bản. 31 ngôn ngữ còn lại chỉ trả về văn bản. Đầu ra âm thanh bao gồm tiếng Trung, tiếng Anh, tiếng Ả Rập, tiếng Đức, tiếng Pháp, tiếng Tây Ban Nha, tiếng Nhật, tiếng Hàn, tiếng Hindi và các ngôn ngữ khác.
Đầu vào là âm thanh và hình ảnh tùy chọn. Đầu ra là văn bản và âm thanh. Các tín hiệu thị giác như chuyển động môi, cử chỉ và văn bản trên màn hình giúp ích trong các căn phòng ồn ào và với các từ ngữ đa nghĩa. Tài liệu khuyến nghị không nên gửi quá 2 hình ảnh mỗi giây.
Các nhóm cũng có thể thiết lập từ khóa (hotwords). Những từ này ánh xạ các thuật ngữ nguồn sang các bản dịch mục tiêu cố định. Tài liệu khuyến nghị cấu hình không quá 1.000 từ khóa.
API, Giá cả và Giới hạn
Các nhà phát triển kết nối thông qua WebSocket Realtime API với ID mô hình là qwen3.8-livetranslate-flash-realtime. Loại phát hiện lượt nói mặc định là speaker_detection. Các máy khách truyền âm thanh liên tục và nhận phản hồi do máy chủ tạo ra.
Âm thanh mặc định là 16 kHz PCM đầu vào và 24 kHz PCM đầu ra. Giọng nói mặc định là Tina. Hãy đặt session.output_modalities thành chỉ văn bản (text only), hoặc văn bản và âm thanh. Luôn gửi session.finish trước khi đóng kết nối, nếu không phân đoạn cuối cùng sẽ bị mất.
Bảng giá niêm yết tại Singapore cho mỗi 1 triệu token:
Giá tại Bắc Kinh thấp hơn, lần lượt là $5,653, $0,466, $14,133 và $22,613 USD. Đầu vào âm thanh tiêu tốn 7 token mỗi giây. Đầu ra âm thanh tiêu tốn 12,5 token mỗi giây. Một giờ phát biểu đầu vào và đầu ra tốn khoảng $1,54 tại Singapore, chưa bao gồm token văn bản và hình ảnh.
Cửa sổ ngữ cảnh là 53.248 token, với 49.152 cho đầu vào và 4.096 cho đầu ra. Giới hạn tốc độ mặc định là 10 yêu cầu và 100.000 token mỗi phút. Model Studio liệt kê các tính năng gọi hàm (function calling), đầu ra có cấu trúc, suy luận theo lô (batch inference) và tinh chỉnh (fine-tuning) là không được hỗ trợ.
Những điểm chính cần lưu ý
Hãy xem qua các Chi tiết Kỹ thuật. Mọi công lao đều thuộc về các nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit ML với hơn 150 nghìn thành viên của chúng tôi cũng như Đăng ký Bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? Bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Cần hợp tác với chúng tôi để quảng bá GitHub Repo, Trang Hugging Face, Sản phẩm mới hoặc Hội thảo trực tuyến của bạn, v.v.? Hãy kết nối với chúng tôi.
Asif Razzaq là CEO của Marktechpost AI Media Inc.. Là một doanh nhân và kỹ sư có tầm nhìn, Asif cam kết khai thác tiềm năng của Trí tuệ nhân tạo vì lợi ích xã hội. Nỗ lực gần đây nhất của ông là ra mắt Nền tảng Truyền thông Trí tuệ nhân tạo, Marktechpost, nổi bật với việc đưa tin chuyên sâu về các tin tức học máy và học sâu, vừa đảm bảo tính kỹ thuật vừa dễ hiểu đối với đông đảo khán giả. Nền tảng này tự hào với hơn 2 triệu lượt xem hàng tháng, minh chứng cho sự phổ biến của nó đối với người dùng.
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.