Sản phẩm
vLLM tích hợp tính năng đóng dấu bản quyền văn bản không mất dữ liệu bằng Gumbel-max
(giờ Việt Nam)
Tóm tắt AI
vLLM vừa bổ sung thuật toán Gumbel-max vào pipeline lấy mẫu của Model Runner v2, cho phép đóng dấu bản quyền văn bản mà không làm giảm chất lượng, đồng thời hỗ trợ giải mã suy đoán và duy trì tính đa dạng của nội dung.
Chính văn · Bản dịch AI
Nguồn gốc văn bản (text provenance) là gì và tại sao nó lại là một thách thức?
Việc xác định nguồn gốc của nội dung kỹ thuật số là yếu tố thiết yếu để xây dựng niềm tin và trách nhiệm giải trình trong thông tin mà chúng ta chia sẻ. Watermarking (đóng dấu bản quyền) cung cấp một giải pháp: nó thay đổi một tác phẩm để nhúng một thông điệp về tác phẩm đó [1], ví dụ như nguồn gốc của nó. Hình ảnh và âm thanh có thể nhúng watermark dưới dạng các nhiễu tinh vi, nhưng các kỹ thuật này không áp dụng được cho văn bản do tính chất rời rạc của nó. Thay vì cố gắng làm nhiễu chính văn bản, chúng ta tác động vào quá trình tạo văn bản theo cách có thể phát hiện được nhưng không làm thay đổi phân phối đầu ra dự kiến.
Watermarking văn bản là một thách thức cả về khoa học lẫn kỹ thuật, và có một số yêu cầu mà chúng ta phải cân bằng để có được một giải pháp thực tiễn:
Không gây biến dạng
Việc thêm watermark không được làm thay đổi phân phối đầu ra dự kiến của một mô hình [2]: nó không được ưu tiên một cách có hệ thống cho các từ ngữ, phong cách viết hoặc các giải pháp cho vấn đề nhất định.
Tính bền vững
Văn bản được tạo ra có thể bị thay đổi theo nhiều cách: rút ngắn, chỉnh sửa, trộn lẫn với các kho dữ liệu khác, hoặc thậm chí được diễn giải lại bởi một LLM khác. Một hệ thống watermarking tốt hướng tới việc bảo toàn tín hiệu nguồn gốc của nó ngay cả khi chịu những sửa đổi như vậy.
Tốc độ
Watermarking nên thêm độ trễ và chi phí bộ nhớ tối thiểu vào quá trình tạo và phát hiện. Điều này đặc biệt quan trọng trong một công cụ phục vụ có lưu lượng cao như vLLM. Sự chậm trễ phát sinh cả khi phục vụ các mô hình nhỏ, vốn nhạy cảm với những thay đổi về độ trễ lập lịch, và các mô hình có kích thước từ vựng lớn.
Phụ thuộc phát hiện tối thiểu
Việc phát hiện watermark trên văn bản nên yêu cầu càng ít thông tin càng tốt: người dùng muốn xác định nguồn gốc của một đoạn văn bản có thể không nhất thiết phải có thêm thông tin về nguồn gốc của nó, chẳng hạn như ngày tạo hoặc mô hình ngôn ngữ nào đã được sử dụng để tạo ra nó.
Những phẩm chất mong muốn này kéo theo các hướng khác nhau: một tín hiệu mạnh dễ phát hiện có thể đòi hỏi chúng ta phải thay đổi đáng kể đầu ra của mô hình, và việc tránh dựa vào thông tin bổ sung sẽ hạn chế các thuật toán mà chúng ta có thể sử dụng.
Ví dụ:
- Metadata đính kèm với tệp có thể bị xóa bỏ và chúng không tồn tại khi sao chép dữ liệu sang một tệp mới.
- Danh sách đỏ-xanh [3] và watermarking dữ liệu trực tiếp có thể dẫn đến sự biến dạng của phân phối đầu ra.
- Thay thế Unicode rất dễ bị xóa bỏ và giả mạo.
- Các kỹ thuật mô hình hóa văn bản (ví dụ: xem xét độ dài câu, các từ và biểu thức bất thường) là không đáng tin cậy.
- Tournament sampling [2] đòi hỏi nhiều vòng xử lý mà có thể khó triển khai hiệu quả mà không ảnh hưởng đến tốc độ suy luận.
Để đáp ứng các tiêu chí này, chúng ta khai thác một đặc tính tự nhiên của các thế hệ mô hình ngôn ngữ: tính ngẫu nhiên.
Khai thác tính ngẫu nhiên trong các LLM
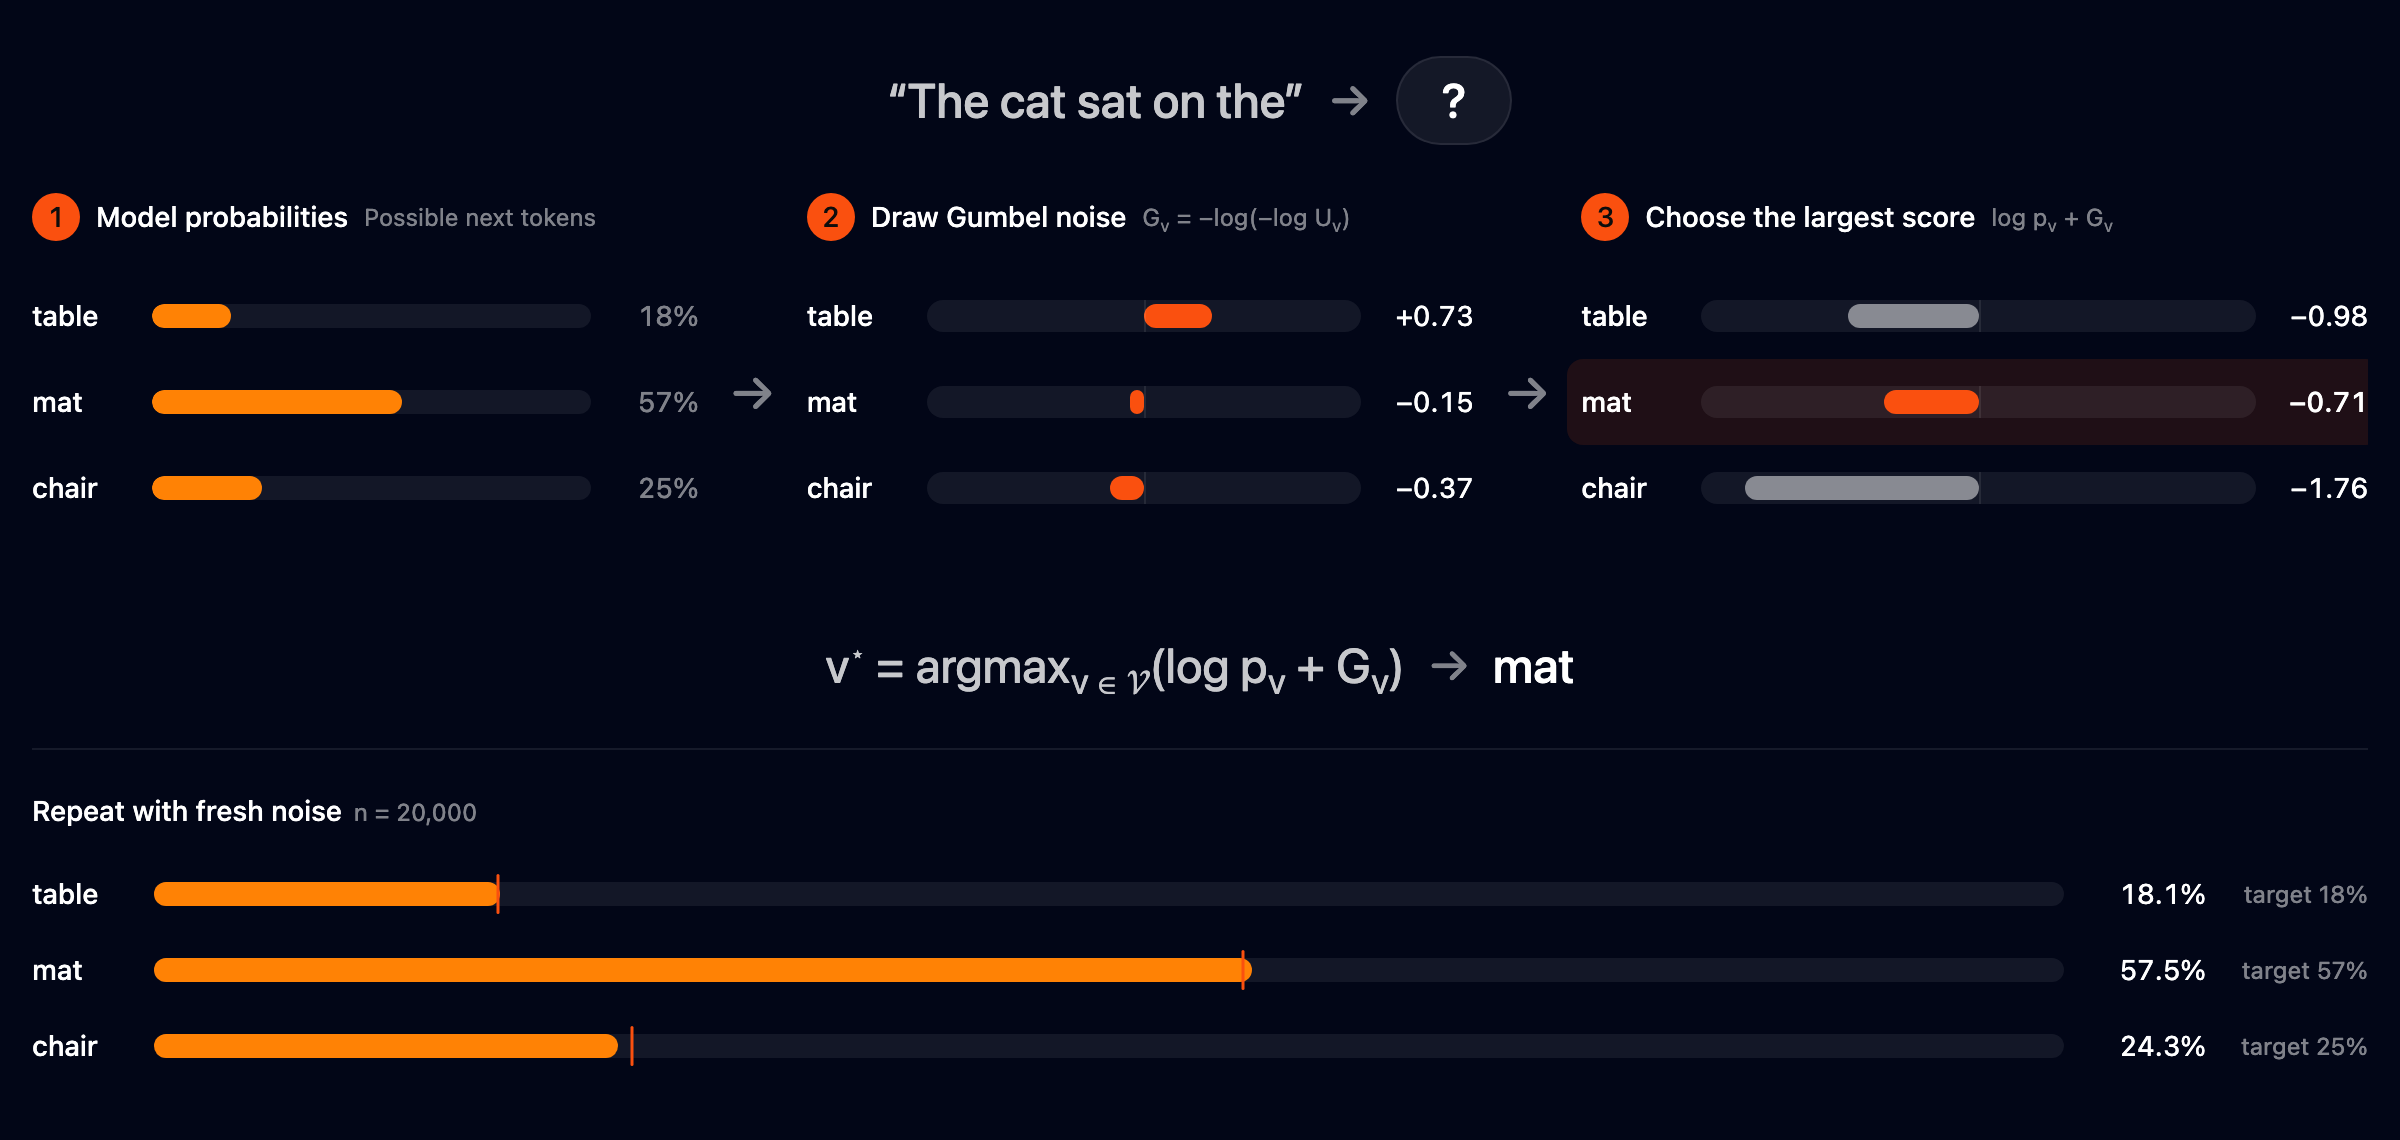
Tại mỗi bước tạo, một mô hình ngôn ngữ gán một xác suất cho mọi token tiếp theo có thể, sau đó lấy mẫu một token. Quá trình này vạch ra một con đường thông qua một cây các phần tiếp nối có thể: một số con đường này có khả năng xảy ra cao hơn những con đường khác, nhưng nhiều con đường là các đầu ra cuối cùng hợp lệ.
Lấy mẫu ngẫu nhiên thông thường rút ra và loại bỏ các giá trị ngẫu nhiên mới tại mỗi bước. Ngược lại, watermarking tạo ra các giá trị có khóa có thể tái lập từ ngữ cảnh gần đây và mỗi token ứng viên. Vì ngữ cảnh và token được chọn vẫn nằm trong đầu ra, một bộ phát hiện có khóa có thể tái tạo lại các giá trị này sau khi tạo. Văn bản có watermark sẽ căn chỉnh một cách có hệ thống với các giá trị này, tạo ra một tín hiệu tích lũy qua một chuỗi đủ dài.
Phần tiếp theo thảo luận về cách chúng ta có thể triển khai quá trình này trong khi vẫn bảo toàn phân phối lấy mẫu ban đầu của mô hình, cho phép chúng ta chọn một cách có thể tái lập một trong các đầu ra cuối cùng có thể của mô hình.
Thủ thuật Gumbel-max
Thủ thuật Gumbel-max là một kỹ thuật để lấy mẫu từ một phân phối phân loại. Giả sử mô hình gán một xác suất cho mỗi token ứng viên: đối với mỗi token, chúng ta rút các biến ngẫu nhiên đồng nhất độc lập và biến đổi chúng thành các biến ngẫu nhiên Gumbel:
Token được lấy mẫu sau đó là:
Một kết quả đáng chú ý của phép biến đổi này là:
Nói cách khác, việc thêm nhiễu Gumbel vào log-xác suất của token và lấy argmax của chúng tạo ra phân phối phân loại chính xác giống như lấy mẫu ngẫu nhiên thông thường: trên thực tế, đường dẫn lấy mẫu tiêu chuẩn của Model Runner v2 đã sử dụng quá trình này. Trong thực tế, chúng ta có thể áp dụng nhiễu Gumbel trực tiếp vào các logit, tránh việc sử dụng softmax và làm cho phép tính có khả năng song song hóa cao hơn.
Để làm cho các lần rút ngẫu nhiên này có thể tái lập, chúng ta sử dụng một hàm giả ngẫu nhiên (PRF) [4]. Một PRF ánh xạ một cách xác định một khóa và một đầu vào thành một giá trị hoạt động giống như một lần rút ngẫu nhiên đồng nhất: vì các đầu vào giống nhau luôn tạo ra đầu ra giống nhau, một bộ phát hiện có thể tái tạo lại các giá trị được sử dụng trong quá trình tạo. Chúng ta thay thế mỗi lần rút đồng nhất độc lập bằng:
trong đó là khóa watermark bí mật, và là ngữ cảnh watermark gần đây (các token cuối cùng).
Việc bao gồm ID token là quan trọng vì nó cho phép mỗi token nhận được nhiễu khác nhau, ngữ cảnh gần đây (theo mặc định, chúng ta sử dụng 4 token cuối cùng) có nghĩa là nhiễu ngẫu nhiên mà chúng ta áp dụng là khác nhau tại hầu hết mọi bước tạo, và khóa bí mật làm cho mô hình này trở nên không thể dự đoán đối với bất kỳ ai không có nó.
Bộ tạo tính toán các giá trị có khóa này cho mỗi token ứng viên, và chọn token có log-xác suất bị nhiễu lớn nhất. Với cùng một khóa và ngữ cảnh, lựa chọn này có thể được tái lập, nhưng nếu không có khóa, nó trông giống như một mẫu ngẫu nhiên thông thường.
Điều này mang lại cho phương pháp một sự đảm bảo chính xác về việc không gây biến dạng: theo kỳ vọng trên các khóa, xác suất chọn token vẫn chính xác là. Tuy nhiên, chỉ riêng điều này không đảm bảo rằng các chuỗi hoàn chỉnh sẽ không bị biến dạng. Chúng ta thảo luận thêm về hạn chế này và các giải pháp của nó trong phần “Duy trì sự đa dạng đầu ra”.
Phát hiện watermark
Tại thời điểm phát hiện, chúng ta đảo ngược quá trình được sử dụng trong quá trình tạo. Nó không yêu cầu quyền truy cập vào trọng số hoặc logit của mô hình, nhưng nó yêu cầu kiến thức về khóa bí mật và bộ tokenizer.
Người dùng sẽ cung cấp một chuỗi văn bản, với nguồn gốc không xác định, cho một bộ phát hiện. Bộ phát hiện này sẽ chuyển đổi chuỗi văn bản trở lại thành các ID token. Đối với mỗi token, bộ phát hiện sẽ sử dụng ngữ cảnh đứng trước và khóa bí mật để tính toán lại giá trị giả ngẫu nhiên của nó:
Đối với văn bản không có watermark, các token quan sát được độc lập với các giá trị có khóa của chúng, vì vậy hoạt động giống như một biến ngẫu nhiên đồng nhất. Các thế hệ có watermark thay vào đó sẽ ưu tiên các token có giá trị lớn hơn. Chúng ta biến đổi mỗi giá trị thành một điểm số cấp token:
Vì các ngữ cảnh lặp lại tái tạo các giá trị có khóa giống nhau, bộ phát hiện chỉ chấm điểm mỗi ngữ cảnh một lần. Nếu văn bản không được đóng dấu watermark, các điểm số tuân theo phân phối mũ với trung bình. Tổng của chúng,
do đó tuân theo phân phối Gamma với hình dạng và quy mô. Điều này cho phép chúng ta tính toán một p-value một phía: xác suất mà văn bản không có watermark sẽ tạo ra một điểm số lớn ít nhất bằng. Một p-value nhỏ là bằng chứng cho thấy văn bản nhất quán với watermark.
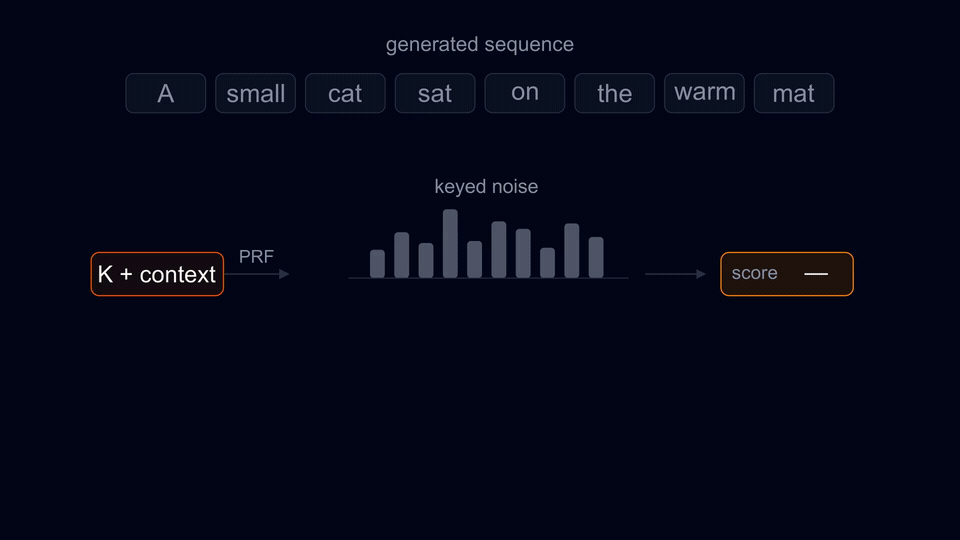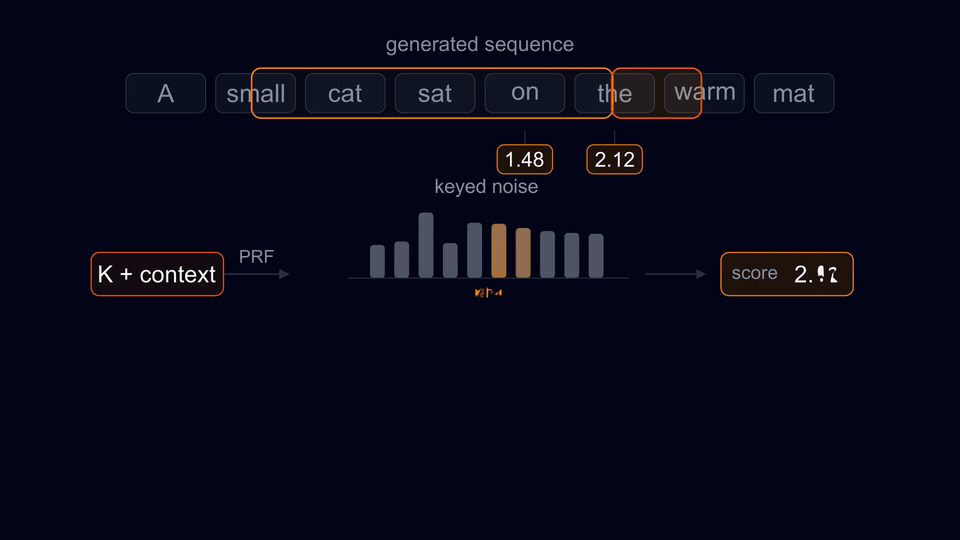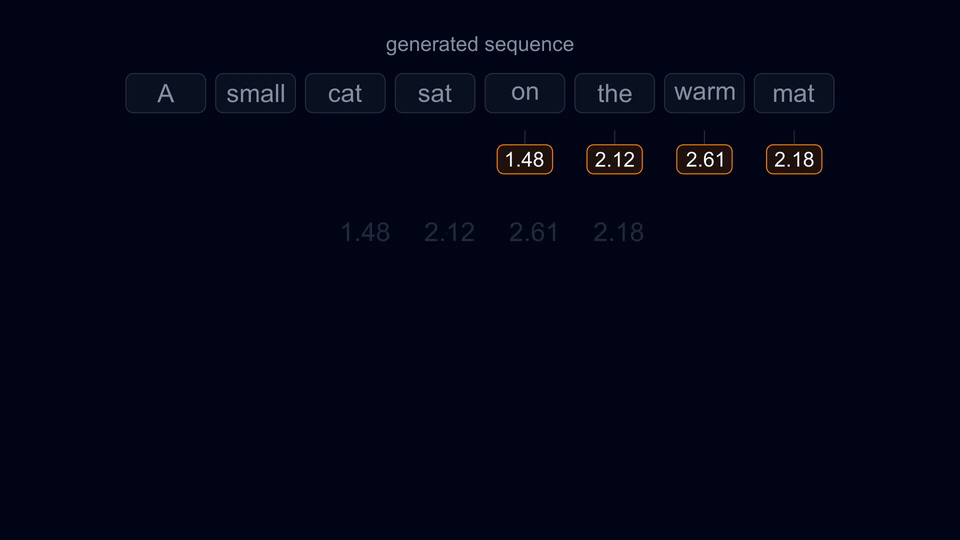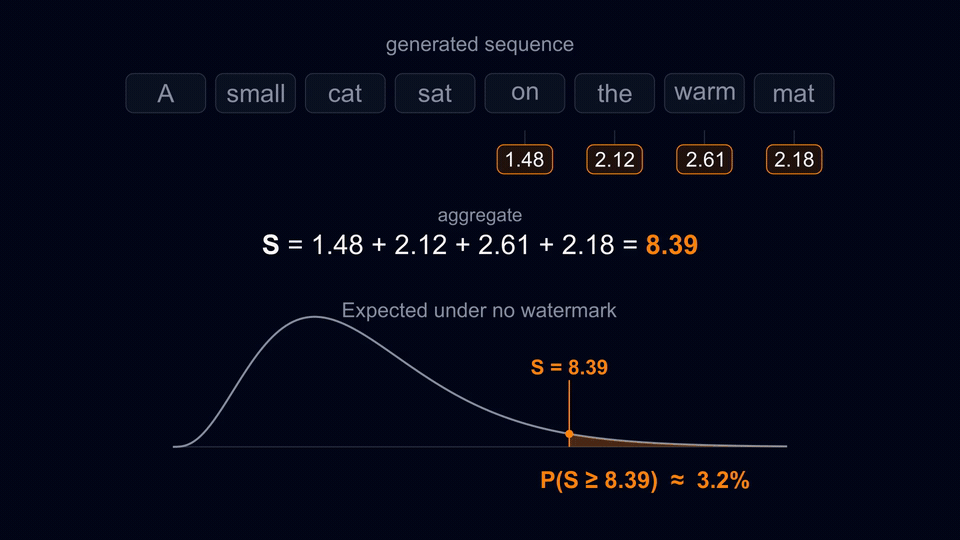
Việc chọn ngưỡng là sự đánh đổi giữa dương tính giả và âm tính giả. Đối với một bài kiểm tra đã được hiệu chuẩn, khoảng 1% các chuỗi không có watermark sẽ bị gắn cờ là dương tính. Trong thực tế, chúng ta có thể kiểm tra với nhiều khóa, bộ mã hóa (tokenizer) hoặc cấu hình watermark khác nhau. Điều này làm tăng khả năng vô tình tìm thấy điểm số cao, buộc chúng ta phải áp dụng hiệu chỉnh kiểm định đa giả thuyết (multiple-testing correction). Khi số lượng ứng viên tăng lên, ngưỡng sẽ nhỏ lại và khả năng phát hiện của chúng ta cũng giảm đi.
Khả năng phát hiện sẽ mạnh hơn khi các bằng chứng độc lập tích lũy: các đầu ra dài cung cấp nhiều token hơn để chấm điểm, và các bước có độ entropy cao tạo điều kiện cho watermark ảnh hưởng đến việc lựa chọn token. Do đó, các đầu ra ngắn hoặc dễ đoán sẽ cung cấp ít tín hiệu hơn.
Vì tín hiệu được mã hóa trực tiếp vào các lựa chọn token, việc sao chép và dán một đoạn văn bản đủ dài sẽ bảo toàn được bằng chứng của nó. Việc chỉnh sửa văn bản sẽ làm gián đoạn điểm số xung quanh các token bị sửa đổi, nhưng tín hiệu vẫn còn nguyên vẹn khi các token này không còn nằm trong ngữ cảnh gần của các token tiếp theo.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ vLLM Blog chính thức. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.