Hướng dẫn
Cách Databricks triển khai mô hình AI mới cho 14.000 nhân viên ngay ngày đầu ra mắt
(giờ Việt Nam)
Tóm tắt AI
Databricks chia sẻ quy trình nội bộ giúp toàn bộ nhân viên tiếp cận mô hình mới ngay ngày đầu thông qua Unity Gateway, đồng thời kiểm soát chi phí chặt chẽ bằng hệ thống phân tầng ngân sách và đánh giá dựa trên phản hồi thực tế.
Chính văn · Bản dịch AI
Việc cung cấp cho nhân viên quyền truy cập vào các năng lực AI tiên tiến là ưu tiên hàng đầu tại Databricks, và do đó, điều quan trọng đối với chúng tôi là họ có thể sử dụng các mô hình mới ngay khi chúng vừa ra mắt. Tuy nhiên, việc cung cấp quyền truy cập nhanh chóng cho hơn 10.000 người vào một mô hình mới không phải là điều đơn giản vì:
- Các mô hình được quảng bá là tiên tiến thường không thực sự như vậy. Ví dụ, Opus 5.0 đắt hơn và xếp hạng thấp hơn cả về điểm chất lượng định lượng lẫn định tính trong đánh giá của các kỹ sư so với Opus 4.8. Việc chuyển đổi sang một mô hình bị thụt lùi so với ngưỡng tiên tiến có thể gây hại đáng kể cho công ty thay vì mang lại lợi ích. Theo kinh nghiệm của chúng tôi, cần hết sức cẩn trọng khi đánh giá các mô hình trước khi chuyển đổi hàng loạt khối lượng công việc sang các mô hình mới.
- Việc sử dụng mô hình mới một cách thiếu chọn lọc có thể làm chi phí tăng vọt. Khi chúng tôi phát hành GPT Astra cho một nhóm kiểm soát mà không có các biện pháp giảm thiểu chi phí đi kèm, chi phí trung bình của mỗi nhà phát triển đã tăng 60% so với trước khi có quyền truy cập vào Astra. Việc chi phí tăng 60% chỉ sau một đêm với quy mô hơn 10.000 người dùng là điều rất khó để một công ty lập kế hoạch ứng phó. Khi hiểu rõ hơn về những tác vụ mà Astra thực sự vượt trội, chúng tôi đã có thể điều hướng cách sử dụng để giảm đáng kể tổng chi phí.
Bài viết này thảo luận về một loạt kỹ thuật mà chúng tôi đã áp dụng để cung cấp cho hầu hết nhân viên tại Databricks quyền truy cập "Ngày 1" vào các mô hình mới, đồng thời cho phép chúng tôi đánh giá xem liệu các mô hình đó có thực sự là những công cụ đắc lực về lâu dài hay không. Các kỹ thuật này phụ thuộc rất nhiều vào Unity Gateway để phát hành, đánh giá và tích hợp các mô hình mới một cách linh hoạt. Tuần lễ ngày 21 tháng 9 là một bài kiểm tra quan trọng đối với những khả năng này khi Opus 5, GPT-6 Sol và GPT-Luna được phát hành liên tiếp trong thời gian ngắn. Trong tuần đó, Databricks đã cung cấp cho tất cả nhân viên quyền truy cập Ngày 1, và đến ngày thứ 3, chúng tôi đã thu thập đủ dữ liệu để xác nhận rằng các mô hình này nằm trong ngưỡng hiệu quả, dẫn đến việc chúng được tích hợp vào cơ sở hạ tầng rộng lớn hơn của chúng tôi.
Vòng đời phát hành mô hình
Ở cấp độ tổng quát, các đợt phát hành mô hình mới tại Databricks đi qua một quy trình như sau:
- Ngay lập tức cung cấp các mô hình mới cho tất cả nhân viên trên cơ sở "thử nghiệm".
- Hạn chế việc sử dụng các mô hình mới dựa trên ngân sách mỗi người dùng.
- Sau khi thu thập đủ dữ liệu, quyết định xem có nên đưa mô hình vào sản xuất (hoặc thậm chí đặt làm mặc định) hay không.

Bước 1: Cung cấp các mô hình mới ngay lập tức
Để việc quản lý mô hình từ các nhà cung cấp đóng và mở trở nên dễ dàng hơn, chúng tôi tận dụng Databricks Unity Gateway của riêng mình cho mọi mục đích sử dụng nội bộ. Đây là trung tâm quản trị AI, quản lý chi phí và khả năng quan sát của chúng tôi, vì vậy việc bắt đầu từ đây là điều tự nhiên.
Gateway là nơi chúng tôi cho phép tất cả nhân viên truy cập vào mô hình mới phát hành. Tuy nhiên, cấu hình phía máy chủ là chưa đủ. Nhân viên của chúng tôi đang sử dụng Claude Code, Codex và meta-harness Omnigent trên máy tính xách tay của họ, và chúng tôi cần phân phối cấu hình mô hình mới đến họ.
Đó là lúc Unity Gateway CLI (UG CLI) phát huy tác dụng. UG CLI đã chạy trên máy tính xách tay của mọi người, được triển khai thông qua hệ thống Quản lý Thiết bị Di động của chúng tôi. Bất cứ khi nào ai đó khởi chạy Claude Code, Codex hoặc Omnigent, UG CLI sẽ chạy để kiểm tra các mô hình, công cụ và kỹ năng mới, đồng thời cập nhật cấu hình cho harness cục bộ. UG cũng cho phép chúng tôi chỉ định tập trung các mô hình mặc định so với mô hình thử nghiệm, chuẩn bị các mô hình cho định tuyến thông minh và thu thập các dấu vết (traces) để đánh giá quá trình triển khai từng mô hình.
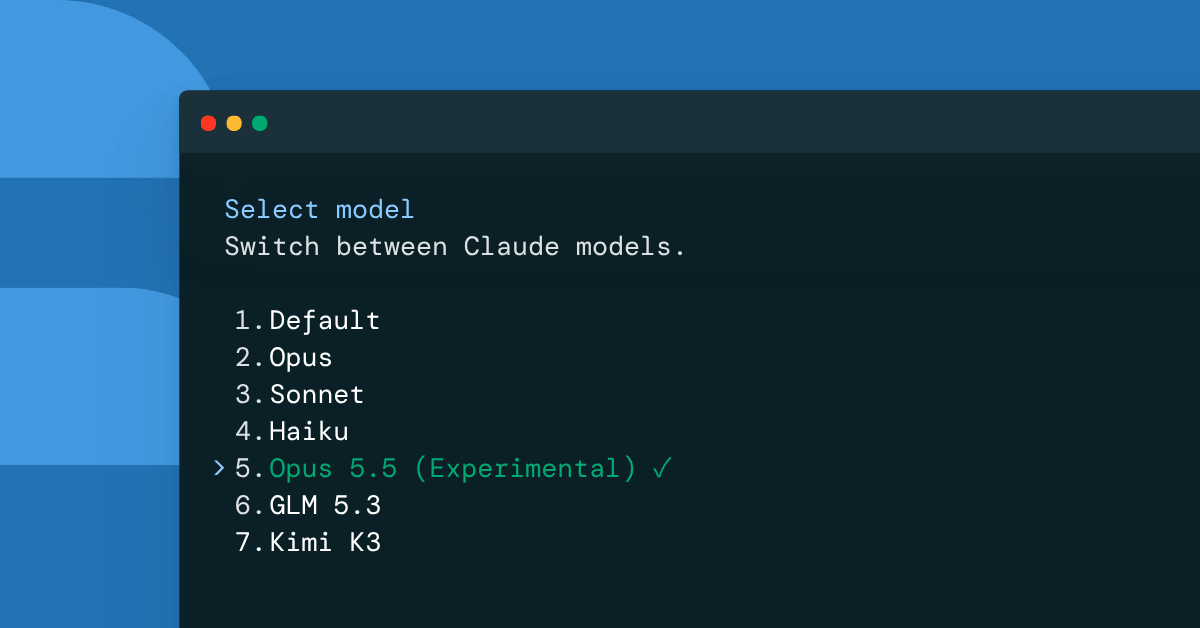
Chúng tôi đã cấu hình Unity Gateway để đẩy các cấu hình thử nghiệm cho Opus 5.5 và Sol 6. Các mô hình này hiện hiển thị với thẻ này, để nhân viên có thể chọn nhưng hiểu rằng đây là mô hình mới, có thể là tốt nhất trong phân khúc hoặc cũng có thể không tồn tại lâu dài:

Claude Code / đầu ra của mô hình chỉ định rõ Opus 5.5 là Thử nghiệm
Bước 2: Hạn chế sử dụng bằng ngân sách mỗi người dùng
Chúng tôi đã từng viết về cách cấu hình ngân sách mỗi người dùng cho chi tiêu AI. Kể từ đó, chúng tôi đã mở rộng kiến trúc ngân sách tổng thể để bao gồm bốn ngân sách chính, mỗi ngân sách được xác định trên cơ sở mỗi người dùng:
- Tối đa hàng tháng: Mỗi người dùng có một hạn mức chi tiêu hàng tháng tổng thể cho tất cả các mô hình.
- Giới hạn chạy quá mức hàng ngày: Mỗi người dùng có một mức tối đa hàng ngày, có thể được nâng lên trực tiếp trong Slack để tránh chi tiêu ngoài ý muốn từ một phiên làm việc bị mất kiểm soát.
- [Mới!] Ngân sách ngưỡng chất lượng: Chúng tôi phân bổ một phần ngân sách hàng tháng cho các mô hình cao cấp nhất nằm trong ngưỡng chất lượng, chẳng hạn như GPT Astra và Claude Fable. (Fable hiện chưa được triển khai nội bộ do các chính sách lưu giữ dữ liệu của Anthropic, nhưng chúng tôi đang phối hợp chặt chẽ để thực hiện chính sách mới của họ.) Điều này phản ánh mục đích rằng các mô hình này không nên được sử dụng làm công cụ hàng ngày, mà thay vào đó nên được chọn cho các tác vụ chuyên biệt nơi chúng thực sự phù hợp, để biện minh cho mức tăng chi phí gấp 2-3 lần so với phân khúc chất lượng tiếp theo.
- [Mới!] Ngân sách thử nghiệm: Một phần khác của ngân sách hàng tháng được phân bổ cho việc sử dụng các mô hình mới, chưa được kiểm chứng. Ở đây, chúng tôi hướng tới việc cân bằng giữa tốc độ áp dụng và rủi ro khi phổ biến rộng rãi một mô hình chưa nằm trong ngưỡng hiệu quả.
Vào ngày đầu tiên ra mắt mô hình, chúng tôi đã cung cấp Opus 5.5 và Sol 6 cho tất cả nhân viên thông qua Unity Gateway và gắn thẻ chúng cho ngân sách thử nghiệm. Sau đó, chúng tôi dành vài ngày tiếp theo để thu thập dữ liệu nhằm quyết định bước tiếp theo — bỏ thẻ thử nghiệm hoặc xóa chúng khỏi danh mục mô hình mà các nhà phát triển của chúng tôi nhìn thấy.

Tổng quan thiết lập ngân sách, phản ánh bốn loại ngân sách
Bước 3: Thúc đẩy hoặc loại bỏ mô hình
Để xác định xem mô hình có nằm trong ngưỡng hiệu quả hay không, chúng tôi dựa vào ba tín hiệu:
- Dữ liệu điểm chuẩn: Chúng tôi có một bộ điểm chuẩn riêng để kiểm tra một loạt các tác vụ, bao gồm các điểm chuẩn ngoại tuyến như lập luận tài liệu, tìm kiếm trong không gian làm việc và sản phẩm Genie của riêng chúng tôi, cũng như các điểm chuẩn trực tuyến nơi chúng tôi chạy hai mô hình song song và so sánh kết quả đầu ra cho việc tạo pull request. Chúng tôi tiếp tục mở rộng và tinh chỉnh các điểm chuẩn này; trong một thế giới lý tưởng, các điểm chuẩn của chúng tôi là đủ để nhanh chóng xác định chi phí và chất lượng của bất kỳ mô hình mới nào được phát hành.
- Chất lượng do người dùng báo cáo: Việc phát hành mô hình thử nghiệm cung cấp vô số dữ liệu thực tế về cảm nhận của mọi người đối với mô hình mới. Chúng tôi nhận thấy rằng một nhóm người dùng chuyên nghiệp rất háo hức thử nghiệm các mô hình mới và so sánh trải nghiệm của họ qua Slack và các phản hồi khảo sát.
- Theo dõi chi phí qua các dấu vết OpenTelemetry: Unity Gateway ghi lại tất cả các dấu vết tại một vị trí trung tâm, cùng với thông tin chi phí. Chúng tôi có thể so sánh cách người dùng thử nghiệm chi tiêu cho thế hệ mô hình trước so với các mô hình mới nhất trên cơ sở mỗi phiên. Điều này không nhất thiết cho chúng tôi biết về chất lượng, nhưng nó cung cấp một thước đo tốt về chi phí.
Đối với Opus 5.5 và Sol 6, cả ba số liệu đều cho chúng tôi một câu chuyện khá nhất quán.
Các điểm chuẩn, chẳng hạn như OfficeQA Pro V2 của chúng tôi, cho thấy Opus 5.5 rõ ràng nằm trong ngưỡng chi phí/chất lượng, một bước tiến lớn trên cả hai trục so với Opus 5. GPT-6 Sol đạt điểm số nằm ở giữa GPT-5.6 Sol và GPT-5.6 Terra về cả chi phí và chất lượng.

Các báo cáo từ người dùng nhìn chung đều đồng tình rằng đối với các tác vụ kỹ thuật và gỡ lỗi (phần lớn những người dùng sớm của chúng tôi là kỹ sư), Opus 5.5 là một bước tiến lớn về chất lượng so với Opus 5 và Opus 4.8, đồng thời phong cách viết của nó cũng được ưa chuộng hơn hẳn. Trong khi đó, GPT-6 Sol đôi khi lại cho thấy sự sụt giảm về chất lượng so với GPT-5.6 Sol.
Việc theo dõi chi phí cho phép chúng tôi so sánh mức sử dụng của nhóm người dùng sớm với chính nhóm đó vào một tuần trước. Việc duy trì cùng một nhóm đối tượng là rất quan trọng vì những người dùng sớm thường là những người sử dụng AI chuyên sâu thay vì người dùng phổ thông.
Chúng tôi muốn chuẩn hóa chi phí theo cơ sở $/phiên, vì những người dùng đang thử nghiệm mô hình mới đôi khi sẽ tăng tần suất sử dụng theo số lượng phiên khi họ thử nghiệm. Chúng tôi nhận thấy rằng việc sử dụng so sánh $/phiên cơ bản vẫn gây hiểu lầm vì sự phân bổ các phiên cũng thay đổi: những người dùng sớm đang thử giải quyết các vấn đề khó hơn với các mô hình mới so với phiên làm việc trung bình của họ.
Kết quả là, chúng tôi đã phân tầng các phiên dựa trên việc chúng là đơn lượt hay đa lượt và liệu chúng có thực hiện bất kỳ chỉnh sửa tệp nào hay không, sau đó điều chỉnh lại trọng số phân bổ cho phù hợp. Bảng dưới đây hiển thị kết quả so sánh giữa Opus 5.5 với Opus 4.8 và GPT-6 Sol với GPT-5.6 Sol.
| So sánh chi phí | Mô hình cũ (trung bình $/phiên) | Mô hình mới (trung bình $/phiên) | Chênh lệch |
| Opus 4.8 so với Opus 5.5 | $5.94/phiên (Opus 4.8) | $4.23 (Opus 5.5) | −29% |
| GPT-5.6 Sol so với GPT-6 Sol | $4.52/phiên (GPT-5.6 Sol) | $2.34/phiên (GPT-6 Sol) | −48% |
Các con số của GPT không quá bất ngờ khi xét đến việc giá đã giảm 50%. Nhưng chúng tôi rất hài lòng khi Opus 5.5 cũng mang lại mức giảm giá đáng kể cho các khối lượng công việc thực tế của chúng tôi, dựa trên kinh nghiệm trước đây với Opus 5.
Những gì chúng tôi đã quyết định
Chúng tôi đã có thể cung cấp cho nhân viên quyền truy cập thử nghiệm vào Opus 5, GPT-6 Sol và Luna ngay trong ngày đầu tiên ra mắt mô hình. Trong vòng ba ngày, chúng tôi đã thu thập đủ dữ liệu để xác nhận rằng các mô hình này nằm trên biên hiệu quả và quyết định chuyển chúng từ ngân sách thử nghiệm sang lưu hành tiêu chuẩn dưới dạng các mô hình khả dụng rộng rãi.
Trong tuần tới, chúng tôi sẽ tiến thêm một bước đối với Opus 5.5 để biến nó thành mặc định cho Claude Code, nhờ vị thế rõ ràng là chất lượng cao hơn và chi phí thấp hơn so với các phiên bản tiền nhiệm.
Trải nghiệm của chúng tôi với GPT-6 Sol cho thấy nó sẽ không thay thế GPT-5.6 Sol làm mặc định cho Codex. Tuy nhiên, chúng tôi sẽ đưa GPT-6 Sol vào bộ công cụ định tuyến thông minh của mình, nhờ lợi thế về chi phí so với 5.6 Sol.
Nhìn chung, chúng tôi nhận thấy phương pháp này hiệu quả trong việc đánh giá nhanh chất lượng và chi phí của mô hình, cho phép chúng tôi nhanh chóng áp dụng các mô hình mới nhất chứng minh được giá trị của chúng. Sự linh hoạt này quan trọng hơn bao giờ hết khi các mô hình mới xuất hiện gần như hàng ngày.
Bài viết được AI dịch và tổng hợp tự động từ Databricks: Blog. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.