Hướng dẫn
Dùng GPT-6 và Opus 5.5 để truy vết kiến thức giả kim thuật và giải mã thư từ thế kỷ 17
(giờ Việt Nam)
Tóm tắt AI
Nhà nghiên cứu lịch sử khoa học benbreen đã ứng dụng GPT-6 và Opus 5.5 để phân tích hơn 5.000 tài liệu gốc từ kho lưu trữ Samuel Hartlib, mở ra hướng đi mới trong nghiên cứu lịch sử.
Chính văn · Bản dịch AI
Tôi đã từng viết về những cạm bẫy và trường hợp sử dụng của AI trong việc tăng cường nghiên cứu lịch sử, nhưng mọi thứ đã thay đổi đáng kể từ giai đoạn 2024-25. Nhân dịp sự kiện ra mắt đối đầu giữa GPT-6 Sol và Opus 5.5 trong tuần này, tôi nghĩ mình sẽ chia sẻ một vài kết quả ban đầu khi sử dụng các mô hình này không chỉ để thực hiện các chức năng kiểu "trợ lý nghiên cứu" như phiên âm tài liệu, mà còn để thực sự giải quyết các vấn đề lịch sử hiện có.
Tóm tắt ngắn gọn là theo quan điểm của tôi, việc kết hợp các nhà sử học làm việc theo nhóm cộng tác với các mô hình tiên tiến hiện nay sẽ tạo ra nhiều bước tiến trong kiến thức và diễn giải lịch sử. Tôi đoán rằng nhiều bước tiến trong số đó có thể trở nên khá ý nghĩa. Điều này đã không xảy ra ngay cả vào năm ngoái. Tôi nghĩ các phòng thí nghiệm AI, các nhà nghiên cứu lịch sử và các cơ quan tài trợ nên bắt đầu tích cực theo đuổi những sự hợp tác này.
Như chúng ta đã thấy với lĩnh vực toán học, các mô hình này hoạt động tốt nhất khi chúng có một tập hợp các vấn đề mà các LLM thường mô tả là "có thể giải quyết được". Nói cách khác:
• Các chuyên gia trong lĩnh vực đã xác định được một nhóm vấn đề cần giải quyết chưa?
• Dữ liệu cần thiết để trả lời các vấn đề này đã được số hóa hoàn toàn và có thể truy cập được chưa?
• Các vấn đề đó có phù hợp với những khả năng "vượt trội" của các mô hình AI tiên tiến hay không — cụ thể là khả năng suy luận đa ngôn ngữ, toán học nâng cao và/hoặc khả năng thực hiện nghiên cứu tự chủ thông qua các tập dữ liệu lớn hoặc trên các tiểu lĩnh vực chuyên môn?
• Chúng có dễ dàng áp dụng các giải pháp liên quan đến việc viết mã tùy chỉnh không?
• Quan trọng nhất: một giải pháp tiềm năng có thể được chứng minh hoặc bác bỏ rõ ràng không? (Điểm cuối cùng này, đối với tôi, dường như là một phần lý do tại sao các mô hình suy luận đã phát triển mạnh mẽ trong toán học nhưng lại không như vậy trong các lĩnh vực nhân văn).
Những yếu tố trên có nghĩa là các loại "vấn đề mở" lịch sử mà AI tiên tiến có thể hỗ trợ một cách hợp lý là khá hạn chế:
- Bất cứ điều gì liên quan đến mật mã và phá mã (Ví dụ: xem Astra giải mã thông tin liên lạc của quân đội Đức năm 1941 và mật mã vô tuyến của Đức trong Thế chiến I, hoặc công việc mà Daniel Bourdeau đang thực hiện tại đây, hoặc nỗ lực của chính tôi khi sử dụng GPT-6 Astra để tìm hiểu chuyện gì đang xảy ra với cuốn sách ma thuật được mã hóa của nhà huyền học thời Elizabeth John Dee, Liber Loagaeth).
- Truy vết các văn bản qua các bản dịch và chuyển thể. Ví dụ về điều này, tôi đã có thể sử dụng GPT-6 Astra để xác định danh tính của một đoạn văn mà Isaac Newton đã dịch tự do sang tiếng Latin từ một văn bản giả kim thuật tiếng Pháp, một sự xác định dường như chưa từng được thực hiện trước đây.
- Thiết lập mối liên hệ giữa các phát hiện hiện có chỉ được báo cáo trong các tiểu lĩnh vực riêng biệt hoặc chuyên biệt, hoặc chưa được tích hợp vào học thuật.
Điểm cuối cùng này có thể trở thành phương pháp mới có tác động mạnh mẽ nhất mà các công cụ này mở ra cho các nhà nghiên cứu lịch sử. Ví dụ, nếu bạn đọc bài viết về việc Astra phá mã một thông điệp Enigma ngày 10 tháng 7 năm 1941 vốn trước đó không thể giải mã, thì hóa ra bước đột phá chính không liên quan gì đến bản thân việc phá mã, mà là việc nhận thấy toàn bộ phạm vi thông tin có sẵn. Nhà nghiên cứu mật mã lịch sử Frode Weierud viết:
Chúng tôi vẫn đang phân tích các bản ghi GPT–6 Astra để xem chính xác cách nó thực hiện việc phá mã. Và chúng tôi đang khám phá ra những chi tiết đáng kinh ngạc. Vào tháng 7 năm 2026, tôi đã đưa ra thông báo sau trên trang web có Danh sách Thông điệp 1941: Lưu ý: Vào tháng 7 năm 2026, nghiên cứu tại Bundesarchiv của Đức đã tiết lộ một số bộ sưu tập thông điệp vô tuyến, cả được mã hóa và văn bản thuần túy. Một trong những bộ sưu tập thông điệp này đến từ bộ chỉ huy hậu cần của Sư đoàn SS-Totenkopf, Nachschubführer. Nhiều thông điệp trong số này được gửi đến trạm vô tuyến Ib (Quartiermeister) và giống hệt với những thông điệp trong danh sách này. Những thông điệp khác là mới, nhưng rất có thể có liên quan. Những thông điệp mới này được thêm vào Danh sách Thông điệp 1941 bằng chữ in đậm, với chỉ báo NF (Nachschubführer) sau số thông điệp, cho biết các số thông điệp này thuộc hệ thống đánh số NF. Tất cả các thông điệp NF đều là thông điệp gửi đi; do đó, các số thông điệp có màu xanh lam. Có vẻ như GPT–6 Astra đã phát hiện ra ghi chú này về các bộ sưu tập thông điệp vô tuyến tại Bundesarchiv của Đức.
Điều hấp dẫn về ghi chú này là ngay cả những chuyên gia con người hàng đầu cũng không hoàn toàn hiểu được GPT-6 Astra đã làm gì khi nó tập hợp các mẩu thông tin này lại và sử dụng chúng để tìm ra giải pháp. Weierud viết:
Các tham chiếu tệp mà GPT–6 Astra đề cập, RS 3–3/20a và RS 3–3/63b, là chính xác, nhưng chúng không có sẵn trên trang web Crypto Cellar Research. GPT–6 Astra đề cập đến một bộ sưu tập tư nhân, nhưng không rõ đây là gì, liệu nó đã truy cập thành công vào các bộ sưu tập đã số hóa của Bundesarchiv hay nó đã tìm thấy các tệp này ở nơi khác.
Phảng phất bóng dáng của sự cố Hugging Face ở đây: các mô hình này cực kỳ quyết tâm khi được đưa cho một vấn đề mà chúng cho là có thể giải quyết được. Chúng sẽ đẩy việc tìm kiếm các giải pháp tiềm năng đi xa nhất có thể, thường theo những cách mà các chuyên gia con người khó có thể truy vết.
Tôi đã đề cập ở trên rằng tôi đã thử sử dụng GPT-6 Astra để "giải mã" bản thảo được mã hóa của John Dee, Liber Loagaeth. Dee là một trong những nhân vật lịch sử yêu thích nhất của tôi, và nếu bạn chưa nghe nói về ông ấy, tôi khuyên bạn nên xem trang Wikipedia của ông — câu chuyện về ông vô cùng hấp dẫn và kỳ lạ. Trong số những điều khác, Dee được cho là đã ảnh hưởng đến cả cách Shakespeare khắc họa phù thủy Prospero trong vở The Tempest và cách Christopher Marlowe khắc họa Faust, kẻ giao kèo với quỷ trong Doctor Faustus.
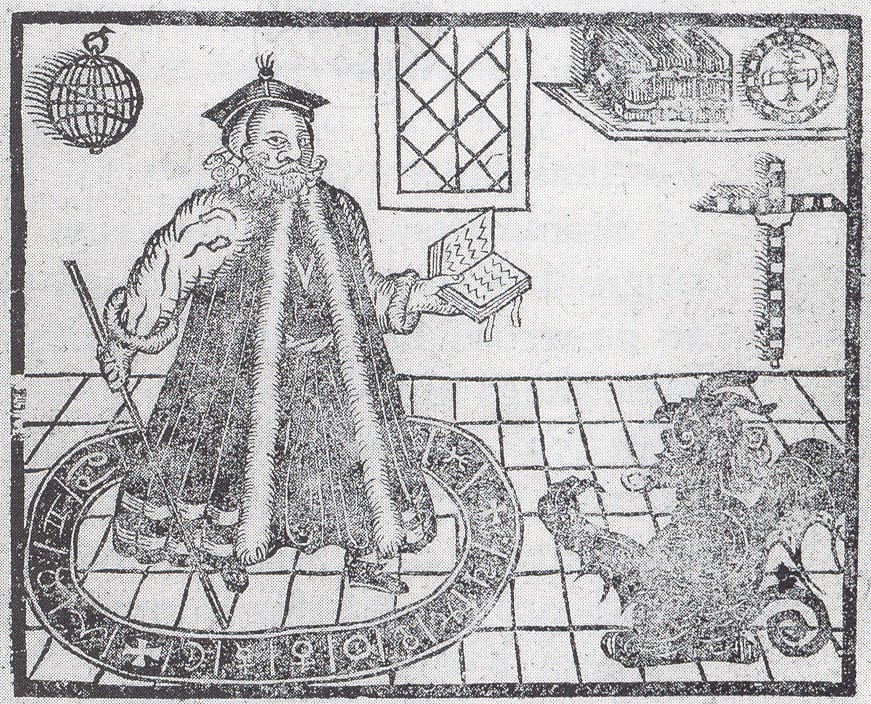
Một trong những phần kỳ lạ nhất của một cuộc đời rất kỳ lạ là công việc của Dee với "nhà tiên tri" Edward Kelley để phiên âm cái mà ông gọi là "cuốn sách bí ẩn" được viết bằng "ngôn ngữ thiên thần" (Dee tin rằng Kelley thực chất là một nhà tiên tri đang nhận các tác phẩm mới về mặc khải thần thánh được viết bằng mật mã). Bạn có thể đọc bản phiên âm đầy đủ của cuốn sách này tại đây.
Phán quyết của Astra, điều mà tôi nghĩ là hợp lý vì Kelley rõ ràng là một kẻ lừa đảo, là cuốn sách được cho là đã mã hóa đó hoàn toàn không có mật mã nào cả: nó gần như hoàn toàn là các âm tiết vô nghĩa. Nó đã tạo ra một báo cáo về các phát hiện của mình tại đây.
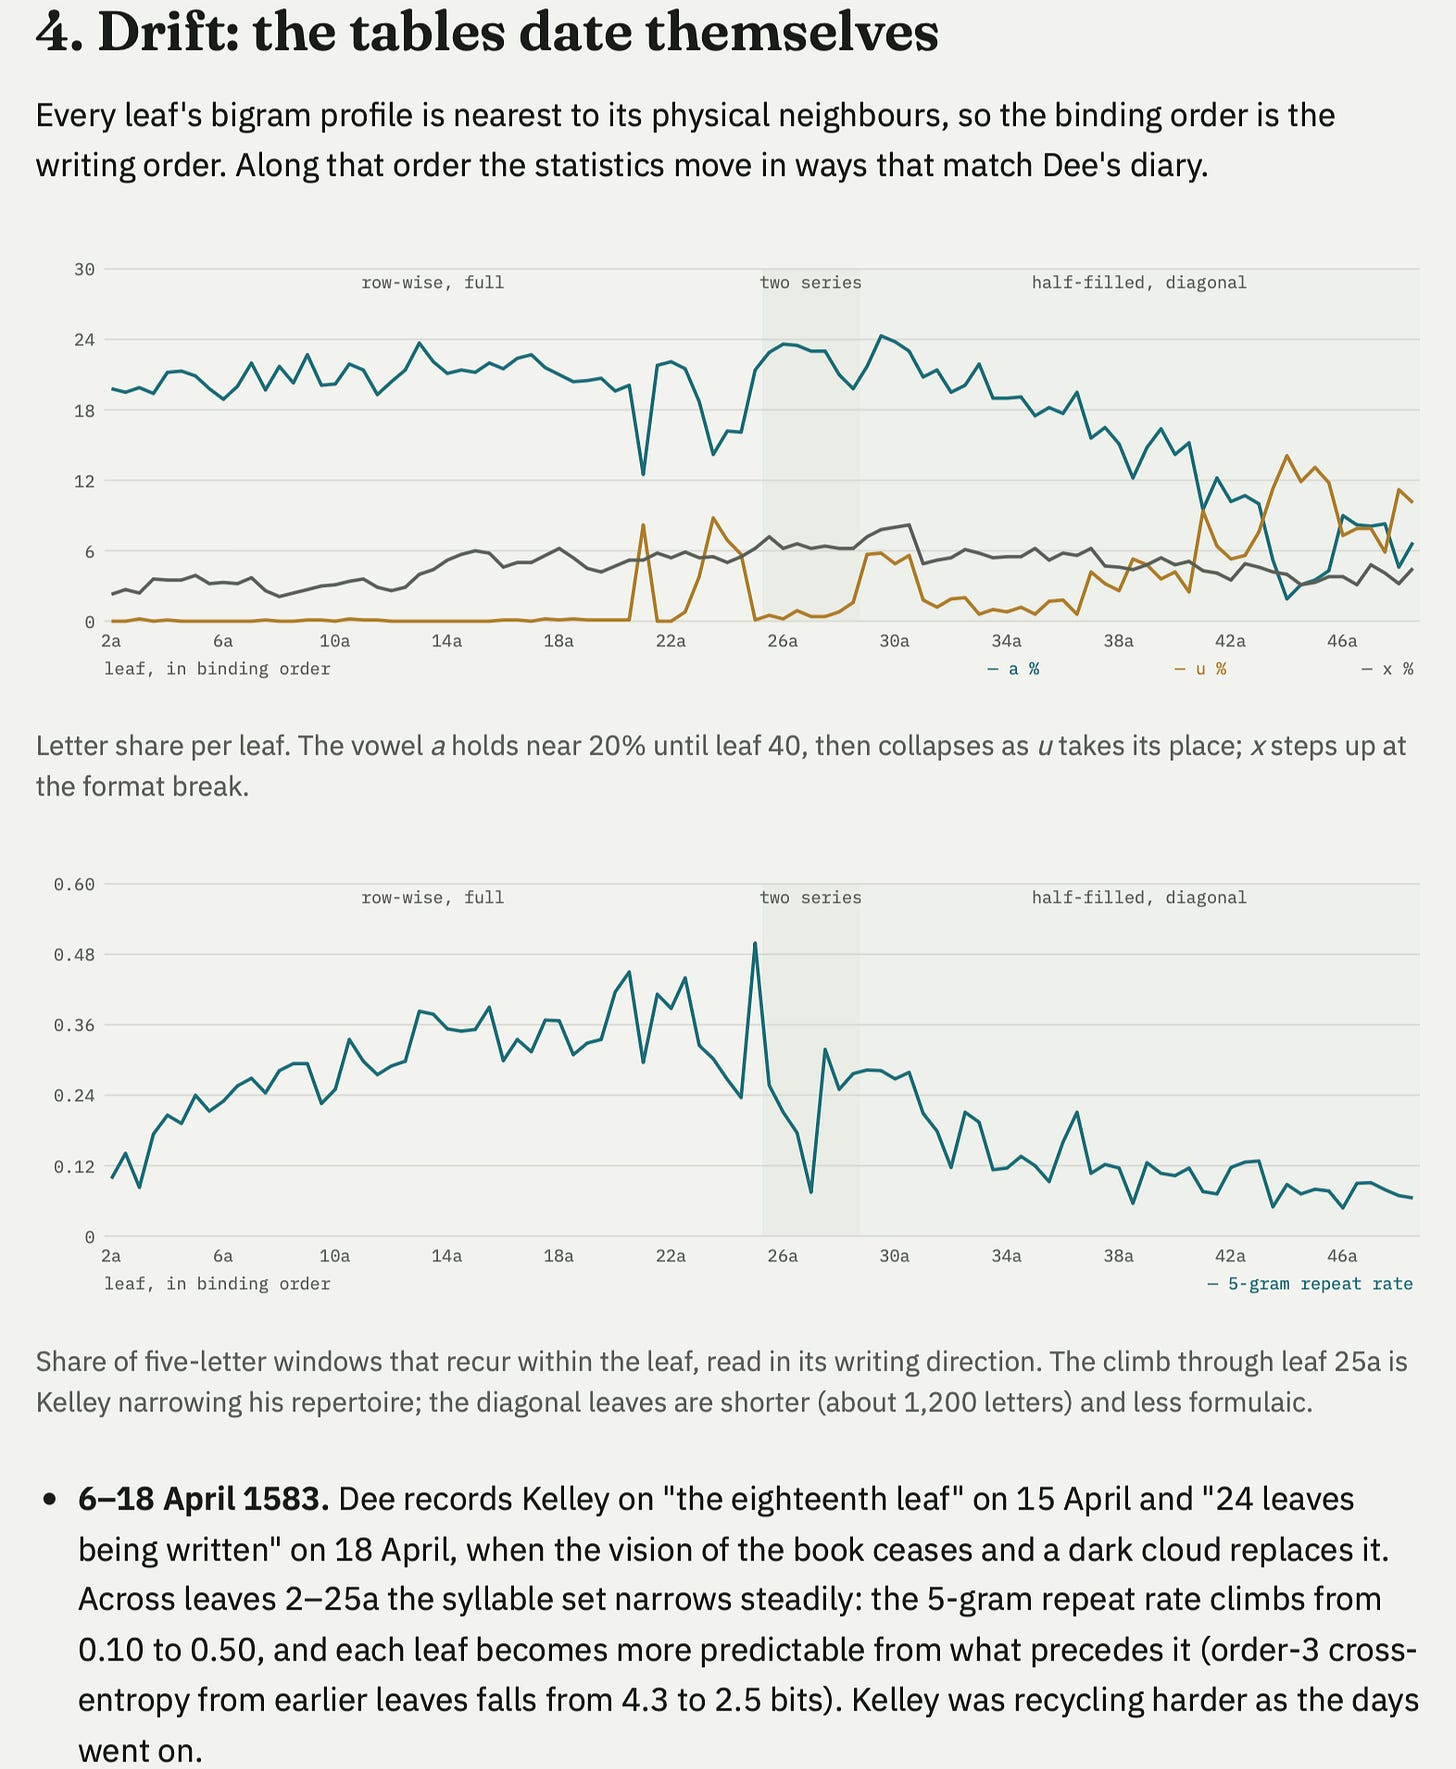
Tuy nhiên, phân tích của mô hình đã mang lại một vài điều thú vị. Ví dụ, nó có thể đối chiếu phân tích toán học của mình về tần suất lặp lại của các ký tự trong văn bản với bằng chứng từ nhật ký của John Dee. Nó kết luận rằng Kelley bắt đầu trở nên lười biếng hơn sau một ngày cụ thể và bắt đầu lặp lại chính mình nhiều hơn:
Astra cũng có thể xác định rằng một đoạn văn của thứ ngôn ngữ vô nghĩa này thực sự có chứa ý nghĩa: một tham chiếu đến Bornogo, một trong những thực thể thiên thần trong cái mà chúng ta có thể gọi là "vũ trụ điện ảnh John Dee" của thần thoại hư cấu.
Đây có phải là một bước đột phá có ý nghĩa trong các nghiên cứu về John Dee không? Không. Và cũng cần thừa nhận rằng ngay cả một bước đột phá thực sự trong một tiểu lĩnh vực lịch sử chuyên biệt như thế này cũng còn lâu mới tương đương với việc giải được phương trình Navier-Stokes.
Tuy nhiên, tôi cho rằng đây là một dấu hiệu thực sự cho thấy kiến thức lịch sử chuyên sâu khi kết hợp với các mô hình tiên phong (frontier models) và khả năng tính toán mạnh mẽ có thể mang lại những kết quả bất ngờ.
Ban đầu, tôi đã thử thách Astra và Opus 5.5 tìm kiếm thêm các thông điệp mã hóa từ thời Thế chiến I và Thế chiến II để giải mã, nhưng có vẻ như những mục tiêu dễ dàng đã bị khai thác hết — chúng không tìm thấy gì (mặc dù rất thú vị khi thấy cách chúng rà soát qua các danh sách quân nhân Đức để tìm ra những cái tên hợp lý cần kiểm chứng).
Tôi bắt đầu đạt được kết quả tốt hơn khi chuyển sang lĩnh vực chuyên môn của mình là lịch sử khoa học và y học. Khi tôi viết những dòng này, GPT-6 đang xử lý các tài liệu của Charles Darwin và tìm kiếm các tham chiếu của ông về nơi ông thu thập thông tin liên quan đến chọn lọc tự nhiên; ý tưởng là tìm ra những mắt xích chưa được khám phá trong chuỗi tri thức giữa Darwin và những người cung cấp thông tin cho ông. Thú vị thay, đây là một ý tưởng mà chính GPT-6 đã đề xuất. Tuy nhiên, nó thực sự phù hợp với trực giác chuyên môn của tôi về những gì cấu thành nên một dự án nghiên cứu xứng tầm (nằm đâu đó giữa một bài báo nghiên cứu và một luận án tiến sĩ, xét về tiềm năng mang lại kết quả). Trước đây, các mô hình AI khiến tôi cảm thấy thiếu khả năng tự hình thành các dự án nghiên cứu lịch sử đáng giá ở quy mô này — chúng hữu ích hơn cho việc, ví dụ như, tạo các hình ảnh trực quan hóa dữ liệu.
Đây là một ví dụ về các bước suy luận của mô hình khi nó cân nhắc xem có nên tiếp tục nghiên cứu một tham chiếu về thanh quản của chuột túi trong một trong những cuốn sổ tay của Darwin hay không!
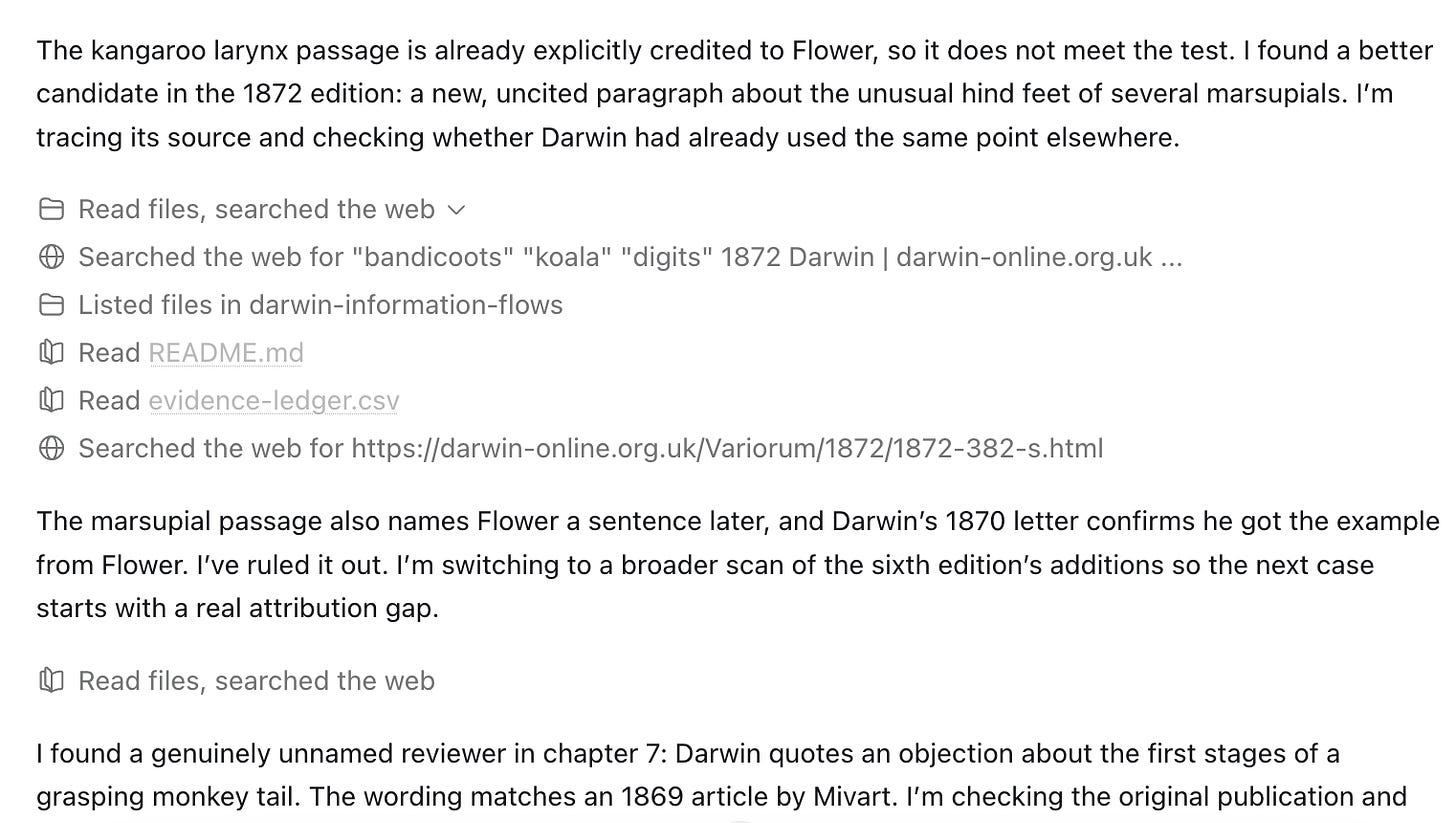
Dự án này hiện vẫn đang trong quá trình thực hiện và chưa mang lại kết quả nào đáng kể để công bố, nhưng tôi nghĩ đây là một ví dụ điển hình về cách công việc kiên trì, hợp tác của các nhà nghiên cứu lịch sử và chuyên gia lưu trữ — cụ thể là đội ngũ đứng sau Dự án Thư từ Darwin tuyệt vời — có thể đóng vai trò là nền tảng cho các phương pháp nghiên cứu mới nổi. Chắc chắn rằng con người có thể và đã từng truy vết các tham chiếu đến những nhân vật được nêu tên trong các ghi chú và thư từ của Darwin, nhưng bản chất đa ngôn ngữ của các mô hình ngôn ngữ khiến tôi nghi ngờ rằng chúng sẽ có thể tìm ra những liên kết mới ở đây, đặc biệt là trong các kho dữ liệu khổng lồ vượt quá khả năng đọc hiểu toàn bộ của bất kỳ cá nhân nào.
Một ứng cử viên tuyệt vời khác: các tài liệu của Samuel Hartlib, người tự mô tả mình là một "nhà tình báo", một thành viên có ảnh hưởng thời kỳ đầu của Hội Hoàng gia và là một nút thắt quan trọng trong mạng lưới khoa học thời kỳ cận đại. Những tài liệu này đã được số hóa hoàn toàn, được rút ra từ các nguồn bằng nhiều ngôn ngữ và bao trùm nhiều lĩnh vực học thuật cũng như các ngách trí tuệ khác nhau. Tất cả những điều đó có nghĩa là chúng đặc biệt dễ xử lý đối với một mô hình tiên phong.
Opus 5.5 bắt đầu công việc bằng cách tải xuống hơn 5.000 tệp nguồn sơ cấp từ kho lưu trữ của Hartlib, sau đó tạo ra các tác nhân phụ để rà soát qua Google Books và các trang lưu trữ khác nhằm đối chiếu chéo các nguồn thông tin chưa xác định của Hartlib bằng các ngôn ngữ khác nhau. Mục tiêu là tìm ra những thời điểm Hartlib nhận được thông tin khoa học quan trọng từ một nguồn ẩn danh hoặc chưa xác định, và sau đó khám phá ra danh tính đó.
Opus thực sự vẫn đang làm việc này khi tôi viết những dòng này, nhưng một báo cáo sơ bộ đã được viết tại đây. Theo quan điểm của tôi, những phát hiện hàng đầu là có thật và đầy ý nghĩa. Không hề gây chấn động, nhưng đó là kiểu công việc mà tôi có thể tưởng tượng mình sẽ dành một tuần để nghiên cứu.
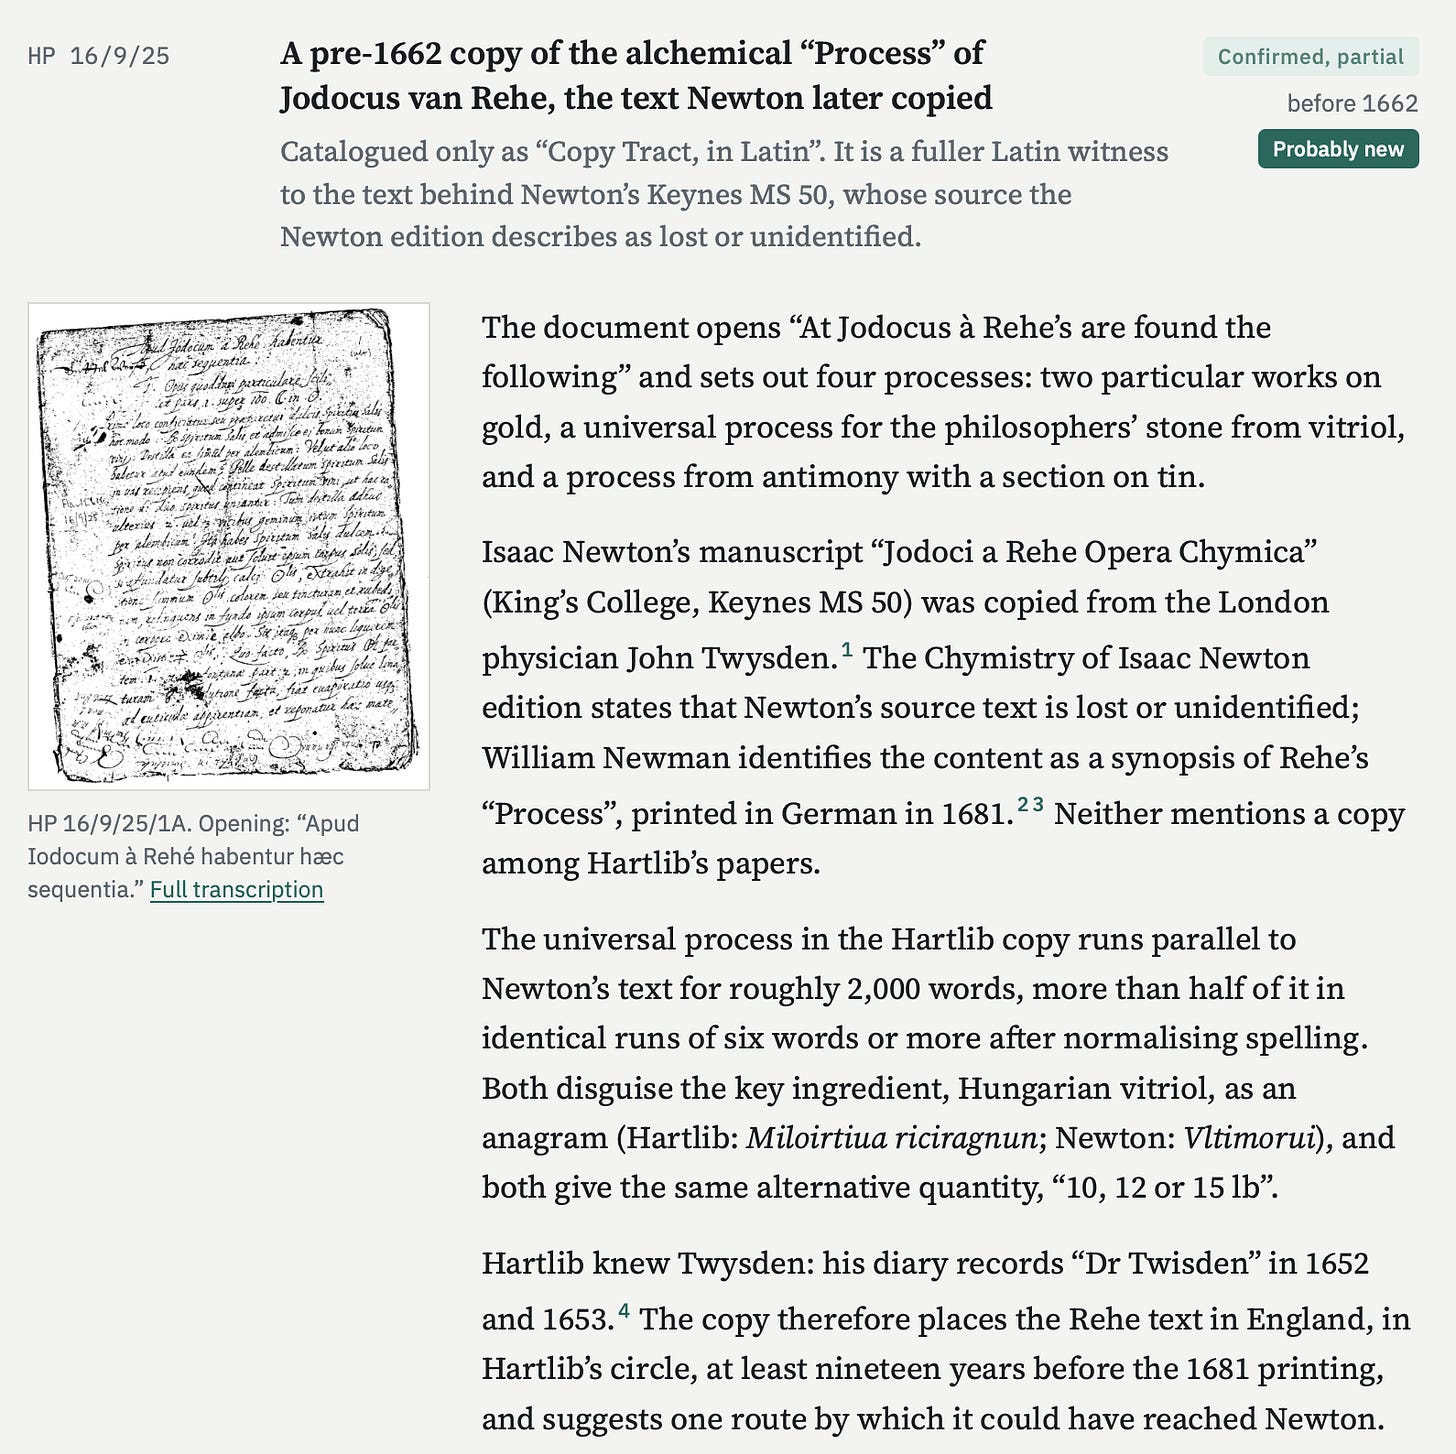
Bạn có chú ý đến đoạn về phép đảo chữ không? Đây là lúc khả năng suy luận/toán học của các mô hình này trở nên hữu ích: Opus 5.5 nhận thấy rằng cả Newton và Hartlib đều sử dụng các phép đảo chữ/mã khác nhau cho thành phần chính, đó là vitriol Hungary (Hungarian vitriol). Loại ngôn ngữ mã hóa này rất phổ biến trong thuật giả kim thời cận đại, nhưng tôi chắc chắn sẽ không bao giờ nhận ra điều đó. Opus giải thích:
Của Newton là một phép đảo chữ thực sự. “Vltimorui” sử dụng chính xác các chữ cái của vitriolum (v-i-t-r-i-o-l-u-m), được sắp xếp lại. Các biên tập viên của ấn bản Newton đã xác định nó theo cách đó. Của Hartlib thì gần giống với cách viết ngược hơn, và ngay cả điều đó cũng không hoàn hảo. Đảo ngược từng từ của Miloirtiua riciragnun theo từng chữ cái và bạn sẽ có: Miloirtiua → auitriolim, gần với uitriolum (= vitriolum) riciragnun → nungaricir, gần với ungaricum.
Điều này đối với tôi có vẻ hơi khiên cưỡng, nhưng nó đã làm rõ hơn mọi thứ bằng cách chia sẻ chú thích lề cụ thể vốn đã được viết để làm rõ điều này cho độc giả thế kỷ 17:
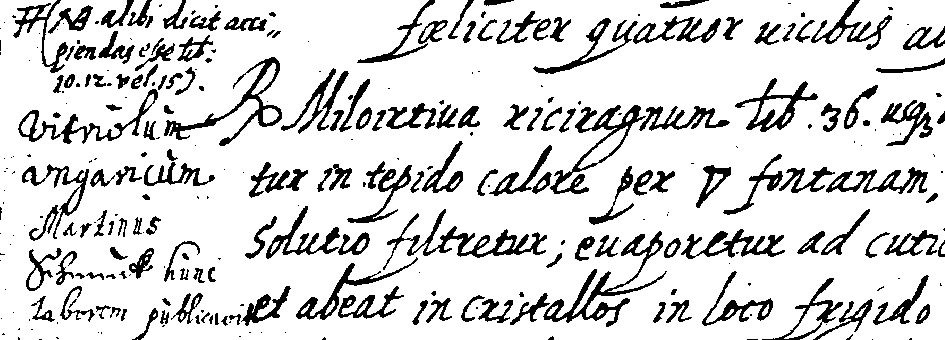
Vì vậy, những gì Opus xác định ở đây không chỉ là phép đảo chữ cho một thành phần giả kim quan trọng, mà quan trọng hơn là sự tương đồng giữa việc cả Newton và Hartlib đều sử dụng các phép đảo chữ cho nó. Điều này, cùng với việc cả hai cùng mô tả các định lượng giống nhau và các điểm tương đồng khác trong các văn bản, đối với tôi dường như là bằng chứng rất thuyết phục rằng bản thảo của Hartlib chính là tài liệu mà Newton đã tham khảo.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ Hacker News Nổi bật (buzzing.cc bản dịch tiếng Trung). Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.