Mô hình
Legacy-Bench của Factory gia nhập chỉ số SII của Fireworks: Đâu là mô hình AI xử lý mã nguồn cũ tốt nhất?
(giờ Việt Nam)
Tóm tắt AI
Legacy-Bench đã được tích hợp vào Specialized Intelligence Index (SII) của Fireworks để đánh giá khả năng của các mô hình AI trong việc xử lý, gỡ lỗi và chuyển đổi các ngôn ngữ lập trình cũ như COBOL, Java 7, BASIC, C89, Fortran và Assembly.
Chính văn · Bản dịch AI
24 tháng 9, 2026 - Đọc trong 2 phút
Đối tác
Chia sẻ
Factory Team | 24 tháng 9, 2026
Hôm nay, Legacy-Bench của Factory đã gia nhập Specialized Intelligence Index (SII) của Fireworks, mang kỹ thuật phần mềm kế thừa vào bộ sưu tập ngày càng tăng các tiêu chuẩn đánh giá do ngành xây dựng, nhằm so sánh các mô hình AI mở, đóng và chuyên biệt trên các tác vụ thực tế.
Legacy-Bench đo lường khả năng của các mô hình tiên tiến trong việc gỡ lỗi, triển khai và di chuyển phần mềm được viết bằng COBOL, Java 7, BASIC, C89, Fortran và Assembly. Việc đưa tiêu chuẩn này vào SII giúp các nhà lãnh đạo kỹ thuật có cách đánh giá rõ ràng hơn về việc mô hình nào có thể hoạt động đáng tin cậy trên các hệ thống nền tảng của thanh toán tài chính, bảng lương, bảo hiểm, viễn thông và tính toán khoa học.
Các kết quả mới nhất củng cố một điểm mà chúng tôi đã thấy trong suốt quá trình nghiên cứu của mình: hiệu suất trên các tiêu chuẩn đánh giá lập trình tổng quát không chuyển đổi đồng đều sang các hệ thống kế thừa.
Các tiêu chuẩn đánh giá phải phản ánh quy trình làm việc của người dùng
Sự tiến bộ của mô hình có một ranh giới không đồng đều. Một mô hình có thể hoạt động tốt trên các kho lưu trữ Python hiện đại nhưng lại gặp khó khăn với COBOL. Nó có thể giải quyết một vấn đề trên GitHub nhưng lại thất bại trong việc duy trì bản ghi có độ rộng cố định hoặc tính toán số thập phân đóng gói. Những khác biệt này rất quan trọng vì các hệ thống kế thừa không có nhiều chỗ cho kết quả có vẻ hợp lý nhưng lại không chính xác. Một chương trình có thể biên dịch, chạy và trông có vẻ đúng trong khi lại làm thay đổi một phép tính thanh toán hoặc làm hỏng một bản ghi hạ nguồn chỉ bằng một byte duy nhất. Trong khi các tiêu chuẩn đánh giá lập trình tổng quát hiếm khi kiểm tra các điều kiện này, Legacy-Bench được xây dựng để làm cho chúng có thể đo lường được.
Phần mềm kế thừa là một vấn đề đánh giá khác biệt
Legacy-Bench chứa các tác vụ gỡ lỗi, triển khai và di chuyển trên sáu họ ngôn ngữ kế thừa. Các tác vụ này đại diện cho quy trình làm việc trong thanh toán tài chính, bảng lương, bảo hiểm, viễn thông và tính toán khoa học. Độ khó vượt xa cú pháp không quen thuộc. Các mô hình phải làm việc với:
- Các mã hóa và bố cục nhị phân chính xác
- Các bản ghi có độ rộng cố định và các trường số thập phân đóng gói
- Các quy tắc kinh doanh được nhúng trực tiếp vào mã
- Các định dạng đầu ra mà chỉ cần một byte sai lệch cũng có thể làm hỏng giao diện
- Các môi trường cung cấp phản hồi hạn chế
Mười tác vụ tiêu biểu hiện có sẵn trên GitHub ở định dạng Harbor. Toàn bộ tiêu chuẩn đánh giá được sử dụng để thực hiện việc đánh giá.
Các mô hình tiên tiến không hoạt động đồng đều khi được giao nhiệm vụ với phần mềm kế thừa
Ảnh chụp nhanh đánh giá mới nhất được chuẩn bị cho Specialized Intelligence Index đã tạo ra các kết quả sau
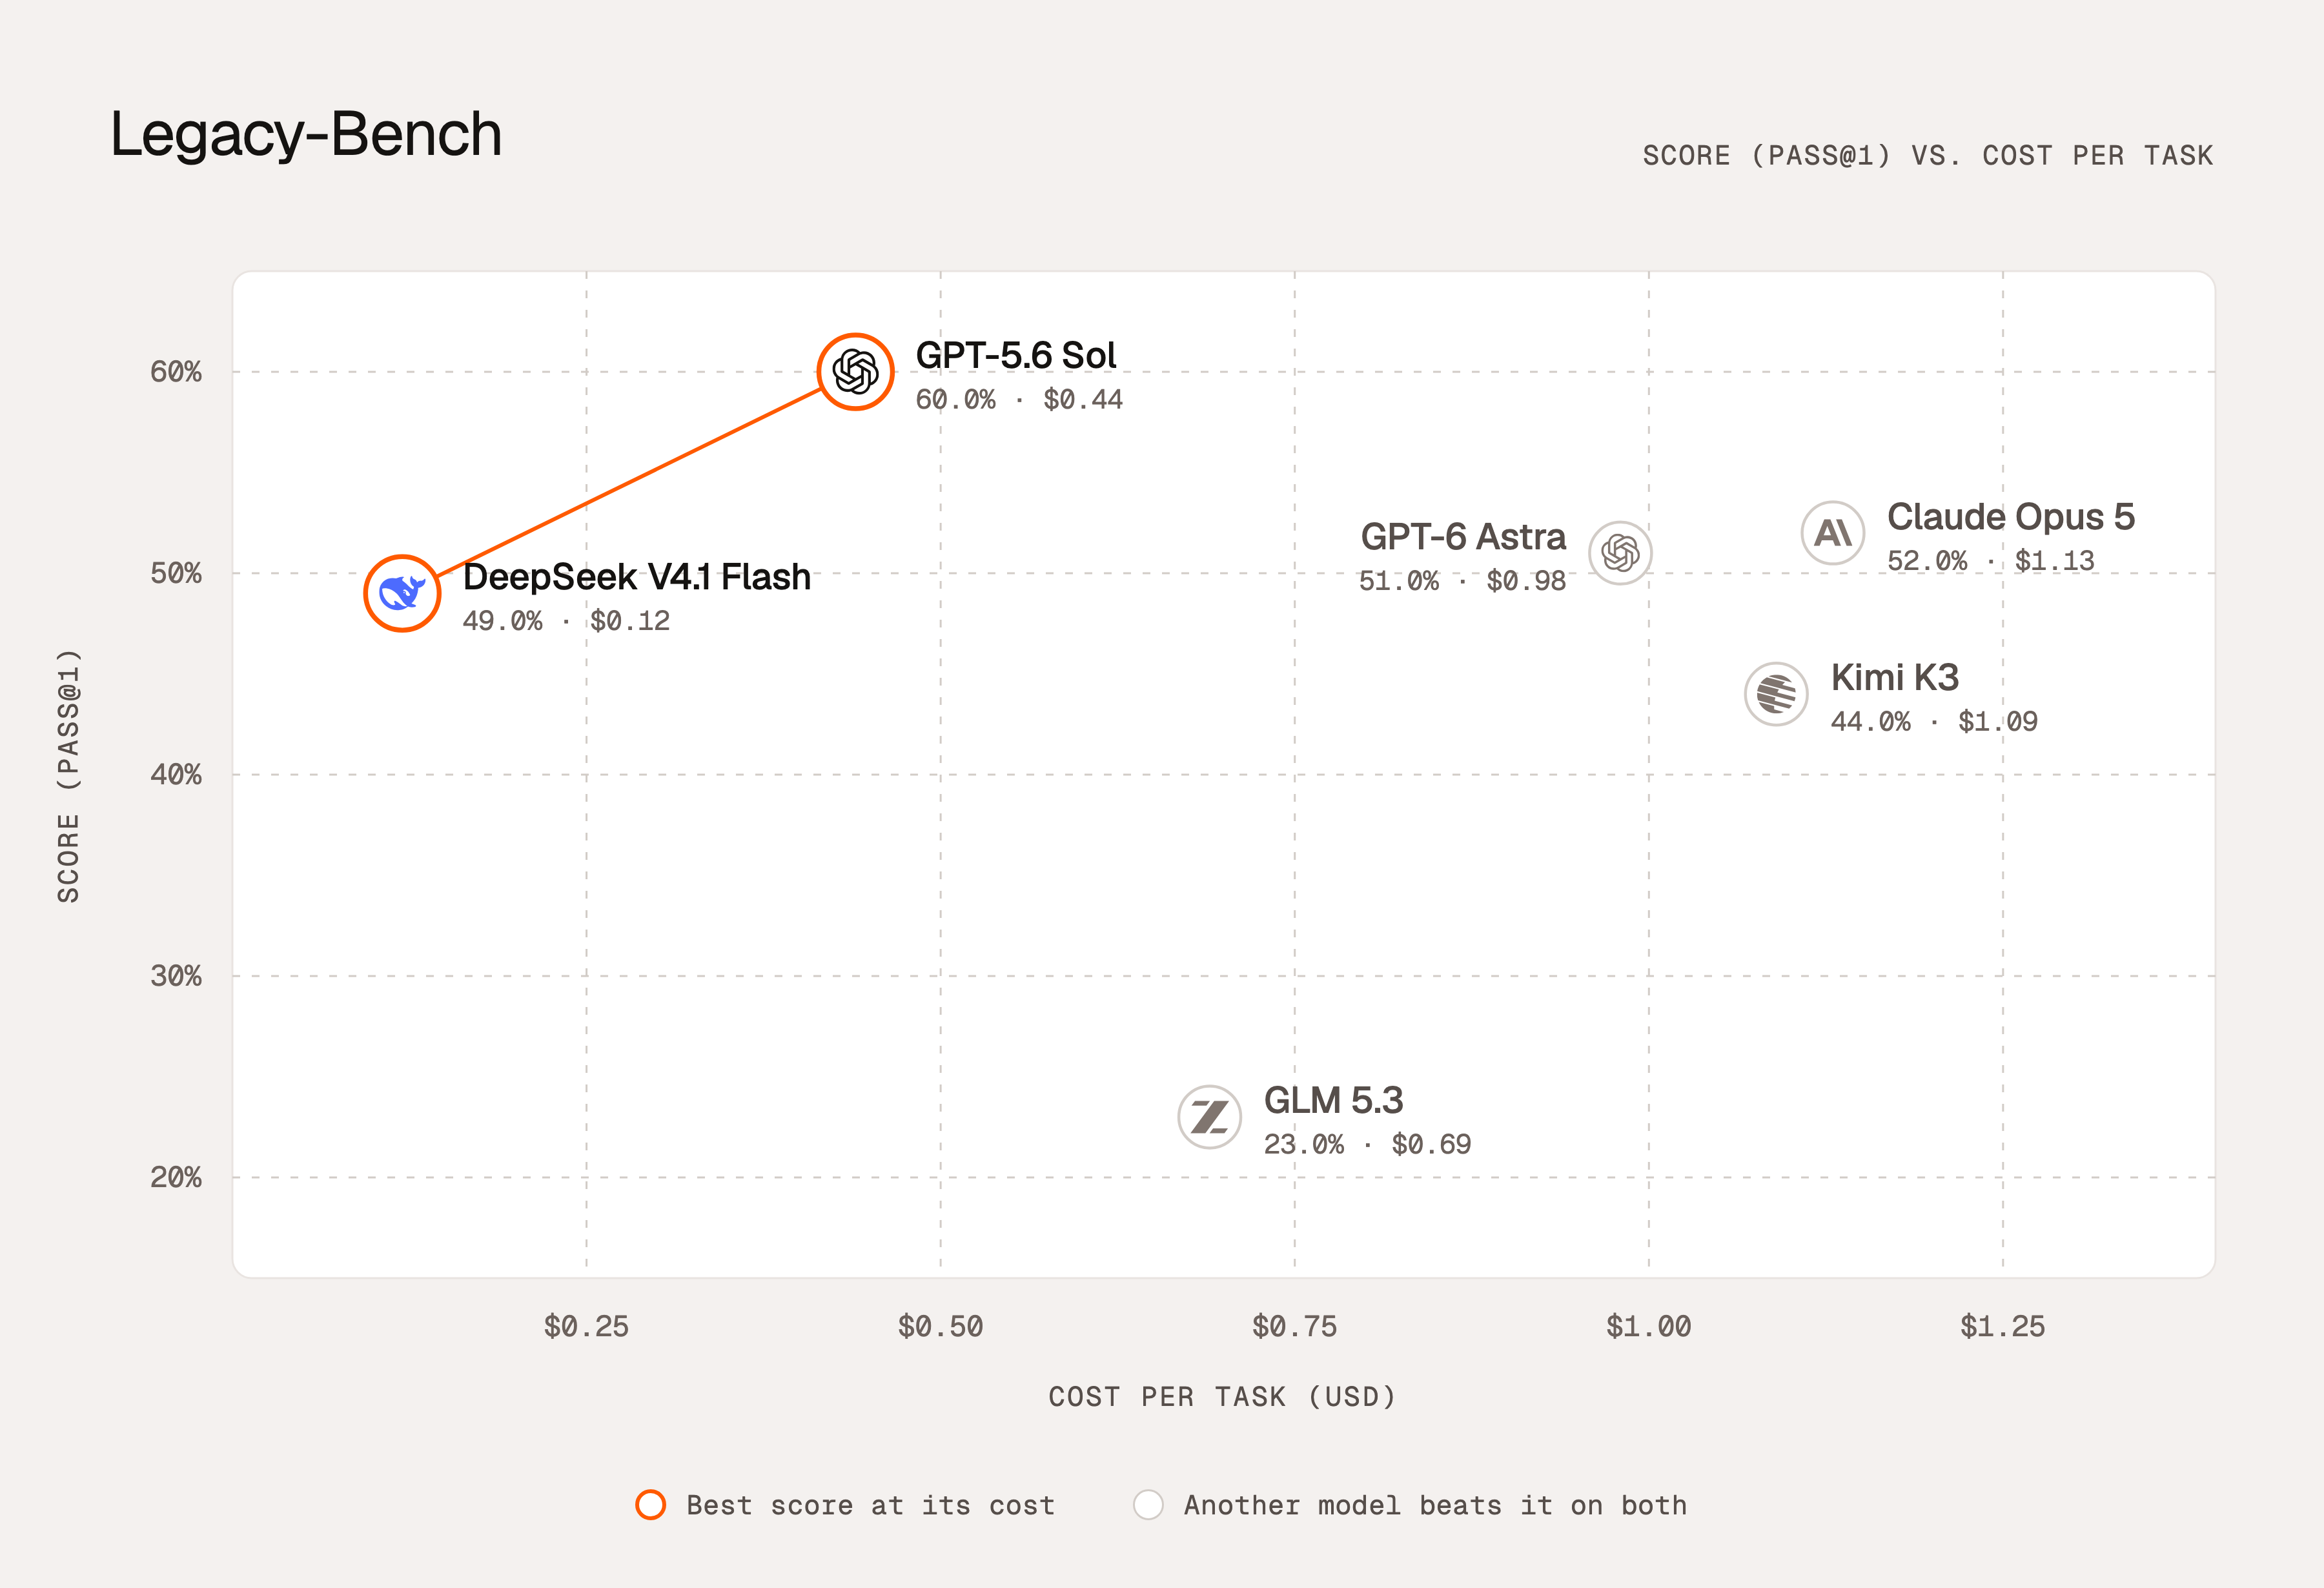
| Mô hình | Điểm số | Chi phí | Thời lượng |
|---|---|---|---|
| GPT-5.6 Sol | 60.0% | $0.44 | 2 phút 43 giây |
| Claude Opus 5 | 52.0% | $1.13 | 5 phút 37 giây |
| GPT-6 Astra | 51.0% | $0.98 | 3 phút 33 giây |
| DeepSeek V4.1 Flash | 49.0% | $0.12 | 5 phút 43 giây |
| Kimi K3 | 44.0% | $1.09 | 8 phút 49 giây |
| GLM 5.3 | 23.0% | $0.69 | 15 phút 09 giây |
GPT-5.6 Sol dẫn trước GPT-6 Astra chín điểm phần trăm trong đánh giá này. Những kết quả này phản ánh quan điểm rằng sự tiến bộ của mô hình tổng quát không chuyển đổi đồng đều sang công việc kỹ thuật kế thừa. Các phát hiện từ tiêu chuẩn đánh giá cho thấy khoảng cách đó có thể xuất hiện như thế nào. Các ngôn ngữ kế thừa ít được đại diện trong quá trình đào tạo mô hình. Các lỗi im lặng khiến tác nhân không có lý do để xem xét lại một câu trả lời có vẻ hợp lý. Các tác vụ yêu cầu đầu ra chính xác sẽ trừng phạt một byte sai lệch duy nhất như một thất bại hoàn toàn. Không có điểm yếu nào trong số đó được nắm bắt tốt bởi các tiêu chuẩn đánh giá lập trình hiện đại toàn diện, đòi hỏi các tiêu chuẩn đánh giá chuyên biệt để hỗ trợ.
Trong một đường dẫn Java 7, một bài kiểm tra thất bại đã tạo ra một ngoại lệ mà mô hình có thể sử dụng để chẩn đoán và sửa lỗi công việc của mình. Trong một tác vụ bảng lương COBOL, chương trình đã biên dịch và vượt qua 24 trong số 29 bài kiểm tra, nhưng lại tính toán khoản khấu trừ y tế là 275 đô la thay vì 125 đô la. Đầu ra trông có vẻ hợp lý và mô hình đã báo cáo thành công.
Các môi trường kế thừa đòi hỏi sự xác minh mạnh mẽ hơn chính xác tại nơi chúng cung cấp phản hồi yếu hơn.
Các tiêu chuẩn đánh giá chuyên biệt là rất quan trọng để thúc đẩy ranh giới công nghệ
Specialized Intelligence Index được tạo ra để so sánh các mô hình mở, đóng và chuyên biệt trên các công việc đặc thù theo lĩnh vực do các chuyên gia thiết kế. Chỉ số này cung cấp cho các tổ chức bằng chứng dựa trên các quy trình làm việc mà họ cần tự động hóa, thay vì chỉ là một bảng xếp hạng mục đích chung duy nhất.
Bằng cách đóng góp kết quả của Legacy-Bench, Factory đang đưa kỹ thuật phần mềm kế thừa vào lớp đánh giá chung đó. Sự hợp tác này giúp các nhà lãnh đạo kỹ thuật đánh giá mô hình nào đã sẵn sàng cho quy trình làm việc của họ.
Các tiêu chuẩn đánh giá nên phản ánh công việc mà người dùng cần hoàn thành. Đối với nhiều tổ chức lớn nhất thế giới, các trường hợp sử dụng chính đòi hỏi phải sử dụng các công nghệ đang hoàn thiện mà các tiêu chuẩn đánh giá lập trình tác nhân khác không đo lường trực tiếp.
Bạn muốn tự mình thử nghiệm tiêu chuẩn đánh giá này? Hãy liên hệ với [email protected].
Bài viết được AI dịch và tổng hợp tự động từ Factory Nghiên cứu / Sản phẩm. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.