Sản phẩm
Chạy mô hình quyết định mã nguồn mở SemIf-OpenJev trực tiếp trong Databricks SQL
(giờ Việt Nam)
Tóm tắt AI
Databricks giới thiệu quy trình ba bước đơn giản để triển khai mô hình SemIf-OpenJev thông qua ai_query, cho phép phân tích dữ liệu và dự đoán xác suất ngay trong môi trường SQL bằng sức mạnh của Serverless GPU.
Chính văn · Bản dịch AI
Sử dụng GPU serverless và ai_query để áp dụng các quyết định có cấu trúc trực tiếp lên dữ liệu được quản trị.
bởi Cyrus Cowley, Tejas Sundaresan, Hanlin Tang, Anshul Gupta và Julia Powell
Cuối tuần qua, các mô hình quyết định "System One" như Jev đã ra mắt, đây là một nhóm các mô hình nền tảng đang phát triển có khả năng đưa ra các quyết định được hiệu chỉnh tốt từ một tập hợp các tùy chọn rời rạc. Các mô hình này thường cực kỳ nhanh và chi phí thấp, cho phép ứng dụng rộng rãi trên dữ liệu lớn. Các trường hợp sử dụng tiềm năng bao gồm từ việc phân tích bản ghi hỗ trợ khách hàng, đến việc áp dụng các quyết định phức tạp trên quy mô lớn cho dữ liệu của bạn.
Cộng đồng mã nguồn mở cũng đã tích cực ra mắt các phiên bản trọng số mở (open weight) của các mô hình quyết định này, từ Smelf-open-jev, đến Laya, cho đến Kev. Nhưng sức mạnh của các mô hình này chỉ được khai phá khi chúng có thể tiếp cận lượng dữ liệu lớn. Hôm nay, chúng tôi rất vui mừng được chia sẻ cách bạn có thể phục vụ các mô hình quyết định trọng số mở trên Databricks và chạy chúng trực tiếp trên dữ liệu được quản trị của mình. Bạn thậm chí có thể truy cập các mô hình này trực tiếp từ bảng điều khiển SQL hoặc các tác vụ sản xuất trong Lakeflow thông qua ai_query. Hơn nữa, các sản phẩm như AI Runtime cho phép bạn tùy chỉnh hoặc huấn luyện bổ sung (post-train) các mô hình này để phù hợp với bối cảnh doanh nghiệp cụ thể của bạn.
Trong bài viết này, chúng tôi sẽ chỉ cho bạn cách sử dụng một mô hình như vậy, SemIf-OpenJev, trực tiếp trong Databricks để phân loại các đánh giá khách sạn là tốt hay xấu.
Từ notebook đến endpoint
Chúng tôi đã đóng gói quy trình làm việc vào một Databricks Notebook có thể nhập.
Bắt đầu chỉ với ba bước:
- Chọn tên/lược đồ mô hình
- Chọn Serverless GPU
- Nhấp vào Chạy tất cả (Run All)
Notebook sử dụng Databricks AI Runtime để cung cấp tài nguyên tính toán GPU serverless theo yêu cầu mà không yêu cầu bạn phải thiết lập hoặc quản lý cơ sở hạ tầng GPU.
Từ đó, nó sẽ:
- Tải xuống các tệp mô hình SemIf-OpenJev.
- Ghi nhật ký và đăng ký mô hình bằng Express Deployments.
- Tự động tạo một endpoint phục vụ mô hình GPU.
Tại thời điểm đó, bạn đã có bộ phân loại mã nguồn mở chạy phía sau một endpoint được quản lý mà bạn có thể gọi từ các ứng dụng — hoặc trực tiếp từ SQL.
Gọi mô hình từ SQL bằng ai_query
Một phần hữu ích của thiết lập này là endpoint không cần phải hiển thị giao diện chat-completions tiêu chuẩn.
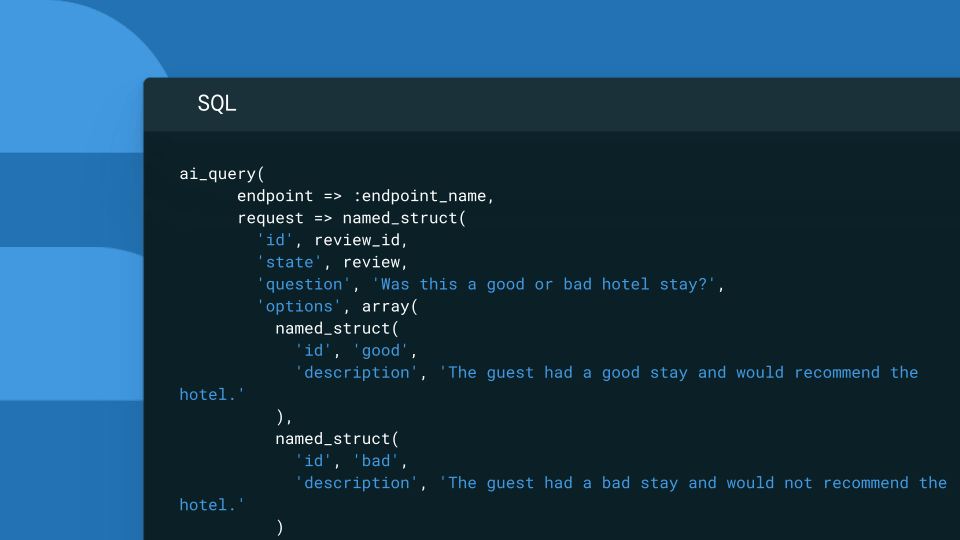
ai_query của Databricks hỗ trợ các API mô hình tùy chỉnh tùy ý, vì vậy bạn có thể gửi định dạng yêu cầu có cấu trúc của SemIf trực tiếp từ SQL.
Ví dụ:
Bây giờ bạn có thể áp dụng mô hình cho các đánh giá đã được lưu trữ trong Databricks và nhận lại phân loại đã chọn cùng xác suất tùy chọn dưới dạng các cột có cấu trúc.

Bắt đầu
Các mô hình quyết định đang phát triển nhanh chóng và các triển khai mã nguồn mở như SemIf-OpenJev giúp bạn thử nghiệm mô hình này dễ dàng hơn nhiều.
Nhập notebook trực tiếp vào không gian làm việc Databricks của bạn, chọn Serverless GPU và nhấp vào Chạy tất cả để bắt đầu. Từ đó, hãy thử nghiệm trên dữ liệu của riêng bạn, thay thế bằng các tiêu chí quyết định của riêng bạn và xem mô hình này phù hợp như thế nào trong các ứng dụng của bạn.
Bài viết được AI dịch và tổng hợp tự động từ Databricks: Blog. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.