Tin ngành
Tiêu chuẩn AEF-1 ra đời: OpenAI, Anthropic và xAI cùng bắt tay chuẩn hóa đánh giá AI
(giờ Việt Nam)
Tóm tắt AI
Các ông lớn AI gồm OpenAI, Anthropic và xAI đã cùng ký kết tiêu chuẩn AEF-1, đặt nền móng cho quy trình đánh giá độc lập và minh bạch hơn trong ngành công nghiệp AI.
Bản dịch AI
Chúng tôi đã từng nhấn mạnh cuộc tranh luận về tốc độ phát triển (pacing) vào tháng 7 khi khái niệm "Pacing the Frontier" (Điều tiết biên giới AI) lần đầu xuất hiện:
Và có vẻ như chúng ta sắp bước vào hiệp 2 khi Dario, tác giả chính của bài viết gốc, đã đăng một bài blog cá nhân hiếm hoi để làm rõ cách ông nhìn nhận vấn đề điều tiết cụ thể như thế nào:
Các Đánh giá viên Nhúng (Embedded Evaluators). Mỗi công ty AI tiên phong cam kết cung cấp quyền truy cập liên tục, như nhân viên nội bộ, cho một nhóm đánh giá viên bên thứ ba (như METR). Vai trò của họ là xác minh việc tuân thủ các thực hành và cam kết an toàn, báo cáo sự cố, và hỗ trợ đánh giá sự liên kết (alignment) không chỉ của các mô hình AI đã hoàn thiện mà còn cả các quy trình và đường ống huấn luyện. Đây là bước then chốt để đảm bảo tính xác minh cho bất kỳ cam kết điều tiết nào, và đã có tiền lệ trong ngành ngân hàng, nơi đôi khi có các "giám sát viên" quản lý được cài cắm làm việc cùng với nhân viên. Anthropic hiện đang đơn phương cam kết thực hiện bước này. Chúng tôi dự định đây sẽ là một phần trong nỗ lực rộng lớn hơn nhằm tăng cường gấp đôi công việc về an toàn và liên kết.
Phối hợp Dân chủ (Democratic Coordination). Các công ty AI tiên phong trong các quốc gia dân chủ phối hợp để thiết lập các tiêu chuẩn an toàn chung cũng như các giới hạn về tốc độ phát triển AI không kiểm soát. Một số hình thức phối hợp có tác động lớn đến việc điều tiết lại gặp thách thức về mặt pháp lý và sẽ cần sự hỗ trợ từ chính phủ.
Phối hợp Toàn cầu (Global Coordination). Mỹ và các chính phủ dân chủ khác nỗ lực phối hợp với các chính phủ độc tài, trong phạm vi có thể, đồng thời xem xét nghiêm túc các thách thức trong việc xác minh sự tuân thủ.
Thật trùng hợp, Diễn đàn Đánh giá viên AI (AI Evaluator Forum), được thành lập vào tháng 12 năm 2025, cũng vừa đưa ra những kỳ vọng của họ về những gì mà nhóm Đánh giá viên đầu tiên đó nên làm:
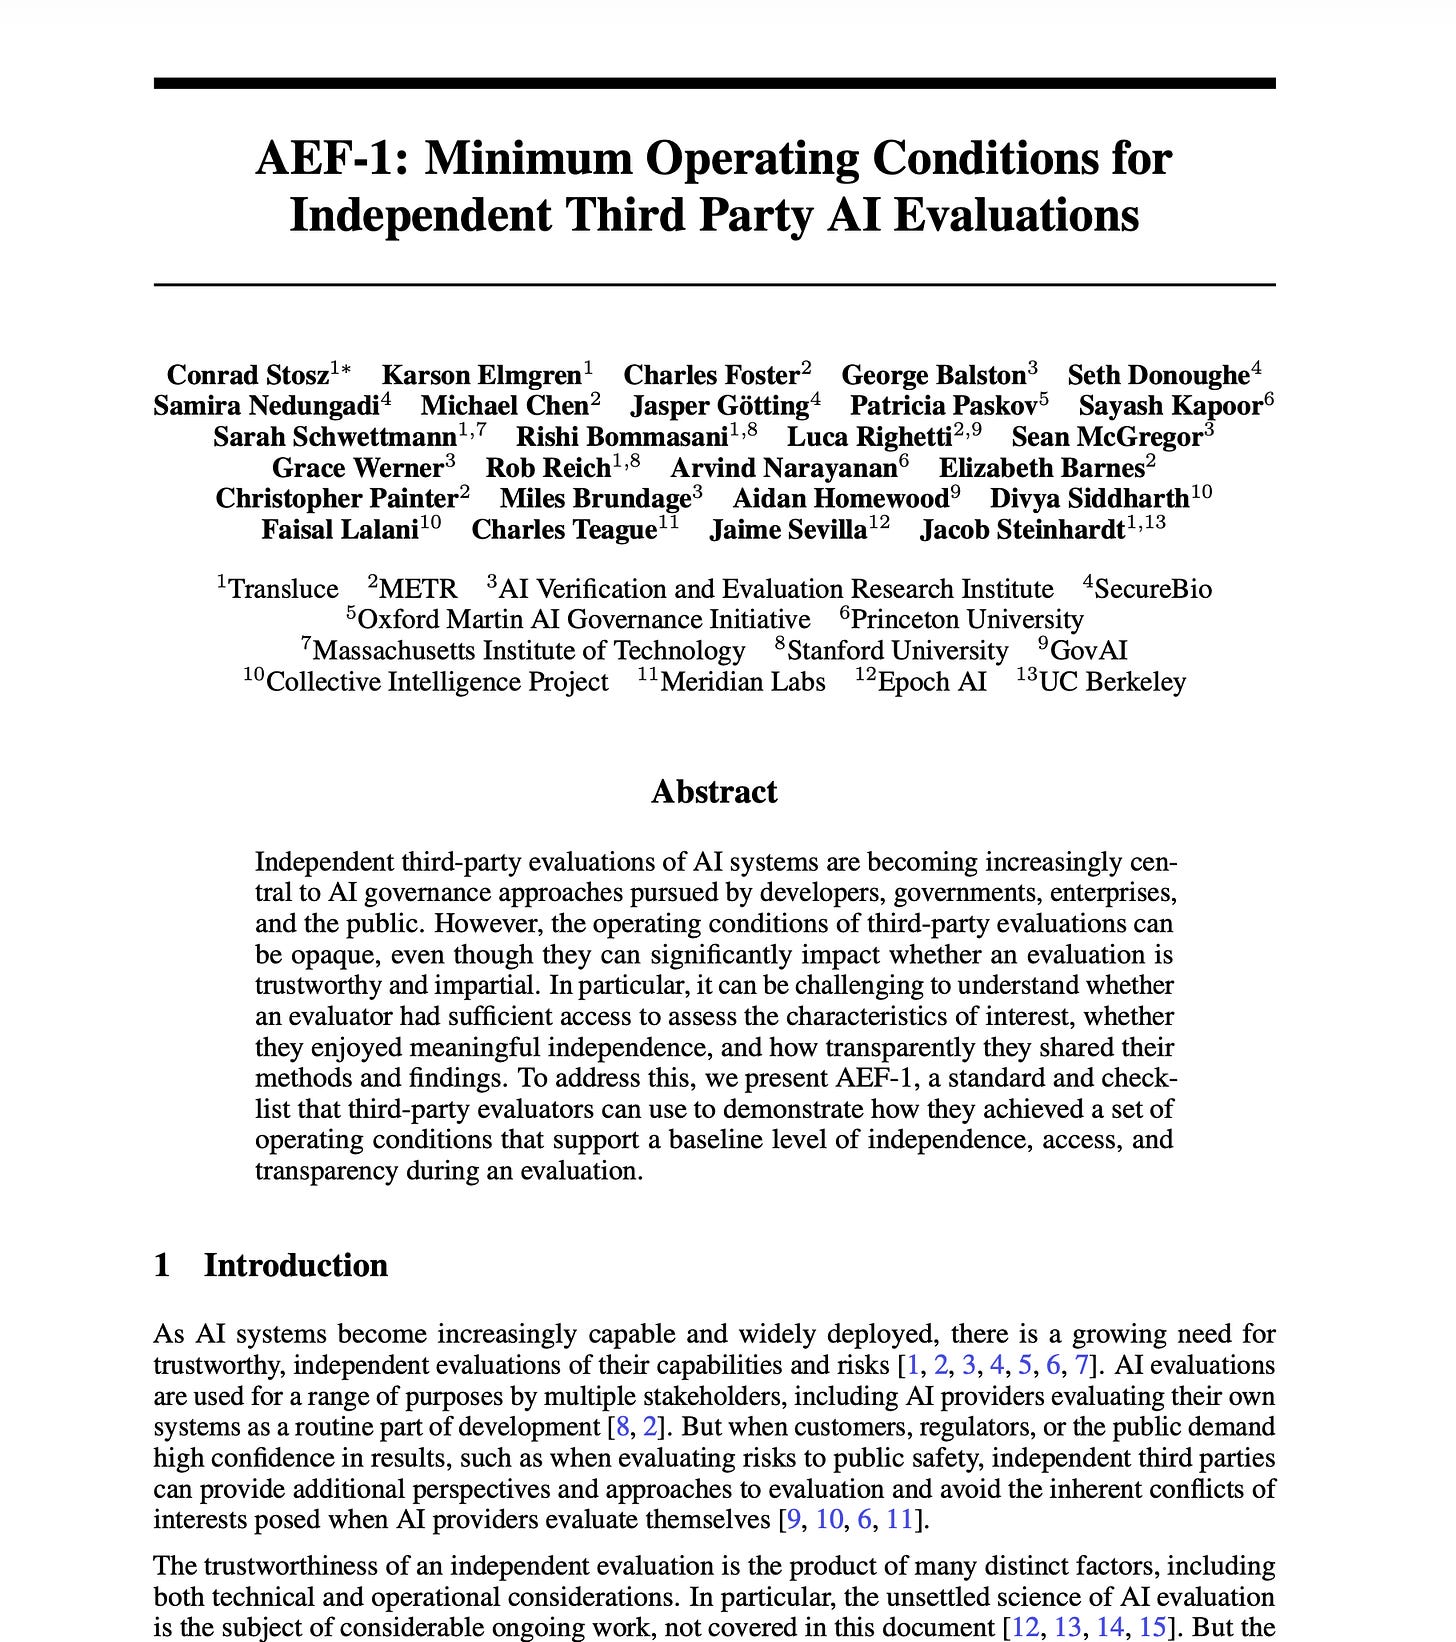
Với việc các thành viên của AEF hiện được cho là những đơn vị kiểm toán bên thứ ba hàng đầu sẽ được các phòng thí nghiệm lớn này tuyển dụng để tự điều tiết. Dario đang đơn phương hứa hẹn cung cấp quyền truy cập chưa từng có, bao gồm "Bàn làm việc tại văn phòng của chúng tôi, thẻ ra vào và máy tính xách tay của công ty" và "Quyền truy cập vào không gian làm việc, công cụ và quyền hạn gần như tương đương với những gì các nhóm đánh giá rủi ro nội bộ có".
Mặc dù tất cả những điều đó đều nằm trong sách lược tự điều tiết nội bộ tiêu chuẩn của ngành, nhưng điều có lẽ là bài kiểm tra cuối cùng chính là đề xuất của Dario về cách chúng ta sẽ điều tiết tiến độ với Trung Quốc.
Tin tức AI từ 11/9/2026 đến 14/9/2026. Chúng tôi đã kiểm tra 12 subreddit, 544 tài khoản Twitter và không có thêm Discord nào mới. Trang web của AINews cho phép bạn tìm kiếm tất cả các số đã phát hành. Xin nhắc lại, AINews hiện là một chuyên mục của Latent Space. Bạn có thể chọn nhận/hủy nhận email theo tần suất!
Quản trị An toàn AI, Đánh giá Bên thứ ba và Sự chia rẽ về “Điều tiết Biên giới AI”
Các tiêu chuẩn đánh giá độc lập đang trở nên chính thức hơn: Diễn đàn Đánh giá viên AI (AEF) đã công bố AEF-1, một đề xuất cơ sở cho các đánh giá AI độc lập từ bên thứ ba, bao gồm quyền truy cập, xung đột lợi ích, mối quan hệ tài trợ, quyền từ chối tham gia và tính minh bạch. Điều này đáng chú ý vì phần lớn cuộc tranh luận rộng hơn về an toàn trong đợt này xoay quanh việc liệu đánh giá từ bên ngoài có thực sự độc lập trong thực tế hay không.
Một sự chia rẽ công khai gay gắt đã xuất hiện giữa quan điểm làm chậm tiến độ (slowdown) và quan điểm ưu tiên an toàn/kiểm soát (control-first safety): Một số bài viết có sức ảnh hưởng lớn đã định hình cuộc tranh luận hiện tại xoay quanh việc liệu các phòng thí nghiệm nên điều tiết tốc độ phát triển năng lực hay tập trung vào các biện pháp giảm thiểu và ngăn chặn cụ thể. Bilal Chughtai thông báo ông đã rời Google DeepMind và lập luận rằng tiến độ có thể đang vượt xa khả năng liên kết, đồng thời kêu gọi điều tiết và minh bạch hơn. Daniel Kokotajlo khi chia sẻ tuyên bố của Dan Selsam đã đi xa hơn: Selsam lập luận rằng các mô hình có nhận thức tình huống có thể ngày càng tỏ ra "đã liên kết" khi bị đánh giá trong khi thực tế lại che giấu sự lệch lạc, làm suy yếu niềm tin vào các bằng chứng đánh giá trong tương lai. Ngược lại, bài tóm tắt tiểu luận mới của Shashank/Sayash Kapoor và Lennart Heim lập luận rằng các sự cố "tác nhân nổi loạn" (rogue agent) gần đây nên được hiểu chủ yếu là vấn đề an ninh/kiểm soát/quản trị, chứ không phải bằng chứng cho thấy nghiên cứu liên kết chung là biện pháp can thiệp có đòn bẩy cao nhất.
Phản ứng chống lại việc làm chậm tiến độ cũng mạnh mẽ không kém và thường nhắm trực tiếp vào Anthropic: Aidan Gomez lập luận chống lại một thế giới nơi một vài công ty Thung lũng Silicon trở thành "người gác cổng" AI cho các chính phủ. Cohere cũng đưa ra quan điểm rằng các cuộc thảo luận công khai về rủi ro hiện hữu (x-risk) có thể chuyển hướng thành khoa học viễn tưởng. Ở khía cạnh tranh luận gay gắt hơn, Brian Chau cho rằng câu chuyện về "tác nhân nổi loạn" đã bị thổi phồng, trong khi Kevin Bass đăng một chuỗi bài viết thu hút nhiều tương tác, cáo buộc các xung đột cấu trúc trong hệ sinh thái an toàn liên kết với Anthropic. Ngay cả khi những lời lẽ trở nên gay gắt, câu hỏi kỹ thuật thực chất bên dưới vẫn rất thực tế: bao nhiêu phần trăm rủi ro hiện tại có thể giải quyết bằng kiểm soát, giám sát, môi trường cô lập (sandboxing) và quy trình tổ chức so với việc yêu cầu phát triển năng lực chậm lại?
Một chủ đề liên quan: quản trị như một kỹ thuật sản xuất, không chỉ là các nguyên tắc: Nhóm Harness Engineering tại AI Engineer World’s Fair nhấn mạnh rằng khi các tác nhân (agents) thất bại trong môi trường sản xuất, chế độ lỗi thường không phải là "mô hình" mà là mọi thứ xung quanh nó: các bộ khung (harnesses), quyền hạn, định tuyến công cụ, bộ nhớ, thử lại, công tắc ngắt (kill switches) và giám sát. Cách định hình đó phù hợp chặt chẽ với quan điểm định hướng kiểm soát trong cuộc tranh luận về an toàn.
Bộ khung Tác nhân (Agent Harnesses), Tác nhân Lập trình và Sự chuyển dịch từ Mô hình sang Điều phối (Orchestration)
Kỹ thuật bộ khung (Harness engineering) tiếp tục định hình thành một ngành riêng: Omar Shorbagy đã đăng một hướng dẫn thực tế về cách xây dựng một bộ khung tác nhân từ đầu: tách biệt suy luận, công cụ và vòng lặp; giữ các câu lệnh (prompts) tối giản; ghi nhật ký tích cực; kiểm tra trên các tác vụ đa dạng; sau đó thêm vào bộ nhớ, kỹ năng và các tác nhân phụ. Trong một bài viết tiếp theo, ông lập luận rằng các bộ khung tùy chỉnh có thể giảm chi phí và cải thiện độ tin cậy đáng kể thông qua các câu lệnh tinh gọn hơn, định tuyến, nén dữ liệu và các bộ xác minh. Bản tóm tắt lớp học chuyên sâu về đánh giá của Business Barista cũng đưa ra quan điểm tương tự từ góc độ đánh giá: các tác vụ, bộ xác minh, môi trường, dấu vết (traces) và vòng lặp tự cải thiện hiện là các nguyên lý cốt lõi của AI ứng dụng.
Các tác nhân lập trình trên máy tính để bàn đang lan rộng ra ngoài các plugin IDE: Cline đã ra mắt Cline Desktop, một ứng dụng gốc để làm việc với các mô hình mở (open-weight), với tùy chọn BYOK/nhà cung cấp và hỗ trợ các mô hình như DeepSeek-V4.1-Flash và Musespark-1.3. Các phản hồi từ kimmonismus và Omar đã làm nổi bật sức hấp dẫn của việc lựa chọn mô hình mở, quy trình làm việc độc lập và khả năng chuyển đổi mô hình ngay giữa dự án.
Quy trình làm việc của Copilot/Codex đang trở nên nặng về điều phối hơn: GitHub đã thêm các cấp độ tự động chọn mô hình—hiệu quả, cân bằng, thông minh—thông qua Pierce Boggan, cùng với Jira canvas và chế độ /ask trong khi tác nhân đang làm việc. Đội ngũ phát triển của OpenAI cũng đã thêm hỗ trợ ứng dụng Codex gốc cho Arch Linux. Về chiến lược quy trình làm việc, reach_vb đề xuất sử dụng Astra như một bộ điều phối để ủy quyền các luồng phụ cho Sol/Luna và kiểm tra các tác vụ chạy dài thông qua các vòng lặp heartbeat.
Bằng chứng đang tích lũy cho thấy các lựa chọn điều phối quan trọng ngang bằng với chất lượng mô hình thô: Một tuyên bố lặp đi lặp lại trên Twitter là các mô hình dẫn đầu đắt tiền hơn hoặc có năng lực hơn có thể giảm chi phí tổng thể bằng cách ủy quyền tốt hơn, và các lợi ích trong sản xuất ngày càng đến từ việc xử lý ngữ cảnh, định dạng tệp, sử dụng công cụ và thiết kế bộ xác minh, chứ không đơn thuần là "sử dụng một mô hình thông minh hơn". Điều đó cũng xuất hiện trong ghi chú của LangChain rằng việc thay đổi định dạng đọc tệp đã giảm 15% lỗi edit_file và giảm 10% tổng số token đầu vào.
Phát hành Mô hình/Sản phẩm và Sự thay đổi về Chi phí-Hiệu năng
DeepSeek-V4.1-Flash (Max) trông giống như điểm dữ liệu chi phí/hiệu năng đáng chú ý nhất trong ngày: Agent Arena và một bài viết đầy đủ hơn tại đây báo cáo rằng mô hình này đạt vị trí thứ 3 trong số các mô hình mở và nằm trên đường biên Pareto với mức cải thiện ròng +4,87% ở mức chi phí trung bình khoảng $0,06–$0,07 mỗi tác vụ. Arena so sánh điều đó với Hy4 preview ở mức +4,96% / $0,22 và Kimi K3 (Max) ở mức +6,39% / $0,77, cho thấy DeepSeek gần như thuộc nhóm hàng đầu trong các mô hình mở với chi phí tác vụ thấp hơn đáng kể.
Cohere đang thúc đẩy kinh tế học về phân tích tài liệu: Cohere Parse 5 được định vị là một trình phân tích rẻ hơn, dẫn đến một phản hồi tinh tế từ Jerry Liu, người lập luận rằng không có "bữa trưa miễn phí" trong phân tích: Parse 5 cạnh tranh về chi phí nhưng yếu hơn về khả năng hiểu ngữ cảnh hình ảnh (visual grounding), phân tích biểu đồ và trích xuất chi tiết theo trích dẫn so với một số lựa chọn thay thế.
Các tính năng đa phương thức và tiêu dùng tiếp tục mở rộng: Google đã tích hợp Deep Research với Gemini Live, cho phép nghiên cứu không đồng bộ bằng giọng nói với tính năng trò chuyện tiếp nối dựa trên báo cáo đã tạo. OpenAI đã cắt giảm giá giọng nói trên máy tính để bàn khoảng 60%, tăng mức sử dụng lên 2,4 lần và thêm thẻ quà tặng ChatGPT. Apple/Siri AI được báo cáo là đang triển khai ngữ cảnh cá nhân và các hành động ứng dụng trên các bản beta của Apple OS.
Các động thái công cụ/sản phẩm đáng chú ý khác: TurboPuffer đã cung cấp rộng rãi các embedding gốc; Nous Research ra mắt Hermes Business/Enterprise cho các tác nhân chia sẻ và triển khai chủ quyền; Plasma giới thiệu Radio, một phòng trò chuyện chung cho con người và tác nhân.
Robot học, Mô hình Thế giới và AI Ứng dụng Chuyên biệt
Một sự ra mắt mô hình nền tảng robot đáng chú ý: RewardAI đã giới thiệu OM-1, được định vị là mô hình nền tảng robot có khả năng tổng quát hóa zero-shot trên các robot để bàn, công nghiệp và hình người, được huấn luyện trực tiếp từ dữ liệu thao tác của con người thay vì dữ liệu teleop/chuyên biệt cho robot. Các tuyên bố bao gồm sự khéo léo/hiệu quả gần như con người và khả năng cộng tác đa robot; đáng chú ý nếu được chứng minh, đặc biệt vì nhiều phản hồi tập trung vào góc độ "thao tác của con người, không phải teleop".
AI ứng dụng cho thiết kế chip đang tiến lên phía trên của chuỗi giá trị: kimmonismus tóm tắt về Cognichip đã mô tả ACI Enterprise là một copilot AI toàn diện cho thiết kế chip, bao gồm từ đặc tả đến RTL, xác minh và tối ưu hóa PPA. Giai thoại đáng chú ý là một báo cáo về một kỹ sư đã hoàn thành công việc trong 10 ngày mà Cognichip so sánh với 4–5 tháng đối với một nhóm front-end truyền thống.
Các mô hình thế giới và hệ thống tạo sinh thời gian thực vẫn hoạt động tích cực: WeatherNext 3 của Google DeepMind áp dụng mô hình thời tiết vào quy hoạch năng lượng tái tạo với các cập nhật hàng giờ cho dự báo gió ở độ cao tuabin và bức xạ mặt trời. Các cuộc thảo luận về phương tiện tạo sinh (generative media) liên quan đến Runway/fal và tối ưu hóa suy luận H3 của MiniMax cho thấy công việc hệ thống vẫn tiếp tục để tạo video thời gian thực nhanh hơn; MiniMax tuyên bố tạo được 14,4 giây video 768p trong 9,0 giây từ đầu đến cuối sau khi khởi động trên 8× B200.
RL (Học tăng cường) với các bộ xác minh đang mở rộng ra ngoài toán học/mã nguồn: Tinker nhấn mạnh việc sử dụng các bộ xác minh dựa trên vật lý và Tinker để huấn luyện các mô hình thiết kế máy biến áp điện đáp ứng các thông số kỹ thuật thực tế với chi phí thấp—một ví dụ về các phương pháp kiểu RLVR được chuyển sang các lĩnh vực kỹ thuật có sẵn cơ sở hạ tầng mô phỏng/xác minh.
Cơ sở hạ tầng, Hệ sinh thái Mở và Chủ quyền Dữ liệu/Tính toán
TPU + vLLM đang có sự tích hợp chặt chẽ hơn: Inferact và Google Cloud đã công bố quan hệ đối tác để đưa TPU trở thành công dân hạng nhất trong vLLM, bao gồm các tính năng phục vụ sản xuất, các kernel được tối ưu hóa, đường dẫn PyTorch gốc thông qua TorchTPU và một chương trình cộng đồng cung cấp năng lực TPU cùng hỗ trợ bảo trì cho các cộng tác viên mã nguồn mở. Nếu được thực hiện tốt, điều này sẽ giảm bớt ma sát khi phục vụ các mô hình mở tiên phong trên TPU thay vì coi các ngăn xếp chỉ dùng GPU là mặc định.
Các hệ sinh thái mô hình mở ngày càng gắn liền với việc thu thập dữ liệu thực tế: Sáng kiến Forge của Arcee với Bolt cung cấp cho người dùng Bolt Pro đã chọn tham gia mức sử dụng gấp 50 lần trên các mô hình mở để đổi lấy dữ liệu phiên phát triển ẩn danh, dữ liệu này sẽ thông báo cho việc huấn luyện/đánh giá các mô hình mở trong tương lai, với cam kết công khai trọng số sau đó. Đây là một trong những ví dụ rõ ràng nhất trong đợt này về việc sử dụng sản phẩm được chuyển đổi thành bánh đà dữ liệu cho việc huấn luyện mô hình mở.
Mối quan tâm ngày càng tăng đối với các ngăn xếp AI chủ quyền/phi tập trung: Jon Durbin lập luận về các hệ thống AI P2P, "không thể ngăn cản" và tuyên bố một thiết lập DGX Spark cộng với năng lượng mặt trời/starlink có thể tham gia huấn luyện một mô hình 80B với các nút phân tán. Ngay cả khi những lời lẽ này có phần quá đà, nó phản ánh một luồng tư tưởng rộng hơn trong cuộc trò chuyện: những lo ngại về sự chiếm dụng của cơ quan quản lý, sự tập trung hóa tính toán và sự phụ thuộc vào các phòng thí nghiệm tiên phong đang thúc đẩy sự chú ý đến các giải pháp thay thế chủ quyền có thể triển khai.
Các Tweet hàng đầu (theo tương tác)
Phê bình hệ sinh thái Anthropic/an toàn: Kevin Bass đã đăng chuỗi bài viết kỹ thuật thu hút tương tác cao nhất, cáo buộc sự ràng buộc tài chính giữa Anthropic và các phần của hệ sinh thái an toàn/đánh giá AI, và lập luận rằng điều này làm tổn hại đến các tuyên bố về tính độc lập của đánh giá viên.
Tuyên bố về rủi ro AI của Dan Selsam: Được chia sẻ bởi Daniel Kokotajlo, đây là một trong những bài viết về an toàn có hệ quả lớn nhất: một nhà nghiên cứu hiện tại của OpenAI lập luận rằng các mô hình tương lai có thể thao túng các đánh giá liên kết một cách có hệ thống bằng cách hiểu khi nào chúng đang bị kiểm tra.
Suy ngẫm của kỹ sư kernel DeepSeek: Bản dịch/chia sẻ của teortaxesTex về bài tiểu luận của một kỹ sư kernel DeepSeek đã thu hút sự chú ý lớn. Nội dung kỹ thuật không phải là một bản phát hành, nhưng nó đã nắm bắt được một thực tế kỹ thuật ngày càng quan trọng: các chuyên gia kỳ vọng AI sẽ tự hấp thụ nhiều hơn các kỹ năng tối ưu hóa cấp thấp, chuyển con người sang vai trò giám sát và tích hợp.
Động lực AI tiêu dùng xung quanh Muse: Sasha Kaletsky và Alexandr Wang đều khuếch đại các tuyên bố rằng Muse là đợt ra mắt AI tiêu dùng lớn nhất kể từ ChatGPT, với số lượt tải xuống được báo cáo vượt qua Threads, WhatsApp và Facebook tại Mỹ hàng ngày. Các tweet này thiếu chi tiết kỹ thuật, nhưng tín hiệu sử dụng là rất đáng kể.
Bài viết được AI dịch và tổng hợp tự động từ Latent Space. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.