Mô hình
Xiaomi ra mắt MiMo-V2.6-Pro 1T: Mô hình mã nguồn mở mạnh nhất thế giới với chi phí huấn luyện 3 triệu USD
(giờ Việt Nam)
Tóm tắt AI
Xiaomi vừa thiết lập cột mốc mới trong làng AI với MiMo-V2.6-Pro, mô hình mã nguồn mở quy mô 1 nghìn tỷ tham số được huấn luyện với ngân sách 3 triệu USD, khẳng định vị thế dẫn đầu của các phòng lab Trung Quốc.
Bản dịch AI
Hãy gặp gỡ Xiaomi và các phòng thí nghiệm tiên phong hàng đầu khác của Trung Quốc tại AIE Shanghai!
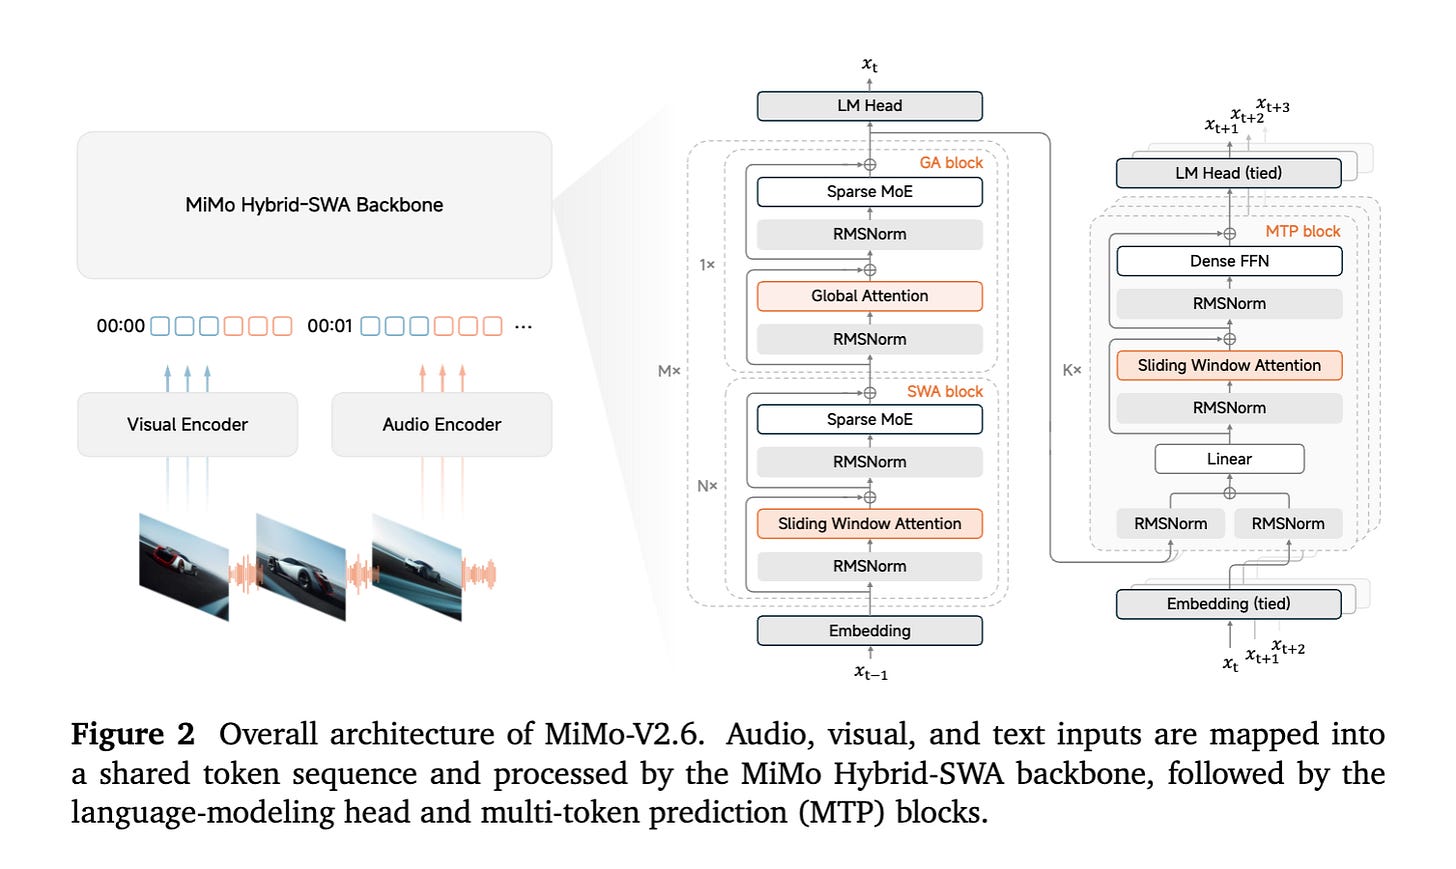
Đây là lần đầu tiên đối với nhà sản xuất điện thoại được mệnh danh là “Apple của Trung Quốc” nay đã chuyển mình thành phòng thí nghiệm tiên phong: “Dòng MiMo-V2.6 bao gồm hai mô hình đa phương thức (omnimodal) nguyên bản: MiMo-V2.6-Pro là mô hình mạnh mẽ nhất của chúng tôi cho đến nay, trong khi MiMo-V2.6-Flash mang lại sự cân bằng tốt nhất giữa trí tuệ, hiệu quả và chi phí. Chúng tôi cũng đang triển khai MiMo-V2.6-Pro-UltraSpeed, mang lại tốc độ đầu ra nhanh hơn tới 20 lần với cùng chất lượng, dành cho những người dùng yêu cầu tốc độ tạo nội dung cực nhanh.”

Artificial Analysis@ArtificialAnlys
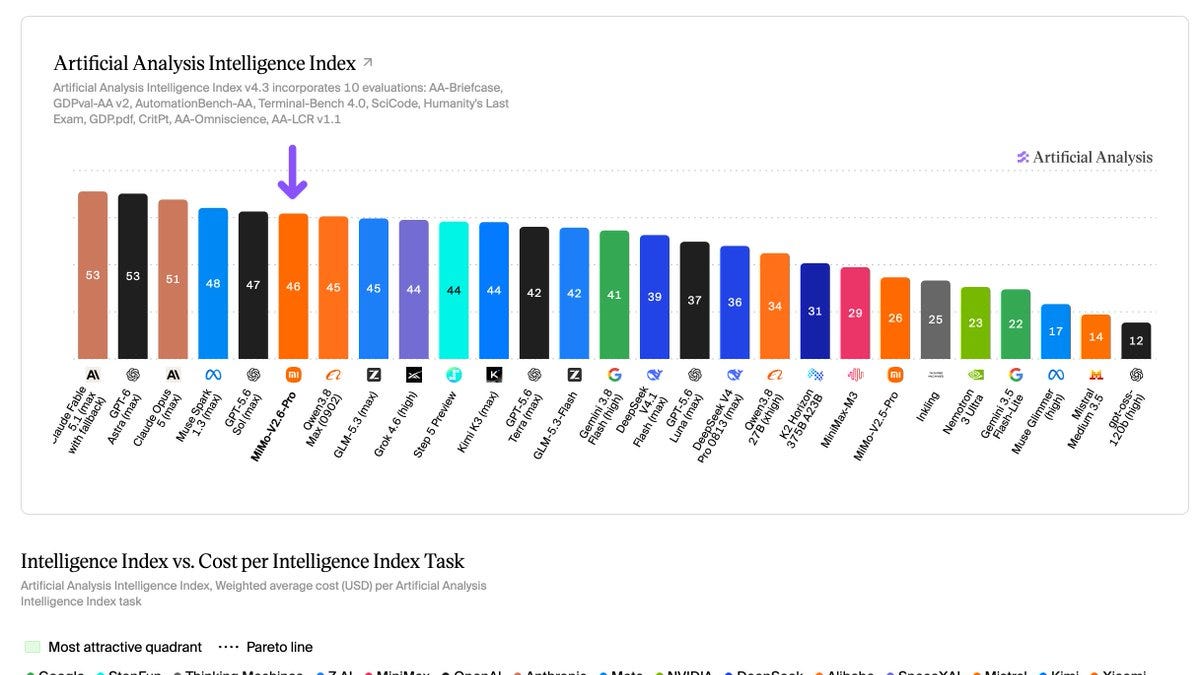
MiMo-V2.6-Pro ra mắt với tư cách là mô hình trọng số mở (open weights) hàng đầu trên Chỉ số Trí tuệ (Intelligence Index) của Artificial Analysis (đạt 46 điểm). Với mức giá 0,13 USD cho mỗi tác vụ trên Chỉ số Trí tuệ, nó đã lọt vào đường biên Pareto về Trí tuệ so với Chi phí trên mỗi Tác vụ @Xiaomi vừa phát hành MiMo-V2.6-Pro, một mô hình trọng số mở với những cải tiến lớn…

8:11 CH · 21 tháng 9, 2026 · 227K Lượt xem
97 Lượt trả lời · 197 Lượt đăng lại · 2,21K Lượt thích
Xiaomi vốn không được coi là một trong sáu “Con hổ AI” của Trung Quốc, vì vậy điều này gây bất ngờ lớn cho trật tự các tên tuổi vốn đã quen thuộc và được yêu thích. Và… nó là mô hình đa phương thức nguyên bản!
Xiaomi đã gây chú ý vài ngày trước khi Fuli Luo, một kỹ sư ngôi sao từng làm việc tại DeepSeek hiện đang ở Xiaomi, bắt đầu công khai trực tiếp các đợt huấn luyện RL (Học tăng cường) cuối cùng của họ, cho thấy mức độ minh bạch bất thường trong các chỉ số nội bộ.
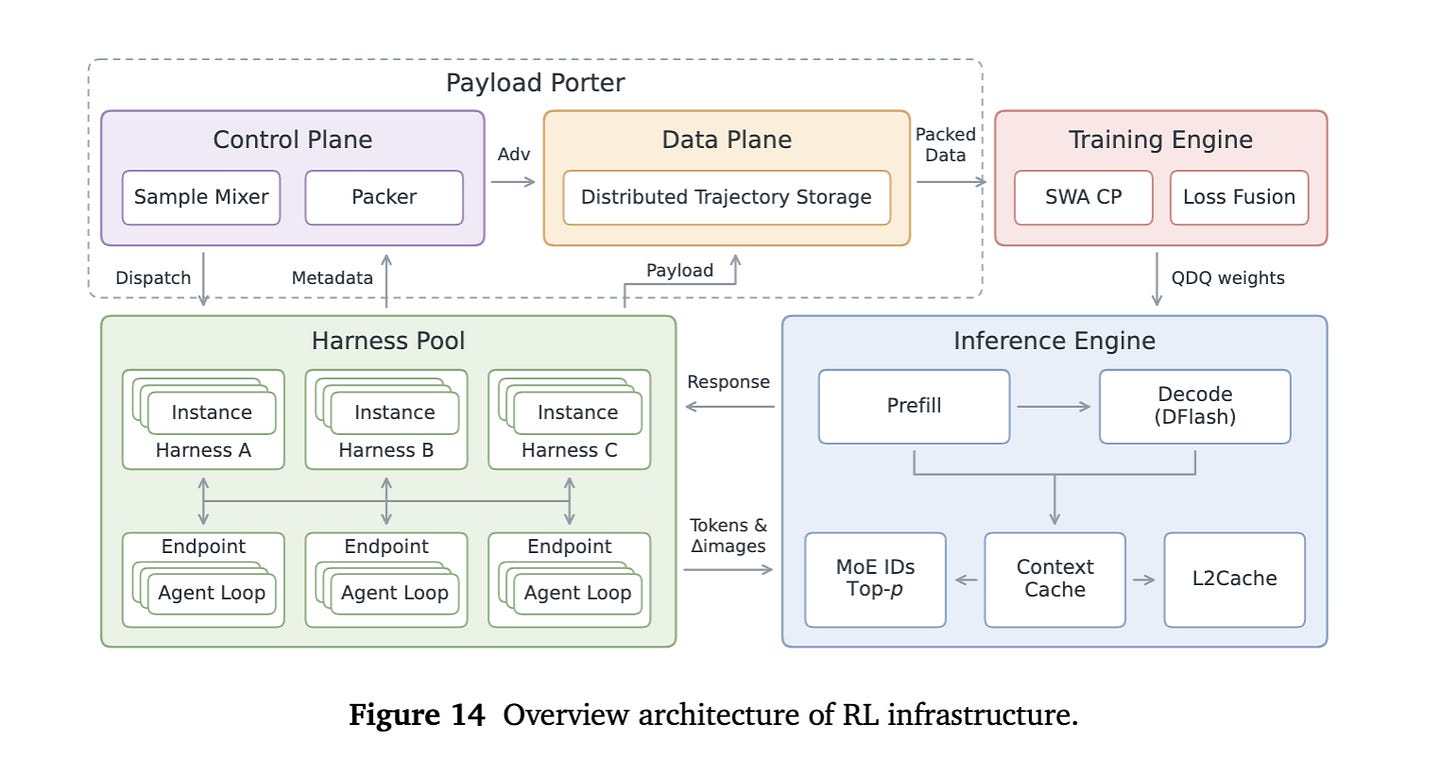
Như họ đã lưu ý trong báo cáo kỹ thuật, họ đã mở rộng quy mô tính toán RL theo ba trục:
Batch lớn hơn và thông lượng cao hơn: các batch lớn trên kiến trúc hoàn toàn bất đồng bộ, với 1.568 mẫu cho mỗi lần cập nhật, huấn luyện ở độ dài ngữ cảnh lên tới 1 triệu token và 3,5 đến 3,7 tỷ token mỗi bước.
Nhiều tác vụ hơn và môi trường phong phú hơn: một bộ huấn luyện đa tác vụ bao gồm lập trình, tác nhân tổng quát (general agents), thị giác và an ninh mạng, được kết hợp qua nhiều bộ công cụ (harnesses) để các thành tựu trong một khả năng sẽ củng cố các khả năng khác.
Tính toán đánh giá (grader) nhiều hơn: so sánh tương đối trong mỗi nhóm giúp các tác vụ RL dài hạn có tín hiệu phần thưởng chính xác và đa dạng hơn, khép kín vòng lặp tự cải thiện và hướng mô hình đi theo các lộ trình ngắn hơn với ít token hơn cho mỗi tác vụ.
TẤT CẢ các công cụ này, bao gồm cả các môi trường, sẽ được mở nguồn. Mã nguồn môi trường và công thức huấn luyện đã có, nhưng các bộ dữ liệu hoàn chỉnh với hơn 7.000 tác vụ vẫn chưa được phát hành.
Lập trình / kỹ thuật phần mềm: Công thức mã nguồn, trình tải dữ liệu và phần thưởng.
An ninh mạng / tái tạo lỗ hổng: Môi trường ARVO và công thức huấn luyện.
Tổng quát / công việc tri thức: Môi trường tổng quát, công cụ và công thức huấn luyện.
Thị giác / phát triển web: Môi trường phát triển web và chấm điểm.
Tạo nhạc: Chuẩn bị dữ liệu và trình chấm điểm âm nhạc.
Các bộ công cụ nhỏ có thể kết hợp (Composable mini-harnesses): Cấu hình tác nhân.
Bộ điều hợp môi trường chia sẻ: Môi trường mimoagent.
Tin tức AI từ 19/9/2026 đến 21/9/2026. Chúng tôi đã kiểm tra 12 subreddit, 544 tài khoản Twitter và không có thêm thông tin nào từ Discord. Trang web của AINews cho phép bạn tìm kiếm tất cả các số báo trước đây. Xin nhắc lại, AINews hiện là một phần của Latent Space. Bạn có thể chọn nhận hoặc hủy nhận email theo tần suất!
Mô hình mở, Cạnh tranh và Khoảng cách Trung Quốc
Các mô hình mở vẫn là câu chuyện trọng tâm về chính sách và thị trường: Nathan Lambert đã chia sẻ một bản tóm tắt trước quốc hội về hiệu suất, mức độ áp dụng của mô hình mở và sự cạnh tranh Mỹ-Trung, theo sau là một bản tóm tắt công khai. Lập luận rộng hơn đã xuất hiện trở lại ở nơi khác: @Yuchenj_UW cho rằng khả năng lập trình tiên phong đã chững lại kể từ Opus 4.8, trong khi các mô hình mã nguồn mở vẫn tiếp tục thu hẹp khoảng cách với chi phí thấp hơn từ 10–50 lần; @ClementDelangue cũng lập luận tương tự rằng các API là quá mức cần thiết cho nhiều trường hợp sử dụng thực tế và các mô hình chuyên biệt sẽ chiếm thị phần. Quan điểm phản bác: @teortaxesTex lập luận rằng các mô hình tiên phong thực sự đã phân tách thành các tầng cao hơn, với các mô hình nội bộ và các mô hình đóng hàng đầu vẫn dẫn trước đáng kể.
Nhịp độ phát hành từ các phòng thí nghiệm Trung Quốc hiện rất khó để bỏ qua: @Thom_Wolf đã tổng hợp một đợt phát hành mở dày đặc bất thường trong khoảng 10 tuần, bao gồm Kimi K3, Qwen3.8-Max, DeepSeek V4-Pro, GLM-5.3, Hy4 Preview, Atria Dawn và nhiều mô hình khác. Điều này được củng cố bởi một ghi chú từ Bloomberg thông qua @Polymarket rằng các công ty khởi nghiệp đang ngày càng xây dựng các mô hình tùy chỉnh trên các trọng số mở để cắt giảm chi phí và giảm sự phụ thuộc vào OpenAI/Anthropic. Thông điệp ẩn ý qua nhiều tweet: khả năng của các mô hình trọng số mở không còn giới hạn ở các mô hình tầm trung; nhiều đội ngũ đang vận chuyển các mô hình MoE quy mô tiên phong với câu chuyện về hiệu suất chi phí đáng tin cậy.
Xiaomi MiMo-V2.6 và RL là đòn bẩy mở rộng quy mô mới
MiMo-V2.6 là bản phát hành mô hình mở lớn nhất trong nhóm: @XiaomiMiMo đã ra mắt MiMo-V2.6 Pro và Flash, được mô tả là các mô hình đa phương thức mở với trọng số, báo cáo kỹ thuật, môi trường RL và mã huấn luyện. Artificial Analysis cho biết MiMo-V2.6-Pro ra mắt với tư cách là mô hình trọng số mở hàng đầu trên Chỉ số Trí tuệ (46), với tổng cộng 1,02 nghìn tỷ tham số / 42 tỷ tham số hoạt động và hiệu quả chi phí mạnh mẽ ở mức 0,435 USD/triệu token đầu vào và 0,87 USD/triệu token đầu ra. @victormustar lưu ý rằng các mô hình này được cấp phép theo MIT.
Điều nổi bật về mặt kỹ thuật không chỉ là mô hình mà còn là ngăn xếp RL: @eliebakouch đã nêu bật bài báo về môi trường/nhà máy dữ liệu của Xiaomi để tạo các tác vụ RL từ các kho lưu trữ mở với “các tác nhân trong vòng lặp” (agents in the loop) nhằm đảm bảo tính mạnh mẽ và chống gian lận. Các bình luận sau đó chỉ ra một bài báo thứ hai và mức độ minh bạch cao bất thường: @xeophon lưu ý Xiaomi muốn phát hành khoảng 7.000 môi trường RL, và @eliebakouch nhấn mạnh rằng đội ngũ đã vận chuyển mô hình + báo cáo kỹ thuật chưa đầy một tuần sau đợt chạy RL cuối cùng. Một cách giải thích phổ biến từ @bertgodel và @Thom_Wolf là các môi trường RL mở chất lượng cao hiện có thể quan trọng về mặt chiến lược như các kho dữ liệu tiền huấn luyện trong chu kỳ trước.
Chi tiết về chi phí/thông lượng RL đã thu hút sự chú ý vì chúng rút ngắn thời gian: @zephyr_z9 trích dẫn 130 giờ, 75 tỷ token và 2,6 triệu USD cho đợt chạy RL đằng sau kết quả này; @tianjun_zhang cho biết dòng MiMo mở rộng quy mô RL trên JAX + TPU, nơi việc mở rộng “chủ yếu là thay đổi cấu hình, không phải viết lại mã”. Nếu những con số này chính xác, hàm ý là hậu huấn luyện/RL đang trở thành con đường rẻ hơn nhiều để đạt được các thành tựu tiệm cận tiên phong so với những gì nhiều người giả định.
Mô hình quyết định, Jev và sự trở lại của suy luận chuyên biệt
Jev là chủ đề thảo luận về sản phẩm/chủ đề chiếm ưu thế: Nhiều bài đăng hội tụ vào cùng một khung: đây “chỉ” là phân loại/định tuyến, nhưng với trí tuệ mô hình hiện đại cùng độ trễ/chi phí tốt hơn nhiều. @karpathy gọi đó là một điểm trên đường biên Pareto cho “không cần suy nghĩ, một token, độ trễ thấp, trí tuệ chấp nhận được”. @willdepue mô tả nó như một bộ phân loại zero-shot với trí tuệ gần như tiên phong, trong khi @ClementDelangue lập luận rằng sự phấn khích cho thấy nhu cầu tiềm ẩn lớn đối với các mô hình chuyên biệt thay vì các mô hình tổng quát ngày càng lớn hơn.
Hệ sinh thái xung quanh Jev mở rộng nhanh chóng: @sarah_edo đã xây dựng một tiện ích mở rộng Chrome sử dụng Jev để chọn và điền các công cụ WebMCP liên quan theo từng lần nhấn phím. LangChain đã thêm Jev-as-a-judge vào LangSmith; @hwchase17 và @Hacubu đã đẩy SemIf, một mô hình quyết định mã nguồn mở, thông qua LangSmith Gateway. @omarsar0 báo cáo việc sử dụng Jev để gắn thẻ lại khoảng 2.300 bài báo trong 83 giây với giá 0,14 USD, với 579 thay đổi có độ tin cậy cao và xác thực thủ công các điểm không đồng nhất.
Bài học bền vững hơn là về kiến trúc: DSPyOSS lập luận rằng việc hỏi các tác nhân tiên phong giống như quản lý con người, trong khi viết tay các chương trình mô hình quyết định tương tự như viết hợp ngữ (assembly); cả hai thái cực đều hữu ích, nhưng dễ hỏng nếu lạm dụng. Một số bài đăng nhấn mạnh nơi các mô hình này phù hợp nhất: định tuyến, cổng phê duyệt, chấm điểm dấu vết, lựa chọn công cụ, quyết định tài liệu rời rạc và giám sát chi phí thấp bên trong các vòng lặp tác nhân lớn hơn thay vì là các “tác nhân thông minh” độc lập.
Suy luận, Công cụ và Tối ưu hóa hệ thống
Cả bộ mã hóa token (tokenizer) và cơ sở hạ tầng hậu huấn luyện đều nhận được những nâng cấp đáng kể: Tokenizers v1 RC của Hugging Face tuyên bố tốc độ mã hóa nhanh hơn tới 30 lần, cải thiện khả năng mở rộng đa luồng, sử dụng bộ nhớ thấp hơn và kích thước gói nhỏ hơn nhiều; @art_zucker coi đó là một thư viện mã hóa token SOTA (tiên tiến nhất) mới. Riêng biệt, Halo đã ra mắt như một khung hậu huấn luyện tuyên bố thông lượng nhanh hơn tới 2,8 lần so với TRL gốc trong khi vẫn giữ các mô hình ở định dạng Hugging Face nguyên bản.
Kỹ thuật phía suy luận vẫn là một đòn bẩy chính: @RisingSayak đã chỉ ra cách KV caching được tích hợp vào QwenImage 2.1, tách biệt ngữ cảnh cố định khỏi các vị trí hình ảnh thay đổi và mang lại tốc độ nhanh hơn 2,55 lần; luồng thảo luận trích dẫn thời gian DiT từ 50,57 giây xuống 19,86 giây trên A100 đã làm nóng với chi phí bộ nhớ vừa phải. vLLM đã công bố các cấu hình phục vụ được tinh chỉnh cho Qwen3.8-2.4T trên GB300 NVL72, cho thấy đường biên Pareto từ 5.000 tổng tok/s/GPU ở thông lượng cao đến 180 tok/s đầu ra/người dùng ở độ trễ thấp. Trong các khối lượng công việc video, vLLM cũng đã tích hợp PyNvVideoCodec/NVDEC, loại bỏ các nút thắt giải mã CPU và báo cáo thông lượng nhanh hơn 2 lần tại 8×H100.
Bài viết được AI dịch và tổng hợp tự động từ Latent Space. Liên kết bài gốc ở phía trên. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.