Mô hình
Supersonic Labs ra mắt Julia 1: Mô hình quyết định mã nguồn mở 144.3M tham số chạy mượt trên CPU
(giờ Việt Nam)
Tóm tắt AI
Phòng thí nghiệm Supersonic Labs (Brazil) vừa phát hành Julia 1, mô hình AI 144.3M tham số chuyên biệt cho việc ra quyết định. Với giấy phép Apache 2.0, mô hình này không tạo văn bản mà tập trung đưa ra lựa chọn và xác suất từ 2-20 phương án, tối ưu để chạy trực tiếp trên CPU thông thường.
Chính văn · Bản dịch AI
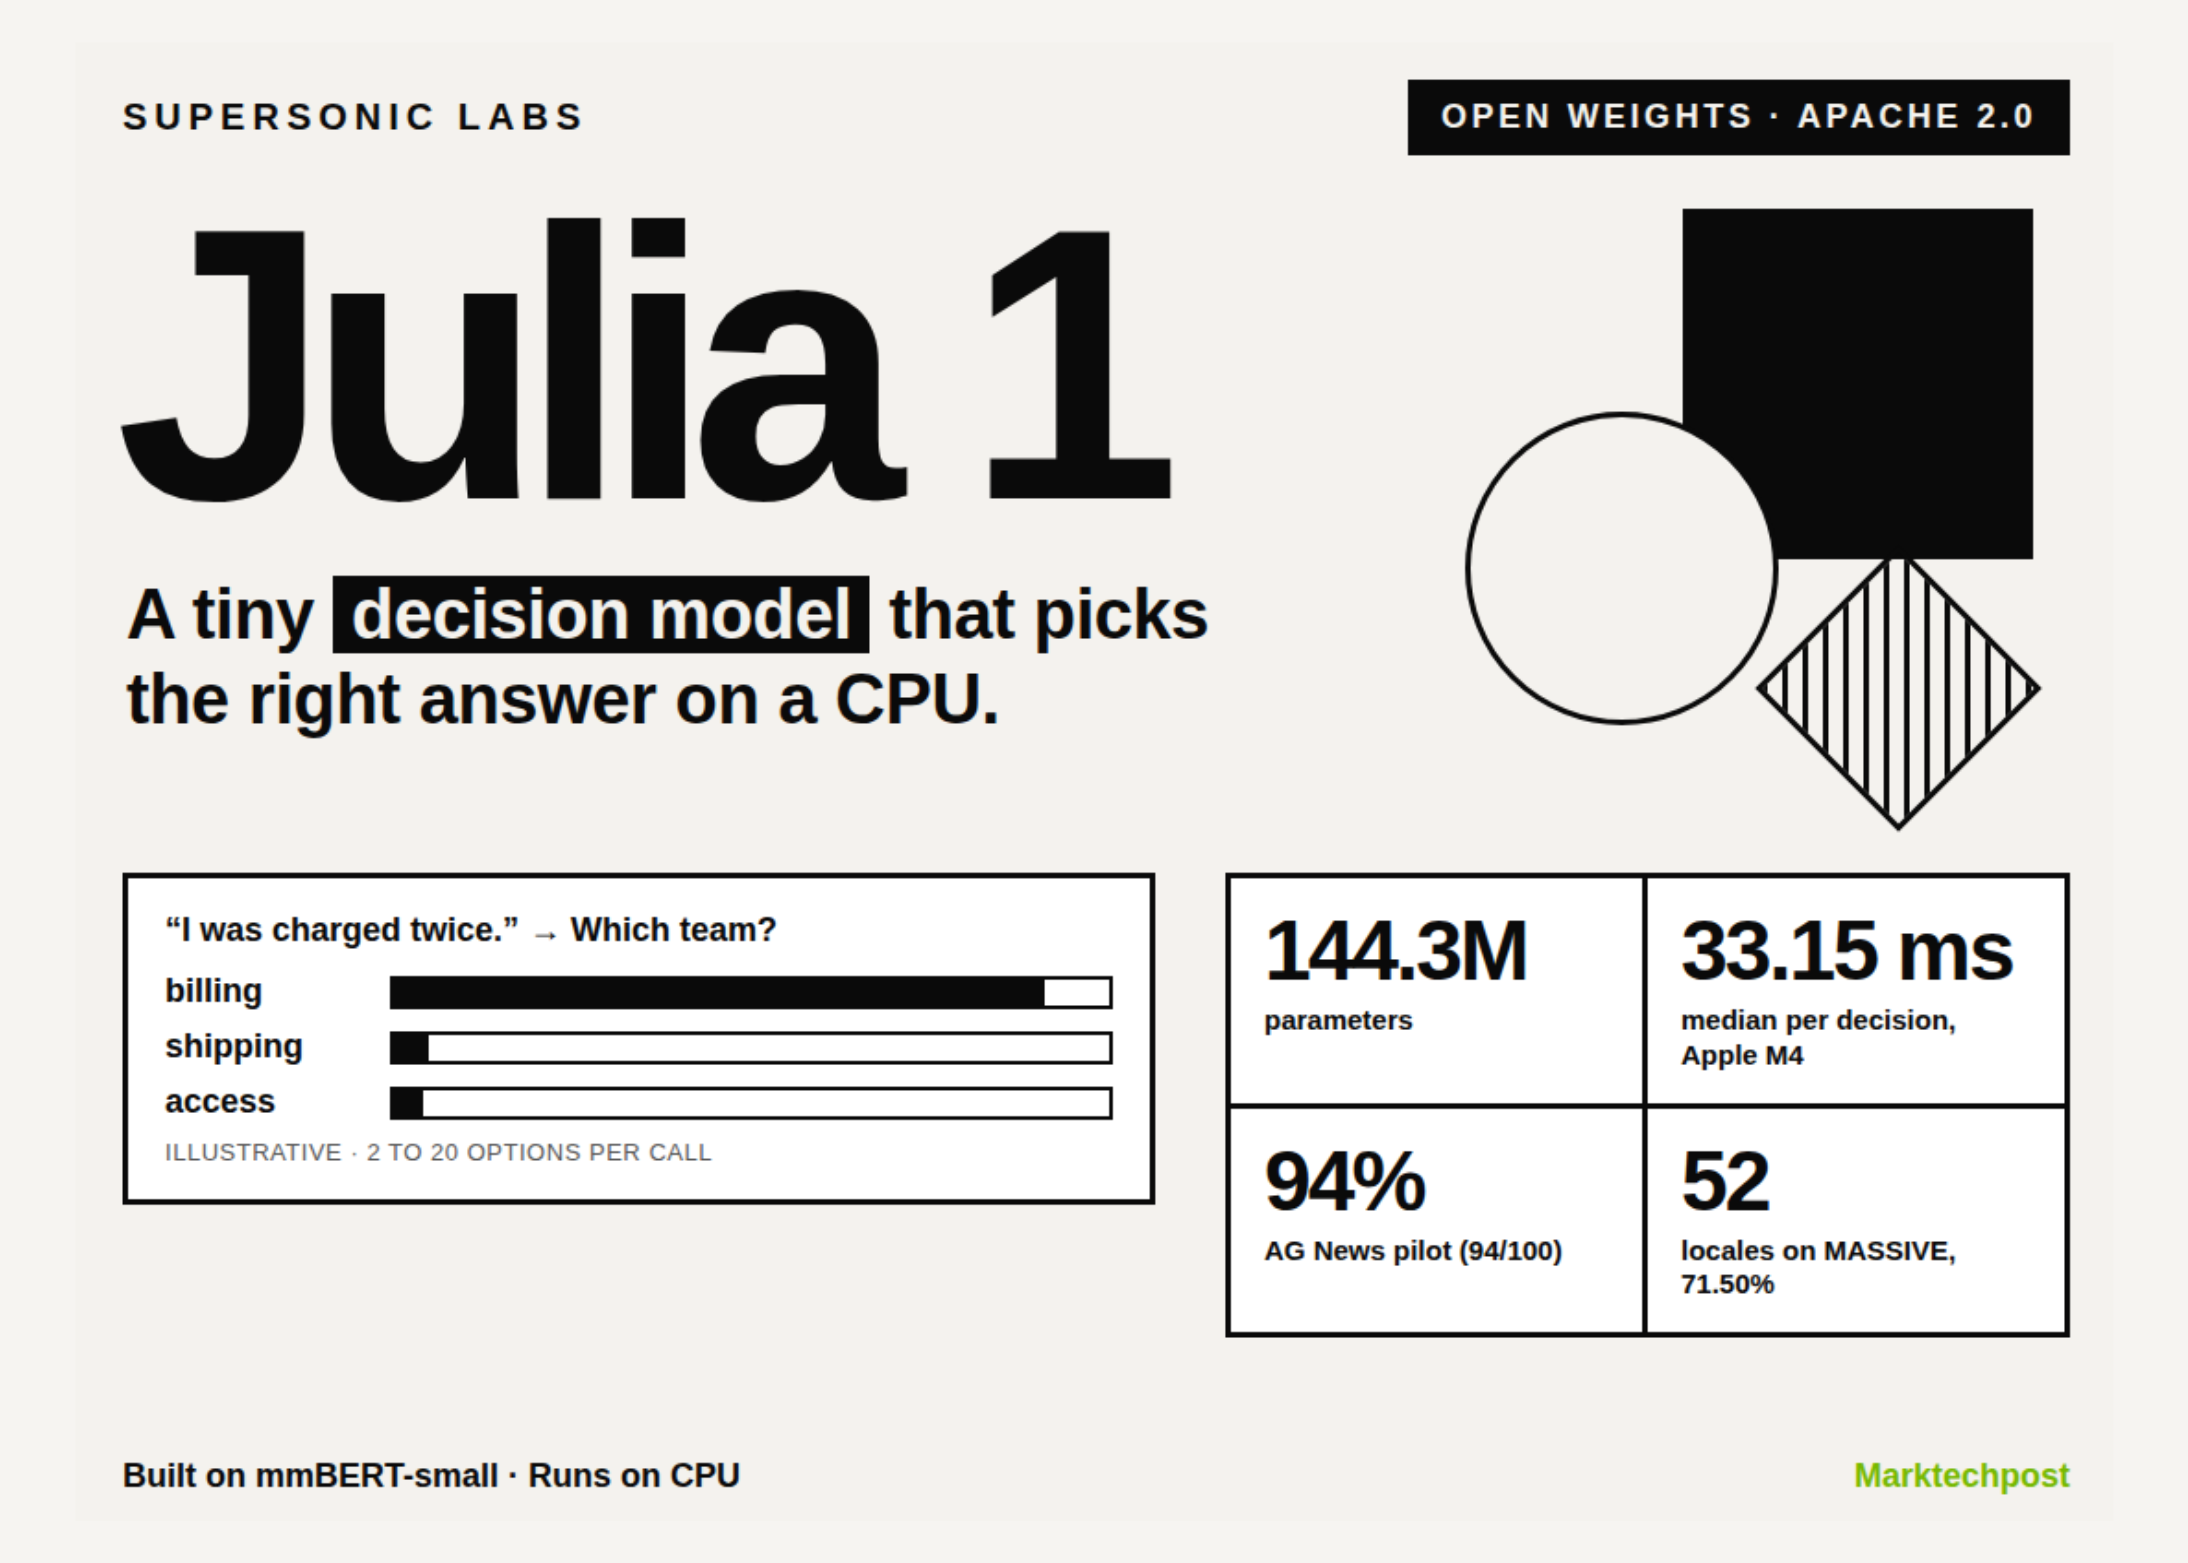
Supersonic Labs, một phòng thí nghiệm AI nhỏ từ Brazil, đã phát hành Julia 1. Đây là một mô hình ra quyết định nhỏ gọn, không phải chatbot. Bạn cung cấp cho nó ngữ cảnh, một câu hỏi và từ 2 đến 20 phương án trả lời. Nó sẽ chọn một phương án và trả về xác suất cho mọi tùy chọn. Mô hình có 144,3 triệu tham số và chạy trên CPU thông thường.
Có thể triển khai được không? Có. Trọng số có trên Hugging Face theo giấy phép Apache 2.0 và chạy cục bộ với Python 3.11+ trên CPU hoặc GPU hỗ trợ BF16. Một bản dựng ONNX cũng chạy được trên trình duyệt thông qua WebGPU. Một API lưu trữ đã được công bố nhưng chưa mở.
Julia 1 làm được gì
Julia 1 xử lý ba loại quyết định thông qua một API duy nhất:
- choice: chọn một nhãn từ 2 đến 20 tùy chọn được mô tả (phân loại, định tuyến).
- score: trả về chỉ số dự kiến trên một thang đo có thứ tự, ví dụ như thấp, trung bình, cao.
- noul: trả về xác suất một khẳng định đúng hoặc sai là chính xác.
Kết quả trả về theo thứ tự tùy chọn của người gọi với đầy đủ xác suất softmax. Các ID người gọi như thông tin thanh toán được trả về nguyên trạng. Mô hình không tạo văn bản.
Kiến trúc và Ngân sách đào tạo
Julia 1 bắt đầu từ mmBERT-small của JHU CLSP, một bộ mã hóa ModernBERT đa ngôn ngữ với 140 triệu tham số được đào tạo trên hơn 1.800 ngôn ngữ. Supersonic Labs giữ lại bộ mã hóa và bộ tách từ (tokenizer), thêm một lớp quyết định (decision head) và đào tạo trên các ví dụ định dạng quyết định. Phòng thí nghiệm khẳng định Julia 1 không phải là mô hình Qwen được tinh chỉnh. Thời gian chạy hỗ trợ tổng cộng 8.192 token, nhưng các điểm chuẩn được công bố sử dụng giới hạn 1.024 token.
Tổng chi phí GPU đám mây cho việc đào tạo và thử nghiệm là khoảng 540 R$ (104,08 USD). Các trọng số FP32 chiếm 550,5 MiB. Quy trình đào tạo riêng không được công bố. Julia 2, với kiến trúc nền tảng riêng của phòng thí nghiệm, đang được phát triển.
Kết quả điểm chuẩn
Đánh giá ngày 24 tháng 9 năm 2026 được thực hiện trên H200 BF16 với mã hóa nghiêm ngặt. Cơ sở so sánh là Jev của TypeSafe, sử dụng các giá trị tham chiếu từ giao thức điểm chuẩn Jev, không phải là một lần chạy Jev mới.
- Quyết định có kiểu dữ liệu: 73,15% (1.463/2.000) so với 72,70% tham chiếu.
- AG News, 4 nhãn: 94/100 so với 91% tham chiếu.
- DAIR Emotion, 6 nhãn: 86/100 so với 48% tham chiếu.
- Banking77, 72 nhãn: 64/100 so với 87% tham chiếu. Đây là điểm thất bại rõ ràng.
- MASSIVE, 18 kịch bản: 71,50% độ chính xác vĩ mô trên 52 ngôn ngữ; 86,25% pt-PT, 86,75% en-US.
Các thử nghiệm phân loại chỉ sử dụng 100 ví dụ mỗi loại. Một lần chạy trên CPU ngày 25 tháng 9 đã tái lập hầu hết các con số: 72,55% trên Typed Decisions và 60/100 trên Banking77 với 3 lần bỏ phiếu trắng.
Độ trễ trên thiết bị
Phòng thí nghiệm đã công bố các phép đo trên từng thiết bị. Trên Apple M4, một quyết định mỗi lệnh gọi mất trung bình 33,15 ms. Trên máy tính bảng Samsung SM-X510 thông qua ONNX Runtime, mức trung bình là 203 ms với đỉnh RSS 393,1 MB. Trên Intel Core i5-1235U, các quyết định AG News mất trung bình 107,83 ms. Banking77 mất 3.713,54 ms vì nó thu hẹp 72 nhãn trước.
Trên X, @supersonicai tuyên bố Julia 1 phân loại nhanh gấp 5 lần Jev trên máy tính xách tay i5. Hãy thận trọng với điều này. Thử nghiệm Jev đã đo lường Jev như một dịch vụ lưu trữ được gọi từ Pháp, vì vậy độ trễ không tương đương nhau.
Julia 1 so với các đối thủ cạnh tranh gần nhất
| Tính năng | Julia 1 | TypeSafe Jev | GLiNER2.5 Multi |
|---|---|---|---|
| Nhà phát triển | Supersonic Labs | TypeSafe AI | Fastino |
| Truy cập | Trọng số mở | API lưu trữ, truy cập sớm | Trọng số mở |
| Giấy phép | Apache 2.0 | Độc quyền | Apache 2.0 |
| Tham số | 144,3M | Không tiết lộ | 287M |
| Bộ mã hóa nền tảng | mmBERT-small | Không tiết lộ | mDeBERTa-v3-base |
| Loại quyết định | Lựa chọn, điểm số, có/không | Quyết định có cấu trúc kiểu dữ liệu | Phân loại, NER, quan hệ, bản ghi |
| Tùy chọn mỗi lệnh gọi | 2 đến 20 (Bộ định tuyến cho nhiều hơn) | Lên đến 255 | Danh sách nhãn theo lược đồ |
| Chạy cục bộ trên CPU | Có | Không | Có |
| Giá đầu vào trên mỗi 1 triệu token | $0,025 (API dự kiến) | $0.042 | Miễn phí (tự lưu trữ) |
| Thử nghiệm AG News | 94% | 91% | 70% |
| Thử nghiệm DAIR Emotion | 86% | 48% | 44% |
| Thử nghiệm Banking77 | 64% | 87% | 61% |
Nguồn: Thẻ mô hình Julia 1, Bài viết ra mắt TypeSafe, Thẻ GLiNER2.5 Multi, Thử nghiệm đánh giá Jev. Các thử nghiệm Julia 1 được chạy riêng biệt với các lượt chạy của Jev và GLiNER.
Hạn chế
Julia 1 so sánh các câu trả lời mà bạn cung cấp. Nó không thể được tin cậy cho các dữ kiện còn thiếu, đại số hoặc tính toán nhiều bước. Bộ định tuyến (Router) có thể bỏ sót nhãn chính xác trong quá trình thu hẹp phạm vi. Đây không phải là một pipeline Transformers thay thế trực tiếp và không có nhà cung cấp suy luận Hugging Face nào hỗ trợ nó. Supersonic Labs khuyên bạn nên tự đánh giá trên các câu hỏi của riêng mình và giữ con người trong vòng lặp đối với các quyết định quan trọng.
Điểm chính cần lưu ý
- Julia 1 là mô hình quyết định 144,3 triệu tham số, giấy phép Apache 2.0, chạy trên CPU.
- Một API duy nhất bao gồm các quyết định lựa chọn, điểm số có thứ tự và có/không cho từ 2 đến 20 tùy chọn.
- Nó đã vượt qua các tham chiếu Jev trong 3 trên 4 thử nghiệm nhưng lại tụt hậu đáng kể ở bộ dữ liệu 72 nhãn Banking77.
- Độ trễ trung vị đạt 33,15 ms mỗi quyết định trên chip Apple M4.
- Chi phí đào tạo khoảng 104 USD trên GPU đám mây; API với giá 0,025 USD/1 triệu token đang được lên kế hoạch.
Xem Trọng số mô hình, Bản dựng ONNX/WebGPU và Chi tiết kỹ thuật. Mọi tín dụng đều thuộc về nhà nghiên cứu của dự án này. Ngoài ra, hãy thoải mái theo dõi chúng tôi trên Twitter và đừng quên tham gia SubReddit 150k+ ML của chúng tôi cũng như Đăng ký Bản tin của chúng tôi. Khoan đã! Bạn có dùng Telegram không? bây giờ bạn cũng có thể tham gia cùng chúng tôi trên Telegram.
Cần hợp tác với chúng tôi để quảng bá GitHub Repo HOẶC Trang Hugging Face HOẶC Bản phát hành sản phẩm HOẶC Hội thảo trực tuyến, v.v. của bạn? Kết nối với chúng tôi

Michal Sutter
Michal Sutter là một chuyên gia khoa học dữ liệu với bằng Thạc sĩ Khoa học Dữ liệu từ Đại học Padova. Với nền tảng vững chắc về phân tích thống kê, học máy và kỹ thuật dữ liệu, Michal xuất sắc trong việc chuyển đổi các tập dữ liệu phức tạp thành những thông tin chi tiết có thể hành động được.
Bài gốc còn tiếp — xem tiếp tại bài gốc ↗
Bài viết được AI dịch và tổng hợp tự động từ MarkTechPost. Liên kết bài gốc ở phía trên. Dữ liệu đồng bộ qua API công khai được ghi nguồn tại AI HOT (canonical) ↗. AIHOT.vn luôn dẫn nguồn đầy đủ — nếu bạn thấy điểm cần chỉnh sửa, hãy gửi ý kiến tại trang phản hồi.